Ollama上哪些模型支持128K上下文?
Hans Kuepper 作者 · PromptQuorum创始人 · 开放权重与开源AI发现引擎
关键要点
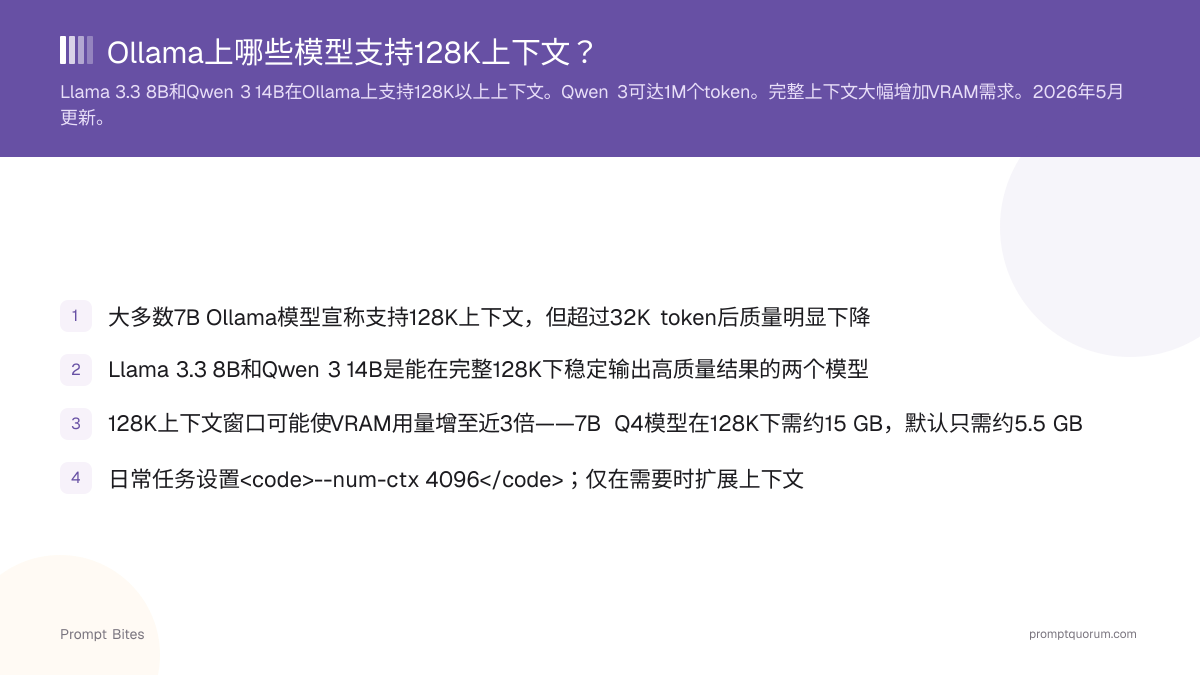
- ✓大多数7B Ollama模型宣称支持128K上下文,但超过32K token后质量明显下降
- ✓Llama 3.1 8B和Qwen3-30B-A3B是能在Ollama上稳定提供128K以上上下文的两个模型
- ✓128K上下文窗口可能使VRAM用量增至近3倍——7B Q4模型在128K下需约15 GB,默认只需约5.5 GB
- ✓日常任务设置<code>num_ctx 4096</code>;仅在需要时扩展上下文
快速回答
Llama 3.1 8B在Ollama上支持128K上下文。Qwen3-30B-A3B是一个混合专家(MoE)模型,可达256K上下文。注意:运行完整上下文会大幅增加VRAM——128K窗口比默认4K窗口需要多3–4倍VRAM。
- ▸Llama 3.1 8B:128K上下文,完整上下文约需16 GB VRAM
- ▸Qwen3-30B-A3B:256K上下文,完整上下文需24+ GB VRAM
- ▸日常使用设置num_ctx 4096以节省VRAM
真正能达到128K的模型
大多数Ollama模型宣称支持128K上下文,但在该长度下能提供有效输出质量的模型很少。问题在于"中间遗失"效应:在标准文档长度上训练的模型,难以关注到长上下文深处的信息。
在Ollama上能稳定提供128K以上上下文的模型有两个:Llama 3.1 8B(原生在128K下训练)和Qwen3-30B-A3B(一个混合专家模型,在Ollama官方库中支持256K上下文窗口,每个token仅激活300亿参数中的约30亿)。Qwen3较小的稠密尺寸在Ollama中默认上下文窗口为40K,对于大多数其他7B级模型,输出质量在超过32K token后也会明显下降。
如果您的任务涉及超过20,000字的文档,从Llama 3.1 8B开始。如果需要最大的上下文窗口且有20+ GB VRAM,Qwen3-30B-A3B是更好的选择。
📍 简单一句话
在Ollama上能稳定提供128K以上上下文的两个模型是Llama 3.1 8B(128K,原生训练)和Qwen3-30B-A3B(256K,混合专家模型)。
💬 简单来说
Llama 3.1 8B从一开始就针对128K token的上下文进行训练,因此在该长度下输出质量依然稳定。Qwen3-30B-A3B是一个混合专家模型——每个token仅激活300亿参数中的约30亿——Ollama将其列为256K上下文窗口。大多数其他7B级模型宣称支持128K,但输出质量在超过32K token后会明显下降。
长上下文的VRAM成本
扩展上下文窗口会显著增加VRAM使用量。KV-Cache存储上下文中所有token的注意力状态,在128K上下文下可能占用与模型权重相当的VRAM。
下表显示Q4_K_M的7B模型KV-Cache VRAM的扩展情况。这些数值假设模型使用分组查询注意力(GQA)——不使用GQA的模型会消耗更多KV-Cache。
日常任务中节省VRAM,请在ollama run会话中输入/set parameter num_ctx 4096(或使用OLLAMA_CONTEXT_LENGTH=4096 ollama serve启动服务)。仅在特定任务需要时扩展至32K或128K。长上下文本地LLM的完整指南(包括模型选择和RAM分割),请参阅长上下文本地LLM指南。
| 上下文长度 | KV-Cache (7B) | 总VRAM (7B Q4) |
|---|---|---|
| 4K(默认) | ~0.5 GB | ~5.5 GB |
| 16K | ~1.5 GB | ~6.5 GB |
| 32K | ~3 GB | ~8 GB |
| 128K | ~10 GB | ~15 GB |
相关指南
- ▸长上下文本地LLM指南 -- 模型选择与内存分配
- ▸可以在Ollama上运行Qwen 3吗? -- 安装与VRAM需求
- ▸哪些Ollama模型支持视觉功能? -- Ollama上的多模态模型
长上下文模型常见问题
如何在Ollama中启用128K上下文?▾
ollama run llama3.1:8b)中输入/set parameter num_ctx 131072。如需永久生效,可在Modelfile中写入PARAMETER num_ctx 131072,在API中传入options.num_ctx,或使用OLLAMA_CONTEXT_LENGTH=131072 ollama serve启动服务。未显式设置时,Ollama的Modelfile规范默认num_ctx为2048,即使是按VRAM分级的运行时默认值(24 GiB以下为4K,24–48 GiB为32K,以上为256K)也可能达不到模型的最大能力——请显式设置num_ctx,以便实际使用更大的上下文窗口。