⚡ 快速事实
📍 In One Sentence
AI 研究工具与通用聊天机器人的区别在于,它对已建立索引的文献做语义检索,并返回你可以点开的引用,而不是凭记忆生成看似合理的参考文献。
💬 In Plain Terms
聊天机器人凭着模糊的印象作答,研究工具则真的去查。差别就在这里——所以前者可能凭空造出一篇并不存在的论文,后者递给你的是一条可以点开的链接。
- Elicit覆盖138M+论文和545,000临床试验,具有语义搜索(非关键字)
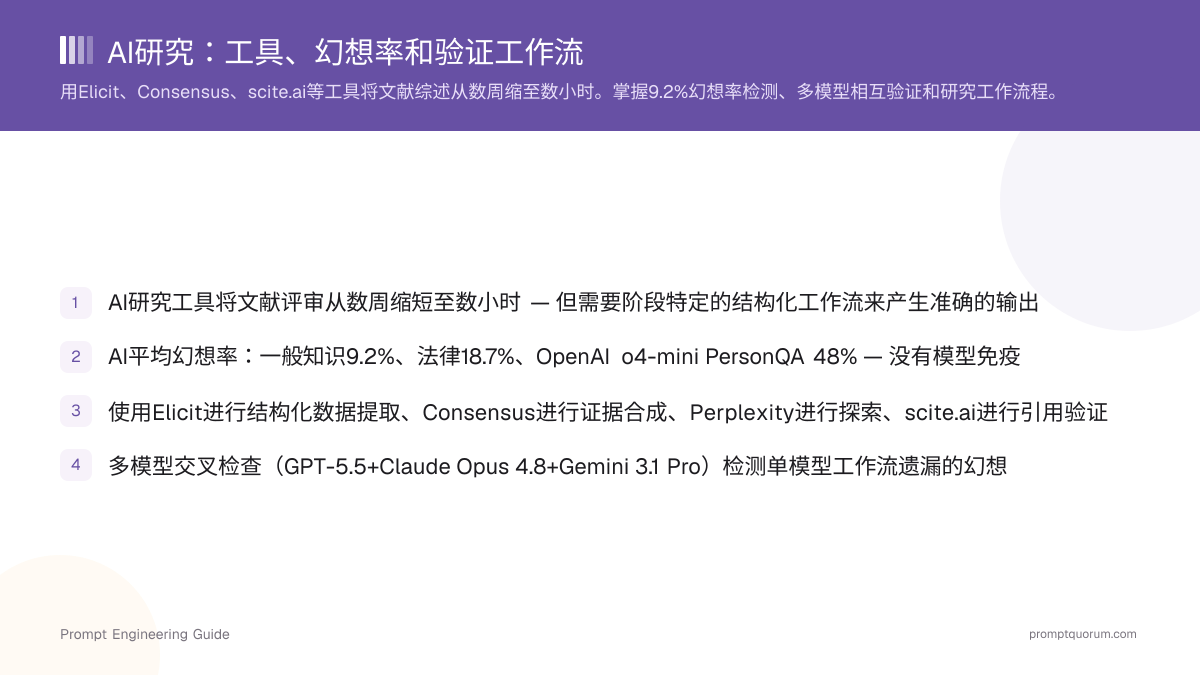
- AI平均幻想率:一般知识9.2%、法律18.7%、o4-mini PersonQA 48%
- 100+虚幻引用在NeurIPS 2025(顶级ML会议,24.52%接受率)通过同行评审
- GPT-5.6、Claude Opus 5和Gemini 3.1 Pro现在都拥有1M令牌的上下文窗口,每个会话处理约800页学术页面
- 温度0.0–0.1用于引用生成;0.7–0.9仅用于假设头脑风暴
- 多模型交叉检查在PromptQuorum测试中的30个测试引用中检测到8个幻想
AI研究实际上做什么
📍 一句话 AI研究使用RAG连接的LLM和语义搜索加速文献发现、合成和验证 — 但需要多模型交叉检查捕获虚幻引用。
💬 简单术语 标准LLM是闭卷考试。RAG驱动的研究工具是开卷 — 在回答前查看来源。但即使开卷答案也可能错误,所以使用第二个模型交叉检查并手动验证引用。
工作原理: Retrieval-Augmented Generation(RAG)是大多数AI研究工具背后的核心架构。RAG将LLM连接到外部知识库 — 学术数据库、上传PDF或实时网络索引 — 以便模型在检索文档中而不仅从训练数据锚定答案。没有RAG,模型只能回忆训练的事实;使用RAG,他们从您提供的来源回答。
每个研究阶段的最佳工具
没有单一AI研究工具能很好地处理每个研究阶段 — 最高质量的工作流会将每项任务路由到为其设计的最佳工具。
Elicit(elicit.com)对138M+学术论文和545,000项临床试验使用语义搜索,无需关键字匹配即可直接从PDF提取方法论、样本量、结果等结构化数据。Consensus(consensus.app)搜索约2亿篇论文,返回总结特定问题科学共识的"共识计量器"(是/否/也许)。Perplexity AI在开放网络和学术文献中提供最快的通用引用答案,是探索阶段的最佳选择。
- 发现 — 使用Perplexity绘制主题全景并明确研究问题
- 文献收集 — 使用Elicit查找特定论文并提取数据表
- 证据验证 — 使用Consensus检查科学界是否认同您的核心假设
- 引用核查 — 使用scite.ai验证您的关键参考文献未被广泛反驳
工具 | 数据库 | 主要功能 | 免费层级 |
|---|---|---|---|
| Elicit | 138M+论文+54.5万项临床试验 | 从PDF提取结构化数据 | 有(每月5,000点数) |
| Consensus | 约2亿篇论文 | 使用共识计量器进行证据合成 | 有(受限) |
| Semantic Scholar | 2亿+论文 | 论文发现、引用图谱、TLDR摘要 | 完全免费 |
| Perplexity AI | 网络+学术 | 实时引用答案、广泛探索 | 有(受限) |
| scite.ai | 12亿+引用声明 | 支持/矛盾/提及分析 | 有(受限) |
| NotebookLM(Google) | 上传的文档 | 基于您自己文件的源引用问答 | 免费/Plus层级 |
研究AI中的幻想问题
AI系统会幻想引用并捏造统计数据 — 这些错误甚至能通过同行评审。 GPTZero分析了NeurIPS 2025(采用率24.52%的顶级机器学习会议)录用的4,841篇论文,在通过多评审人同行评审的53篇论文中发现了100多个确认的幻想引用。
幻想率因领域和任务复杂度而显著不同:
用简单的话说: 幻想率为9.2%的AI研究助手,每生成11条引用大约会捏造1条。在一篇包含40条引用的论文中,这意味着3—4条虚构的参考文献 — 足以导致一篇出版物被撤回。核心问题在于"自信"。LLM表达的不确定性与其准确性并不成正比。幻想引用与真实引用几乎无法区分 — 相同的格式、看似合理的期刊名称、连贯的作者组合。
领域 | 幻想率 |
|---|---|
| 一般知识问题 | 9.2%(模型平均) |
| 法律信息 | 18.7%(顶级模型) |
| 医疗/健康查询 | 15.6%(整体平均) |
| 文本摘要(最佳模型) | 1.3—4.1% |
| OpenAI o4-mini的PersonQA基准 | 48% |
🔍 信心问题
LLM不按比例表达与其准确性成正比的不确定性。虚幻引用看起来与真实引用相同 — 相同格式、似是而非的期刊名称、一致的作者组合。没有视觉信号表明引用是捏造的。验证是唯一的防御。
如何验证AI研究输出:多模型交叉检查
多模型交叉检查 — 同时通过GPT-5.6、Claude Opus 5和Gemini 3.1 Pro运行同一研究问题 — 能检测出单模型工作流会遗漏的幻想,因为独立模型很少捏造出相同的具体虚假声明。
验证逻辑基于统计学:当三个独立训练的模型对某条引用达成一致时,三者都幻想出相同作者、期刊、卷号和年份的概率微乎其微。当它们意见不一致时,这种分歧就是需要手动验证的明确信号。
PromptQuorum是一款多模型AI分派工具,可将同一提示同时发送给多个AI提供商,并并排返回所有回答。在研究工作流中,这意味着通过一次分派,将引用或事实性声明同时提交给GPT-5.6(OpenAI)、Claude Opus 5(Anthropic)和Gemini 3.1 Pro(Google DeepMind),然后查看三个模型在哪些地方一致、哪些地方冲突。
在PromptQuorum中测试 — 三个模型的30条研究引用提示: 三个模型(GPT-5.6、Claude Opus 5、Gemini 3.1 Pro)在30个案例中有22个案例就相同的引用格式和DOI达成一致。在8个案例中,至少有一个模型给出了不同的作者姓名或期刊卷号 — 经Google Scholar人工核实,这8个案例全部确认为幻想。
- 生成 — 让一个模型(例如Claude Opus 5)生成带引用的文献摘要
- 交叉检查 — 通过PromptQuorum将同一问题分派给GPT-5.6和Gemini 3.1 Pro
- 标记分歧 — 任何模型在作者、年份或期刊上意见不一致的引用都需要人工验证
- 验证一致的声明 — 使用scite.ai确认达成一致的引用未被撤回或反驳
🔍 为什么交叉检查有效
三个独立训练的模型很少捏造相同的特定虚假声明 — 相同作者、相同期刊、相同卷号、相同年份。三个全部同意时,引用几乎肯定是真实的。当他们不同意时,该差异是您的幻想警报。
研究任务的提示工程
结构化提示比开放式问题产生更准确和可验证的研究输出 — 区别在于范围具体性、输出格式和引用来源的明确说明。
大多数研究人员犯的关键错误是像搜索引擎那样完全按照他们输入的方式提出研究问题。搜索引擎排名文档;LLM预测令牌。他们需要不同的输入结构。
研究提示框架
为任何AI研究任务使用这个结构:
- 角色 — "您是专门从事领域的系统评审研究人员。"
- 范围 — "仅分析2020至2026年间发表的同行评审论文。"
- 目标 — "总结当前关于主题的科学共识。"
- 引用要求 — "使用作者、年份和期刊引用每项声明。如果找不到验证引用,请说"未验证"而不是生成一个。"
- 输出格式 — "以结构化表格返回结果:声明|来源|年份|信心(高/中/低)。"
错误提示: 没有角色或引用要求的开放式问题会产生幻想统计数据:
关于AI幻想的研究有哪些?
好的提示示例
好的提示: 下面的结构化版本会生成可验证的输出表格。上面的开放式提示会生成一段自信满满、但可能包含捏造统计数据的文字。
您是一名系统评审研究人员。请总结当前关于各领域(医疗、法律、一般知识)AI幻想率的科学共识。仅引用2023—2026年间发表的同行评审论文或官方模型评估报告。结果格式为:领域|幻想率|研究|年份。如果某个具体比率未经验证,请标注为"估计"并加以标记。
研究任务的温度设置
对所有需要事实准确性的研究任务,将温度(T)设置为0.0—0.2。 温度(T)是应用于softmax输出分布的超参数:当T = 0.0时,模型在每一步都选择概率最高的令牌,产生确定性输出。当T = 1.0时,输出变得更加多样 — 这对创意任务是理想的,但对引用生成来说很危险,因为一个错误的令牌就可能改变作者姓名或DOI。
任务 | 推荐T值 | 原因 |
|---|---|---|
| 引用生成 | 0.0—0.1 | 确定性输出;最小化令牌变动 |
| 摘要 | 0.1—0.3 | 事实准确同时表述自然 |
| 假设头脑风暴 | 0.7—0.9 | 多样化输出扩大构思范围 |
| 文献综述初稿 | 0.2—0.4 | 准确性与可读性的平衡 |
🔍 一个错误令牌
在温度0.7时,单个令牌的变动就可能将"Smith 2024"变为"Smith 2023",或将"Nature"变为"Nature Methods"。对于引用生成,即使T = 0.2也会带来不必要的风险。除非有特殊理由,否则请使用T = 0.0。
按模型划分的AI研究工具:上下文窗口限制
上下文窗口大小决定了LLM在单个会话中能处理多少研究论文 — 这是大规模文献综合的主要技术限制。
- GPT-5.6、Claude Opus 5和Gemini 3.1 Pro目前都共享100万令牌的上下文窗口。对于涉及不到20篇论文的研究任务,三个模型都能轻松处理完整上下文。对于覆盖50—200篇论文的系统评审,三个模型现在都能在单次会话中处理完整语料库 — 尽管无论窗口大小如何,"lost in the middle"效应仍会降低对埋藏在上下文中间的材料的检索准确性。
- 对于真正大规模的语料库(500篇以上论文),正确的架构是RAG管道 — 将论文分块、嵌入向量数据库、并通过语义相似性检索 — 而非直接注入上下文。
- 关于上下文窗口的更深入解释,以及模型为何会丢失上下文中间的信息,请参阅上下文窗口详解。
模型 | 上下文窗口 | 大致页面容量 |
|---|---|---|
| GPT-5.6(OpenAI) | 1M令牌 | 每个会话约800页标准学术页面 |
| Claude Opus 5(Anthropic) | 1M令牌 | 每个会话约800页标准学术页面 |
| Gemini 3.1 Pro(Google DeepMind) | 1M令牌 | 每个会话约800页标准学术页面 |
🔍 中间丢失效应
即使在模型声明的上下文窗口范围内,放置在长输入中间的信息其检索准确性也会下降。将最重要的论文放在前面,参考材料放在最后。这是Anthropic和Google研究中记录的已知限制。
全球及区域研究AI概况
欧洲研究机构越来越多地要求AI辅助研究遵守《欧盟人工智能法案》(EU AI Act),该法案要求包括学术出版在内的高风险AI应用具备透明度、可追溯性和人工监督。Mistral AI(法国)因其模型可在本地部署、满足敏感研究数据的GDPR数据驻留要求,而在欧盟学术界被广泛使用。
中国的研究机构将Qwen3(阿里巴巴)和DeepSeek用作主要的研究AI工具 — 两者均为开源、可本地部署,且在处理CJK语言学术文献时的令牌处理速度快于西方训练的模型。中国的《生成式人工智能服务管理暂行办法》(2023年)要求对AI生成的研究内容进行标注,这一政策目前正影响着全球的学术出版标准。
在METI数据治理指南下运营的日本大学,经常在本地部署Ollama和Llama 4 8B — 该模型的本地推理需要8GB RAM,不产生任何外部API调用,符合敏感研究严格的数据驻留标准。
AI支持研究中的常见错误
在使用AI工具进行研究时避免这些频繁错误:
- 基于基准排行榜选择(非实际任务) — 修复: 按任务拟合选择模型,而不是排行榜排名。基准赢家(GPT-5.6)对于摘要来说是过度的;Gemini 3.1 Pro的成本优势在您只需要上下文处理时占主导地位。
- 假设上下文窗口=质量(三大前沿模型现在都是1M;LLaMA 4 Scout本地可达10M) — 修复: 上下文窗口只是一个维度,不是质量的衡量标准。1M令牌仅对50+论文重要。对于小型文献评审,应由价格和任务适配性——而非窗口大小——决定模型选择,因为GPT-5.6、Claude Opus 5和Gemini 3.1 Pro现在在上下文上已持平。
- 对每个任务使用前沿模型(Gemini Flash对GPT成本相差60倍) — 修复: 按成本效率路由任务:Gemini Flash用于分类、Claude Opus 5用于写作、GPT-5.6用于代码。PromptQuorum多模型分派可实现按任务模型选择。
- 忽视地理位置和数据驻留(EU GDPR、中国) — 修复: EU研究必须使用符合GDPR的工具(Mistral本地、Ollama本地)。中国机构使用Qwen3或DeepSeek。日本在METI指南下本地使用Ollama+Llama 4 Scout。
- 在没有抽象层的情况下锁定到提供者SDK — 修复: 使用多模型分派工具(PromptQuorum)避免供应商锁定。单个API调用路由到最佳模型;更换提供者无需代码更改。
相关阅读
- RAG说明 — 为Elicit、Consensus和所有生产研究AI工具供电的检索架构
- AI局限性 — LLM不能做什么 — 为什么幻想是结构性的,而不是可修复的错误
- 提示注入和安全 — 将抓取网络内容馈送到研究管道时的间接注入风险
- 思想链提示 — 需要可追溯逻辑的系统分析任务的结构化推理
- 温度和Top-P说明 — 随机参数如何影响引用生成中的事实准确性
- 什么是提示工程 — 结构化AI说明的基础定义
- Qwen对Llama对Mistral — 本地推理的领先开源模型比较
- 最佳编码本地LLM — 软件开发任务的本地模型评估
- 开源对专有LLM — 研究工作流中模型选择的权衡
如何进行AI支持的研究
- 1按阶段映射您的研究工作流:发现、收集、合成、验证。 使用Perplexity进行探索性发现、Elicit进行结构化文献提取、Consensus进行证据合成、scite.ai进行引用验证。将每个任务路由到为其设计的工具。
- 2为引用生成将温度(T)设置为0.0–0.1。 确定性输出最小化作者名称、年份和DOI的幻想。仅将T=0.7–0.9用于假设头脑风暴,而不是任何基于事实的声明。
- 3使用角色、范围、目标、引用要求和输出格式来构造研究提示。 例如:"您是系统评审研究人员。仅分析2020–2026同行评审论文。总结主题的科学共识。用作者、年份、期刊引用每项声明。表格返回:声明|来源|年份|信心。"
- 4使用多模型交叉检查检测虚幻引用。 通过PromptQuorum在GPT-5.6、Claude Opus 5和Gemini 3.1 Pro中运行相同的研究问题。任何模型在作者、年份或期刊方面不同意的引用都需要在Google Scholar或PubMed中进行手动验证。
- 5在学术著作中包含前验证所有引用。 每个AI生成的参考文献都必须针对源数据库进行检查。虚幻引用已在包括NeurIPS 2025的顶级会议论文中得到确认。
常见问题
2026年学术研究的最佳AI工具是什么?
没有单一工具在所有研究阶段都获胜。Elicit在结构化文献评审和从其138M+论文数据库PDF提取中领先。Consensus在使用其共识计量器(是/否/也许)快速证据合成中领先。Perplexity在跨学术和网络来源快速、广泛引用的探索研究中领先。最高质量工作流顺序使用所有三个。
AI生成研究输出的准确性如何?
准确性因任务和模型而异。文本摘要的最佳幻想率为1.3–4.1%。一般知识问题平均9.2%。法律和医疗领域分别达到18.7%和15.6%。2026年1月,GPTZero在通过同行评审的53篇NeurIPS 2025论文中确认了100+个虚幻引用 — 这意味着AI错误并不总是被专家审查人员捕获。
AI一次可以处理多少学术论文?
这取决于模型的上下文窗口。GPT-5.6(OpenAI)、Claude Opus 5(Anthropic)和Gemini 3.1 Pro(Google DeepMind)目前都能每个会话处理约800页标准学术页面(各自拥有1M令牌上下文)。超出此范围的语料库需要具有向量数据库的RAG管道。
在学术论文中引用AI生成的引用是否安全?
否 — 未经验证不安全。AI模型生成看似合理的引用,可能有不正确的作者、错误的卷号或错误的DOI。每个AI生成的引用都必须在学术工作中包含前针对源数据库(Google Scholar、PubMed、arXiv)验证。虚幻引用已被发现在包括NeurIPS 2025的顶级机器学习会议论文中。
AI研究协助在美国外是否以不同方式运作?
是的。欧洲研究人员必须遵守AI协助工作的EU AI法透明度要求。中国机构主要使用Qwen3(阿里巴巴)和DeepSeek — 两者对CJK语言文献有更快的令牌处理。日本研究人员在METI数据治理指南下经常使用基于Ollama的本地模型 — Llama 4 8B在8GB RAM上本地运行,没有数据离开机构基础设施。
我应该为AI研究任务使用什么温度?
将温度设置为0.0–0.1以生成引用 — 确定性输出最小化令牌变动,令牌变动可能会损坏作者姓名或DOI。对于自然措辞很重要的摘要,使用0.1–0.3。仅为假设头脑风暴(多样输出是目标)保留0.7–0.9。
Elicit是什么?它是如何工作的?
Elicit是一款AI研究助手,在138M+学术论文和545,000项临床试验中使用语义搜索。与关键字搜索不同,它按概念相似性匹配论文。其核心功能是结构化数据提取 — 无需关键字匹配,即可直接从PDF全文中提取方法论、样本量和结果,生成比较表格。
AI研究工具能访问付费墙背后的论文吗?
大多数AI研究工具(Elicit、Consensus、Semantic Scholar)使用开放获取的论文数据库。除非您直接上传PDF,否则它们无法访问机构付费墙背后的论文。NotebookLM(Google)和Elicit都支持上传PDF,为您有权访问的论文提供基于来源的问答。
如何识别幻想引用?
在Google Scholar或PubMed中核对该引用。检查作者姓名、期刊、卷号、年份和DOI是否完全一致。使用scite.ai确认该论文有引用活动 — 一篇号称有影响力的论文如果引用数为零,就是危险信号。用第二个AI模型进行交叉检查:如果它给出不同的作者或期刊信息,两个版本都需要人工验证。
Perplexity AI对学术研究可靠吗?
Perplexity AI对探索性研究可靠 — 例如梳理主题全景、识别关键研究者、寻找需要进一步调查的相关来源。但它不适合作为最终引用来源,因为它搜索的是包括非同行评审来源在内的整个网络。使用Perplexity进行发现,然后在引用前用Elicit、Semantic Scholar或直接数据库查询验证任何具体声明。
来源和进一步阅读
- Schulhoff等,2024. "提示报告:提示技术的系统调查" — 目录58+适用于研究工作流的提示技术
- GPTZero,2026. "GPTZero在NeurIPS 2025会议论文中发现100个新幻想" — 虚幻引用进入顶级会议议事录的首个有案可稽
- 美联储圣路易斯分行,2025. "生成AI对工作生产力的影响" — 使用AI的工人报告AI支持时间的生产力提高33%
- Vectara幻想评估模型(HHEM) — 用于跨领域测量LLM幻想率的开源模型和排行榜
- Elicit研究文档 — Elicit的语义搜索和结构化提取方法的技术文档