树思考是什么?
📍 In One Sentence
树思考告诉模型:"探索 3 种方法,评估,选择最佳"。
💬 In Plain Terms
就像要求某人考虑 3 条不同的路线,权衡每条的利弊,然后选择最好的,而不是只跟随第一条想到的路线。
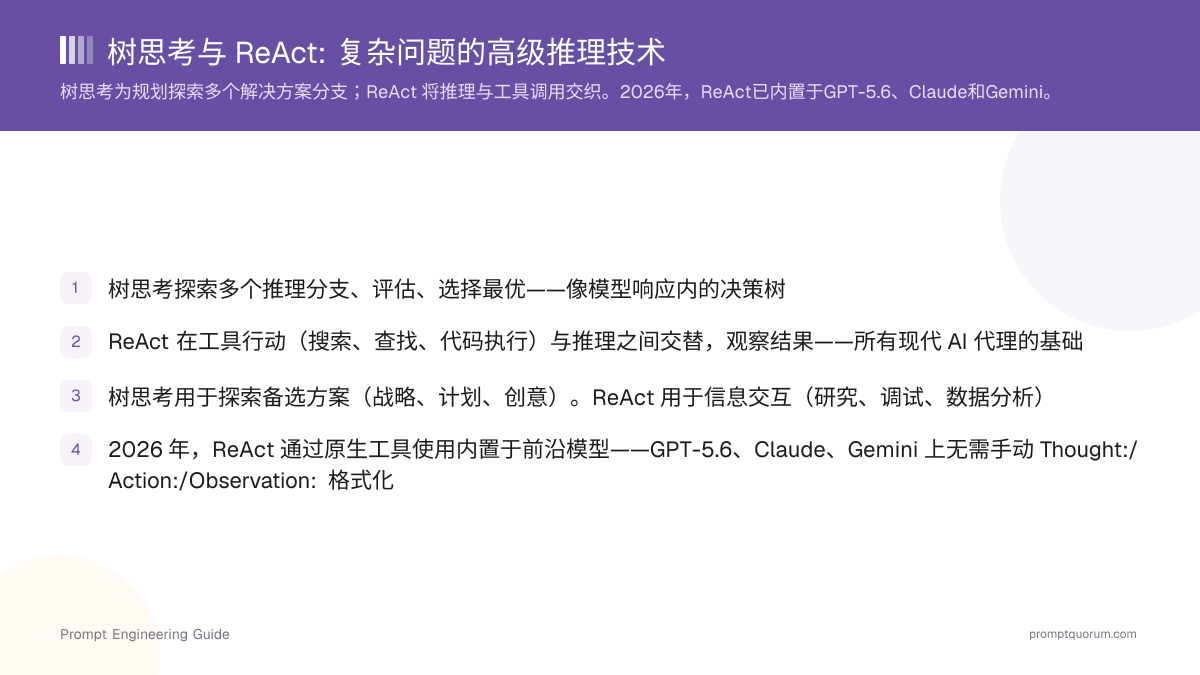
树思考指示模型探索多条推理路径,评估每条,然后在给出最终答案前选择最佳路径。与线性 Chain-of-Thought 不同,树思考明确创建并比较替代方案。
🔍 专业提示
始终指定分支数量("生成正好 3 个方法")和评估标准("按可行性、成本和上市时间比较")。没有明确标准,模型倾向于选择它生成的第一个分支。
ReAct 是什么?
📍 In One Sentence
ReAct 交替执行:思考→行动→观察→重复。
💬 In Plain Terms
你形成假设,搜索信息来测试它,阅读结果,更新假设——这正是 ReAct 逐步做的。
ReAct(推理+行动)在推理步骤与行动(工具调用、搜索、查找)之间交替,观察结果。这是所有现代 AI 代理(从自主编码到网络研究)的基本模式。
🔍 你知道吗
每次 Claude Code 编辑文件、运行测试并根据输出修复错误时,它都在执行 ReAct 循环。2023 年论文中的 Thought-Action-Observation 模式现在是数百万开发者使用的自主 AI 编码工具的核心。
主要区别
Chain-of-Thought (CoT): 单一线性路径。模型"逐步思考",不探索替代方案。
树思考 (ToT): 有意分支。探索 2-5 个分支、评估、选择最优。Token 消耗要大得多。
ReAct: 有工具交互的线性循环。模型在推理和外部工具调用(搜索、API、代码执行)之间交替。
何时使用 —— CoT 用于简单解释和逻辑。ToT 用于选择重要的战略和计划。ReAct 用于需要外部交互的研究和调试。
对比表:CoT vs ToT vs ReAct
维度 | Chain-of-Thought (CoT) | 树思考 (ToT) | ReAct |
|---|---|---|---|
| 推理形状 | 线性(单路径) | 分支(多路径→选最优) | 工具循环线性 |
| 核心动作 | "逐步思考" | "探索 3 种方法、评估、选择" | "推理→行动→观察→重复" |
| 外部工具? | 否 | 否(仅内部) | 是——搜索、API、代码执行 |
| Token 成本 | ~1.5-2 倍 | ~2-5 倍 | 可变(工具调用数) |
| 最适用于 | 数学、逻辑、解释 | 战略、计划、创意探索 | 研究、调试、数据分析 |
| 2026 模型支持 | 所有模型 | 推理模型最优(Opus 5、o3) | 内置于所有前沿模型 |
| 需要手动格式化? | 是(非推理) | 是(明确格式有帮助) | 否(原生工具使用),开源权重除外 |
如何编写树思考提示
按以下步骤构建有效的 ToT 提示:
- 1说明问题并指定分支数量:"为 问题 生成正好 3 个方法"
- 2选择前定义评估标准:"按 可行性/成本/风险/时间 比较"
- 3让模型评估每个分支并评分或排名
- 4添加选择指示:"选择在 标准 上平衡最好的方法"
- 5用选定分支的完整推理完成任务
如何编写 ReAct 提示
为推理-行动-观察循环使用此模板:
在具有原生工具使用的前沿模型上,这个格式由内部处理。模型决定何时调用工具、接收结果、继续推理——无需手动格式化。
推理:首先需要做什么?
行动:[具体工具调用或明确步骤]
观察:[行动的结果]
推理:这告诉我什么?
行动:[下一步]
...
最终答案:[综合结论]
2026 年的 ReAct:从提示模式到内置行为
原始 ReAct 论文(2023)提议手动 Thought/Action/Observation 格式作为提示模式。2026 年,GPT-5.6、Claude Opus 5/Sonnet 5 和 Gemini 3.1 Pro 通过 Function Calling/原生工具自动实现 ReAct 循环。
模型决定何时调用工具、接收结果、继续推理——无需手动格式化。只需定义可用工具;模型管理循环。
手动格式化仍然相关的情况:
1. 开源权重模型:没有原生工具使用(Mistral、旧 LLaMA 变体、Qwen)
2. 教育/调试上下文:希望看到完整追踪
3. 模拟工具交互:没有真实 API 连接
生产 ReAct: 自主 AI 编码工具(Claude Code、OpenAI Codex、Cursor)是大规模 productionized ReAct,其中"行动"= 文件编辑和测试运行。
⚠️ 警告
树思考提示可以生成标准提示 3-5 倍的输出 token。在 $0.025/1M 输出 token(Claude Opus 5),生成 5,000 token 的复杂 ToT 每次运行成本约为 $0.125。相应进行预算。
代理系统中的树思考与 ReAct
Claude Code/OpenAI Codex: Productionized ReAct(推理→写代码→运行→观察错误→修复→迭代)
研究代理(Perplexity、Deep Research):制定问题→搜索→阅读→综合→再搜索
Claude 管理的代理(2026): 完全托管 ReAct,安全沙箱和内置工具
代理规划: 某些框架在规划阶段使用 ToT——提议多个方法、评估可行性、通过 ReAct 执行最优
MCP(模型上下文协议): 标准化工具连接,使 ReAct 样式循环即插即用
提示示例
❌ 模糊
帮我为 SaaS 产品制定营销策略。
✅ 结构化树思考
为我们的 SaaS 产品生成正好 3 种营销策略。按以下比较每种:成本、覆盖范围、实施时间、预期转化率。评估每个,分配分数,选择最优。
❌ 无结构
研究 GPU RTX 5090 性能。
✅ 明确观察的 ReAct
推理:哪些来源比较 RTX 5090 GPU?行动:执行 2026 GPU 基准 Web 搜索。观察:[基准结果]。推理:关键点是什么?行动:提取延迟和功耗。最终答案:[综合]
❌ 非迭代
修复代码。
✅ 调试用迭代 ReAct
推理:错误是什么?行动:运行代码,显示输出。观察:[错误:KeyError 第 42 行]。推理:键丢失,需要添加键存在检查。行动:更新代码。观察:[无错误,正常输出]。最终答案:修复的代码,有解释。
Token 成本
ToT:因为模型生成多个分支后再选择,所以基线输出 token 的 2-5 倍。
ReAct:工具调用数可变(每个行动/观察轮次添加 token)。
成本示例(Claude Opus 5 上 $0.025/1M 输出 token):生成 5,000 token 的复杂 ToT = 每次运行约 $0.125。
高容量指导:在战略决策上有选择地使用 ToT;日常任务优先使用线性 CoT。
入门方法
- 1战略/计划 → 使用带明确分支数和评估标准的 ToT
- 2带工具的研究/调试 → 使用 ReAct(或只在前沿模型上使用原生工具使用)
- 3组合:计划阶段用 ToT,选定分支内的执行用 ReAct
- 4在 PromptQuorum 上跨 GPT-5.6、Claude Opus 5、Gemini 3.1 Pro 并行测试两种模式
常见错误
❌ 对简单任务使用ToT
Why it hurts: ToT会让token成本增加2–5倍。对于"总结这封邮件"这类任务,线性的chain-of-thought更快、更便宜,准确率也相当。只有当问题确实存在多条可行路径时,ToT才划算。
Fix: 先用chain-of-thought测试。如果准确率超过90%,就不要升级到ToT。
❌ 要求过多分支
Why it hurts: "生成10种方案"会超出模型进行有效评估的能力。超过5个分支后,评估质量下降,模型可能开始产出凑数的选项。
Fix: 3–5个分支是最佳区间。复杂问题用3个,创意头脑风暴用5个。
❌ 没有真实工具就使用ReAct
Why it hurts: 模拟式ReAct(模型自行想象动作结果)比真实ReAct(模型调用实际API或工具)要弱。模拟动作仍然会凭空编造数据。
Fix: 生产环境的ReAct请使用带有真实工具绑定的智能体框架(LangChain、CrewAI)。模拟式ReAct适合探索和原型验证。
❌ ToT中缺少评估标准
Why it hurts: 不给标准就说"选出最佳方案",模型会随机选择或按默认偏好选择。没有明确标准,分支评估这一步就失去了意义。
Fix: 指定3–5条评估标准:"按可行性(1-5)、成本(1-5)、实施周期(1-5)评估每个分支,选择总分最高的一个。"
❌ 在每个问题上都把ToT和ReAct组合起来
Why it hurts: 这种组合很强大,但成本高、速度慢。大多数问题只需要其中一种技术,而不是两种。
Fix: "该用哪种策略"类问题用ToT。"查找信息并进行推理"类问题用ReAct。只有两者都需要时才组合,例如"该用哪种策略,且每种策略都需要数据来评估"。
❌ ToT中未说明分支选择标准
Why it hurts: 模型常常在生成分支后就停下,不清楚说明为什么选择其中某一个。隐含的选择依据薄弱,也难以审查。
Fix: 要求给出明确推理:"评估完每个分支后,请说明:分支A在标准Y上得X分,理由是原因。最终选择:分支Z,理由是总分与依据。"
❌ 使用ReAct时没有观察循环
Why it hurts: 模型完成推理、执行动作后立刻继续,不停下来观察结果。这就丢失了来自真实反馈的价值。
Fix: 强制执行循环:"每次动作之后,停下并说明:观察:你了解到了什么。更新后的推理:这如何改变你的方案。下一步动作:你将如何调整。"
❌ 任由ToT分支偏离主题
Why it hurts: 没有明确约束时,模型可能生成富有想象力但不相关的分支,对解决原始问题毫无帮助。
Fix: 设定分支边界:"针对具体问题生成3种方案。每种方案都必须直接回应约束条件。不要探讨旁枝话题或副作用。"
❌ 所有问题都用相同的分支数量
Why it hurts: 简单问题用3个分支时,往往有一个明显占优,白白浪费token预算。复杂问题只用2个分支,则可能遗漏重要的备选方案。
Fix: 让分支数量匹配问题复杂度:二选一决策用2个,典型问题用3个,开放式创意工作用4–5个,简单任务用1个(即纯CoT)。
在 PromptQuorum 中
跨 GPT-5.6、Claude Opus 5/Sonnet 5、Gemini 3.1 Pro 并行测试 ToT 和 ReAct 模式。测量 token 成本、输出质量和延迟,无需向多个 API 暴露数据。
常见问题
树思考提示是什么?
树思考指示模型探索多条推理路径(如决策树分支),评估每条,然后在给出最终答案前选择最佳路径。与线性 CoT 不同,树思考明确创建并比较多个选项。
ReAct 提示是什么?
ReAct(推理+行动)是一个提示框架,其中模型在推理步骤和行动(工具调用、搜索、查找)之间交替。每次行动后,模型观察结果并更新其推理。这个模式是现代 AI 代理的基础。
树思考与 Chain-of-Thought 有何不同?
Chain-of-Thought 遵循单一线性推理路径。树思考分支为多条路径、评估并选择最优。可以这样想:CoT 是走一条路,ToT 是探索分岔口后再选择要走的路。
2026 年还需要手动格式化 ReAct 吗?
在具有原生工具使用的前沿模型(GPT-5.6、Claude Opus 5、Gemini 3.1 Pro)上不需要。这些模型自动实现循环。手动 Thought:/Action:/Observation: 格式化对于没有工具使用的开源权重模型或教学目的仍然有用。
我可以结合树思考和 ReAct 吗?
可以。在战略层面使用 ToT 来探索和比较多个方法,然后在选定分支内使用 ReAct 处理需要工具交互或数据查找的步骤。这在复杂的规划任务中很常见。
哪些模型最适合树思考?
具有扩展思维/推理模式的模型最自然地处理 ToT:Claude Opus 5(扩展思维)、GPT-5.6(推理模式)和 Gemini 3.1 Pro(深度思维)。这些模型可以在内部探索多个分支。
ReAct 的实际应用是什么?
所有现代 AI 代理都是 ReAct 循环:Claude Code(推理代码→编辑→运行测试→观察→迭代)、研究助手(思考问题→Web 搜索→阅读结果→综合)、支持机器人(思考请求→查询知识库→设计响应→验证)。模式从简单查找扩展到数小时的自主会话。
树思考如何影响 Token 成本?
树思考使用明显更多的 token,因为模型生成多个分支后再选择。计划使用标准 CoT 提示输出 token 的 2-5 倍。在 $0.025/1M 输出 token(Claude Opus 5),生成 5,000 token 的复杂 ToT 每次运行成本约为 $0.125。为高容量使用进行预算。
中国企业如何确保树思考和 ReAct 的合规性?
根据中国 2021 年《数据安全法》,本地推理满足数据驻留和处理合规要求。树思考和 ReAct 在本地部署模型上支持金融、医疗和法律部门的法规要求,无需将敏感数据发送到外部 API。
我可以在生产环境中使用树思考和 ReAct 吗?
可以。ReAct 是生产 AI 代理(Claude Code、OpenAI Codex)的基本模式。树思考用于复杂的战略决策。为额外的 token 成本进行预算,并在生产案例中测试模型行为。
来源
- Yao, S., Yu, D., Zhao, J., et al. (2023). "Tree of Thoughts: Deliberate Problem Solving with Large Language Models." NeurIPS 2023. arXiv:2305.10601
- Yao, S., Zhao, J., Yu, D., et al. (2023). "ReAct: Synergizing Reasoning and Acting in Language Models." ICLR 2023. arXiv:2210.03629
- Wei, J., Wang, X., Schuurmans, D., et al. (2022). "Chain-of-Thought Prompting Elicits Reasoning in Large Language Models." NeurIPS 2022. arXiv:2201.11903
- Shinn, N., Cassirer, A., Goyal, A., et al. (2023). "Reflexion: Language Agents with Verbal Reinforcement Learning." arXiv:2303.11366
- Anthropic. (2026). "Tool Use — Claude API Documentation." Retrieved from docs.anthropic.com
- OpenAI. (2026). "Function Calling — Responses API." Retrieved from platform.openai.com/docs