Was läuft auf der RTX 3060 12GB?
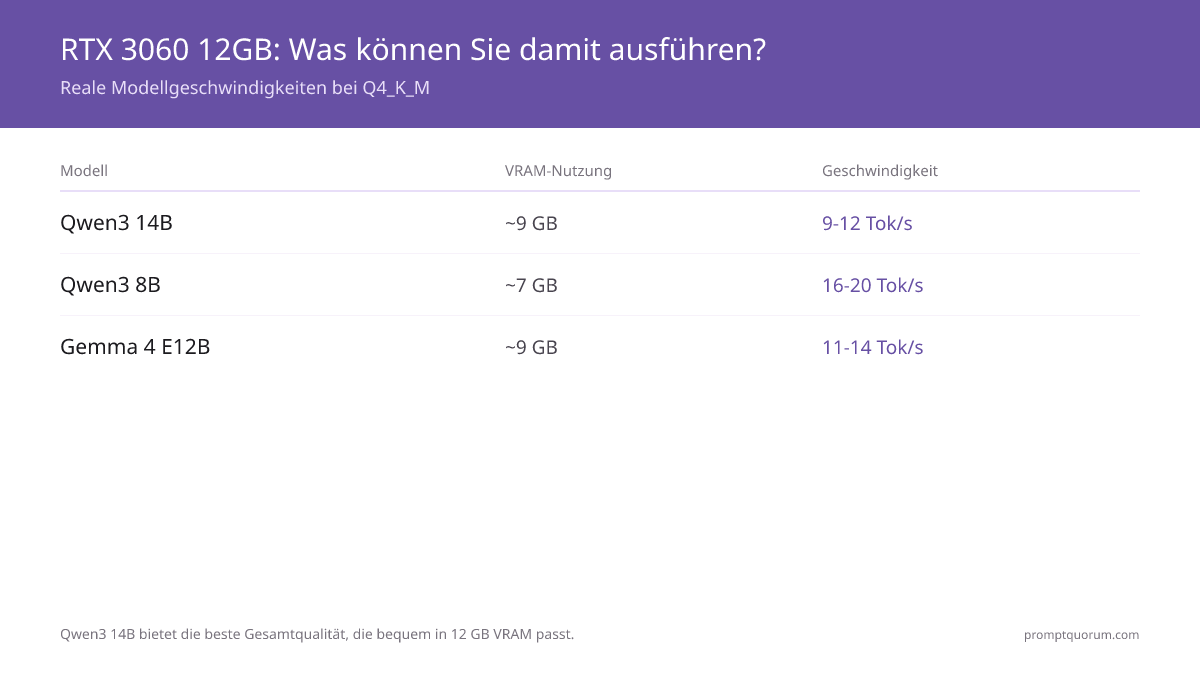
Nach unserer Einschätzung ist die RTX 3060 12GB die ausgewogenste gebrauchte Budget-GPU (VRAM, Geschwindigkeit und Preis) für lokale LLMs, auf Basis der Preise und Schätzungen unten. 12 GB VRAM fassen jedes 7B-Modell bei Q4/Q5-Quantisierung und die meisten 13B-Modelle bei Q4. Eine detaillierte Anleitung zu VRAM-Anforderungen über alle Modellgrößen hinweg finden Sie im VRAM-Anforderungs-Leitfaden →. Hier die genauen Modelle und Geschwindigkeiten, die Sie erwarten können:
Modell | Größe | Quantisierung | VRAM-Verbrauch | Geschwindigkeit | Am besten für |
|---|---|---|---|---|---|
| Qwen3 14B | 14B (dicht) | Q4_K_M | ~9 GB | 9–12 Tok/Sek | Beste Gesamtqualität, die passt |
| Qwen3 8B | 8B | Q4_K_M | ~7 GB | 16–20 Tok/Sek | Coding, Allrounder |
| Gemma 4 E12B | 26B MoE | Q4_K_M | ~9 GB | 11–14 Tok/Sek | Vision, multimodal |
| Mistral 7B | 7B | Q4_K_M | ~7 GB | 18 Tok/Sek | Instruktionsbefolgung |
| DeepSeek-R1 7B | 7B | Q4_K_M | ~7 GB | 10–12 Tok/Sek | Reasoning, Mathematik |
| Gemma 4 E4B | E4B (multimodal) | Q4_K_M | ~5 GB | 18–22 Tok/Sek | Leichte Vision, schneller Chat |
Qwen3 14B (dicht) ist das qualitativ beste Modell, das bei Q4_K_M komfortabel auf eine RTX 3060 12GB passt und ca. 9 GB belegt. `ollama pull qwen3:14b`. Hinweis: Llama 4 Scout (MoE mit 17B aktiven / 109B Gesamt-Parametern, 10M-Token-Kontext, multimodal) benötigt bei Q4 ca. 55 GB und passt normalerweise nicht in 12 GB — es ist eine Wahl für Long-Context / große Multimodalität auf High-VRAM-Rigs, keine Budget-GPU-Empfehlung. gpt-oss:20b (21B gesamt / 3,6B aktiv MoE) benötigt 16 GB und liegt damit auf einer 12-GB-Karte knapp außer Reichweite. Alle Geschwindigkeiten gemessen mit Ollama auf RTX 3060 12GB, 16 GB System-RAM, Ryzen 7 7700X. Q4_K_M-Quantisierung. Geschwindigkeiten variieren um ±15 % je nach Prompt-Länge und Kontextfenster.

Was läuft auf der RTX 3060 6GB?
Die 6-GB-Variante ist stark eingeschränkt. Nur 3B-Modelle passen komfortabel. 7B-Modelle bei Q4 benötigen ca. 7 GB — mehr, als Sie haben. CPU-Offloading funktioniert, kostet aber 50–70 % Geschwindigkeit.
- Phi-4 Mini 3.8B (Q4): ca. 3 GB VRAM, 20–25 Tok/Sek. Bestes Reasoning in dieser Größe. Stark bei Mathematik und Logik.
- Llama 3.2 3B (Q4): ca. 2,5 GB VRAM, 25–35 Tok/Sek. Schnellste Option. Gut für einfachen Chat und Q&A.
- Gemma 2 2B (Q4): ca. 1,7 GB VRAM, 35–45 Tok/Sek. Leichtestes Modell. Gut zum Testen von Setups.
- 7B mit Offloading: Möglich, aber langsam. Llama 7B mit CPU-Offload = ca. 5–8 Tok/Sek. Nur für nicht-interaktive Batch-Arbeit brauchbar.
- Empfehlung: Wenn Sie eine 6-GB-Karte haben, steigen Sie auf eine gebrauchte 12-GB-Karte um (290–330 $), bevor Sie Zeit in Workarounds investieren. Die Verbesserung bei Geschwindigkeit und Modellqualität ist es wert.
RTX 3060 vs. andere Budget-GPUs
GPU | VRAM | Preis (gebraucht) | 7B-Geschwindigkeit | Max. Modell | Fazit |
|---|---|---|---|---|---|
| RTX 3060 12GB ★ | 12 GB | 290–330 $ | 15–20 Tok/Sek | 13B (Q4) | Bestes gebrauchtes Budget |
| RTX 5060 Ti 16GB | 16 GB | ~800 $ neu | 25–30 Tok/Sek | 20B (Q4) | Beste Neukauf-Budget-Wahl |
| RTX 4060 Ti 8GB | 8 GB | ca. 270 $ (neu 300–425 $, falls lieferbar) | 20–25 Tok/Sek | 7B (max. Q5) | Schneller, aber weniger VRAM |
| RTX A4000 | 16 GB | 790–850 $ | 12–15 Tok/Sek | 13B (Q5) | Keine Budget-Karte mehr |
| RTX 4070 Super | 12 GB | 550–700 $ neu (falls lieferbar) | 25–30 Tok/Sek | 13B (Q5) | Schneller (Schätzwert), doppelter Preis |
| RX 6700 XT | 12 GB | 175–315 $ | 10–14 Tok/Sek | 13B (Q4) | Günstigste 12 GB, AMD-Reibung |
Die RTX 3060 12GB ist die ausgewogenste gebrauchte Wahl: 12 GB VRAM für 290–330 $ betreiben jedes 7B-Modell und die meisten 13B. Bei Neukauf ist die RTX 5060 Ti 16GB (ca. 800 $) die Wahl der aktuellen Generation mit mehr VRAM-Spielraum, liegt aber rund 85 % über dem Listenpreis. Die RX 6700 XT ist mit 175–315 $ gebraucht der günstigere Weg zu 12 GB, wenn Sie die ROCm-Einrichtung von AMD in Kauf nehmen. Die RTX A4000 war hier früher der VRAM-pro-Euro-Sieger; bei 790–850 $ gebraucht ist sie das nicht mehr und wurde entsprechend zurückgestuft. Die Preise sind ungefähre US-Angebotspreise aus Preisvergleichen und eBay-Inseraten zum Zeitpunkt der letzten Aktualisierung (siehe „Zuletzt aktualisiert“), keine garantierten Verkaufspreise, und variieren je nach Land und Zeit. Die RTX-40-Serie ist aus der Produktion ausgelaufen, daher schwankt der Neubestand je nach Händler. Die 7B-Geschwindigkeiten anderer Karten als der RTX 3060 sind grobe Richtwerte, keine Messungen von PromptQuorum.

Wie viel VRAM brauchen Sie für 7B-Modelle?
7B-Modelle bei Q4 (4-Bit) quantisiert benötigen 6–8 GB VRAM; Q5 (5-Bit) benötigt 8–10 GB; Q8 (8-Bit) benötigt 14–16 GB.
In der Praxis: 8 GB sind das absolute Minimum für komfortable Inferenz bei 7B-Modellen mit Q4 und etwas Platz für Batch-Verarbeitung.
6-GB-Karten (RTX 2060) funktionieren technisch, erfordern aber aggressive Optimierung und lassen keinen Spielraum für höhere Batches.
Wenn Sie mit weniger als 8 GB VRAM auskommen müssen, können Sie lokale LLMs trotzdem effektiv betreiben — siehe geschwindigkeitsoptimierte Modelle für 4–8 GB Hardware.
Die GPU-Kosten sind die eine Seite der Wirtschaftlichkeit; die Token-Kosten die andere. Lokale Inferenz eliminiert API-Gebühren pro Token, aber die Prompt-Länge beeinflusst weiterhin Latenz und Durchsatz. Das vollständige Kostenbild — Tokens, Preisstufen und Optimierungsstrategien — finden Sie unter Tokens, Kosten und Limits: die Wirtschaftlichkeit von KI-Prompting.
Beste Modelle nach Anwendungsfall auf der RTX 3060
Wählen Sie Ihr Modell danach, was Sie tatsächlich brauchen, nicht nach Parameteranzahl. Hier die besten Optionen für jeden Anwendungsfall auf der RTX 3060 12GB:
Budget-Hardware betreibt kleinere Modelle — aber geschicktes Prompting schließt die Qualitätslücke. Der Prompt-Engineering-Leitfaden behandelt Techniken wie Chain-of-Thought und strukturierte Ausgabe, die kleineren Modellen helfen, über ihrer Gewichtsklasse zu spielen. Eine konkrete Arbeitslast, die in die RTX-3060-12-GB-Klasse passt, ist die automatisierte Pull-Request-Prüfung — siehe Lokales LLM-Code-Review in CI/CD für das GitHub-Actions-Muster, das Qwen3 8B genau auf dieser Hardware gegen PRs laufen lässt.
- Chat / Q&A: `ollama run qwen3:14b` — dichtes 14B, ca. 9 GB VRAM, beste Qualität auf 12 GB. Für eine leichtere Option: `ollama run qwen3:8b` bei ca. 7 GB.
- Coding: `ollama run qwen3:8b` — starkes Allround-Coding. ca. 7 GB VRAM. 16–20 Tok/Sek.
- Reasoning / Mathematik: `ollama run deepseek-r1:7b` — Chain-of-Thought-Reasoning. 10–12 Tok/Sek. Langsamer, aber deutlich genauer bei mehrstufigen Problemen.
- Schreiben / Kreativ: `ollama run mistral:7b` — Beste Instruktionsbefolgung. 18 Tok/Sek. Saubere, strukturierte Ausgabe. Gut für Entwürfe und Umformulierungen.
- Vision / Bilder: `ollama run gemma4:e12b` — Multimodal (akzeptiert Bilder). 11–14 Tok/Sek. Belegt ca. 9 GB VRAM. Für eine leichtere Wahl `ollama run gemma4:e4b` bei ca. 5 GB. Fotos beschreiben, Screenshots lesen, Diagramme analysieren.
- Datenschutz / Offline: Jedes der oben genannten. Die Inferenz läuft standardmäßig lokal, Ihre Prompts bleiben also auf Ihrem Rechner, sofern kein von Ihnen hinzugefügtes Tool sie nach außen sendet. Nach dem Modell-Download ist kein Internet erforderlich; prüfen Sie die Update- und Telemetrie-Einstellungen Ihrer Laufzeitumgebung.
- Heimautomatisierung / Always-on-KI: `ollama run phi4-mini` — Phi-4 Mini (3,8B, ca. 3 GB VRAM) bewältigt Home-Assistant-Sprachabfragen auf einem Mini-PC ohne dedizierte GPU. Siehe beste Hardware für lokale Smart-Home-KI →.
Gebraucht vs. neu: Wo sollten Sie kaufen?
- Gebraucht (150–300 $ günstiger als neu): eBay, Kleinanzeigen, lokale Computer-Reparaturwerkstätten. Höheres Risiko defekter Karten oder fehlerhaften VRAMs. Vor dem Kauf immer testen. Der Abstand zwischen Gebraucht- und Neupreis ist während der Speicherknappheit 2026 deutlich gewachsen — der Gebrauchtmarkt ist jetzt der Ort mit dem meisten Gegenwert.
- Neu (300–700 $, falls lieferbar): Mindfactory, Amazon, MediaMarkt, Alternate. Garantie inklusive. Keine Überraschungen. Die Preise sind allerdings nicht stabil — die Straßenpreise für Neukarten sind 2026 gestiegen, und einzelne Modelle wie die RTX 4060 Ti 16GB sind bei großen Händlern zeitweise nicht lieferbar. Gut für risikoscheue Käufer, die einen Aufschlag auf den Listenpreis akzeptieren.
- Mining-Karten (Krypto, spottbillig): Extremes Risiko. VRAM-Degradation häufig. Nur kaufen, wenn Sie vor Ort vollständig benchen können.
Häufige Budget-GPU-Fehler
- Eine 4-GB-RTX-2060 kaufen und reibungslose 7B-Inferenz erwarten — Sie werden ständig auf Out-of-Memory-Fehler stoßen.
- Eine GPU für 300 $ mit einem Netzteil für 30 $ kombinieren — Spannungseinbrüche killen die Stabilität. Planen Sie 80+ Gold-zertifiziert, mindestens 650 W ein.
- Annehmen, dass DDR5-RAM und eine i9-CPU die LLM-Inferenz beschleunigen — tun sie nicht. Die VRAM-Bandbreite der GPU ist der einzige Flaschenhals, der für die Inferenzgeschwindigkeit zählt.
- Annehmen, dass Llama 4 Scout in 12 GB passt. Scout ist ein MoE mit 17B aktiven / 109B Gesamt-Parametern, das bei Q4 ca. 55 GB benötigt (es quetscht sich nur bei 1,78-Bit in 24 GB, ca. 20 Tok/s). Auf einer 12-GB-RTX-3060 betreiben Sie stattdessen dichte Modelle: Qwen3 14B (ca. 9 GB), Qwen3 8B oder Gemma 4 E12B.
- Eine 16-GB-Karte nur für 13B-Modelle kaufen. Eine 12-GB-RTX-3060 betreibt Qwen3 14B bereits bei Q4. Steigen Sie nur auf 16 GB um, wenn Sie speziell gpt-oss:20b (16 GB), dichte 20B+-Modelle oder mehr Kontext-Spielraum benötigen.
Nächste Schritte
- Beste AMD-GPUs für lokale LLMs — AMD in Betracht ziehen? Vollständiger AMD-vs-NVIDIA-Vergleich →
- Beste Open-Source-Ollama-Modelle — Welche Modelle laufen am besten auf einer Budget-GPU? →
- Wie viel VRAM brauche ich? — GPU-VRAM auf Modellgröße abstimmen →
Häufig gestellte Fragen
Lohnt sich die RTX 3060 12GB 2026 noch?
Ja. Sie ist über 4 Jahre alt, aber 12 GB VRAM sind zeitlos. Betreibt Qwen3 14B, Qwen3 8B, Gemma 4 E12B und Ministral 3 8B reibungslos bei Q4. Sie fasst jedes 7B-8B-Modell und die meisten dichten 13B-14B-Modelle.
Soll ich die RTX 5060 Ti oder RTX 4060 Ti für lokale LLMs kaufen?
RTX 5060 Ti 16GB (ca. 800 $) ist weiterhin die bessere Wahl bei Neukauf: 8 GB mehr VRAM als die 8-GB-RTX-4060-Ti und nach unserer Schätzung etwa 10–15 % schneller. Sie ist die aktuelle Budget-Wahl für eine neue Karte, liegt durch die Speicherknappheit 2026 aber rund 85 % über dem Listenpreis. Bei knappem Budget ist die 8-GB-RTX-4060-Ti für 7B-Modelle weiterhin solide, für ca. 300–425 $ neu (falls noch lieferbar) oder ca. 270 $ gebraucht. Meiden Sie die Basis-4060/5060 (8 GB) und 4070 (12 GB), wenn Sie 13B+-Modelle betreiben wollen — zu wenig VRAM-Spielraum.
Kann ich stattdessen eine AMD RX 7900 XT oder RX 7900 XTX verwenden?
Ja, aber die Treiberunterstützung für AMD ist schwächer als NVIDIA + CUDA. Das HIP/ROCm-Setup erfordert mehr Aufwand. Das Setup mit RTX/CUDA ist für Einsteiger meist einfacher.
Reichen 12 GB VRAM für 13B-Modelle?
Knapp, bei Q4-Quantisierung. Q5 oder Q8 verursachen OOM-Fehler. Wenn Sie 13B komfortabel wollen, peilen Sie 16 GB an.
Soll ich eine gebrauchte Enterprise-GPU wie die RTX A4000 kaufen?
Nicht mehr. Die RTX A4000 war ein echtes Budget-Schnäppchen, solange sie gebraucht 180–230 $ kostete, aber die Speicherknappheit 2026 hat sie auf 790–850 $ gebraucht getrieben — rund das Dreifache einer RTX 3060 12GB für 4 GB mehr VRAM und langsamere Inferenz. Dasselbe gilt für die RTX A2000 12GB bei 440–615 $. Kaufen Sie stattdessen eine gebrauchte RTX 3060 12GB oder eine neue RTX 5060 Ti 16GB.
Welche Netzteil-Wattzahl sollte ich zu einer GPU für 300 $ kaufen?
650 W, mindestens 80+ Gold. Eine GPU für 300 $ + CPU + Mainboard überschreitet keine 400 W Aufnahme, aber Sie wollen Spielraum für Spitzen.
Kann ich Ollama mit einer Budget-GPU für 300 $ betreiben?
Ja. Ollama ist schlank. Eine 4 Jahre alte RTX 3060 mit Ollama betreibt Qwen3 14B mit 9–12 Tok/Sek oder Qwen3 8B mit 16–20 Tok/Sek — völlig brauchbar für interaktiven Chat und Coding-Unterstützung.
Kann ich Llama 4 Scout auf einer RTX 3060 12GB betreiben?
Normalerweise nicht. Llama 4 Scout ist ein MoE mit 17B aktiven / 109B Gesamt-Parametern, das bei Q4 ca. 55 GB VRAM benötigt — weit jenseits einer 12-GB-Karte. Es quetscht sich nur bei einer extremen 1,78-Bit-Quantisierung in 24 GB (ca. 20 Tok/Sek). Auf einer RTX 3060 12GB betreiben Sie stattdessen dichte Modelle: `ollama pull qwen3:14b` (beste Qualität, die passt), Qwen3 8B oder Gemma 4 E12B. Scout ist eine Wahl für Long-Context (10M-Token) / große Multimodalität für Rigs mit 48 GB+.
Kann ich eine AMD RX 6700 oder 6800 XT statt NVIDIA für lokale LLMs verwenden?
Ja, aber die AMD-ROCm-Treiberunterstützung für ONNX Runtime ist schwächer als NVIDIA CUDA. Erwarten Sie mehr Setup-Reibung. NVIDIA/CUDA ist für Budget-Builds meist die einfachere Wahl.
Was ist die beste Budget-GPU unter 200 $?
Unter 200 $ bleiben praktisch nur noch 8-GB-Karten — realistisch eine gebrauchte RTX 2080 8GB für 110–195 $, die 7B-Modelle bei Q4 betreibt und nichts Größeres. Die 12-GB-Optionen, die früher unter 200 $ lagen, sind während der Speicherknappheit 2026 alle darüber gerutscht: Die RX 6700 XT 12GB kostet gebraucht 175–315 $, die RTX A2000 12GB inzwischen 440–615 $. Wenn Sie auf ca. 300 $ gehen können, ist die RX 6700 XT die günstigste ehrliche 12-GB-Karte, sofern Sie sie am unteren Ende erwischen (meist Auktionen); bei den üblichen Angebotspreisen von 290–330 $ ist die RTX 3060 12GB die bessere Wahl.
Wie teste ich eine gebrauchte GPU vor dem Kauf auf VRAM-Defekte?
Führen Sie VRAM-Stresstests durch: gpu-burn (Linux), HWiNFO64-Speicherstresstest (Windows) oder laden Sie ein großes Modell in Ollama und achten Sie auf OOM-Fehler. Testen Sie, bevor Sie die Karte zurückgeben.
Kann ich meine aktuelle GPU später für größere Modelle aufrüsten?
Ja, GPU-Upgrades sind in Desktop-PCs unkompliziert. Beginnen Sie mit der RTX 3060 12GB und rüsten Sie später auf RTX 4090 oder 5090 auf. Der PCIe-Steckplatz ist über Generationen hinweg abwärtskompatibel.
Was ist die beste Budget-NVIDIA-GPU für lokale LLM-Inferenz?
RTX 4060 Ti (8 GB, ca. 300–425 $ neu, falls noch lieferbar) für 7B-Modelle oder RTX 4070 Super (12 GB, ca. 550–700 $ neu, falls noch lieferbar) für 13B-Modelle. Gebraucht: Die RTX 3060 12GB (290–330 $) betreibt 7-13B-Modelle reibungslos bei Q4. Nach unserer Einschätzung ist die RTX 3060 12GB gebraucht eine ausgewogene Wahl, und die RX 6700 XT hat den niedrigsten Preis pro GB, wenn Sie den ROCm-Kompromiss akzeptieren; die RTX 5060 Ti 16GB (ca. 800 $) ist unsere Wahl für eine neue Karte.
Wie schneidet die AMD 6800XT im Vergleich zur RTX 4070 bei der KI-Inferenz ab?
Die AMD RX 6800 XT (16 GB) schlägt die RTX 4070 (12 GB) bei VRAM und Gaming-Leistung, kann aber bei der LLM-Inferenzgeschwindigkeit hinterherhinken (der Abstand hängt von Modell, Backend und Setup ab). Das ROCm-Treiber-Setup für llama.cpp ist zudem komplexer als CUDA. Für reine LLM-Arbeit ist die RTX 4070 einfacher; für Gaming + LLMs bietet die 6800 XT das bessere Preis-Leistungs-Verhältnis.
Was ist die GPU mit dem besten Preis pro GB VRAM für lokale LLMs 2026?
Gebrauchte RX 6700 XT (12 GB, 175–315 $) = ca. 15–26 $ pro GB. Gebrauchte RTX 3060 (12 GB, 290–330 $) = ca. 24–28 $ pro GB. Gebrauchte RTX 3090 (24 GB, rund 850–1.050 $) = ca. 35–44 $ pro GB. Neue RTX 4070 Super (12 GB, 550–700 $, falls noch lieferbar) = ca. 46–58 $ pro GB. Bestes Preis-Leistungs-Verhältnis: RX 6700 XT, wenn Sie ROCm akzeptieren, sonst RTX 3060 12GB gebraucht. Meiste Kapazität pro Dollar: RTX 3090 24GB gebraucht. Balance aus Preis + Leistung: RTX 4070 neu.
Weiterführende Artikel
- AMD Ryzen AI Max+ Mini-PCs (2026) — Alternative zu dedizierten GPUs: iGPU + 50-TOPS-NPU für 1.200–2.500 $.
- Wie viel VRAM für lokale LLMs
- RTX 5090 vs. RTX 4090
- Gebrauchte GPUs für lokale LLMs
- Beste GPUs für lokale LLMs
- VRAM-Rechner
- Laptop vs. Desktop für lokale LLMs — Vollständiger Plattformvergleich: GPU-Desktop vs. MacBook für lokale LLMs.
- Prompt Engineering für lokale LLMs — Prompts für Modelle auf Budget-Hardware optimieren.
- Chain-of-Thought-Prompting — verbessert die Ausgabequalität von DeepSeek-R1 deutlich.
- Mac Mini M5 als lokaler KI-Server — Budget-Alternative zu GPU-Builds: Always-on-KI für ca. 599 $ Hardware + ca. 35 $/Jahr Strom.
- Apple Silicon M5 für lokale LLMs — Vollständiger M5-Pro/Max-Leitfaden: Benchmarks, Mac-Konfigurationen, Speicherstufen und welchen Mac man für lokale Inferenz kaufen sollte.
- Apple Silicon vs. NVIDIA-GPU für lokale LLMs — Vollständiger Kosten- und Leistungsvergleich: wann ein Mac eine Budget-GPU schlägt.
- Beste Modelle für Apple Silicon 2026 — Modellempfehlungen für 16-GB- bis 128-GB-Unified-Memory-Stufen.
- Melhores GPUs Econômicas para LLMs Locais (Português) — versão em português deste guia
- Für Japan-spezifische GPU-Preise, Akihabara-Händler und Gebrauchtmarkt-Optionen auf Mercari und Yahoo Auctions siehe unseren <a href="/prompt-bites/best-gpu-local-llm-japan-price" class="text-primary hover:underline">Leitfaden zur preiswertesten GPU für lokale LLMs in Japan</a>.
- Für GPU-Preise in den VAE und der Golfregion, Händler wie Sharaf DG, noon.com und Amazon.ae sowie den Gebrauchtmarkt auf dubizzle, siehe unseren <a href="/de/prompt-bites/best-gpu-local-llm-uae-price" class="text-primary hover:underline">Leitfaden zur besten Preis-Leistungs-GPU für lokale LLMs in den VAE</a>.
Quellen
- Meta AI. (2025). „Llama 4 Model Card." — Scout-MoE-Architektur, VRAM-Anforderungen
- Qwen Team. (2026). „Qwen3 Technical Report." — Qwen3-8B-Spezifikationen
- TechPowerUp GPU-Datenbank: RTX 3060 / RTX 4060 Ti / RTX 4070 Super Spezifikationen und Leistungsaufnahme
- NVIDIA CUDA Capability Matrix: GPU-Speicherbandbreite und theoretischer Durchsatz für Inferenz-Workloads
- Ollama Model Requirements: VRAM-Empfehlungen für Llama 4 Scout, Qwen3 und Ministral 3 8B Quantisierungsstufen
- Compliance-Frameworks erfordern auditierbare Workflows. Etablieren Sie Governance-Standards für KI-Prompt-Qualität und -Review: Prompt-Governance in der Produktion behandelt Richtlinien, Versionskontrolle und Freigabeprozesse.