Wichtigste Erkenntnisse
- 7B-Modelle: Zu schwach. Erkennen ~45% der Fehler -- nur oberflächliches Feedback.
- 13B-14B-Modelle: DeepSeek-R1 14B erkennt ~75% der Fehler durch Chain-of-Thought. Akzeptabel für algorithmische Überprüfung.
- 32B-Modelle: Qwen2.5-Coder 32B erkennt ~88% der Fehler bei 20 GB RAM. Praktische Mindestanforderung für Pre-Merge-Review.
- 70B+-Modelle: Llama 3.3 70B erkennt ~85% der Fehler. Beste für Sicherheitsanalyse und Multi-File-Architektur-Review.
- Insgesamt am besten: Qwen2.5-Coder 32B (88% Fehler, 20 GB RAM). Beste 70B: Llama 3.3 70B (Sicherheit). Beste Reasoning: DeepSeek-R1 14B (Algorithmen).
- Setup: vLLM + benutzerdefinierte Prompt-Vorlage. Qwen2.5-Coder 32B für allgemeines Review; Llama 3.3 70B für sicherheitssensitiven Code.
- Latenz: 70B benötigt 2-3 Min pro 500-Zeilen-Datei. 32B benötigt ~60 Sekunden. Batch-Verarbeitung reduziert Gesamtzeit.
- Kosten: Null (Open Source) vs. €45/Monat (GitHub Copilot Code Review).
📍 In einem Satz
Die besten lokalen LLMs für Code Review sind Qwen2.5-Coder 32B für die Gesamtgenauigkeit, Llama 3.3 70B für Sicherheitsanalysen und DeepSeek-R1 14B für algorithmische Überprüfungen; 7B-Modelle erkennen nur etwa 45 % echter Fehler, während 32B+-Modelle 80-88 % erkennen und das praktische Minimum vor dem Mergen sind.
💬 In einfachen Worten
Bei Code Reviews spielt die Modellgröße eine größere Rolle als bei den meisten anderen Aufgaben -- ein kleines 7B-Modell übersieht mehr als die Hälfte der echten Fehler, was vor dem Mergen von Code nicht vertrauenswürdig genug ist. Wer ein lokales Modell möchte, das Probleme wirklich zuverlässig erkennt, sollte bei 32B oder größer anfangen, wobei sich verschiedene Modelle in unterschiedlichen Bereichen auszeichnen: allgemeine Genauigkeit, Sicherheitsprobleme oder algorithmische Logik.
Warum Modellgröße bei Code Review wichtig ist
7B-Modelle mangelt es an Reasoning-Tiefe. Sie erkennen offensichtliche Syntaxfehler, verpassen aber:
- Race Conditions (Concurrency-Bugs)
- SQL-Injection-Anfälligkeit
- Off-by-One-Fehler in Schleifen
- Typverwechslungen in dynamisch typisierten Sprachen
13B-14B-Modelle verstehen grundlegende Logik, kämpfen aber mit:
- Architektonischen Anti-Patterns
- Leistungsimplikationen (Cache Misses, O(n²)-Algorithmen)
- Sicherheits-Edge-Cases
32B+-Modelle sind ausgezeichnet bei:
- Refactoring-Vorschläge (Extract Method, Zyklomatische Komplexität reduzieren)
- Sicherheitsanalyse (Injection, XSS, CSRF)
- Leistungsoptimierung (Caching, Indexierung, Parallelisierung)
70B-Modelle bieten zusätzlich:
- Multi-File-Architektur-Review (128K-Kontext)
- Tiefe Sicherheitsmuster-Erkennung über ganze Codebasen
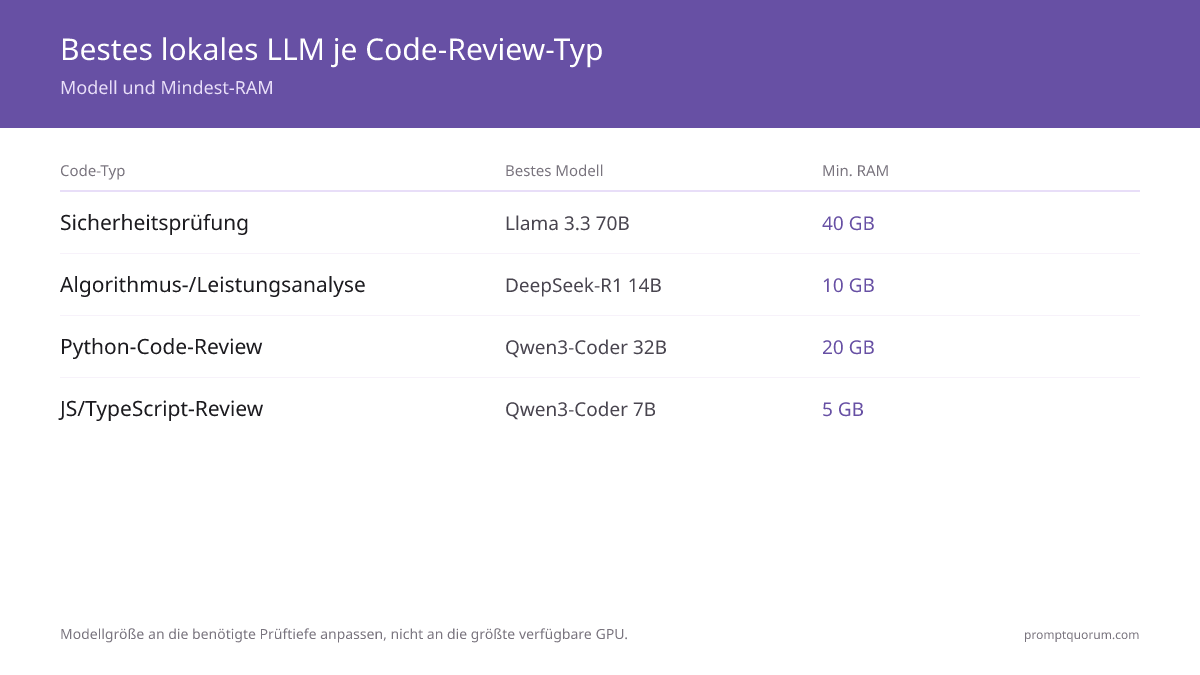
Modellvergleichstabelle
Code-Typ | Bestes Modell | Min. RAM | Begründung |
|---|---|---|---|
| Sicherheitsüberprüfung (Injection, XSS, CSRF) | Llama 3.3 70B | 40 GB | Höchste Sicherheitsmuster-Erkennung |
| Algorithmus- und Leistungsanalyse | DeepSeek-R1 14B | 10 GB | Chain-of-Thought für O(n)-Analyse |
| Python-Code-Review | Qwen2.5-Coder 32B | 20 GB | Höchster HumanEval bei zugänglichem RAM |
| JavaScript/TypeScript | Qwen2.5-Coder 7B | 5 GB | FIM-Unterstützung, starke TS-Typanalyse |
| Schnelles Lint-Level-Feedback | Llama 3.1 8B | 6 GB | Schnell, akzeptabel für Style-Review |
| Multi-File-Architektur-Review | Llama 3.3 70B | 40 GB | 128K-Kontext bearbeitet ganze Codebasen |

Genauigkeit vs Geschwindigkeit - Abwägungen
Geschwindigkeit pro Datei: Qwen2.5-Coder 7B ~15 Sekunden/500 Zeilen. Qwen2.5-Coder 32B ~60 Sekunden/500 Zeilen. Llama 3.3 70B ~120 Sekunden/500 Zeilen.
Genauigkeit (erkannte Fehler): Qwen2.5-Coder 7B ~60%. Qwen2.5-Coder 32B ~88%. Llama 3.3 70B ~85%.
Wann 7B verwenden: Schnelles Feedback während der Entwicklung, nicht kritische Code-Pfade.
Wann 32B verwenden: Pre-Commit-Hooks, allgemeines Python/TypeScript-Review, die meisten täglichen Review-Aufgaben.
Wann 70B verwenden: Sicherheitssensitiver Code, öffentliche APIs, Multi-File-Architektur-Analyse.
Optimaler Workflow: Qwen2.5-Coder 7B für Echtzeit-IDE-Feedback; Qwen2.5-Coder 32B für Pre-Commit-Review; Llama 3.3 70B für Sicherheitsaudits.

Setup: Lokale Code-Review-Pipeline
- 1Starten Sie vLLM mit Qwen2.5-Coder 32B: `python -m vllm.entrypoints.openai.api_server --model Qwen/Qwen3-Coder-32B-Instruct`
- 2Schreiben Sie einen fokussierten Review-Prompt: "Überprüfen Sie diesen Code auf Fehler, Sicherheitsprobleme und Refactoring-Vorschläge. Fokus auf [ISSUE_TYPE]. Output: Severity (critical/warning/info), Zeilennummer, Problembeschreibung, Lösungsvorschlag."
- 3Integration in Git Pre-Commit-Hook: `pre-commit`-Hook ruft die API mit dem Diff oder Patch für gestaffelte Dateien auf.
- 4Batch-Anfragen: Gruppieren Sie Dateien nach Verzeichnis, senden Sie 3-5 Dateien pro Anfrage (vLLM verarbeitet parallel innerhalb eines Batch).
- 5Antwort analysieren: Extrahieren Sie Vorschläge nach Severity (critical, warning, info).
- 6Ausgabe formatieren: Posten Sie Ergebnisse als PR-Kommentare oder Inline-Vorschläge über GitHub Actions.
Code Review mit lokalen LLMs: Regionaler Kontext
EU / GDPR + Sicherheit
Für EU-Software-Teams, die Code überprüfen, der mit persönlichen Daten arbeitet, bedeutet die lokale Ausführung von Code Review, dass der Quellcode selbst -- der möglicherweise gehärtete Anmeldedaten, personenbezogene Daten in Test-Fixtures oder Datenverarbeitungslogik enthält -- die Infrastruktur der Organisation nie verlässt. GDPR Artikel 32 verlangt angemessene technische Sicherheitsmaßnahmen; das Senden von proprietärem Quellcode an Cloud-AI-APIs schafft eine zusätzliche Datenverarbeiter-Beziehung nach Artikel 28.
Für deutsche BSI-konforme Softwareentwicklungsumgebungen: Qwen2.5-Coder 32B (Apache 2.0) und Llama 3.3 70B (Meta Llama Community Licence) laufen vollständig vor Ort. Der EU AI Act (ab Februar 2025) klassifiziert KI-gestützte Code Review für kritische Infrastruktur möglicherweise als hohes Risiko -- lokale Inferenz hält den Prozess innerhalb Ihres bestehenden Sicherheitsperimeters. BSI-Grundschutz-Kataloge (BSI-Kataloge) für deutsche Organisationen erfordern dokumentierte Kontrollen über externe Verarbeitungsprozesse; lokale Modelle erfüllen diese Anforderungen natürlich.
Japan (METI)
Japanische Enterprise-Software-Teams unterliegen METI-Cybersecurity-Richtlinien, die zunehmend Richtlinien zur Nutzung von AI-Tools enthalten. Für japanische Teams unterstützt Qwen3-Coder japanische Kommentare und Variablennamen-Konventionen nativ -- nützlich für Codebasen mit japanischer Inline-Dokumentation. METI-AI-Governance erfordert die Dokumentation von verwendeten AI-Tools in der Softwareentwicklung: Modellname, Version (Ollama-Tag) und Quantisierungsstufe in Code-Review-Pipelines aufzeichnen.
China
Nach Chinas Data Security Law (数据安全法) darf Quellcode für kritische Informationsinfrastruktur-Systeme nicht von ausländischen Cloud-Services verarbeitet werden. Lokale Code Review über Qwen3-Coder (Alibaba, Apache 2.0) erfüllt diese Anforderung. Qwen2.5-Coder 32B läuft auf einer Dual-RTX-4090-Workstation (48 GB VRAM) und verarbeitet Python-, Java-, C++- und Go-Code mit nativer Unterstützung für chinesische Kommentare.
Häufige Fehler
- Verwendung von 7B-Modellen für Sicherheitsüberprüfung. Überall Falsch-Positive; Entwickler ignorieren schließlich alle Rückmeldungen.
- Review ohne Kontext. Review einer einzelnen Funktion verpasst architektonische Probleme. Übergeben Sie immer verwandte Dateien, Imports und Typ-Definitionen.
- Keine Angabe des Problem-Typs. "Überprüfe diesen Code" ist zu vage. Verwenden Sie "Prüfe auf SQL-Injection-Anfälligkeiten" oder "Schlag Leistungsoptimierungen für diese Schleife vor".
- Verwendung von Llama 3.3 70B für jeden Review-Task, wenn ein kleineres Modell ausreichend ist: Llama 3.3 70B benötigt 2-3 Minuten pro 500-Zeilen-Datei auf den meisten Hardware-Setups. Für Style-Feedback und offensichtliche Fehler erledigt Qwen2.5-Coder 7B denselben Review in ~15 Sekunden bei 60-65% Genauigkeit. Reservieren Sie 70B für sicherheitssensitiven Code und Pre-Merge-Review; verwenden Sie 7B für Echtzeit-IDE-Feedback.
- Nicht-Setting num_ctx für Multi-File-Review: Ollama standardmäßig auf 2048 Token Kontext -- unzureichend für die meisten Code-Dateien. Für Code Review setzen Sie `PARAMETER num_ctx 32768` mindestens in Ihrer Modelfile. Für Multi-File-Architektur-Review verwenden Sie 128K-Kontext mit einem 70B-Modell. Ohne explizite Kontext-Konfiguration schneidet das Modell Code jenseits von 2048 Token stillschweigend ab und verpasst Fehler in späteren Abschnitten.
Weiterführende Ressourcen
- Beste lokale LLMs für Codierung -- umfassender Benchmark-Vergleich von Coding-Modellen bei 7B, 14B, 32B und 70B Tiers
- LLM-Quantisierung erklärt -- RAM-Anforderungen bei Q4_K_M für 32B und 70B Modelle in Code-Review-Pipelines
- Wie man 70B-Modelle auf Consumer-Hardware lädt -- VRAM und Hardware-Anforderungen für lokales Ausführen von Llama 3.3 70B für Code Review
- Lokale LLM OpenAI-kompatible API -- verbinden Sie Ihr lokales Code-Review-Modell mit VS Code, Cursor oder CI/CD-Pipelines
- Beste lokale LLMs 2026 -- vollständige Modell-Rankings über alle Task-Typen einschließlich Coding-Benchmarks
- Troubleshooting für lokales LLM Setup -- beheben Sie OOM-Fehler beim Ausführen von 32B oder 70B Modellen für Code Review
Häufig gestellte Fragen
Kann ich ein 13B-Modell für Code Review verwenden?
Ja für Linting-Level-Feedback -- Style und offensichtliche Fehler. Für Sicherheits- und Leistungs-Review verwenden Sie 32B+. Qwen2.5-Coder 32B bei 20 GB RAM ist die praktische Mindestanforderung für ernsthaften Code Review.
Wie viele Dateien kann ich parallel überprüfen?
vLLM Standard batch=32. Bei 70B-Modellen ist batch=1 pro Datei realistisch. Verarbeiten Sie 5-10 Dateien sequenziell für vollständiges Review in 10-15 Min.
Ist Llama 3.3 70B besser als DeepSeek für Code Review?
DeepSeek-R1 14B ist besser für Mathematik und Algorithmus-Optimierung aufgrund von Chain-of-Thought-Reasoning. Llama 3.3 70B ist besser für Sicherheitsanalyse. Qwen2.5-Coder 32B übertrifft beide bei reinen Code-Completion-Benchmarks bei niedrigerem RAM.
Kann ich lokale Modelle für Pair Programming verwenden?
Ja. Verwenden Sie Qwen2.5-Coder 7B für Echtzeit-Vorschläge (schnell, ~15 Sekunden pro Datei). Aktualisieren Sie alle 5 Minuten während sich Code ändert. Für tiefergehendes Feedback nutzen Sie Batch-Review mit Qwen2.5-Coder 32B zwischen Sessions.
Welchen Prompt sollte ich für Code Review verwenden?
System: "Sie sind ein Experten-Code-Reviewer." User: "Überprüfen Sie auf: [Problem-Liste]. Output Severity (critical/warning/info), Zeilennummer, Fehler und Lösungsvorschlag. Code: [Code]"
Wie vermeide ich halluzinierte Fehler?
Bieten Sie vollständigen Kontext -- Imports, Typen und verwandte Funktionen. Halluzinationen nehmen deutlich bei größeren Modellen ab. Qwen2.5-Coder 32B halluziniert weit weniger als 7B-Modelle bei Code-Review-Tasks.
Muss ich bei der Verwendung von Qwen3-Coder die DSGVO beachten?
Ja. Bei Code Review mit persönlichen Daten ist DSGVO Artikel 28 (Datenverarbeiter) und Artikel 32 (Sicherheitsmaßnahmen) relevant. Lokale Inferenz mit Qwen2.5-Coder 32B erfüllt diese Anforderungen: Der Code verlässt Ihre Infrastruktur nicht, und Sie kontrollieren alle Sicherheitsmaßnahmen. Dokumentieren Sie die Verwendung für BSI-Grundschutz-Katalog-Compliance.
Ist Qwen3-Coder für den deutschen Mittelstand geeignet?
Ja, sehr. Qwen2.5-Coder 32B auf einer Dual-RTX-4090-Workstation (48 GB VRAM) kostet ~€2000 einmalig und keine laufenden API-Gebühren. Für deutsche Mittelstand-Unternehmen erfüllt lokale Inferenz BSI IT-Sicherheitsstandards, DACH-Compliance-Anforderungen und bietet vollständige Datenkontrolle. Perfect fit für Unternehmen mit strengen Datenschutz-Anforderungen.
Wie viel VRAM benötigt Llama 3.3 70B für Code Review?
Bei Q4_K_M-Quantisierung ungefähr 40 GB VRAM. Ein Dual-GPU-Setup (2× RTX 4090, 48 GB gesamt) oder Mac Studio M5 Max (bis zu 128 GB unified memory) funktioniert. CPU-Only-Inferenz ist mit 48+ GB RAM möglich bei 5-10 Tokens/Sekunde.
Ist Qwen3-Coder besser als Llama 3.3 für Python-Code-Review?
Ja für reine Coding-Tasks. Qwen2.5-Coder 32B erzielt höhere HumanEval-Scores und unterstützt FIM (Fill-in-the-Middle) für Code-Completion. Llama 3.3 70B ist besser für Sicherheitsanalyse von Python-Code. Für Python-spezifisches Review mit angemessenem RAM (20 GB) ist Qwen2.5-Coder 32B die empfohlene Wahl.
Quellen
- Qwen Team. (2025). "Qwen3-Coder Technical Report." arxiv.org/abs/2409.12186 -- HumanEval- und Code-Completion-Benchmarks für Qwen3-Coder bei allen Größen-Stufen.
- Meta AI. (2025). "Llama 3.3 Model Card." huggingface.co/meta-llama/Llama-3.3-70B-Instruct -- Offizielle Spezifikationen und Code-Verständnis-Benchmarks für Llama 3.3 70B.
- DeepSeek AI. (2025). "DeepSeek-R1 Technical Paper." arxiv.org/abs/2501.12948 -- Chain-of-Thought-Architektur und Reasoning-Benchmark-Daten für DeepSeek-R1.