Wichtigste Erkenntnisse
- Mac mini M6 (32 GB max.): 899 $. Apples neuer Einstiegs-Mac-mini (Aug. 2026) — geräuschlos, kompakt, passt nicht für 70B-Modelle.
- Mac mini M5 Pro (64 GB max.): 1.699 $. Einzige neue Mac-mini-Konfiguration mit genug Speicher für 70B-Modelle. Verfügbar ab 22. September 2026 — noch keine unabhängigen Benchmarks.
- Framework Desktop (128 GB): ca. 1.999 €. Erreichte 70B mit über 20 tok/s gegenüber dem vorherigen M4 Pro. Speziell für lokale LLMs entwickelt.
- ASUS PN51 + RTX 5060 Ti: ca. 900 €. Bestes x86-Preis-Leistungs-Verhältnis. 7B bei 25 tok/s, 13B bei 15 tok/s.
- Intel NUC 13 + eGPU: ca. 1.300 €. Premium-Verarbeitungsqualität, Thunderbolt-eGPU verliert 15–25 % Bandbreite.
- Custom-Mini-ITX (Lian Li A4): ca. 1.000–1.400 €. Flexibelste Option, schwierigster Aufbau.
- Vermeiden: Mini-PCs mit ausschließlich integrierter GPU (1–2 tok/s bei 7B), volle ATX-Netzteile (passen nicht), RTX 4090 (zu groß für jedes SFF-Gehäuse).
📍 In einem Satz
Mini-PCs mit moderner Hardware führen 7B-70B-Modelle in kompakter Bauform aus. Nur Konfigurationen mit mehr Speicher wie der Mac mini M5 Pro (64 GB) oder das Framework Desktop (128 GB Unified Memory) bieten genug Spielraum für 70B-Modelle -- günstige Mini-ITX-Builds mit dedizierter GPU decken 7B-13B für unter 1.400 € ab.
💬 In einfachen Worten
Ein Mini-PC ist ein guter Mittelweg zwischen Laptop und ausgewachsenem Desktop-Tower für lokale KI: klein genug, um neben dem Monitor zu stehen, aber leistungsstark genug für echte Modelle bei der richtigen Konfiguration. Entscheidend ist der Speicher -- ein Mini-PC mit nur 32 GB Unified Memory schafft mittelgroße Modelle, einer mit 64 GB oder mehr auch ein 70B-Modell.
Was macht einen Mini-PC für lokale LLMs geeignet?
Ein geeigneter Mini-PC benötigt einen PCIe-x16-Slot, ein 450W+-SFX-Netzteil, aktive Kühlung und eine 1TB+-SSD. Die meisten Consumer-Mini-PCs verfügen über keinen Slot für eine dedizierte GPU — immer vor dem Kauf prüfen.
- PCIe-x16-Slot (volle Länge): Für den Einbau einer dedizierten GPU. Manche Mini-PCs nutzen USB-C-externe Docks — eGPU-Bandbreitenverlust beträgt 15–25 % gegenüber internem PCIe.
- Stromversorgung: Mindestens 450W SFX-Netzteil. RTX 5060 Ti (165 W) + CPU (65 W) + Mainboard (50 W) = 280 W Last, mit Spitzen über 420 W.
- Kühlung: Aktive Gehäuselüfter erforderlich. Passive Kühlung funktioniert bei 3B-Modellen im Leerlauf; anhaltende 7B-Inferenz benötigt erzwungene Luftzirkulation.
- Speicher: Mindestens 1TB SSD. Ein 7B-Modell bei Q4_K_M belegt ~4 GB auf der Festplatte; eine Bibliothek mit 5 Modellen füllt 25 GB.
Mac Mini: M6, M5 Pro und die vorherige Generation
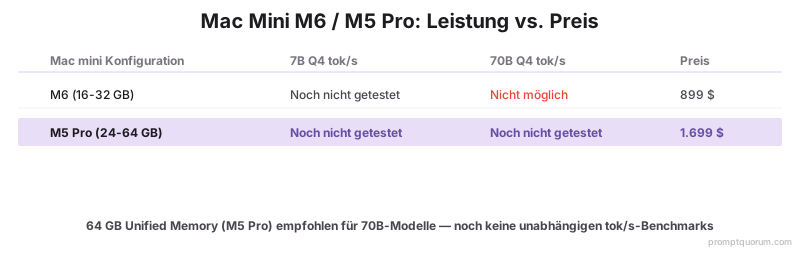
Apple hat den Mac mini am 25. August 2026 aktualisiert: M6-Chip (ab 899 $, Obergrenze 32 GB Unified Memory) und M5-Pro-Chip (ab 1.699 $, Obergrenze 64 GB Unified Memory) — beide ab 22. September 2026 verfügbar und jetzt Apples aktuelle Mac-mini-Reihe. Nur die M5-Pro-Konfiguration erreicht 64 GB; der Basis-M6 ist bei 32 GB gedeckelt, was für 70B-Modelle nicht genug Spielraum bietet. Die auslaufenden Chips M4 (ab 599 $) und M4 Pro (bis 64 GB, bis 2.299 $) sind jetzt die vorherige Generation. Apple gibt an, der M6 sei bei CPU-Aufgaben rund 40 % schneller und bei KI-Workloads bis zu 4× schneller als der auslaufende M4 — eine Marketingaussage von Apple, keine unabhängige Messung, da die neuen Chips noch nicht ausgeliefert wurden.
- Aktuelle Reihe (Aug. 2026): M6 ab 899 $ (32 GB max.) und M5 Pro ab 1.699 $ (64 GB max.) verfügbar ab 22. September 2026. Für 70B-Modelle ist die M5-Pro-Konfiguration erforderlich — der M6 ist bei 32 GB gedeckelt und passt dafür nicht.
- Vorherige Generation: M4 (ab 599 $) und M4 Pro (bis 64 GB, bis 2.299 $) — der 10–15-tok/s-Wert für 70B in der Tabelle oben stammt aus dieser jetzt abgelösten Generation.
- Vorteile: Geräuschlos (kein Lüfterlärm bei Inferenz), kompakte Bauform, macOS + Linux via Asahi, Ollama Metal-GPU-Beschleunigung funktioniert sofort.
- Nachteile: RAM bei keinem der beiden Chips nachrüstbar. Für M6 oder M5 Pro existieren noch keine unabhängigen 70B-tok/s-Benchmarks — beide sind erst ab 22. September 2026 verfügbar. Apples Angabe von ~40 % schnellerer CPU / bis zu 4× schnellerer KI-Leistung beim M6 ist Apples eigene Marketingzahl, keine unabhängige Messung.
- Befehl: `ollama run llama3.3:70b-instruct-q4_K_M` — funktioniert nativ auf Apple Silicon via Metal.
Mac-mini-Konfiguration | Speichergrenze | 7B Q4 tok/s | 70B Q4 tok/s | Preis |
|---|---|---|---|---|
| M4 (16 GB) — Vorgänger | 16 GB | 40–50 | Passt nicht | 599 $ |
| M4 Pro (64 GB) — Vorgänger | 64 GB | 60–80 | 10–15 | 2.299 $ |
| M6 — neu (Aug. 2026) | 32 GB | Noch kein Benchmark | Passt nicht | ab 899 $ |
| M5 Pro — neu (Aug. 2026) | 64 GB | Noch kein Benchmark | Noch kein Benchmark | ab 1.699 $ |
Framework Desktop: AMD Ryzen AI Max 395+
Das Framework Desktop mit AMD Ryzen AI Max 395+ und 128 GB Unified LPDDR5X-Arbeitsspeicher führt Llama 3.3 70B mit über 20 tok/s für ca. 1.999 € aus — Ende 2025 eingeführt und speziell für lokale LLM-Workloads entwickelt. Das Framework Desktop nutzt die Strix-Halo-APU mit 128 GB Unified Memory, der sowohl für CPU als auch für die integrierte Radeon 8060S GPU zugänglich ist. Als erstes Mainstream-PC-Gerät explizit für lokale KI vermarktet.
- CPU: AMD Ryzen AI Max 395+ (16-Kern Zen 5)
- GPU: Radeon 8060S (40 RDNA-3,5-CUs)
- Arbeitsspeicher: 128 GB LPDDR5X Unified (kein separater VRAM)
- Formfaktor: 4,5 L Mini-ITX-Stil
- Leistungsaufnahme: 120 W anhaltend, 200 W Spitze
- Vorteile: 70B mit über 20 tok/s schlug den auslaufenden Mac mini M4 Pro (10–15 tok/s) zu ähnlichem Preis — unabhängige Benchmarks für den neuen M5 Pro Mac mini gibt es noch nicht. Vollständig aufrüstbar (Mainboard, Speicher). Linux-first-Design. Open-Source-Firmware.
- Nachteile: ROCm-Einrichtung für Ollama erforderlich (nicht so schlüsselfertig wie Metal auf dem Mac). Lüfterlärm 40–50 dB unter anhaltender Last. Ende 2025 veröffentlicht — Treiberreife noch in Entwicklung.
Modell | tok/s |
|---|---|
| Llama 3.1 8B Q4 | 45–60 |
| Llama 3.3 70B Q4 | 20–25 |
| DeepSeek-R1 70B Q4 | 18–22 |
| Qwen3 72B Q4 | 22–26 |

Welche Mini-PC-Plattform bietet das beste Preis-Leistungs-Verhältnis?
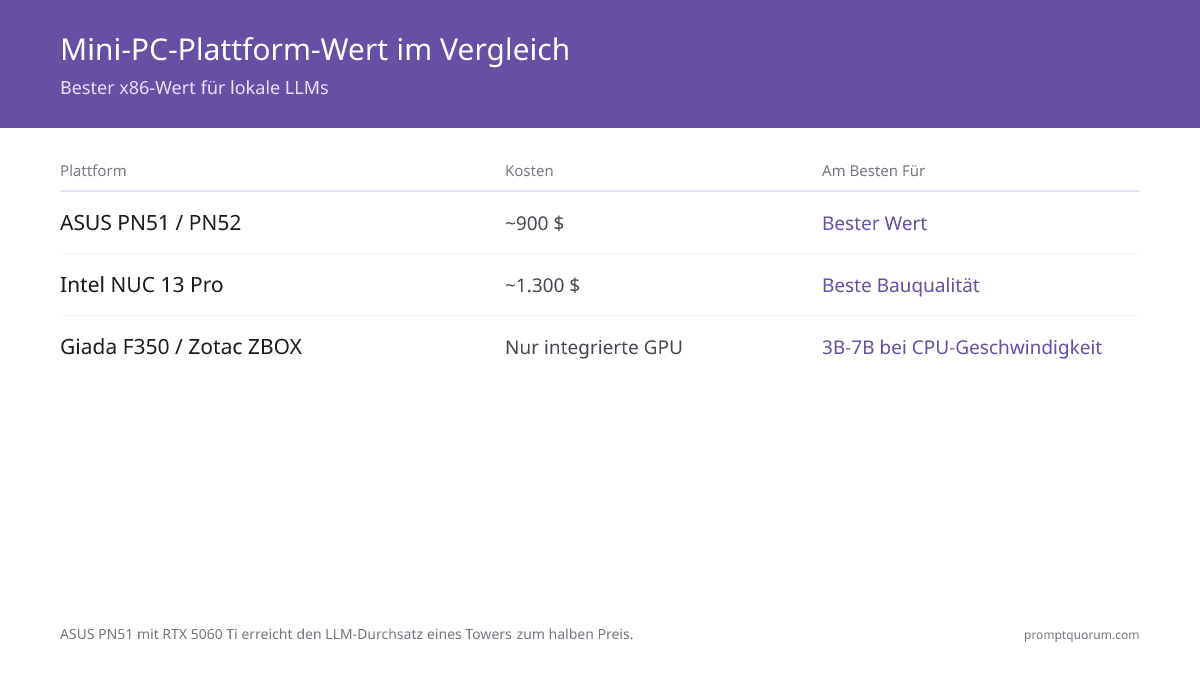
Der ASUS PN51 mit Ryzen 5 und RTX 5060 Ti bietet das beste traditionelle x86-Preis-Leistungs-Verhältnis für ca. 900 € — identischer LLM-Durchsatz wie ein Full-Tower zum halben Preis.
- Intel NUC 13 Pro (Core i7): Kompakte, aufrüstbare 65W-CPU. GPU über Thunderbolt-3-eGPU-Dock. 700 € Basis + 450 € RTX 5060 Ti + 250 € Dock = ca. 1.300 €. Beste Verarbeitungsqualität.
- ASUS PN51 oder PN52 (Mini-ITX-Barebone): Ryzen 5 (150 €) + 32 GB RAM (80 €) + 1TB SSD (70 €) + RTX 5060 Ti (450 €) = ca. 900 €. Bestes Preis-Leistungs-Verhältnis.
- Giada F350 oder Zotac ZBOX Sphere (Fertig-PC): Nur integrierte GPU. Geeignet für 3B–7B bei CPU-Geschwindigkeit. Nicht empfohlen für dedizierte GPU-Inferenz.
- Custom-Mini-ITX-Build (Lian Li A4, Dan A4-H2O): Flexibelste Option, schwierigster Aufbau. ca. 1.000–1.400 € je nach GPU-Wahl.

Welche GPU passt in ein Mini-PC-Gehäuse?
Die RTX 5060 Ti mit 16 GB wurde Ende 2025 zum Mini-ITX-Optimum — passt in alle Gehäuse bei 217 mm, führt 13B bei Q4 mit VRAM-Reserve aus, unter 400 €. Die RTX 5070 funktioniert in den meisten Gehäusen, aber messen — manche Varianten überschreiten 220 mm.
GPU | VRAM | Max. Modell | Passt in Mini-ITX | Preis (2026) |
|---|---|---|---|---|
| RTX 5060 Ti | 16 GB | 13B Q4 | Ja (217 mm) | 350–580 € |
| RTX 5070 | 12 GB | 13B Q4 | Variante prüfen (225 mm) | ca. 600–700 € |
| RTX 4060 Ti | 8 GB | 7B Q4 | Ja (216 mm) | ca. 300–350 € |
| RTX 4070 | 12 GB | 13B Q4 | Variante prüfen (220 mm Limit) | ca. 450–550 € |
| RTX A4000 | 16 GB | 13B (problemlos) | Variante prüfen | ca. 300–400 € gebraucht |

Wie verwaltet man die Kühlung in einem kompakten Mini-PC-Gehäuse?
Erwarten Sie 60–70 °C GPU-Temperatur und 50–60 dB Lüfterlärm bei voller LLM-Inferenzlast. Undervolting senkt die Temperaturen um 5–10 °C ohne messbaren Geschwindigkeitsverlust.
- Thermals: GPU 60–70 °C, CPU 55–65 °C unter anhaltender Inferenz. Nicht gefährlich, aber Lüfter drehen hoch.
- Lärm: RTX 5060 Ti unter Volllast = 50–60 dB (Staubsaugerpegel). Im Büro akzeptabel, in ruhigen Räumen störend.
- Undervolting: Kernspannung um 50 mV über MSI Afterburner (Windows) oder CoreCtrl (Linux) senken. Reduziert Temperaturen um 5–10 °C, Geschwindigkeitsverlust 0–2 %.
- Geräuschloser Betrieb: GPU-Lüfter durch Noctua- oder BeQuiet!-Varianten (50–80 €) ersetzen. Reduziert Lärm um 10–15 dB.

Was sind die Grenzen von Mini-PCs für lokale LLMs?
Traditionelle Mini-ITX-Builds sind auf 13B-Modelle begrenzt (12–16 GB VRAM). Apple Silicon und AMD Ryzen AI Max beseitigen diese Einschränkung mit Unified Memory bis zu 128 GB.
- Traditioneller Mini-ITX-VRAM-Maximalwert: 8–16 GB (nur eine dedizierte GPU). RTX 4090 passt nicht (Dual-Slot, über 280 mm lang).
- Maximale Modellgröße (traditionell): 13B problemlos. 70B erfordert CPU-Offloading und einen 3–5-fachen Geschwindigkeitsverlust.
- Upgrade-Pfad: Begrenzt. GPU-Tausch kann Gehäusemodifikation erfordern. RAM meist nachrüstbar.
- Multi-GPU: Unmöglich in Mini-ITX. Kein Platz für eine zweite dedizierte Grafikkarte.
- Langlebigkeit: Mini-PC-Gehäuse für Bürolas ten ausgelegt, nicht für 24/7-Inferenz. Staubfilter jährlich reinigen.
- Mini-PC-Hardware limitiert die Modellgröße, aber die Modellgröße ist nicht die einzige Einschränkung. Selbst die größten Modelle haben grundlegende Einschränkungen — Halluzinationen, Reasoning-Fehler und Wissenslücken. Siehe was LLMs nicht können für das vollständige Bild.
Regionaler Kontext: Datenhaltung mit Mini-PCs
Mini-PCs mit lokalen LLMs behalten alle Daten On-Premises — kein Datum verlässt das Gerät und erfüllt damit DSGVO, APPI und chinesische DSL-Datenhaltungsanforderungen standardmäßig.
- EU / DSGVO: Lokale Inferenz eliminiert Auftragsverarbeitungsverträge (Artikel 28 DSGVO). Sensible Berufsdaten (rechtlich, medizinisch, finanziell) verbleiben innerhalb der EU ohne SCC-Vertragsaufwand. Der BSI-Grundschutz-Katalog empfiehlt On-Premises-Verarbeitung für kritische Infrastrukturen und Behörden.
- DACH-Unternehmensstandards: Im deutschsprachigen Raum (Deutschland, Österreich, Schweiz) verlangen DSGVO-Umsetzungsgesetze und BSI-IT-Grundschutz strikte Datenlokalisierung. Mini-PCs eignen sich für den Einsatz in regulierten Branchen (Gesundheit, Finanzen, öffentliche Verwaltung), da alle Verarbeitungen lokal stattfinden.
- Japan / APPI: Das japanische Gesetz zum Schutz personenbezogener Informationen (APPI) erfordert ausdrückliche Einwilligung für grenzüberschreitende Datentransfers. Lokale Inferenz beseitigt diese Anforderung vollständig.
- China / Datensicherheitsgesetz: Das Datensicherheitsgesetz von 2021 schränkt die Übertragung bestimmter Datenkategorien ins Ausland ein. Ein Mini-PC, der Qwen3 lokal ausführt, erfüllt diese Anforderungen ohne Cloud-Routing.
Häufige Mini-PC-Fehler bei der lokalen LLM-Inferenz
Der häufigste Fehler ist der Kauf eines Consumer-Mini-PCs mit integrierter Grafik — integrierte GPUs sind 10× langsamer als dedizierte Karten für LLM-Inferenz.
- Kauf eines Fertig-Mini-PCs mit integrierter GPU für 7B-Inferenz. Integrierte GPUs liefern 1–2 tok/s gegenüber 25 tok/s der RTX 5060 Ti.
- Wahl eines TB3-eGPU-Docks in der Erwartung voller dedizierter GPU-Geschwindigkeit. eGPU verliert 15–25 % PCIe-Bandbreite — erwarten Sie 12 tok/s statt 15 bei 7B.
- Annahme, dass jedes Mini-PC-Gehäuse ein vollständiges ATX-Netzteil fasst. Mini-ITX erfordert SFX- oder TFX-Formfaktor-Netzteile.
- RAM-Dimensionierung überspringen — mit nur 8 GB freiem RAM verursacht das Laden von 7B-Modellen Swap-Thrashing und 5–10-fache Verlangsamungen.
- GPU-Länge vor der Bestellung nicht messen — RTX-5070-Varianten reichen von 210 mm bis 242 mm; den spezifischen Slot-Grenzwert des Gehäuses überprüfen.
Häufig gestellte Fragen: Mini-PCs für lokale LLMs
Kann ich 13B-Modelle flüssig auf einem Mini-PC ausführen?
Ja, bei Q4-Quantisierung mit RTX 5060 Ti (16 GB) oder RTX 4070 (12 GB). Die RTX 4060 Ti (8 GB) ist für komfortablen 13B-Betrieb zu knapp — der VRAM-Spielraum sinkt unter 1 GB.
Ist Intel NUC mit externer RTX 5060 Ti angedockt gut für lokale LLMs?
Ja. TB3 eGPU verliert 15–20 % Bandbreite, erwarten Sie also 12 tok/s statt 15 bei 7B. Dennoch nutzbar und ideal für kleine Räume, wo ein Full-Tower unpraktisch ist.
Wie laut ist ein Mini-PC bei LLM-Ausführung?
RTX 5060 Ti unter Volllast erreicht 50–60 dB. Undervolting oder Ersetzen der GPU-Lüfter durch Noctua-Varianten senkt den Lärm auf 40–45 dB — für die meisten Büros akzeptabel.
Kann ich eine RTX 4090 in einen Mini-PC einbauen?
Nein. Die RTX 4090 ist Dual-Slot und über 280 mm lang. Custom-SFF-Gehäuse (Lian Li A4, Dan A4-H2O) haben ein maximales GPU-Längenmaß von 220 mm.
Ist ein Mini-PC besser als ein Laptop für lokale LLMs?
Für stationäre Nutzung ja. Der Mini-PC bietet bessere Thermals (60–70 °C anhaltend) und volle PCIe-Bandbreite. Laptops drosseln auf ~10 tok/s unter anhaltender Last. Mini-PC gewinnt für den Schreibtischeinsatz.
Wie hoch sind die Gesamtkosten eines Mini-PCs für 7B-Inferenz?
ASUS-PN51-Build: ca. 900 €. Intel NUC 13 + RTX 5060 Ti eGPU-Dock: ca. 1.300 €. Beide führen 7B mit 20–25 tok/s aus; PN51 bietet besseres Preis-Leistungs-Verhältnis.
Benötigt ein Mini-PC eine dedizierte Kühllösung für LLMs?
Ja, für anhaltende Inferenz. Standard-Mini-ITX-Gehäuselüfter (1×80 mm) sind für die RTX 5060 Ti unter Volllast unzureichend. Einen 92-mm-Seitenlüfter ergänzen oder GPU-Lüfter durch Noctua-Varianten (50–80 €) ersetzen.
Welche Mini-PC-CPU eignet sich am besten für lokale LLM-Inferenz?
Die CPU ist für die Token-Generierung sekundär. Ryzen 7 7700X oder Intel Core i7-14700K sind ausreichend. Den VRAM-Budgetanteil der GPU gegenüber der CPU-Geschwindigkeit für 7B–13B-Inferenz priorisieren.
Kann der neue Mac mini (M6 oder M5 Pro) Llama 3.3 70B ausführen?
Nur die M5-Pro-Konfiguration (ab 1.699 $, Obergrenze 64 GB Unified Memory) hat genug Speicherspielraum für 70B-Modelle — unabhängige tok/s-Benchmarks gibt es noch nicht, da sie erst ab 22. September 2026 verfügbar ist. Der Basis-M6 (ab 899 $) ist bei 32 GB Unified Memory gedeckelt und passt nicht für 70B-Modelle. Zum Vergleich: Der auslaufende M4 Pro (64 GB, 2.299 $) lief bei 70B mit 10–15 tok/s.
Unterstützt der neue Mac mini M6 wie der alte M4 Pro 64 GB Unified Memory?
Nein — der Basis-M6-Mac-mini ist bei 32 GB Unified Memory gedeckelt, weniger als das Maximum von 64 GB beim M4 Pro. Um in der neuen Mac-mini-Reihe 64 GB Unified Memory zu bekommen, benötigen Sie die M5-Pro-Konfiguration (ab 1.699 $), nicht den M6 (ab 899 $). Das ist eine bedeutende Änderung gegenüber der Vorgängergeneration, wo 64 GB bereits beim mittleren M4 Pro verfügbar waren.
Ist das Framework Desktop besser als der neue Mac mini für lokale LLMs?
Das Framework Desktop (1.999 $, 128 GB Unified Memory) hat weiterhin mehr Speicherspielraum als jeder neue Mac-mini-Chip — der M5 Pro ist bei 64 GB gedeckelt, der M6 bei 32 GB. Gegenüber dem auslaufenden M4 Pro schlug das Framework Desktop mit über 20 tok/s bei 70B den Mac mini (10–15 tok/s); für den neuen M5-Pro-Chip existiert noch kein unabhängiger Benchmark. Bei der Einrichtung gewinnt weiterhin der Mac mini — Ollama funktioniert mit Metal sofort, während Framework eine ROCm-Einrichtung erfordert.
Muss ich bei der Verwendung eines Mini-PCs mit lokalem LLM die DSGVO beachten?
Bei lokaler LLM-Inferenz verlassen keine personenbezogenen Daten das Gerät. Damit entfällt die Pflicht zur Auftragsverarbeitungsvereinbarung gemäß Artikel 28 DSGVO. Der BSI-Grundschutz-Katalog empfiehlt On-Premises-Verarbeitung für Behörden und kritische Infrastrukturen. Für Unternehmen, die sensible Daten verarbeiten (Gesundheit, Finanzen, Recht), erfüllt ein Mini-PC mit lokalem LLM die Datenlokalisierungsanforderungen ohne zusätzliche vertragliche oder technische Maßnahmen.
Ist ein Mini-PC mit lokalem LLM für den deutschen Mittelstand geeignet?
Ja, besonders für KMU mit Datenschutzbedarf oder eingeschränktem Cloud-Budget. Der ASUS PN51 Build (ca. 900 €) und das Framework Desktop (ca. 1.999 €) erfüllen BSI-IT-Grundschutz-Empfehlungen für lokale Datenverarbeitung. Mittelständische Kanzleien, Arztpraxen und Ingenieurbüros profitieren davon, dass keine Daten externe Server erreichen. Cloud-API-Kosten bei intensiver Nutzung (über 5 Millionen Token/Monat) übersteigen die Hardwareinvestition innerhalb eines Jahres.
Welche Mac-mini-Konfiguration eignet sich am besten für lokale LLMs — M6 oder M5 Pro?
Für 70B-Modelle reicht nur der M5 Pro (ab 1.699 $, bis zu 64 GB Unified Memory) — der M6 (ab 899 $) ist bei 32 GB Unified Memory gedeckelt und passt selbst bei Q4-Quantisierung nicht für 70B-Modelle. Wenn nur 7B–13B-Modelle benötigt werden, reicht der Basis-M6. Der auslaufende M4 Pro (bis 64 GB, bis 2.299 $) wird ausgelistet, lief aber bei 70B mit 10–15 tok/s, falls Sie ein reduziertes Exemplar finden.
Was ist eine gute Alternative zum Mac mini für lokale LLMs?
Das Framework Desktop (1.999 $, 128 GB Unified Memory) hat mehr Speicherspielraum als jede neue Mac-mini-Konfiguration (M6: 32 GB, M5 Pro: 64 GB) und schlug den Mac mini gegenüber dem auslaufenden M4 Pro bei reiner 70B-Geschwindigkeit (über 20 tok/s gegenüber 10–15 tok/s) — auf Kosten eines lauteren Lüfters und eines ROCm-Einrichtungsschritts. Für x86-Flexibilität statt Unified Memory deckt ein ASUS-PN51-Build mit RTX 5060 Ti (900 $) 7B–13B-Modelle zu geringeren Anschaffungskosten ab.
Was ist der beste Budget-Mini-PC für lokale LLMs im Jahr 2026?
Ein ASUS-PN51- oder -PN52-Barebone mit Ryzen 5, 32 GB RAM, 1-TB-SSD und RTX 5060 Ti (16 GB) kostet insgesamt rund 900 $ — der günstigste Mini-PC-Build, der bei 7B dennoch 25 tok/s und bei 13B 15 tok/s auf einer dedizierten GPU erreicht. Vorgefertigte Mini-PCs mit integrierter Grafik kosten zwar weniger, fallen bei 7B jedoch auf 1–2 tok/s ab und sind damit keine echte Budgetoption für lokale LLM-Inferenz.