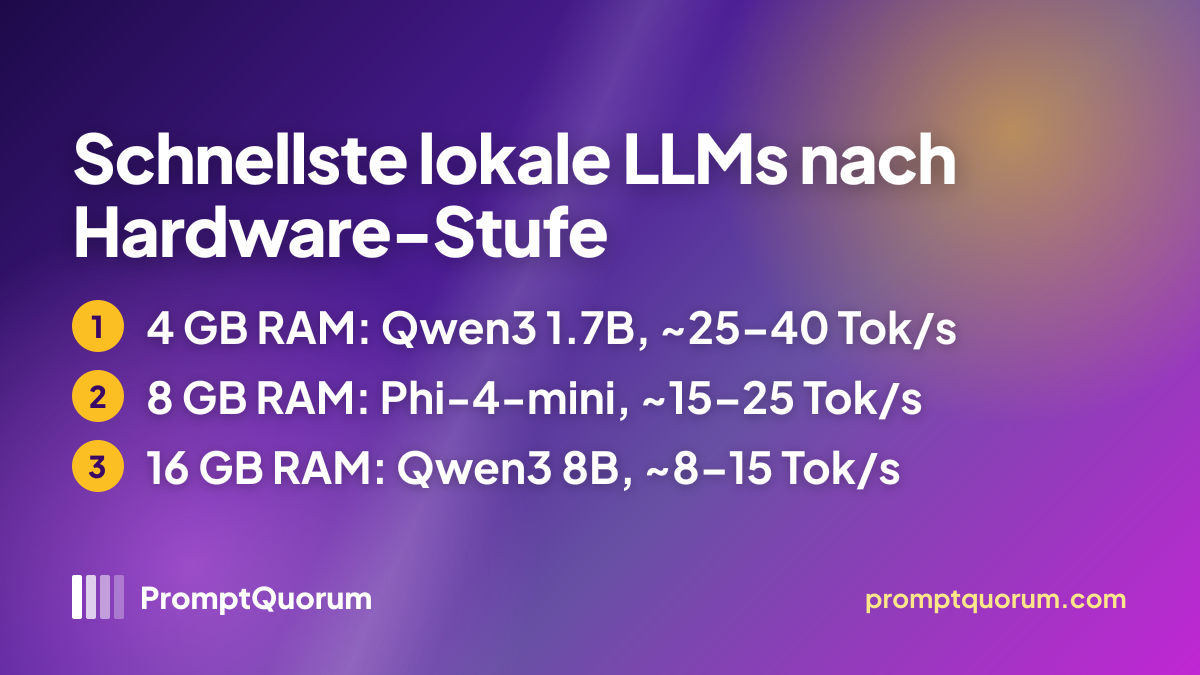
Welches Modell ist das schnellste für Ihre Hardware?
Stimmen Sie Ihre Hardware auf das richtige Modell ab — die falsche Wahl verschenkt 4–10× Geschwindigkeit. Alle Stufen unten sind CPU-only, sofern nicht anders angegeben. Die Geschwindigkeiten sind Schätzungen von PromptQuorum für Dual-Channel-RAM, keine Labormessungen; Single-Channel-RAM oder ein älteres DDR4-Notebook liegt darunter.
Ihre Hardware | Empfohlenes Modell | Ollama-Befehl | Erwartete Geschwindigkeit |
|---|---|---|---|
| 4 GB RAM, nur CPU | Qwen3 1.7B Q4_K_M | ollama run qwen3:1.7b | 25–40 Tok/s |
| 8 GB RAM, nur CPU | Phi-4-mini 3.8B Q4_K_M | ollama run phi4-mini | 15–25 Tok/s |
| 8 GB RAM + Intel-Iris-iGPU | Qwen3 4B Q4_K_M | ollama run qwen3:4b | 12–20 Tok/s |
| 16 GB RAM, nur CPU | Qwen3 8B Q4_K_M | ollama run qwen3:8b | 8–15 Tok/s |
| 16 GB RAM + iGPU | Llama 3.2 3B Q4_K_M | ollama run llama3.2:3b | 20–35 Tok/s |
Welches Modell sollten Sie verwenden?
Stimmen Sie Ihre Situation auf das richtige Modell ab — das ist die wichtigste Entscheidung:
- Notebook mit 8 GB RAM (keine dedizierte GPU): Phi-4-mini (3.8B) bei Q4_K_M — 15–25 Tok/s, übernimmt Coding und Reasoning. `ollama run phi4-mini`
- 4 GB RAM, sehr alter PC: Qwen3 1.7B Q4_K_M — 25–40 Tok/s, schnellste Antwort bei minimalem RAM. `ollama run qwen3:1.7b`
- 16 GB RAM, keine GPU: Qwen3 8B Q4_K_M — 8–15 Tok/s, starke Qualität. `ollama run qwen3:8b`
- 8 GB RAM + Intel-Iris-iGPU: Qwen3 4B — geschätzt 12–20 Tok/s, wenn Ollama die iGPU nutzt (führen Sie `ollama ps` aus und lesen Sie die Spalte PROCESSOR). `ollama run qwen3:4b`
- Langer Kontext gewünscht: Qwen3 4B (256K Kontext auf Ollama) oder Llama 3.2 3B (128K). Qwen3 1.7B und 8B sind mit 40K aufgeführt.
- Neuere Generation, kleinste Dateien: Qwen3.5 0.8B (1,2 GB auf Ollama) ist kleiner als Qwen3 1.7B (1,4 GB) und sollte daher auf derselben CPU schneller laufen, bei geringerer Qualität. Qwen3.5 2B (2,7 GB) und 4B (3,3 GB) haben größere Dateien als Phi-4-mini (2,5 GB) und Qwen3 4B (2,5 GB); erwarten Sie daher eine geringere Geschwindigkeit. `ollama run qwen3.5:0.8b`. PromptQuorum hat Qwen3.5 nicht auf der Hardware dieses Leitfadens gemessen.
- Ebenfalls einen Test wert bei 8 GB RAM: Gemma 4 E2B (Google, veröffentlicht im April 2026). Es hat etwa 2,3 Mrd. effektive Parameter, aber der Ollama-Download beginnt wegen der Embedding-Tabellen bei 4,6 GB — es ist also kein Modell mit 1,5–2 GB. `ollama run gemma4:e2b`. Geschätzte Geschwindigkeiten je Speichertyp finden Sie im Leitfaden für reine CPU-Modelle.
- Empfehlungen je RAM-Stufe und Wärmemanagement finden Sie im Leitfaden zum Betrieb eines lokalen LLM auf einem Notebook.
Welches lokale LLM sollten Sie auf Ihrer Hardware ausführen?
Alle Stufen unten sind CPU-only oder iGPU. Wählen Sie das größte Modell, das bei Q4_K_M in Ihr RAM passt und Reserve für Betriebssystem und Kontext lässt. Die Geschwindigkeiten sind Schätzungen.
Hardware | Model | Quant | Speed | Experience |
|---|---|---|---|---|
| 4 GB RAM, nur CPU | Qwen3 1.7B | Q4_K_M | 25–40 t/s | schnell, nutzbare Qualität |
| 8 GB RAM, nur CPU | Phi-4-mini 3.8B | Q4_K_M | 15–25 t/s | Coding + Reasoning |
| 8 GB RAM + iGPU Iris | Qwen3 4B | Q4_K_M | 12–20 t/s | wenn iGPU genutzt wird |
| 16 GB RAM, nur CPU | Qwen3 8B | Q4_K_M | 8–15 t/s | starke Qualität |
| 16 GB RAM + iGPU | Llama 3.2 3B | Q4_K_M | 20–35 t/s | wenn iGPU genutzt wird |

GPU vs. CPU für lokale LLMs: Was ist schneller auf Low-End-Hardware?
Dedizierte GPU: in der Regel 5–10× schneller als reine CPU beim selben Modell, weil VRAM eine weit höhere Speicherbandbreite hat als der Systemspeicher. Eine gebrauchte RTX 4060 8 GB (Preis schwankt) ist ein gängiges Budget-Upgrade. Weitere kostengünstige Optionen finden Sie im Budget-GPU-Leitfaden.
iGPU (integrierte Grafik): teilt sich den Systemspeicher mit der CPU, sodass die wichtigste Grenze — die Speicherbandbreite — gleich bleibt. Ein Gewinn fällt meist bescheiden aus und hängt von der Treiberunterstützung ab. Laut Ollama-Dokumentation ist die Vulkan-GPU-Unterstützung unter Windows und Linux standardmäßig aktiviert, sofern das Backend installiert ist, und AMD-Ryzen-AI-iGPUs werden unter ROCm aufgeführt; Intel-Grafikeinheiten werden dort nicht in einer Support-Tabelle aufgeführt. Prüfen Sie `ollama ps`: Die Spalte PROCESSOR zeigt, ob das Modell auf CPU, GPU oder geteilt läuft.
Nur CPU: läuft auf jedem PC ohne Treiber-Setup. Die Geschwindigkeit entspricht grob Speicherbandbreite ÷ Größe der Modelldatei; deshalb zählen Dual-Channel-RAM und eine kleine Q4_K_M-Datei mehr als die CPU-Taktfrequenz.
Regel: Nutzen Sie eine dedizierte GPU, wenn Sie eine haben. Andernfalls führen Sie denselben Prompt mit und ohne iGPU aus (`OLLAMA_VULKAN=0` schaltet Vulkan-GPUs ab) und behalten Sie die schnellere Variante.

Warum kleinere Modelle auf Low-End-PCs schneller sind
Die Modellgröße bestimmt direkt die Geschwindigkeit. Ein 1B–3B-Modell passt vollständig in den Systemspeicher, sodass CPU oder GPU Daten kontinuierlich streamen können. Größere Modelle erfordern Memory-Swapping — das Verschieben von Daten zwischen RAM und Festplatte — was die Generierung dramatisch verlangsamt (der Engpass ist Disk-I/O, nicht die Berechnung).
Die obige Hardware-Entscheidungstabelle spiegelt dieses Prinzip wider: Die kleinsten Dateien liefern die höchste Geschwindigkeit, während 13B+-Modelle auf Low-End-Hardware unpraktisch sind, weil Swapping dominiert.
- 1B–3B-Modelle: Passen in 4–8 GB RAM → schnellste Generierung → akzeptable Qualität
- 7B-Modelle: Grenzwertig auf 8-GB-Systemen → langsamer durch Speicherdruck → hohe Qualität
- 13B+-Modelle: Benötigen 16+ GB RAM oder Swap → zu langsam für interaktive Nutzung auf Low-End-PCs
Wie schnell sind lokale LLMs auf Low-End-PCs?
Auf CPU-only-Systemen erwarten Sie diese geschätzten Bereiche:
- 3B-Modelle → 15–40 Token/Sek (ältere CPUs: 10–15, neuere Dual-Channel-DDR5-Systeme: 30–40)
- 7B–8B-Modelle → 8–15 Token/Sek (Q4_K_M bei Dual-Channel-RAM; Single-Channel-RAM liegt darunter)
- Schätzen Sie Ihre eigene Geschwindigkeit mit einer Division. Für jedes generierte Token muss das gesamte Modell einmal aus dem RAM gelesen werden; Token pro Sekunde können daher nie höher sein als Speicherbandbreite ÷ Größe der Modelldatei. Spitzenbandbreite = Übertragungsrate (MT/s) × 8 Byte × Kanäle.
- Rechenbeispiele (Obergrenzen, keine Prognosen): Dual-Channel-DDR4-3200 ergibt 3200 × 8 × 2 = 51,2 GB/s; geteilt durch die 2,5 GB große Phi-4-mini-Datei sind das höchstens etwa 20 Tok/s. Dual-Channel-DDR5-5600 ergibt 89,6 GB/s, also höchstens etwa 36 Tok/s für dieselbe Datei. Ein Single-Channel-DDR4-3200-Notebook liefert 25,6 GB/s, also höchstens etwa 10 Tok/s. Die reale Geschwindigkeit liegt unter der Obergrenze.
- Intel-N100-Mini-PCs haben nur einen Speicherkanal (Intel-Spezifikationen: DDR4-3200, DDR5-4800 oder LPDDR5-4800). Mit DDR4-3200 liegt die Obergrenze für die 1,4 GB große Qwen3-1.7B-Datei bei etwa 18 Tok/s, mit DDR5-4800 bei etwa 27 Tok/s. Erwarten Sie, dass der N100 unter den Dual-Channel-Bereichen in diesem Leitfaden landet.
- Das ist langsamer als Cloud-Chatbots, aber ausreichend für interaktive Nutzung. Ein 3B-Modell mit 25 Tok/Sek generiert eine 500-Token-Antwort in 20 Sekunden — akzeptabel für nicht zeitkritische Aufgaben wie Code-Review, Zusammenfassung und kreatives Schreiben.
Wie beeinflusst Quantisierung die Geschwindigkeit auf Low-End-PCs?
Q4 (4-Bit): die Standardwahl — grob ein Viertel der Dateigröße von 16 Bit bei geringem Qualitätsverlust in den meisten Aufgaben. Details zu allen Quantisierungsstufen finden Sie im vollständigen Leitfaden.
Q3 (3-Bit): kleinere Datei und größerer Qualitätsverlust als bei Q4. Akzeptabel für Chat, wenn Q4 nicht in den RAM passt.
Q2 (2-Bit): kleinste Datei und größter Qualitätsverlust. Riskant; nur verwenden, wenn Q4 und Q3 den Speicher überschreiten.
Geschwindigkeitsauswirkung: Weil die CPU-Dekodierung durch die Speicherbandbreite begrenzt ist, erzeugt eine kleinere Datei etwa im gleichen Verhältnis schneller Text. Q3- und Q2-Dateien sind schneller als Q4, aber der Qualitätsverlust lohnt sich bei Modellen dieser Größe meist nicht.
Strategie: Wählen Sie zuerst die Modellgröße und verwenden Sie dann Q4_K_M. Ein kleines Modell bei Q4_K_M schlägt meist ein größeres Modell, das auf Q2 gepresst wurde — dieses verliert an Genauigkeit und braucht dennoch mehr RAM.
Schnellere Modelle opfern Qualität für Geschwindigkeit — aber durch Anpassen von Temperature und top-p lässt sich viel dieser Qualität zurückgewinnen. Niedrigere Temperature (0,1–0,3) bei schnellen Modellen erzeugt konsistentere Ausgabe als Standardeinstellungen. Siehe Temperature und top-p erklärt für die genauen Einstellungen.

Wie beschleunigen Sie CPU-only-Inferenz?
- Beide Speicherkanäle bestücken: Zwei identische RAM-Riegel verdoppeln die Spitzenbandbreite gegenüber einem Riegel — die größte einzelne Beschleunigung auf einem reinen CPU-PC. Notebooks und Mini-PCs mit nur einem Riegel laufen mit der halben Obergrenze.
- Kontextfenster verkleinern: Der KV-Cache wächst mit der Kontextlänge. Setzen Sie `OLLAMA_CONTEXT_LENGTH=2048` (der Ollama-Standard ist 4096) oder `/set parameter num_ctx 2048` innerhalb von `ollama run`.
- KV-Cache quantisieren: `OLLAMA_FLASH_ATTENTION=1` mit `OLLAMA_KV_CACHE_TYPE=q8_0` halbiert den KV-Cache-Speicher gegenüber dem f16-Standard in etwa, was auf Maschinen mit 4 GB und 8 GB am meisten hilft.
- Modell geladen halten: Ollama entlädt ein Modell standardmäßig nach 5 Minuten. `OLLAMA_KEEP_ALIVE=30m` vermeidet, dass die Datei für jede Sitzung neu geladen wird.
- Speicherhungrige Programme schließen: Browser mit vielen Tabs drängen das Modell in den Swap, was die Generierung um ein Vielfaches verlangsamt.
- iGPU testen: Führen Sie `ollama ps` aus, während ein Modell geladen ist. Zeigt PROCESSOR 100 % CPU, vergleichen Sie mit einem GPU-Lauf; ist die iGPU instabil, setzen Sie `OLLAMA_VULKAN=0`.
Lässt sich lokales RAG mit 2 GB RAM betreiben?
Ja, für kleine Dokumentenbestände: Qwen3 0.6B (523 MB auf Ollama) für die Antworten plus das Embedding-Modell nomic-embed-text (274 MB) für die Suche brauchen zusammen etwa 0,8 GB an Modelldateien. Das passt, wenn tatsächlich 2 GB RAM frei sind, etwa auf einer schlanken Linux-Installation, einem alten Netbook oder einem PC mit geschlossenen anderen Programmen. Erwarten Sie einfache Antworten aus Ihren Dokumenten, kein tiefes Reasoning.
- Chat-Modell: `ollama pull qwen3:0.6b` (523 MB, 40K Kontext auf Ollama). Mit etwas mehr freiem RAM ist `qwen3.5:0.8b` (1,2 GB) die neuere kleine Option.
- Embedding-Modell: `ollama pull nomic-embed-text` (274 MB, 2K Kontextfenster). Teilen Sie Dokumente in Chunks von einigen hundert Token, damit jeder Chunk in das 2K-Fenster passt.
- Wenige Chunks abrufen: Übergeben Sie nur die 2–3 besten Treffer an das Chat-Modell. Jeder zusätzliche Chunk verlängert den Kontext und vergrößert den KV-Cache.
- Kontext kurz halten: Setzen Sie `OLLAMA_CONTEXT_LENGTH=2048`, damit der KV-Cache klein bleibt.
- Antworten prüfen: Ein 0.6B-Modell zieht gut einen Fakt aus einer abgerufenen Passage, ist aber schwach bei mehrstufigem Reasoning; prüfen Sie wichtige Antworten daher anhand der Quellpassage.
- Wenn 2 GB zu knapp sind: Wechseln Sie auf Qwen3 1.7B (1,4 GB) bei 4 GB RAM oder auf Phi-4-mini bei 8 GB und behalten Sie dasselbe Embedding-Modell.
Wie schnell sind diese Modelle? Geschätzte Geschwindigkeiten
Geschätzte Geschwindigkeiten nach Hardware-Klasse, keine Labormessungen. Die Bereiche sind eigene Näherungswerte von PromptQuorum, abgeleitet aus der Speicherbandbreiten-Obergrenze jeder Klasse, für Ollama-Standardeinstellungen und Q4_K_M-Dateien. Verstehen Sie sie als Obergrenzen für eine gesunde Installation; Ihre eigene Ausgabe von `ollama run <model> --verbose` zeigt die reale Geschwindigkeit in Token pro Sekunde:
- Intel-N100-Mini-PC (Single-Channel-RAM, 4-GB-Stufe) + Qwen3 1.7B Q4_K_M: bis zu etwa 18 Tok/s mit DDR4-3200 und etwa 27 Tok/s mit DDR5-4800 (Bandbreiten-Obergrenzen). `ollama run qwen3:1.7b`
- Moderner Dual-Channel-i5/Ryzen 5 (4-GB-Stufe) + Qwen3 1.7B Q4_K_M: geschätzt 25–40 Tok/s. `ollama run qwen3:1.7b`
- Notebook der Klasse Core i5-1235U (8 GB RAM) + Phi-4-mini Q4_K_M: geschätzt 15–22 Tok/s bei LPDDR5; DDR4-Notebooks liegen darunter. `ollama run phi4-mini`
- Desktop der Klasse Ryzen 5 5600G (8 GB RAM) + Qwen3 4B Q4_K_M: geschätzt 15–20 Tok/s (die Obergrenze bei Dual-Channel-DDR4-3200 liegt bei etwa 20); eine iGPU teilt sich dieselbe RAM-Bandbreite, erwarten Sie daher nicht mehr.
- Notebook der Klasse Intel Iris Xe (8 GB RAM) + Qwen3 4B Q4_K_M: geschätzt 12–18 Tok/s. `ollama run qwen3:4b`
- Desktop der Klasse Ryzen 7 7700X (16 GB RAM, Dual-Channel-DDR5) + Qwen3 8B Q4_K_M: geschätzt 8–13 Tok/s. `ollama run qwen3:8b`
- Notebook der Klasse Iris Xe (16 GB RAM) + Llama 3.2 3B Q4_K_M: geschätzt 20–30 Tok/s. `ollama run llama3.2:3b`
Was ist bei lokalen LLMs tatsächlich „schnell"?
Geschwindigkeit fühlt sich je nach Aufgabe unterschiedlich an — nutzen Sie dies als Referenz:
Läuft Ihr Modell unter 15 Tok/s, verkleinern Sie das Modell (7B → 3B) oder senken Sie eine Quantisierungsstufe (Q5 → Q4), bevor Sie neue Hardware kaufen.
- Unter 10 Tok/s → fühlt sich kaputt an. Wörter erscheinen einzeln mit spürbaren Pausen. Für interaktiven Chat unbrauchbar.
- 15–25 Tok/s → akzeptabel. Lesbare Geschwindigkeit für die meisten Nutzer. Gut für Q&A, Zusammenfassungen und Coding-Hilfe.
- 30+ Tok/s → flüssig. Fühlt sich wie ein echter Assistent an. Angenehm für alle interaktiven Aufgaben.
- 60+ Tok/s → sofort. Schneller als man lesen kann. Ideal für Echtzeit-Autovervollständigung und schnelle Iteration.

Was Sie auf Low-End-PCs vermeiden sollten
- Führen Sie keine 13B+-Modelle aus — sie überschreiten die RAM-Grenzen. Ein 13B-Modell bei Q4 braucht allein für die Datei etwa 8 GB — mehr, als ein 8-GB-PC nach Abzug des Betriebssystems aufnehmen kann. Bleiben Sie bei 16 GB bei 8B und darunter, bei 8 GB bei 4B und darunter.
- Vermeiden Sie Q8-Quantisierung — langsamer mit minimalem Qualitätsgewinn. Q8 verdoppelt grob die Dateigröße von Q4, und eine größere Datei bedeutet weniger Token pro Sekunde auf einer bandbreitenbegrenzten CPU. Für 4-GB-Systeme ist Q8 unpraktisch; für 8-GB-Systeme bleibt Q4 optimal. Q3 ist der einzige Kompromiss, der in Betracht gezogen werden sollte, wenn Q4 den Speicher überschreitet.
- Erwarten Sie keine Echtzeit-Autovervollständigung. Bei 3 Tok/Sek auf CPU dauert die Generierung von 50 Token etwa 17 Sekunden. Interaktive Autovervollständigung braucht deutlich höhere Geschwindigkeiten. Lokale LLMs auf Low-End-CPUs eignen sich für Batch-Chat, Entwürfe und Review — nicht für Live-Autovervollständigung oder Code-während-der-Eingabe-Szenarien.
- Verwenden Sie CPU-only-Inferenz nicht für Produktions-Chatbots. Akzeptabel für interne Tools, Prototypen und Offline-Batch-Arbeit. Eine Low-End-CPU bedient jeweils einen Nutzer mit niedriger Geschwindigkeit, während eine gehostete API auf viele Nutzer skaliert. Verwenden Sie lokale Inferenz für datenschutzkritische oder Offline-Szenarien, nicht für geschwindigkeitskritische.
Häufige Fehler
- Fehler: Nur einen RAM-Riegel verwenden. Problem: Ein einzelner Speicherkanal halbiert die Spitzenbandbreite, sodass dasselbe Modell mit etwa der halben Geschwindigkeit generiert. Lösung: Installieren Sie zwei identische Riegel (oder kaufen Sie einen Dual-Channel-Mini-PC), bevor Sie eine schnellere CPU kaufen.
- Fehler: Die Geschwindigkeit allein am CPU-Modell festmachen. Problem: Eine neuere CPU mit langsamem Single-Channel-DDR4 kann langsamer sein als eine ältere CPU mit Dual-Channel-DDR5, weil die Token-Generierung durch die Speicherbandbreite begrenzt ist. Lösung: Vergleichen Sie RAM-Geschwindigkeit und Kanäle und lesen Sie dann den realen Wert aus `ollama run <model> --verbose` ab.
- Fehler: Q2-Quantisierung erzwingen, um 7B in 4 GB zu pressen. Problem: Q2-Quantisierung führt während der Inferenz oft zu Out-of-Memory-Abstürzen durch KV-Cache-Overhead, und die Ausgabequalität sinkt stark. Lösung: Verwenden Sie stattdessen ein 3B-Modell bei Q4.
- Fehler: Das Kontextfenster groß lassen. Problem: Ein langer Kontext vergrößert den KV-Cache und drängt eine kleine Maschine in den Swap. Lösung: Setzen Sie `OLLAMA_CONTEXT_LENGTH=2048`, sofern Sie keine langen Dokumente brauchen.
- Fehler: Falschen Ollama-Slug für Ihr Modell verwenden. Problem: `ollama run phi` lädt Phi-2, nicht Phi-4-mini. Lösung: Verwenden Sie `ollama run phi4-mini` für das aktuelle Phi-mini-Modell. Prüfen Sie immer ollama.com/library für exakte Modell-Tags.
Lokale LLMs auf Low-End-PCs: Regionaler Kontext
EU / DSGVO: Lokal auf Low-End-Hardware: Bei Offline-Betrieb verlassen keine Inferenzdaten das Gerät — für viele KMU und Freiberufler im DACH-Raum eine technisch einfache Methode, Art.-44-Transferrisiken zu vermeiden. Ob der EU AI Act oder andere Pflichten für Ihren Einsatz gelten, hängt davon ab, wer das System betreibt und zu welchem Zweck; dieser Leitfaden ist keine Rechtsberatung. Für deutsche KMU, die lokale LLMs für interne Geschäftsaufgaben abwägen, vermeidet das Belassen der Dokumente auf dem Gerät die Weitergabe an einen Drittanbieter als Auftragsverarbeiter; die datenschutzrechtliche Gesamtkonformität hängt jedoch vom Betrieb ab, nicht allein von der Inferenz-Architektur.
Japan: Japans METI-KI-Leitlinien für Unternehmen betonen den verantwortungsvollen Umgang mit Daten. CPU-Inferenz auf Low-End-Hardware ist zwar langsam, hält Prompts aber auf dem Gerät — sobald das Modell heruntergeladen ist, benötigt die Inferenz selbst keine API-Aufrufe. Für japanischsprachige Aufgaben mit Qwen3 bei CPU-Geschwindigkeiten in den obigen Bereichen sind einige Sekunden pro Satz für nicht zeitkritische Dokumentzusammenfassungen akzeptabel.
China: Lokale Inferenz von Qwen3 und DeepSeek-R1-Distillationen auf Consumer-Hardware ist eine Option für Nutzer in China, die nicht-chinesische Cloud-APIs nicht erreichen können. Qwen3 0.6B, 1.7B und 4B laufen auf CPU-only-Hardware und bieten eine funktionale Alternative zu Cloud-APIs für Nutzer mit eingeschränkter Hardware.
Häufige Fragen zum Betrieb lokaler LLMs auf Low-End-PCs
Was gilt als Low-End-PC für lokale LLMs?
Ein Low-End-PC für lokale LLMs ist jede reine CPU-Maschine (keine dedizierte GPU) mit 4–16 GB Systemspeicher. Dazu gehören die meisten Notebooks mit Intel Iris oder AMD Radeon integrierter Grafik, ältere Desktop-PCs ohne dedizierte GPU sowie Mini-PCs wie der Intel N100. Die entscheidende Einschränkung ist der Systemspeicher für die Modellgewichte, nicht die CPU-Taktfrequenz.
Kann ich ein 7B-Modell ganz ohne GPU ausführen?
Ja — Qwen3 8B bei Q4_K_M läuft mit geschätzt 8–15 Tok/s bei 16 GB RAM, nur CPU (Schätzung für einen Desktop der Klasse Ryzen 7 7700X mit Dual-Channel-RAM). Es ist langsamer als die kleineren Optionen, liefert aber deutlich bessere Qualität. Bei 8 GB RAM bleiben Sie besser bei Phi-4-mini (3.8B) — ein 8B-Modell bei Q4_K_M braucht Spielraum, den ein 8-GB-System nicht zuverlässig garantiert.
Ist CPU-Inferenz für Chatbots nutzbar?
Ja, für interaktive Nutzung, wenn Sie die richtige Modellgröße wählen. Phi-4-mini mit 15–25 Tok/s (8 GB RAM) und Qwen3 1.7B mit 25–40 Tok/s (4 GB RAM) sind beide schnell genug für Echtzeit-Chat. Ein 7B-Modell auf CPU (8–15 Tok/s) eignet sich besser für Batch-Aufgaben — Entwürfe, Zusammenfassungen, Offline-Review — als für Live-Konversation.
Soll ich Phi-4-mini oder Qwen3 1.7B auf reiner CPU-Hardware verwenden?
Verwenden Sie Phi-4-mini (3.8B), wenn Sie 8 GB RAM haben — es übernimmt Coding und Reasoning mit 15–25 Tok/s. Verwenden Sie Qwen3 1.7B, wenn Sie nur 4 GB RAM haben oder die schnellstmögliche Antwort wollen (25–40 Tok/s) — auf Kosten etwas Qualität bei komplexen Aufgaben.
Wie prüfe ich, ob ich überhaupt eine GPU habe?
Führen Sie `nvidia-smi` im Terminal für dedizierte NVIDIA-GPUs aus. Erscheint „command not found", prüfen Sie `lspci` (Linux) oder den Geräte-Manager (Windows) auf eine Intel-Iris-Xe- oder AMD-Radeon-iGPU — ob Ollama sie nutzen kann, hängt von der Treiber- und Backend-Unterstützung ab; bestätigen Sie es daher mit `ollama ps`.
Wie beeinflusst Quantisierung die Inferenzgeschwindigkeit?
Quantisierung reduziert primär den Speicherbandbreitenbedarf, nicht die Berechnung. Eine Q2-Datei (2-Bit) ist kleiner als eine Q4-Datei (4-Bit); die CPU liest daher pro Token weniger Bytes und generiert schneller, etwa im Verhältnis der Dateigröße. Q2 verliert jedoch deutlich mehr Ausgabequalität. Die praktische Regel: Verwenden Sie Q4_K_M als Standard für jede Stufe in diesem Leitfaden, wechseln Sie zu Q3 nur, wenn Q4_K_M nicht in den verfügbaren RAM passt.
Kann ich unter Q2 quantisieren?
Technisch ja (1-Bit-IQ1-Formate gibt es in llama.cpp), aber die Ausgabequalität bricht bei dieser Größe zusammen. Für keinen praktischen Anwendungsfall empfohlen, auch nicht für die 4-GB-RAM-Stufe in diesem Leitfaden — wählen Sie stattdessen ein kleineres Modell bei Q4_K_M.
Wird CPU + iGPU-Hybrid-Inferenz unterstützt?
Manchmal. Ollama kann ein Modell zwischen CPU und GPU aufteilen, wenn es ein unterstütztes GPU-Backend findet, und `ollama ps` zeigt die Aufteilung in der Spalte PROCESSOR. Eine iGPU teilt sich den Systemspeicher mit der CPU, sodass die Speicherbandbreite — die wichtigste Geschwindigkeitsgrenze — nicht steigt. Auf einem 8-GB-RAM-System mit Intel-Iris-Xe-iGPU wird Qwen3 4B auf geschätzt 12–20 Tok/s taxiert, wenn die iGPU genutzt wird. Testen Sie mit `OLLAMA_VULKAN=0`, um mit reiner CPU zu vergleichen.
Was ist das schnellste lokale LLM für einen Low-End-PC?
Qwen3 1.7B bei Q4_K_M ist das schnellste der Stufenempfehlungen in diesem Leitfaden (kleinere Modelle wie Qwen3 0,6B sind noch schneller, bei deutlich geringerer Qualität) — geschätzt 25–40 Tok/s auf einem modernen i5/Ryzen 5 mit 4 GB RAM ohne GPU. Für bessere Qualität bei ähnlicher Geschwindigkeit läuft Phi-4-mini (3.8B) mit 15–25 Tok/s bei 8 GB RAM und übernimmt Coding und Reasoning deutlich besser.
Kann ich ein lokales LLM mit 4 GB RAM ausführen?
Ja — Qwen3 1.7B bei Q4_K_M ist die empfohlene Wahl für 4 GB RAM, nur CPU, mit 25–40 Tok/s auf einem modernen i5/Ryzen 5. Es ist das schnellste der Stufenempfehlungen in diesem Leitfaden und passt mit Puffer für das Betriebssystem.
Ist eine GPU für Geschwindigkeit erforderlich?
Nein — jedes Modell in diesem Leitfaden läuft nur auf CPU. Eine Intel-Iris-iGPU kann einen bescheidenen Geschwindigkeitsschub bringen (Qwen3 4B: geschätzt 12–20 Tok/s, wenn die iGPU genutzt wird), ist aber optional und hängt von der Treiberunterstützung ab. Eine dedizierte GPU wie eine gebrauchte RTX 4060 8 GB ist typischerweise 5–10× schneller als reine CPU beim selben Modell, ist aber ein separater Upgrade-Pfad, keine Voraussetzung.
Muss ich bei der Verwendung lokaler LLMs auf Low-End-PCs die DSGVO beachten?
Für rein private Nutzung greift in der Regel die Haushaltsausnahme (Art. 2 Abs. 2 lit. c DSGVO). Verarbeiten Sie Daten anderer Personen beruflich (z. B. Kundendaten, Patienteninformationen), gelten die DSGVO-Pflichten weiterhin. Bei rein lokaler Inferenz ohne externen Anbieter entsteht für diese Verarbeitungsstufe kein Auftragsverarbeiter. Dies ist keine Rechtsberatung.
Ist der Einsatz lokaler LLMs auf Low-End-Hardware für den deutschen Mittelstand geeignet?
Das kann passen, etwa für interne Dokumente. Kleine lokale Modelle liefern aber keine verlässlichen Vertragsanalysen; prüfen Sie Ergebnisse stets selbst und stimmen Sie sich bei Bedarf mit Ihrer IT-Sicherheit ab (etwa nach BSI IT-Grundschutz). Für KMU bieten sich Phi-4-mini (3.8B) auf einem modernen CPU-System (8 GB RAM) oder Qwen3 8B (16 GB RAM) für höhere Qualität an. Dies ist keine Rechtsberatung.
Reicht eine Intel-Iris-iGPU für lokale LLMs?
Es kann helfen, ist aber nicht garantiert. Bei 8 GB RAM mit Intel-Iris-Xe-iGPU wird Qwen3 4B auf geschätzt 12–20 Tok/s taxiert, wenn Ollama die iGPU tatsächlich nutzt; bei 16 GB RAM liegt Llama 3.2 3B bei geschätzt 20–35 Tok/s. Weil sich eine iGPU den Systemspeicher mit der CPU teilt, fällt der Gewinn meist bescheiden aus. Führen Sie denselben Prompt mit und ohne iGPU aus und behalten Sie die schnellere Einstellung.
Sollte ich Q2- oder Q4-Quantisierung auf Low-End-Hardware verwenden?
Beginnen Sie mit Q4_K_M — es passt für jede Modellstufe in diesem Leitfaden (1.7B bis 8B) bei geringem Qualitätsverlust. Wechseln Sie nur zu Q3 oder Q2, wenn Q4_K_M Out-of-Memory-Fehler verursacht. Q2-Dateien sind schneller, weil sie kleiner sind, aber der Qualitätsverlust ist bei Reasoning- und Coding-Aufgaben spürbar.
Wie prüfe ich meinen verfügbaren RAM unter Windows?
Öffnen Sie Task-Manager → Leistung → Arbeitsspeicher. Der angezeigte Gesamtwert ist Ihr System-RAM — vergleichen Sie ihn mit der obigen Hardware-Entscheidungstabelle (4-, 8- oder 16-GB-Stufen), um das richtige Modell zu wählen.
Nutzt Ollama automatisch meine integrierte GPU?
Nur dort, wo ein unterstütztes Backend existiert. Laut Ollama-Dokumentation ist die Vulkan-GPU-Unterstützung unter Windows und Linux standardmäßig aktiviert, sofern das Backend installiert ist, und AMD-Ryzen-AI-iGPUs werden unter ROCm aufgeführt; integrierte Intel-GPUs werden nicht in einer Support-Tabelle aufgeführt. Prüfen Sie mit `ollama ps` nach dem Laden eines Modells — die Spalte PROCESSOR zeigt 100 % CPU, 100 % GPU oder eine Aufteilung. Setzen Sie `OLLAMA_VULKAN=0`, um Vulkan-GPUs abzuschalten.
Was ist die beste kostenlose Alternative zu ChatGPT auf einem Low-End-PC?
Phi-4-mini (3.8B) bei Q4_K_M auf Ollama mit 8 GB RAM, nur CPU, liefert 15–25 Tok/s — genug für Chat, Zusammenfassungen und Coding-Hilfe. Die Qualität ist niedriger als bei einem Frontier-Cloud-Modell, aber für Alltagsaufgaben ausreichend. Komplett kostenlos, läuft offline, kein API-Key nötig.
Um wie viel schneller ist eine dedizierte GPU als CPU bei lokalen LLMs?
Typischerweise 5–10× schneller beim selben Modell. Eine gebrauchte RTX 4060 8 GB (Preis schwankt) übertrifft die in diesem Leitfaden behandelten CPU-only-Konfigurationen in der Regel. Eine Intel-Iris-iGPU liegt allenfalls dazwischen — Qwen3 4B kommt z. B. auf geschätzt 12–20 Tok/s, wenn die iGPU genutzt wird, gegenüber geschätzt 8–15 Tok/s bei reiner CPU auf der vergleichbarsten Stufe.
Ist ein lokales KI-Modell dasselbe wie ein lokales LLM?
Für diesen Leitfaden: ja. "Lokales KI-Modell" ist die umgangssprachliche Bezeichnung für das, was der Fachbereich lokales LLM (Large Language Model) nennt — textgenerierende Gewichte, die Sie einmal herunterladen und offline auf Ihrem eigenen Gerät ausführen. Der Unterschied spielt nur eine Rolle, wenn das KI-Modell nicht textbasiert ist: Bildgeneratoren wie Stable Diffusion und Sprachmodelle wie Whisper laufen ebenfalls lokal, haben aber andere Hardware-Profile, und keine der Tok/s-Angaben in diesem Leitfaden gilt für sie.
Was ist das leichteste lokale LLM, das noch brauchbaren Text schreibt?
Qwen3 1.7B bei Q4_K_M ist das leichteste Modell in diesem Leitfaden, das sich lohnt — 1,4 GB auf der Festplatte in Ollama, läuft mit 4 GB RAM, geschätzt 25–40 Tok/s rein auf CPU. Kleinere Optionen existieren (TinyLlama 1.1B, Qwen3 0.6B) und sind noch schneller, aber die Ausgabequalität sinkt so stark, dass sie eher als Autovervollständigung denn als Schreibassistent zu behandeln sind. Unter etwa 1 Mrd. Parametern liefert kein leichtgewichtiges Modell zuverlässig kohärenten Fließtext.
Ist Gemma 4 E2B schneller als Qwen3 1.7B auf einem Low-End-PC?
Auf Maschinen mit 4 GB wahrscheinlich nicht. Gemma 4 E2B (Google, veröffentlicht im April 2026) hat etwa 2,3 Mrd. effektive Parameter, aber der Ollama-Download beginnt wegen der Embedding-Tabellen bei 4,6 GB, und auf einer bandbreitenbegrenzten CPU bedeutet eine größere Datei weniger Token pro Sekunde. Es passt besser zu Systemen mit 8 GB oder 16 GB RAM. Der Leitfaden für reine CPU-Modelle schätzt dafür 8–14 Tok/s bei Dual-Channel-RAM. Qwen3 1.7B (1,4 GB) bleibt die Geschwindigkeitswahl dieses Leitfadens für die schwächste Hardware; probieren Sie zum Vergleich `ollama run gemma4:e2b` auf Systemen mit 8 GB oder mehr.
Warum ist mein lokales LLM auf einem Low-End-PC so langsam?
Die übliche Ursache ist die Speicherbandbreite, nicht die CPU-Geschwindigkeit: Für jedes Token muss die gesamte Modelldatei aus dem RAM gelesen werden, daher ist die Geschwindigkeit auf Speicherbandbreite geteilt durch Dateigröße begrenzt. Prüfen Sie vier Dinge: einen einzelnen RAM-Riegel (ein Kanal halbiert die Obergrenze), eine Modelldatei, die größer ist als der freie RAM (Swapping verlangsamt die Generierung um ein Vielfaches), ein großes Kontextfenster (setzen Sie `OLLAMA_CONTEXT_LENGTH=2048`) und ob das Modell auf CPU oder GPU läuft (`ollama ps`). Wechseln Sie dann zu einem kleineren Modell wie Qwen3 1.7B oder Phi-4-mini bei Q4_K_M.
Wie schnell ist ein Intel-N100-Mini-PC für lokale LLMs?
Der N100 hat einen einzelnen Speicherkanal (DDR4-3200, DDR5-4800 oder LPDDR5-4800, laut Intel). Für die 1,4 GB große Qwen3-1.7B-Q4_K_M-Datei liegt die Bandbreiten-Obergrenze bei etwa 18 Tok/s mit DDR4-3200 und etwa 27 Tok/s mit DDR5-4800; die reale Geschwindigkeit liegt darunter. Phi-4-mini (2,5 GB) hat eine Obergrenze von knapp 10 Tok/s mit DDR4 und 15 Tok/s mit DDR5. Verwenden Sie auf einem N100 Qwen3 1.7B oder kleiner.
Kann ich lokales RAG auf einem Notebook mit 2 GB RAM betreiben?
Ja, für kleine Dokumentenbestände, wenn etwa 2 GB RAM frei sind. Verwenden Sie Qwen3 0.6B (523 MB) als Chat-Modell und nomic-embed-text (274 MB, 2K Kontext) für die Embeddings, halten Sie Chunks bei einigen hundert Token, übergeben Sie nur die 2–3 besten Chunks an das Modell und setzen Sie `OLLAMA_CONTEXT_LENGTH=2048`. Erwarten Sie einfache Antworten aus Ihren Dokumenten statt tiefem Reasoning und prüfen Sie wichtige Antworten anhand der Quellpassage.
Sollte ich auf einem Low-End-PC Qwen3.5 statt Qwen3 verwenden?
Für die schnellste Antwort bleiben Sie vorerst bei Qwen3 1.7B. Ollama führt Qwen3.5 0.8B mit 1,2 GB, 2B mit 2,7 GB und 4B mit 3,3 GB auf, gegenüber 1,4 GB für Qwen3 1.7B und 2,5 GB für Qwen3 4B. Auf einer bandbreitenbegrenzten CPU erzeugt eine größere Datei weniger Token pro Sekunde; daher sollte nur Qwen3.5 0.8B schneller sein als Qwen3 1.7B, bei geringerer Qualität. Qwen3.5 2B und 4B sind einen Test wert, wenn Ihnen neueres Training wichtiger ist als Geschwindigkeit. PromptQuorum hat Qwen3.5 nicht auf der Hardware dieses Leitfadens gemessen.
Welches ist das größte Modell, das ich nur mit CPU ausführen kann?
Die Grenze ist der freie RAM für Datei plus Kontext. Ollama führt etwa 5,2 GB für Qwen3 8B, 9,3 GB für Qwen3 14B und 20 GB für Qwen3 32B auf; als grobe Regel gelten also 0,65 GB pro Milliarde Parameter bei Q4. Ein PC mit 32 GB kann Qwen3 32B aufnehmen, aber die Bandbreiten-Obergrenze bei Dual-Channel-DDR5-5600 liegt bei etwa 4,5 Tok/s (89,6 GB/s ÷ 20 GB), womit es ein Batch-Werkzeug ist. Mixture-of-Experts-Modelle wie Qwen3 30B-A3B (19 GB) lesen pro Token nur wenige Milliarden aktive Parameter und sollten daher schneller laufen, als ihre Dateigröße vermuten lässt.
Quellen
- Phi-4-mini Modellkarte — Microsoft Research. Von den Entwicklern gemeldete Benchmark-Ergebnisse; veröffentlicht 2025.
- Ollama-Bibliothek: Qwen3 — Dateigrößen und Kontextlängen für qwen3:0.6b, 1.7b, 4b und 8b (geprüft am 23.10.2026).
- Ollama-Bibliothek: Qwen3.5 — Dateigrößen für qwen3.5:0.8b, 2b und 4b (geprüft am 23.10.2026).
- Ollama-Bibliothek: Gemma 4 — Download-Größe von gemma4:e2b und 128K Kontext (geprüft am 23.10.2026).
- Ollama-Bibliothek: Phi-4-mini — 2,5 GB, 128K Kontext (geprüft am 23.10.2026).
- Ollama-Bibliothek: nomic-embed-text — Embedding-Modell mit 274 MB, 2K Kontextfenster (geprüft am 23.10.2026).
- Ollama-Dokumentation: GPU-Unterstützung — Vulkan, ROCm und Variablen zur GPU-Auswahl, darunter OLLAMA_VULKAN.
- Ollama-Dokumentation: FAQ — OLLAMA_CONTEXT_LENGTH, OLLAMA_KV_CACHE_TYPE, OLLAMA_FLASH_ATTENTION, OLLAMA_KEEP_ALIVE und `ollama ps`.
- Intel Processor N100 Spezifikationen — ein Speicherkanal; DDR4-3200, DDR5-4800, LPDDR5-4800.
- Berichterstattung zur Gemma-4-Ankündigung — Veröffentlichung am 2. April 2026, etwa 2,3 Mrd. effektive und 5,1 Mrd. Gesamtparameter (Zusammenfassung eines Drittanbieters).
- llama.cpp-Build-Dokumentation — CPU-Backends und Build-Optionen.