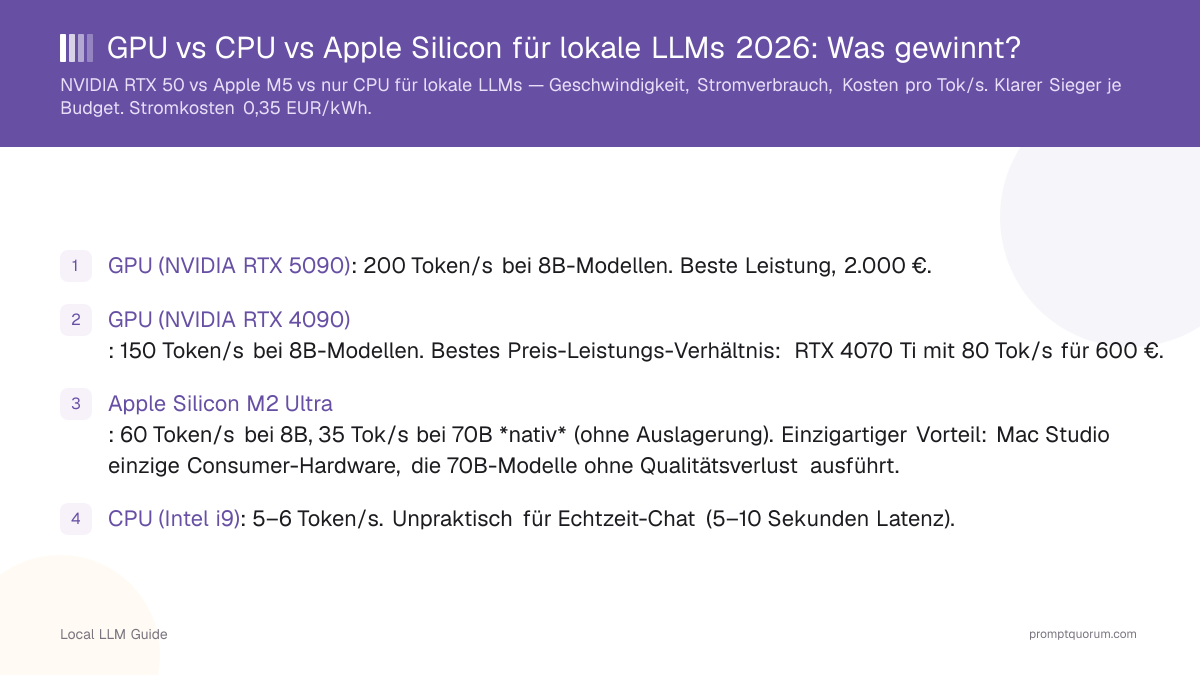
Wichtigste Erkenntnisse
- Apple M5 Pro (64 GB, ~2.399 $): bestes Allround-Gerät für die meisten Nutzer. 40–60 Tok/s bei 30B-Modellen, geringer Verbrauch (~25 W bei Inferenz), keine VRAM-Grenze.
- NVIDIA RTX 5090 (32 GB, 2.000 $): am schnellsten für 7B–14B-Modelle mit 150–200 Tok/s. Kann 30B+ nicht ohne CPU-Offloading laden. Am besten für Produktions-Workloads.
- NVIDIA RTX 5070 (12 GB, ~600 $): bestes Preis-Leistungs-Verhältnis bei GPUs. 60–80 Tok/s bei 8B-Modellen. Auf 7B–8B bei voller Präzision begrenzt.
- Apple M5 Max (64–128 GB, ~3.199 $+): 460–614 GB/s Bandbreite. Führt 30B–70B nativ aus. Am besten für Forscher und intensive 30B+-Nutzung.
- Nur CPU (moderne Ryzen/Intel): 10–20 Tok/s bei 7B-Modellen mit schnellem DDR5-RAM. Für gelegentliche Nutzung geeignet, unpraktisch für Echtzeit-Chat.
- Fazit: Für die meisten Nutzer gewinnt Apple M5 Pro mit 64 GB — größere Modelle als jede einzelne GPU, geringere Kosten als ein GPU-Build, 10× weniger Stromverbrauch. RTX 50-Serie nur wählen für maximale Geschwindigkeit bei 7B–14B oder Produktions-Workloads.
📍 In einem Satz
Für lokale LLMs: Apple M5 Pro 64 GB (~2.399 $) ist das beste Allround-Gerät mit 40–60 Tok/s bei 30B-Modellen; RTX 5090 32 GB (~2.000 $) ist am schnellsten für 7B–14B (150–200 Tok/s), aber kein 30B+; RTX 5070 12 GB (~600 $) bietet bestes GPU-Preis-Leistungs-Verhältnis; CPU-only: 10–20 Tok/s bei 7B.
💬 In einfachen Worten
GPUs sind bei kleinen Modellen (unter 14B) am schnellsten dank hoher Compute-Bandbreite. Apple Silicon gewinnt bei größeren Modellen (30B+) durch integrierten Speicher und niedrige Leistungsaufnahme. CPU-only ist am langsamsten, funktioniert aber auf jedem Laptop.
Leistungsvergleich: Geschwindigkeit, Bandbreite und Kosten
*Erfordert CPU-Offloading – erhebliche Geschwindigkeitseinbuße und Qualitätsverlust bei niedrigen Bit-Breiten
Hardware | Qwen3 8B | Qwen3 30B | Verbrauch | Kosten |
|---|---|---|---|---|
| RTX 5090 (GPU, 32 GB GDDR7) | 150–200 Tok/s | Nicht möglich* | ~450W | 2.000 $ |
| RTX 5080 (GPU, 16 GB GDDR7) | 100–130 Tok/s | Nicht möglich* | ~360W | 1.000 $ |
| RTX 5070 Ti (GPU, 16 GB) | 80–100 Tok/s | Nicht möglich* | ~300W | 750 $ |
| RTX 5070 (GPU, 12 GB) | 60–80 Tok/s | Nicht möglich* | ~250W | 600 $ |
| MacBook Pro M5 Pro (36–64 GB, 307 GB/s) | 40–60 Tok/s | 20–30 Tok/s | ~25W | 2.399 $+ |
| MacBook Pro M5 Max (64–128 GB, 460–614 GB/s) | 60–80 Tok/s | 35–50 Tok/s | ~35W | 3.199 $+ |
| Mac mini M5 base (16–32 GB, 200 GB/s) | 25–35 Tok/s | Offload* | ~15W | 599 $+ |
| Intel Core Ultra 9 / AMD Ryzen 9 (CPU, DDR5) | 10–20 Tok/s | 3–5 Tok/s | ~65W | Enthalten |

Wann man sich für GPU entscheidet (RTX 50-Serie)
Wählen Sie eine NVIDIA-GPU der RTX 50-Serie, wenn Sie maximale Geschwindigkeit bei 7B–14B-Modellen benötigen oder 24/7-Produktions-Workloads betreiben.
- RTX 5090 (32 GB GDDR7, 1.792 GB/s): 150–200 Tok/s bei 8B-Modellen. 2.000 $. Am besten für Produktions-Pipelines, Fine-Tuning und geschwindigkeitskritische Anwendungen.
- RTX 5080 (16 GB GDDR7): 100–130 Tok/s bei 8B. 1.000 $. Gutes Verhältnis von Geschwindigkeit und Kosten für 8B–13B.
- RTX 5070 Ti / 5070 (12–16 GB): 60–100 Tok/s bei 8B. 600–750 $. Bestes Preis-Leistungs-Verhältnis für Chat und Coding mit einem Nutzer.
- CUDA-Ökosystem-Vorteil: vLLM, llama.cpp, LM Studio sind alle nativ optimiert. Schnellste Inferenz bei nativer Präzision.
- Harte Grenze: Keine RTX 50-Serie-Karte lädt 30B-Modelle in voller Qualität (erfordert 20+ GB VRAM). Auslagerung auf System-RAM erzeugt 5–10× Geschwindigkeitsstrafe.
Der Stromverbrauch ist der zentrale Trade-off: RTX 5090 zieht 450 W unter Last gegenüber 25 W beim M5 Pro. Bei 0,35 €/kWh kostet die RTX 5090 ~55 € mehr pro Monat an Strom bei 8 Std./Tag.
Wann man sich für Apple Silicon entscheidet (M5)
Wählen Sie Apple Silicon M5, wenn Sie 14B–70B-Modelle ausführen müssen, Energieeffizienz schätzen oder macOS als Hauptsystem nutzen.
- M5 base (16–32 GB, 200 GB/s): führt 7B–8B nativ mit 25–35 Tok/s aus. Ab 599 $ (Mac mini). Guter Einstiegspunkt.
- M5 Pro (36–64 GB, 307 GB/s): führt bis zu 30B nativ mit 20–30 Tok/s aus. ~2.399 $ (MacBook Pro). Bestes Allround-Preis-Leistungs-Verhältnis.
- M5 Max (64–128 GB, 460–614 GB/s): führt 30B–70B nativ mit 35–50 Tok/s aus. ~3.199 $+. Am besten für Forscher und intensive 70B-Workloads.
- Vorteil des einheitlichen Speichers: keine VRAM-Obergrenze. Ein M5 Pro mit 64 GB lädt 30B-Modelle nativ; ein M5 Max mit 128 GB lädt 70B-Modelle nativ.
- Apple-Angaben: 4× schnellere LLM-Inferenz gegenüber M4 in der M5-Generation.
- MLX-Framework: Apples MLX ist für Apple Silicon optimiert. Qwen3-Modelle laufen hervorragend auf MLX. DeepSeek-R1 14B liefert gute Ergebnisse.
Trade-off: kann die rohe Geschwindigkeit der RTX 5090 bei 7B nicht erreichen. Langsamer für Fine-Tuning. Keine CUDA-exklusiven Tools.
Wann Nur-CPU ausreicht
Reine CPU-Inferenz ist praktikabel, wenn Sie nur gelegentliche Antworten benötigen und kleine Modelle (7B Q4) ausführen.
- Moderne Intel Core Ultra 9 / AMD Ryzen 9 mit DDR5-5600: 10–20 Tok/s bei Qwen3 8B oder Llama 3.2 8B. Nutzbar für nicht-interaktive Batch-Aufgaben.
- Ältere CPU / DDR4: 5–8 Tok/s. Merkliche Latenz (5–8 Sekunden pro Antwort) macht interaktiven Chat unangenehm.
- Keine zusätzlichen Hardwarekosten: Wenn Sie bereits einen leistungsfähigen Desktop besitzen, funktionieren llama.cpp oder Ollama sofort.
- Stromverbrauch: CPUs ziehen bei voller Inferenzlast 65–125 W – weniger als eine GPU, mehr als Apple Silicon.
CPU-Inferenz eignet sich für: Dokumentenzusammenfassung im Batch, nächtliche Verarbeitung, gelegentliche Fragen. Vermeiden Sie Nur-CPU für Echtzeit-Chat, Coding-Assistenten oder Modelle größer als 8B.
Speicherbandbreite: Der echte Geschwindigkeitsbottleneck
LLM-Inferenz ist speichergebunden, nicht rechengebunden. Die Token-Generierungsgeschwindigkeit wird dadurch begrenzt, wie schnell Sie Modellgewichte aus dem Speicher laden können. Höhere Speicherbandbreite = schnellere Token-Generierung.
Die Formel: Inferenzgeschwindigkeit ≈ Speicherbandbreite ÷ Modellgewichte im Speicher
- RTX 5090 mit 1.792 GB/s hat die schnellste Einzel-GPU-Bandbreite, die 2026 verfügbar ist.
- M5 Max mit 460–614 GB/s erreicht oder übertrifft die RTX 5080 bei der Bandbreite – mit 128 GB einheitlichem Speicher gegenüber 16 GB VRAM.
- M5 Pro mit 307 GB/s ist der Sweet Spot: genug Bandbreite für 30B-Modelle, halb so teuer wie M5 Max.
- CPU-DDR5 mit 89 GB/s ist 20× langsamer als RTX 5090, aber 4× schneller als DDR4 – eine deutliche Verbesserung für CPU-Inferenz.
- Vorteil des einheitlichen Speichers: Kein CPU↔GPU-Übertragungsaufwand. M5 Pro hält ein 30B-Modell vollständig in seinem 64-GB-Pool.
Plattform | Speicherbandbreite | Effektive Geschwindigkeit (8B) |
|---|---|---|
| RTX 5090 (GDDR7) | 1.792 GB/s | 150–200 Tok/s |
| RTX 5080 (GDDR7) | 960 GB/s | 100–130 Tok/s |
| RTX 5070 (GDDR7) | 672 GB/s | 60–80 Tok/s |
| M5 Max (einheitlich, 128 GB) | 460–614 GB/s | 60–80 Tok/s |
| M5 Pro (einheitlich, 64 GB) | 307 GB/s | 40–60 Tok/s |
| M5 base (einheitlich, 32 GB) | 200 GB/s | 25–35 Tok/s |
| DDR5-5600 RAM (nur CPU) | 89 GB/s | 10–20 Tok/s |
| DDR4-3200 RAM (nur CPU) | 51 GB/s | 5–8 Tok/s |
Kosten pro Tok/s: Echte Wertanalyse
Kosten pro Tok/s vergleicht den Hardware-Wert: Anschaffungskosten geteilt durch dauerhafte Tokengeschwindigkeit.
RTX 5070 hat die besten Kosten pro Tok/s bei reiner Geschwindigkeit. M5 Pro gewinnt bei Energie: bei 0,15 €/kWh und 8 Std./Tag kostet M5 Pro ~1,10 €/Monat gegenüber ~16,50 €/Monat für RTX 5090.
Wenn Sie bereits einen Mac mit M5 Pro besitzen, sind die Kosten pro Tok/s für den Hardware-Anteil effektiv 0 €.
Hardware | Anfangskosten | Tok/s (8B) | Kosten pro Tok/s | Verbrauch (Inferenz) |
|---|---|---|---|---|
| RTX 5090 (32 GB) | 2.000 $ | 175 | 11,4 $ | 450W |
| RTX 5070 (12 GB) | 600 $ | 70 | 8,6 $ | 250W |
| M5 Pro MacBook Pro (64 GB) | 2.399 $ | 50 | 48 $ | 25W |
| M5 Max MacBook Pro (128 GB) | 3.199 $ | 70 | 46 $ | 35W |
| CPU (moderner DDR5-Desktop) | Enthalten | 15 | 0 $ | 65W |

Entscheidungsleitfaden für Plattformen
Entscheidungsrahmen basierend auf Modellgröße, Budget und Anwendungsfall:
- RTX 5090 / 5080 wählen: maximale Geschwindigkeit bei 7B–14B, Produktions-Pipelines, Fine-Tuning, 24/7-Server-Workloads.
- RTX 5070 / 5070 Ti wählen: bestes GPU-Preis-Leistungs-Verhältnis für Chat und Coding mit einem Nutzer bei 7B–13B. 600–750 $.
- M5 Pro (64 GB) wählen: bestes Allround-Gerät für die meisten Nutzer. Führt 30B nativ aus, geringer Verbrauch, macOS-Workflow. ~2.399 $.
- M5 Max (128 GB) wählen: für Forschung, 70B-Modelle nativ, maximale Apple-Silicon-Leistung. ~3.199 $+.
- Nur CPU: keine zusätzliche Investition, gelegentliche 7B-Nutzung, nächtliche Batch-Verarbeitung.

Häufige Fehler bei der Hardware-Wahl
- GPU für 30B+-Modelle wählen. Keine RTX 50-Serie-Karte lädt 30B in den VRAM. Auslagerung auf RAM erzeugt eine 5–10× Geschwindigkeitsstrafe. Verwenden Sie stattdessen M5 Pro oder M5 Max.
- Annehmen, dass M5 base (16 GB) ausreicht. Er lädt nur 7B. Für 14B-Modelle brauchen Sie 32 GB; für 30B brauchen Sie 64 GB (M5 Pro).
- Stromkosten für dauerhaft laufende GPU-Server ignorieren. RTX 5090 bei 8 Std./Tag = ~200 $/Jahr Strom bei 0,15 $/kWh. M5 Pro = ~14 $/Jahr.
- RTX 5090 für 8B-Chat kaufen. RTX 5070 für 600 $ liefert 70 Tok/s bei 8B – 80 % der Geschwindigkeit zu 30 % der Kosten.
- Erwarten, dass CPU für Echtzeit-Chat praktikabel ist. Selbst 20 Tok/s fühlt sich langsam an. 5–8 Tok/s auf DDR4 ist für interaktive Nutzung unbrauchbar.
Häufig gestellte Fragen
Ist GPU oder CPU besser zum Ausführen lokaler LLMs?
Für Echtzeitinferenz ist NVIDIA-GPU schneller: RTX 5070 führt 8B-Modelle mit 60–80 Tok/s aus gegenüber 10–20 Tok/s auf einer modernen CPU mit DDR5. Apple M5 Pro mit 40–60 Tok/s übertrifft ebenfalls die CPU und kann zusätzlich 30B-Modelle nativ ausführen.
Kann Apple Silicon lokale LLMs ausführen?
Ja. Die Apple M5-Serie führt 7B-Modelle mit 25–80 Tok/s aus, je nach Chip-Klasse. M5 Pro (64 GB) führt 30B-Modelle nativ mit 20–30 Tok/s aus – das kann keine Consumer-GPU erreichen. M5 Max (128 GB) führt 70B-Modelle nativ mit 35–50 Tok/s aus.
Was ist der minimale GPU-VRAM für lokale LLMs?
12 GB VRAM (RTX 5070) führen 7B–8B-Modelle bei Q4–Q8-Quantisierung problemlos aus. 16 GB (RTX 5080) verarbeiten 13B-Modelle. 24–32 GB werden für 30B-Modelle benötigt, aber keine einzelne Consumer-GPU lädt 30B vollständig – verwenden Sie stattdessen Apple M5 Pro mit 64 GB.
Wie viel schneller ist GPU vs CPU bei der LLM-Inferenz?
RTX 5090 ist 8–15× schneller als eine moderne CPU mit DDR5 bei 8B-Modellen (175 Tok/s gegenüber 15 Tok/s). Der Unterschied kommt von der Speicherbandbreite: 1.792 GB/s (GDDR7) gegenüber 89 GB/s (DDR5). Apple M5 Pro mit 307 GB/s liegt mit 40–60 Tok/s dazwischen.
Lohnt sich der GPU-Kauf nur für lokale LLMs?
RTX 5070 (600 $) amortisiert über 3 Jahre kostet weniger als OpenAI-API-Gebühren für Vielnutzer mit 2+ Stunden pro Tag. Mit 70 Tok/s verarbeitet sie Echtzeit-Chat und Coding-Unterstützung. Wenn Sie 30B+-Modelle brauchen, bietet M5 Pro trotz höherer Anschaffungskosten mehr Wert.
Was ist Speicherbandbreite und warum ist sie für LLMs wichtig?
LLM-Inferenz ist speichergebunden. Token-Geschwindigkeit ≈ Speicherbandbreite ÷ Modellgewichte. RTX 5090: 1.792 GB/s. M5 Max: 460–614 GB/s. M5 Pro: 307 GB/s. CPU DDR5: 89 GB/s. Deshalb kann Apple Silicon mit einheitlichem Speicher große Modelle effizient ausführen, trotz geringerer roher Bandbreite als Top-GPUs.
Welcher Apple Silicon Chip ist 2026 am besten für lokale LLMs?
M5 Pro (64 GB, 307 GB/s) ist das beste Allround-Gerät für die meisten Nutzer – führt 30B-Modelle nativ mit 20–30 Tok/s für ~2.399 $ aus. M5 Max (128 GB, 460–614 GB/s) für 70B-Modelle mit 35–50 Tok/s (~3.199 $+). Vermeiden Sie M5 base (16 GB) für alles über 7B hinaus.
Kann Apple Silicon 30B- und 70B-Modelle ausführen?
M5 Pro (64 GB) führt 30B-Modelle nativ mit 20–30 Tok/s aus. M5 Max (128 GB) führt 70B-Modelle nativ mit 35–50 Tok/s aus. Das sind reale Durchsatzwerte ohne CPU-Offloading – keine Consumer-GPU kann das bei 30B+ erreichen.
Lohnt sich RTX 5090 für 2.000 $ bei lokalen LLMs?
Nur, wenn Ihr Workflow 7B–14B-Modelle bei maximaler Geschwindigkeit erfordert oder Sie Produktions-Inferenz-Pipelines betreiben. Für die meisten liefert RTX 5070 (600 $) 80 % der Geschwindigkeit zu 30 % der Kosten. Für 30B+-Modelle ist M5 Pro unabhängig vom Budget die bessere Wahl.
Wie vergleicht sich der Stromverbrauch zwischen GPU und Apple Silicon?
RTX 5090 zieht ~450 W bei Inferenzlast. M5 Pro zieht ~25 W. Bei 8 Std./Tag und 0,15 $/kWh sind das 200 $/Jahr (RTX 5090) gegenüber 14 $/Jahr (M5 Pro). Für Privatnutzer und alle mit gewerblichen Stromtarifen ist die Energieeffizienz von M5 Pro ein spürbarer Kostenvorteil.
Wie schnell ist LLM-Inferenz auf einem Intel MacBook Pro (i9, 16 GB RAM)?
Langsamer als Apple Silicon und langsamer als ein moderner DDR5-Desktop. Intel MacBook Pros haben keinen Unified-Memory-GPU-Pfad für llama.cpp — die Inferenz läuft rein auf der CPU über DDR4, mit etwa 38–45 GB/s Dual-Channel-Bandbreite gegenüber 89 GB/s bei einer modernen DDR5-Desktop-CPU. Mit der oben genannten Formel Speicherbandbreite ÷ Modellgröße landet ein quantisiertes 7B-Modell (~4,5 GB bei Q4) bei theoretisch etwa 8–10 Tok/Sek., realistisch bei 4–7 Tok/Sek. unter Berücksichtigung des CPU-Rechenaufwands. 16 GB Gesamt-RAM begrenzen Sie zudem auf etwa 7B–8B bei Q4 mit Spielraum für das Betriebssystem — erwarten Sie keine 13B+-Modelle ohne starkes Swapping und einen deutlichen Geschwindigkeitseinbruch.
Was ist der Unterschied zwischen pp Tok/Sek. und tg Tok/Sek.?
pp Tok/Sek. (Prompt Processing) misst, wie schnell das Modell Ihren Eingabe-Prompt verarbeitet — die "Prefill"-Phase, die rechengebunden ist und mit paralleler Hardware wie GPUs gut skaliert. tg Tok/Sek. (Token Generation) misst, wie schnell es jedes neue Ausgabe-Token erzeugt — die "Decode"-Phase, die speicherbandbreitengebunden ist (siehe die Bandbreitenformel oben). GPUs zeigen typischerweise eine große pp/tg-Lücke (schnelles Prefill, durch Bandbreite begrenzte Generierung); der Unified Memory von Apple Silicon hält beide Werte näher beieinander. Prüfen Sie beim Vergleich von Benchmarks immer, welche Zahl Sie gerade lesen — pp und tg können auf derselben Hardware um das 5- bis 20-Fache voneinander abweichen.
Muss ich bei der Verwendung lokaler LLMs die DSGVO beachten?
Ja. DSGVO Artikel 28 (Prozessor vs. Verantwortlicher), BSI-IT-Grundschutz-Kataloge. Egal ob RTX 5070 oder Apple M5 Pro: Lokale Inferenz hält Eingabe- und Ausgabedaten auf Ihrer eigenen Hardware — das Art.-44-Transferrisiko für die KI-Schicht entfällt. DSGVO-Konformität und BSI-IT-Grundschutz hängen vom Gesamtsystem und Ihren TOMs ab, nicht vom GPU- oder Chip-Modell.
Ist lokale LLM-Hardware für den deutschen Mittelstand geeignet?
Ja, besonders für den Mittelstand. RTX 5070 (600 $) ist ein kostengünstiger Einstieg, keine Abhängigkeit von US-Cloud-APIs. Lokale Inferenz hält Eingabe- und Ausgabedaten auf Ihrer eigenen Hardware — das Art.-44-Transferrisiko für die KI-Schicht entfällt. DSGVO-Konformität und BSI-IT-Grundschutz-Konformität hängen vom Gesamtsystem und Ihren TOMs ab, nicht vom Hardware-Modell. Lokale Hardware in Deutschland/Österreich/Schweiz vermeidet Datentransfers ins Ausland.
Quellen
- NVIDIA GPU-Spezifikationen — RTX 50 Serie GPU-Spezifikationen, VRAM, Speicherbandbreite.
- Apple M3 Leistung — M5 Max einheitliche Speicherarchitektur und Inferenzleistung.
- vLLM-Benchmarks — Produktions-LLM-Inferenz-Durchsatz-Benchmarks.
- Unterschiedliche Hardware erzeugt unterschiedliche Token-Raten, aber jede Inferenz profitiert von strukturierten Prompts. Lange Kontextanfragen erfordern andere Techniken als kurze: Kontextfenster erklärt behandelt Strategien für jede Hardware.