Wichtigste Erkenntnisse
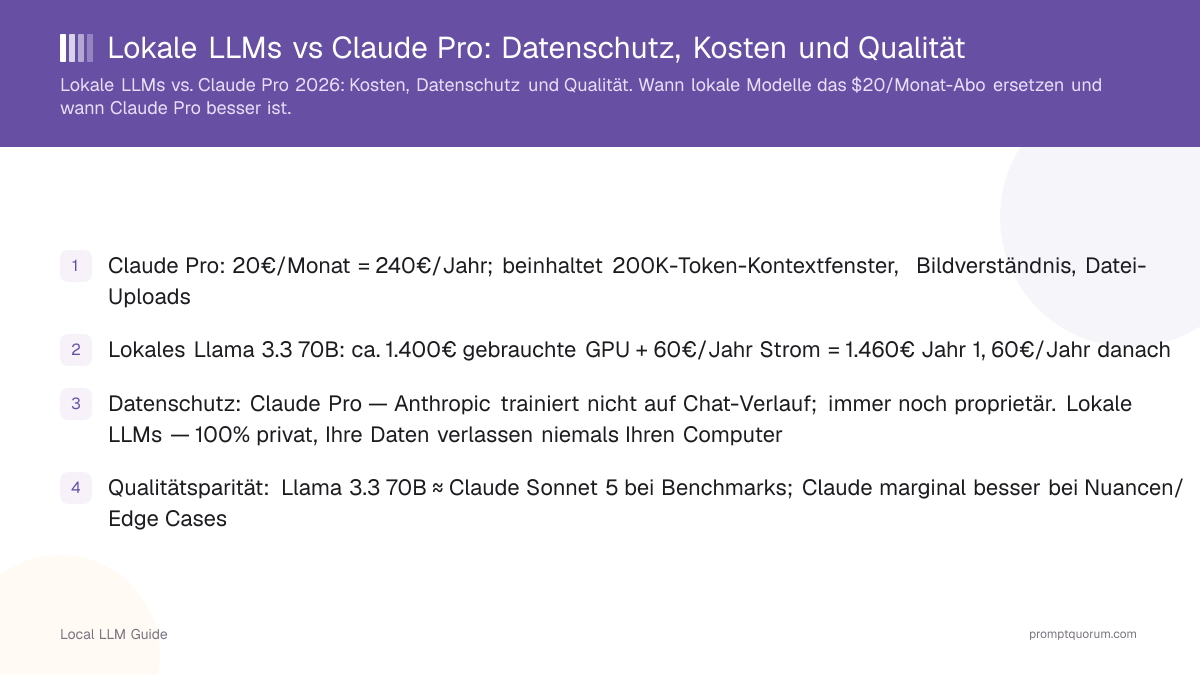
- Claude Pro: 20€/Monat = 240€/Jahr; beinhaltet 200K-Token-Kontextfenster, Bildverständnis, Datei-Uploads
- Lokales Llama 3.3 70B: dual RTX 4070s gebraucht ca. 500€ (empfohlen) + 60€/Jahr Strom = 560€ Jahr 1, 60€/Jahr danach. Eine gebrauchte RTX 4090 kostet jetzt 2.100–2.800€ (von NVIDIA 2026 eingestellt).
- Datenschutz: Claude Pro — Anthropic trainiert nicht auf Chat-Verlauf; immer noch proprietär. Lokale LLMs — 100% privat, Ihre Daten verlassen niemals Ihren Computer
- Qualitätsparität: Llama 3.3 70B ≈ Claude Sonnet 5 bei Benchmarks; Claude marginal besser bei Nuancen/Edge Cases
- Kontextfenster: Claude Pro 200K Tokens vs Llama 3.3 70B 128K Tokens (immer noch ausgezeichnet für Dokumente)
- 5-Jahres-TCO: Claude Pro 1.200€ vs Lokal mit dual RTX 4070s (500€ GPU + 300€ Strom) = 800€ — günstiger als Claude. Eine gebrauchte RTX 4090 (2.100–2.800€ + 300€ Strom) amortisiert sich möglicherweise nicht in 5 Jahren.
- Lokaler Vorteil: Unbegrenzte Abfragen, null Ratenbegrenzungen, Offline-Fähigkeit, Modellbesitz
- Claude Pro-Vorteil: Bessere Multimodal-Fähigkeiten (Bilder), Echtzeit-Updates, null Infrastruktur-Overhead
Schnelle Fakten
- Claude Pro Preis: 20€/Monat (240€/Jahr), keine Hardware erforderlich
- Llama 3.3 70B Hardware: dual RTX 4070s (~500€ gebraucht, empfohlen) oder eine gebrauchte RTX 4090 (2.100–2.800€ — von NVIDIA 2026 eingestellt)
- 5-Jahres-TCO: Claude Pro 1.200€ vs Lokal ~800€ (dual RTX 4070s) — lokal günstiger. Eine gebrauchte RTX 4090 (~2.400€) amortisiert sich möglicherweise nicht in 5 Jahren.
- MMLU-Ergebnisse: Claude Sonnet 5 97% vs Llama 3.3 70B 96%
- Kontextfenster: Claude Pro 200K Tokens vs Llama 3.3 128K Tokens
- Amortisationspunkt: ~Monat 33 (dual RTX 4070s) — danach ist lokal unbegrenzt billiger. Eine gebrauchte RTX 4090 überschreitet das 5-Jahres-Fenster.
Was ist der Preisunterschied zwischen Claude Pro und lokalen LLMs?
Claude Pro berechnet 20€/Monat ohne Hardware erforderlich; lokales Llama 3.3 70B kostet ca. 500€ Auffront mit dual RTX 4070s (empfohlen) oder 2.100–2.800€ mit einer gebrauchten RTX 4090 (von NVIDIA 2026 eingestellt), plus ~60€/Jahr Strom. Jahr 1 ist mit Claude Pro absolut gesehen weiterhin günstiger, aber dual RTX 4070s amortisieren sich um Monat 33.
5-Jahres-Gesamtkostenrechnung: Claude Pro 1.200€ vs Lokal Llama (dual RTX 4070s gebraucht) 800€ vs Lokal Llama (gebrauchte RTX 4090) 2.400–3.100€. Jahr 1: Claude Pro 240€ vs Lokal 560€ (4070s) oder 2.160–2.860€ (4090). Jahr 3: Claude Pro 720€ vs Lokal 680€ (4070s) oder 2.280–2.980€ (4090). Jahr 5: Claude Pro 1.200€ vs Lokal 800€ (4070s) oder 2.400–3.100€ (4090).
Beste GPUs für lokale LLMs hat detaillierte Hardware-Optionen und aktuelle Marktpreise.
•⚠️ Warnung: NVIDIA hat die RTX 4090 2026 eingestellt; gebrauchte Preise sind auf 2.100–2.800€ gestiegen — das kann die Amortisation gegenüber Claude Pro in 5 Jahren verhindern.
•💡 Pro Tipp: Dual RTX 4070s (~500€ gebraucht) führen Llama 3.3 70B mit 60–70% der Geschwindigkeit einer einzelnen 4090 für etwa ein Viertel der Kosten aus — 2026 die wirtschaftlichere Wahl.
Wie unterscheiden sich Datenschutzmodelle zwischen Claude Pro und lokalen LLMs?
Claude Pro (Anthropic): Ihre Konversationen werden nicht zum Trainieren zukünftiger Claude-Modelle verwendet (Anthropic explizite Datenschutzrichtlinie seit 2026). Abfragen werden jedoch auf Anthropic-Servern für Sicherheitsüberwachung und Debugging protokolliert. Anthropic hat seinen Sitz in den USA und unterliegt US-Gesetzen.
Lokale LLMs: Alle Daten bleiben auf Ihrem Computer. Null Cloud-Protokollierung, null Drittanbieter-Sichtbarkeit. Geeignet für Gesundheitswesen (DSGVO), Finanzen (PCI-DSS) und legale (Anwalts-Klient-Privileg) Workflows. Seit April 2026 ist Llama 3.3 vollständig Open Source (keine Anthropic-Datenerfassung).
•📌 Wichtiger Punkt: Anthropic trainiert nicht auf Chat-Verlauf, aber Konversationen werden auf US-Servern für Sicherheitsüberwachung protokolliert.
•🛡️ Compliance: Für DSGVO, PCI-DSS oder Anwalts-Klient-Privileg-Workflows sind nur lokale LLMs konform — kein Drittanbieter-Server sieht jemals Ihre Daten.
Wie vergleichen sich Claude Sonnet 5 und Llama 3.3 70B in der Qualität?
Claude Sonnet 5 (Anthropic, 2026): führend bei Reasoning, Nuancierung und Anweisungsfolge (laut Anthropic-Benchmark-Angaben). 97% MMLU (Sprachverständnis) Ergebnis. Excels bei komplexer Analyse, Copywriting, Code-Reviews. MMLU-Ergebnis: 97%. Kontextfenster: 200K Tokens. Bildverständnis: Nativ. Fine-Tuning: Nicht verfügbar. Offline: Nein. Ratenbegrenzungen: Ja.
Llama 3.3 70B (Meta, April 2024): 96% MMLU-Ergebnis. Ausgezeichnetes Reasoning, nahezu Parität mit Claude bei Benchmarks. Stärkere Coding-Leistung (+2% auf HumanEval). Etwas schwächer bei kreativen/narrative Aufgaben. MMLU-Ergebnis: 96%. HumanEval: +2% vs Claude. Kontextfenster: 128K Tokens. Bildverständnis: Via Adapter nur. Fine-Tuning: Vollständig (LoRA, voll). Offline: Ja. Ratenbegrenzungen: Keine.
Bei 80% der Real-World-Aufgaben (Zusammenfassung, Q&A, Datenextraktion, Coding) erzeugen Llama 3.3 70B und Claude Sonnet 5 äquivalente Output. Bei Edge Cases (subtile narrative Analyse, domänenspezifisches kreatives Schreiben) ist Claude marginal besser. Wie viel VRAM brauchen Sie für lokale LLMs? behandelt Hardware-Anforderungen für die Ausführung von 70B-Modellen.
📍 In einem Satz
Llama 3.3 70B matched Claude Sonnet 5 bei 80% der Real-World-Aufgaben, aber Claude ist bei nuanciertem Reasoning und kreativem Schreiben Edge Cases leicht überlegen.

•💡 Pro Tipp: Im HumanEval-Coding-Benchmark erzielte Llama 3.3 70B in Tests vom April 2026 ca. 2 Prozentpunkte mehr als Claude Sonnet 5 (EvalPlus-Leaderboard; Ergebnisse variieren je nach Benchmark-Version und Aufgabenverteilung).
Wie viel können beide lange Dokumente verarbeiten?
Claude Pro 200K Tokens: ~150.000 Wörter (äquivalent zu 3 Büchern). Kann ganze Codebase, rechtliche Verträge oder Forschungspapiere in einer Abfrage verarbeiten.
Llama 3.3 70B 128K Tokens: ~96.000 Wörter. Immer noch ausgezeichnet für die meisten Dokumente; einige sehr große Codebases oder 500+-Seiten-Verträge überschreiten dieses Limit.
Seit April 2026: Für Dokumentenverarbeitungs-Workflows (RAG, Bulk-Zusammenfassung, Vertragsüberprüfung) ist Claudes 200K-Fenster ein greifbarer Vorteil. Llama 3.3 128K ist ausreichend für ~95% der Business-Dokumente.
•📌 Wichtiger Punkt: Beide Kontextfenster sind massiv. Nur sehr große Codebases oder 500+-Seiten-Verträge treffen Llamas 128K-Limit.
Was ist die 5-Jahres-Gesamtkostenrechnung im Vergleich?
Claude Pro: 20€ × 60 Monate = 1.200€ gesamt.
Lokales Llama 3.3 70B (dual RTX 4070s, gebraucht): 500€ + Strom 5 Jahre 300€ = 800€ gesamt. Der empfohlene Weg, seit NVIDIA die RTX 4090 eingestellt hat.
Lokales Llama 3.3 70B (gebrauchte RTX 4090): 2.100–2.800€ + 300€ Strom = 2.400–3.100€ gesamt.
Amortisationspunkt: ~33 Monate (rund 3 Jahre) mit dual RTX 4070s. Eine gebrauchte RTX 4090 amortisiert sich bei aktuellen Preisen nicht innerhalb von 5 Jahren.
💬 In einfachen Worten
Über 5 Jahre kosten dual RTX 4070s rund 800€ gegenüber 1.200€ für Claude Pro — günstiger. Eine gebrauchte RTX 4090 kostet jetzt 2.100–2.800€ (NVIDIA hat sie 2026 eingestellt), amortisiert sich also nicht mehr gegenüber Claude Pro in 5 Jahren.

•💡 Pro Tipp: Strombegrenzung einer 4070 auf 350W spart 40% Strom mit nur ~10% Geschwindigkeitsverlust — bringt 5-Jahres-Lokalkosten mit dual 4070s unter 700€.
Kosten & Datenschutz FAQ
•🔍 Wussten Sie?: Claude Pro ist identisch mit ChatGPT Plus zu 20€/Monat bepreist, bietet aber ein 10× größeres Kontextfenster (200K vs 16K Tokens).
Kann ich Claude Pro offline verwenden?
Nein. Claude Pro erfordert aktive Internetverbindung und Anthropic-Server. Lokales Llama 3.3 funktioniert vollständig offline.
Verwendet Anthropic meine Claude Pro-Konversationen zum Trainieren?
Nein (seit April 2026). Anthropic trainiert explizit nicht auf Chat-Verlauf. Konversationen werden für Sicherheit/Debugging protokolliert, aber nicht für Modell-Verbesserung verwendet.
Ist Llama 3.3 70B wirklich kostenlos zu verwenden?
Ja. Llama 3.3 ist Open Source unter Metas Community-Lizenz. Sobald Sie die GPU besitzen, kostet Inference 0€ (nur Strom). Modell-Updates sind kostenlos.
Kann ich Claude Pro oder lokales Llama unterschiedlich fine-tunen?
Claude Pro: Kein Fine-Tuning verfügbar seit April 2026. Lokales Llama 3.3: Vollständiges Fine-Tuning Support (LoRA, Vollparameter-Tuning). Lokal gewinnt bei Anpassung.
Was wenn meine lokale GPU ausfällt?
Sie verlieren Rechenleistung bis sie ersetzt ist (~500€ mit dual RTX 4070s, ~2.100–2.800€ mit einer gebrauchten RTX 4090). Claude Pro degradiert elegant (Ratenbegrenzung). Lokal erfordert Redundanz-Planung (Backup-GPU, Cloud-Failover).
Kann Llama 3.3 Bilder wie Claude Pro verarbeiten?
Nativ multimodal: Nein (seit April 2026). Sie können mit Open-Source-Vision-Modellen (CLIP, LLaVA) integrieren als Workaround, aber es's nicht so nahtlos wie Claude.
Ist Claude Pro besser als Llama 3.3 bei irgendeiner spezifischen Aufgabe?
Ja. Claude Sonnet 5 excels bei nuancierter narrativer Analyse, komplex mehrstufigen Reasoning mit mehrdeutigen Kontext und kreatives Schreiben Edge Cases. Im HumanEval-Coding-Benchmark erzielte Llama 3.3 70B in April-2026-Tests ca. 2 Prozentpunkte mehr als Claude (EvalPlus-Leaderboard; Ergebnisse hängen von der Benchmark-Version und Aufgabenverteilung ab).
Kann ich von Claude Pro zu lokales LLM ohne Verlust meiner Workflows wechseln?
Ja. Die meisten Claude Pro Anwendungsfälle (Q&A, Zusammenfassung, Coding) transferieren direkt zu Llama 3.3 70B via Ollama oder LM Studio. Migration beinhaltet: Ollama installieren, llama3.1:70b herunterladen, und alle API-Integrationen von claude.ai zu localhost:11434 aktualisieren. Keine Daten sind in Claude Pro gesperrt.
Muss ich als deutsches Unternehmen die DSGVO bei lokalen LLMs beachten?
Lokale LLMs übermitteln keine Inferenzdaten an externe KI-Anbieter. Das beseitigt das Art.-44-DSGVO-Transferrisiko für die KI-Schicht. DSGVO-Konformität setzt zusätzlich eine Rechtsgrundlage (Art. 6), ggf. eine Datenschutz-Folgenabschätzung (Art. 35) und dokumentierte technisch-organisatorische Maßnahmen (Art. 32) voraus.
Sind lokale LLMs für deutsche Finanzunternehmen geeignet?
Ja. Deutsche Banken und Finanzdienstleister können lokale Llama 3.3 70B auf On-Premises-Hardware einsetzen, um die Abhängigkeit von US-Cloud-Providern zu vermeiden und PCI-DSS- sowie BDSG-Anforderungen zu unterstützen. Lokale LLMs übermitteln keine Inferenzdaten an externe KI-Anbieter und beseitigen damit das Art.-44-DSGVO-Transferrisiko für die KI-Schicht. Vollständige regulatorische Konformität erfordert zusätzlich eine Rechtsgrundlage (Art. 6 DSGVO), ggf. eine Datenschutz-Folgenabschätzung (Art. 35) und dokumentierte technisch-organisatorische Maßnahmen (Art. 32).
Häufige Fehler beim Vergleichen von Claude Pro und lokalen LLMs
- Denken Claude Pro ist billiger, weil die monatlichen Kosten sichtbar sind. Über 5+ Jahre gleichen dual RTX 4070s aus und werden billiger; eine gebrauchte RTX 4090 bei aktuellen Preisen nicht mehr.
- Annehmen eine gebrauchte RTX 4090 sei weiterhin die günstige Option für Llama 3.3 70B. NVIDIA hat sie 2026 eingestellt, gebrauchte Preise sind auf 2.100–2.800€ gestiegen. Dual RTX 4070s (500–600€ gesamt) sind der wirtschaftlichere Weg.
- Erwarten Llama 3.3 matched Claudes Bildverständnis. Native Multimodal ist nicht verfügbar; nutzen Sie CLIP Adapter.
- Vergessen Claude Pro hat einen 200K Kontext-Vorteil. Für Single-Query-Dokumentenverarbeitung gewinnt Claude. Für durchschnittliche Q&A ist Llama 3.3 fein.
- Nicht Infrastruktur-Overhead berechnen. Lokales Llama 3.3 70B Ausführen erfordert Expertise (CUDA, PyTorch, Docker). Claude Pro ist schlüsselfertig.
Weiterführende Ressourcen
Quellen
- Anthropic Claude Pro Preisgestaltung & Datenschutzrichtlinie — Anthropic, April 2026
- Meta Llama 3.3 70B Modell-Karte — Meta, April 2024
- Open LLM Leaderboard — MMLU & HumanEval Benchmarks — Hugging Face, April 2026