•Info: 📌 Suchen Sie den älteren Vergleich? Springen Sie zu Mistral 24B vs Qwen3 14B vs Llama 3.1 8B Legacy Benchmarks unten.
Modellfamilien-Übersicht: Qwen, Llama und Mistral
Familie | Entwickler | Verfügbare Größen | Lizenz |
|---|---|---|---|
| Qwen3 | Alibaba | 0.6B, 1.7B, 4B, 8B, 14B, 30B-A3B, 32B, 235B-A22B | Apache 2.0 (meist) |
| Llama 3.x | Meta | 1B, 3B, 8B, 70B | Llama Community (benutzerdefiniert) |
| Mistral | Mistral AI | 7B, Small 3.1 (24B), Large (123B) | Apache 2.0 (7B, Small) |
Benchmark-Vergleich: Qwen3 vs Llama 3.x vs Mistral
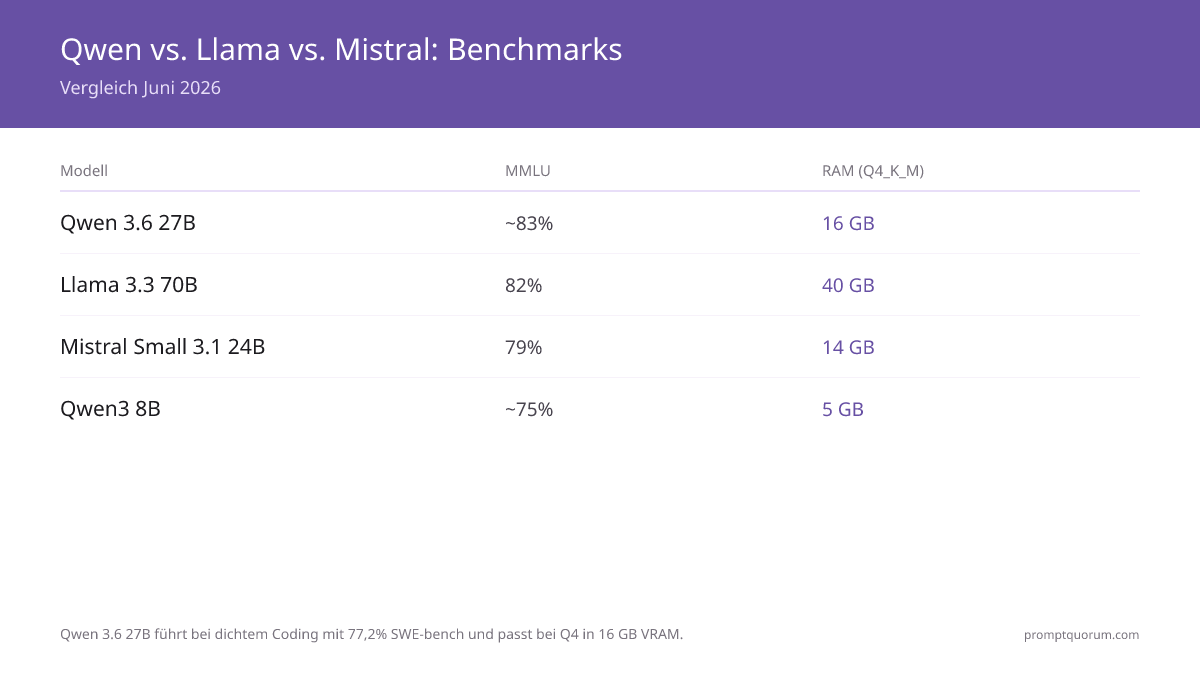
Striche kennzeichnen Benchmarks, die nicht veröffentlicht wurden oder nicht anwendbar sind. Es handelt sich um von den Herstellern berichtete Richtwerte, nicht um Messungen von PromptQuorum; prüfen Sie die jeweilige Modellkarte. SWE-bench Pro und Verified sind unterschiedliche Varianten und sollten nicht direkt verglichen werden.
Modell | MMLU | HumanEval | MATH | RAM (Q4_K_M) |
|---|---|---|---|---|
| Llama 3.3 70B | — | — | — | 40 GB |
| Mistral Small 3.1 24B | — | — | — | 14 GB |
| Qwen3 32B | — | — | — | 20 GB |
| Qwen3 14B | — | — | — | 9 GB |
| Llama 3.2 3B | — | — | — | 5,5 GB |
| Mistral Small v0.3 | — | — | — | 4,5 GB |
| Qwen3 8B | — | — | — | 4,7 GB |

Qwen3: Bestes für Coding, Mathematik und nicht-englische Sprachen
Qwen3 von Alibaba gehört bei Coding-Benchmarks zu den stärksten Modellfamilien. Alibaba meldet für Qwen3.8-27B 61,7 SWE-bench Pro — das stärkste dichte Coding-Ergebnis unter den hier verglichenen Modellen (Herstellerangabe, nicht von PromptQuorum gemessen).
Stärken: Coding (Python, JavaScript, SQL), mathematisches Reasoning, 29-Sprachen-Unterstützung, JSON-Modus, Function Calling, 128K Kontextfenster auf allen Größen.
Schwächen: Der englische Instruktions-Stil kann weniger natürlich wirken als Llama oder Mistral; einige Nutzer berichten von weniger flüssigem kreativem Schreiben auf Englisch. Der Alibaba-Ursprung stellt Datenschutzbedenken für einige Unternehmensnutzer dar, trotz offener Gewichte.

Llama 3.x: Bestes für allgemeine englische Aufgaben und Ökosystem-Unterstützung
Metas Llama 3.x Familie ist die am weitesten unterstützte Open-Weight-Modellserie. Mehr Tools, Fine-Tunes, Quantisierungen und Community-Leitfäden existieren für Llama als für jede andere Familie. Llama 3.3 70B ist mit allen Konkurrenten bei allgemeinen englischen Benchmarks gleichauf oder besser.
Stärken: Breiteste Ökosystem-Unterstützung (jedes Tool unterstützt Llama), bestes englisches kreatives Schreiben, starke Instruktions-Befolgung, 128K Kontextfenster auf 3.1/3.2/3.3-Varianten, Community-getestete Zuverlässigkeit.
Schwächen: Keine native mehrsprachige Unterstützung jenseits grundlegender Funktionalität; Llama 3.2 3B kann mit Qwen3 4B und Phi-4 Mini beim Coding und bei Mathematik nicht mithalten, obwohl dieselbe Parameteranzahl.
Mistral: Beste Effizienz und stärkste 7B-Klasse-Geschichte
Mistral AI produziert die parameter-effizientesten Modelle in diesem Vergleich. Mistral Small 3.1 bei 24B liefert Benchmark-Ergebnisse nah bei der 70B-Klasse, während nur 14 GB RAM benötigt werden -- das beste Qualitäts-pro-RAM-Verhältnis aller Modelle in diesem Vergleich.
Stärken: bestes Qualitäts-zu-RAM-Verhältnis (Small 3.1), starke Function Calling und Tool-Nutzung, Apache-2.0-Lizenz bei mehreren Modellen (Lizenz je Modell vor dem kommerziellen Einsatz prüfen), europäische Herkunft (Frankreich).
Schwächen: Mistral Small v0.3 wird nun beim Benchmark von Qwen3 8B und Llama 3.1 8B übertroffen; weniger Größenoptionen als Qwen oder Llama.

Tool Calling und Reasoning im Vergleich
Tool Calling (Funktionsaufrufe) ermöglicht es einem Modell, externe APIs und Tools in agentic Workflows zu aufzurufen. Ab April 2026 unterstützen alle drei Familien dies nativ.
Modell | Tool Calling | Reasoning (MATH) | Best For |
|---|---|---|---|
| Llama 3.3 70B | ✅ Nativ | 77% | Englisch-fokussierte Agent-Workflows |
| Mistral Small 3.1 24B | ✅ Nativ, gut getestet | 65% | Produktions-Tool-Nutzung bei 16 GB |
| Qwen3 14B | ✅ Nativ | 70% | Kosteneffektives Tool Calling |
| Llama 3.2 3B | ✅ Nativ | 51% | Leichte Agents |
| Mistral Small v0.3 | ⚠️ Begrenzt | 28% | Nicht empfohlen für Tool-Nutzung |
Für Reasoning-intensive Tasks (Mathe, Logik, Code-Review): DeepSeek-R1 (MIT-Lizenz, 7B-32B) übertrifft alle drei Familien bei MATH-Benchmarks. (DeepSeek hat inzwischen DeepSeek-V4 — Flash/Pro — als neuere offene Generation veröffentlicht; R1/V3 bleiben weiterhin lokal nutzbar.)
Welche Modellfamilie gewinnt nach Task?
Die Modellauswahl ist Schritt eins; das Prompt-Design ist Schritt zwei. Derselbe Prompt kann bei Qwen, Llama und Mistral sehr unterschiedliche Ergebnisse liefern. Für systematische Techniken, die bei jeder Modellfamilie zu konsistenten Ergebnissen führen, siehe den Prompt-Engineering-Guide.
Task | Gewinner | Warum |
|---|---|---|
| Python / JavaScript Coding | Qwen3 | Qwen3.8-27B: 61,7 SWE-bench Pro (Qwen-Angabe), stärkstes dichtes Coding-Ergebnis hier |
| Allgemeine Q&A (Englisch) | Llama 3.x | Starkes englisches Instruction-Following; Llama 3.3 70B gibt ~82% MMLU an (Richtwert; Modellkarte prüfen) |
| Mathematisches Reasoning | Qwen3 | Laut Qwen-Berichten allgemein stark bei Mathematik; prüfen Sie die Modellkarten für Ihren Anwendungsfall |
| Nicht-englische Sprachen | Qwen3 | 29 native Sprachen; Llama und Mistral sind englisch-primär |
| Kreatives Schreiben (Englisch) | Llama 3.x | Natürlicherer englischer Generierungsstil |
| Qualität auf 16 GB RAM | Mistral Small 3.1 | Nahezu 70B-Qualität bei 14 GB RAM |
| Anfänger erstes Modell | Llama 3.2 3B | Am besten dokumentiert, meiste Community-Unterstützung |

Größen-für-Größen-Vergleich: Welche Familie ist besser bei jeder Skalierung?
3B-4B Klasse: Qwen3 4B und Phi-4 Mini 3.8B übertrumpfen Llama 3.2 3B beim Coding und Mathematik. Für allgemeine englische Nutzung ist Llama 3.2 3B zuverlässiger.
7B-8B Klasse: Qwen3 8B und Llama 3.1 8B übertrumpfen beide Mistral Small v0.3 deutlich. Qwen3 8B führt beim Coding; Llama 3.1 8B führt bei englischer Instruktions-Befolgung.
14B-24B Klasse: Qwen3 14B und Mistral Small 3.1 24B sind die Hauptoptionen. Mistral Small 3.1 ist insgesamt stärker, erfordert aber mehr RAM. Qwen3 14B ist besser für Coding und mehrsprachig bei niedrigerem RAM.
70B Klasse: Llama 3.3 70B ist das bekannteste lokal lauffähige dichte Modell dieser Größe und eine gute Wahl für englisch-fokussierte allgemeine Aufgaben. Für Coding und Mehrsprachigkeit vergleichen Sie zuerst Qwen3 32B oder Qwen3.8-27B, die deutlich weniger RAM benötigen.
Qwen, Llama und Mistral decken die Open-Source-Landschaft ab. Für einen Vergleich der kommerziellen Alternativen — GPT-5.6, Claude Opus 5 und Gemini 3.5 — und wann proprietäre Modelle die bessere Wahl sind, siehe das richtige KI-Modell auswählen.

Erste Schritte mit jeder Familie
Installieren Sie Ollama (einzelner Befehl auf macOS, Windows oder Linux) und pullen Sie jedes Modell in einem Schritt.
# Qwen3 Familie
ollama run qwen3:8b
ollama run qwen3:14b
ollama run qwen3:32b

# Llama 3.x Familie
ollama run llama3.2:3b
ollama run llama3.2
ollama run llama3.3:70b

# Mistral Familie
ollama run mistral          # 7B
ollama run mistral-small3.1 # 24B
Quellen
- Qwen3 Technical Report (Qwen Team, 2025) -- arXiv:2505.09388 -- Benchmark-Daten zur Qwen3-Familie für Coding, Mathematik und mehrsprachige Aufgaben.
- Llama 3 Model Card (Meta AI, 2024) -- ai.meta.com/blog/meta-llama-3 -- Llama 3.3 70B Spezifikationen, Evaluierungsergebnisse und Lizenzbedingungen.
- Mistral 7B (Jiang et al., Mistral AI, 2023) -- arXiv:2310.06825 -- Ursprüngliche Mistral-Architektur, Sliding-Window-Attention und erste Benchmark-Daten.
- Open LLM Leaderboard (Hugging Face, 2026) -- huggingface.co/spaces/HuggingFaceH4/open_llm_leaderboard -- Echtzeit MMLU, HumanEval und MATH Benchmark-Rankings für alle offenen Modelle.
Häufige Fehler bei der Wahl von Modellfamilien
- Modelle bei unterschiedlichen Parameteranzahlen vergleichen -- Qwen 32B vs Llama 70B ist kein Apfel-zu-Apfel-Vergleich.
- Mehrsprachige Benchmarks ignorieren, wenn Ihr Workload mehrsprachig ist.
- Annehmen, dass die neueste Modellversion immer am besten ist -- manchmal haben ältere Quantisierungen bessere Community-Unterstützung.
- Lizenzbedingungen übersehen -- Llama-Modelle verwenden eine benutzerdefinierte Llama Community License, die die Nutzung ab 700 Millionen monatlich aktiver Benutzer einschränkt; verifizieren Sie vor Skalierungsbereitstellung.
- Nur auf einem Benchmark testen -- MMLU misst Wissen, HumanEval misst Coding, MATH misst Reasoning. Ein Modell, das bei einem Benchmark führt, kann bei einem anderen hinterherhinken.
Regionaler Kontext: EU/DSGVO, Japan und China
EU/DSGVO: Alle drei Modellfamilien (Qwen3, Llama 3.x/4, Mistral) lassen sich vollständig auf eigener Hardware betreiben, sodass Inferenzdaten nicht an externe Anbieter fließen. Das entschärft die Frage der Datenübermittlung, macht einen Betrieb aber nicht von selbst DSGVO-konform: Rechtsgrundlage, technische und organisatorische Maßnahmen und gegebenenfalls eine Datenschutz-Folgenabschätzung bleiben erforderlich. Mistral AI hat seinen Sitz in Frankreich; Devstral Small 2 wird unter Apache 2.0 geführt, bei Codestral 22B prüfen Sie vor dem kommerziellen Einsatz die Lizenzbedingungen. Qwen3 (Apache 2.0) lässt sich ebenfalls in der EU einsetzen. Für die multimodalen Llama-4-Modelle gelten nach der Llama-Lizenz territoriale Einschränkungen; prüfen Sie die Lizenz vor einem Einsatz in der EU. Prüfen Sie außerdem die für Ihren Einsatz geltenden Pflichten aus der EU-KI-Verordnung. Dies ist eine allgemeine Information und keine Rechtsberatung.
Japan (METI): Die KI-Governance-Leitlinien des METI für Unternehmen empfehlen, Modellherkunft und Leistung bei Unternehmenseinsätzen zu dokumentieren; Qwen3, Llama 3.x/4 und Mistral veröffentlichen alle Model Cards oder technische Berichte, die Sie dafür heranziehen können. Der Betrieb auf privater Infrastruktur hält Daten im eigenen Netzwerk, ob dennoch Melde- oder sonstige Pflichten gelten, hängt jedoch vom Einsatzzweck ab — klären Sie das mit Ihrer Rechtsberatung. Qwen3 bietet unter seinen 29 Sprachen eine native japanische Tokenisierung und ist damit ein naheliegender Kandidat für japanischsprachige Aufgaben.
China (CAC): Die 2023 erlassenen Interim Measures für generative KI-Dienste, die von der Cyberspace Administration of China (CAC) umgesetzt werden, betreffen vor allem Dienste, die der Öffentlichkeit in China angeboten werden; ob ein konkreter Einsatz darunter fällt, hängt von der Art des Angebots ab — klären Sie das mit lokaler Rechtsberatung. Qwen3 (Alibaba) ist mit seinen 29 nativen Sprachen auch auf die Nutzung mit Chinesisch ausgelegt. Verarbeiten Sie Daten in China, prüfen Sie vor der Nutzung von Cloud-APIs die Anforderungen an Datenspeicherung im Inland und grenzüberschreitende Übermittlung.
Häufig gestellte Fragen
Welches ist besser für Coding: Qwen, Llama oder Mistral?
Qwen3-Modelle gelten als stark beim Coding; Qwen3.8-27B meldet 61,7 SWE-bench Pro (Qwen-Angabe). Für den Vergleich mit Llama und Mistral prüfen Sie bitte die Modellkarten der Größe, die Sie betreiben (Qwen3 8B, 14B, 32B). In der 7B-8B-Klasse gelten Qwen3 8B und Llama 3.1 8B beide als deutlich stärker als Mistral Small v0.3.
Welches Local LLM unterstützt die meisten Sprachen?
Qwen3 unterstützt nativ 29 Sprachen, darunter Arabisch, Japanisch, Koreanisch, Chinesisch und alle wichtigen europäischen Sprachen. Llama 4 unterstützt offiziell 8 Sprachen. Mistral-Modelle konzentrieren sich primär auf Englisch und große europäische Sprachen.
Welches Modell sollte ich mit 8 GB RAM wählen?
Mit 8 GB RAM verwenden Sie Llama 3.2 3B (Q4, ~2 GB) für allgemeine Aufgaben oder Qwen3 8B (Q4, ~4,7 GB) für Coding. Beide laufen mit 15-25 Token/Sec auf einer CPU mit 8 GB RAM. Installieren Sie mit: ollama pull llama3.2:3b oder ollama pull qwen2.5:7b.
Ist Qwen3 besser als Llama 3.3?
Das hängt vom Anwendungsfall ab. Es gibt kein dichtes Qwen3-Modell der 70B-Klasse; die größten dichten Modelle sind Qwen3 32B und Qwen3.8-27B. Qwen gilt als stark bei Mehrsprachigkeit und Coding, Llama 3.3 70B als stark beim englischen Instruction-Following. Vergleichen Sie die Modellkarten für Ihren Anwendungsfall.
Welches Local LLM ist am effizientesten mit begrenztem VRAM?
Mistral Small 3.1 24B gilt als sehr effizient: Es benötigt nur 14 GB RAM und wird häufig als nahezu 70B-Klasse-Qualität beschrieben (Modellkarte prüfen).
Kann Qwen3 Cloud-Modelle für Coding-Aufgaben ersetzen?
Für viele Standard-Coding-Aufgaben (Python, JavaScript, SQL-Generierung) können Modelle wie Qwen3 32B oder Qwen3.8-27B ausreichen. Für komplexes Multi-File-Refactoring oder architektonisches Reasoning behalten Frontier-Cloud-Modelle (GPT-5.6, Claude Opus 5) in der Regel noch einen Vorteil; testen Sie mit Ihren eigenen Aufgaben.
Ist Mistral Small 2026 noch wert zu verwenden?
Für Systeme mit nur 4-5 GB VRAM bleibt Mistral Small eine brauchbare Option. Jedoch übertrumpfen Qwen3 8B und Llama 3.1 8B beide Mistral Small v0.3 bei allen großen Benchmarks, während ähnlicher VRAM benötigt wird. Mistral Smalls Hauptvorteil heute ist seine lange etablierte Community-Unterstützung und Tool-Integration.
Was ist die Llama Community License-Einschränkung?
Metas Llama Community License ist kostenlos für kommerzielle Nutzung unterhalb von 700 Millionen monatlich aktiver Benutzer. Über dieser Schwelle ist eine separates kommerzielles Abkommen mit Meta erforderlich. Für die meisten Anwendungsfälle ist diese Grenze kein Problem.
Kann ich diese Modelle vollständig offline ausführen?
Ja, für die Inferenz. Nach dem einmaligen Modell-Download lassen sich alle drei Familien (Qwen, Llama, Mistral) über Ollama oder LM Studio ohne Internetverbindung und ohne API-Schlüssel ausführen. Prüfen Sie die Telemetrie- und Update-Einstellungen des jeweiligen Tools, wenn Sie strikte Vorgaben haben.
Welche Modellfamilie ist am einfachsten zu beginnen?
Llama 3.2 3B hat die größte Community und die meisten Anfänger-Tutorials. Führen Sie es aus mit ollama run llama3.2:3b (erfordert 8 GB RAM, keine GPU erforderlich). Jedes große Local LLM Tool (Ollama, LM Studio, OpenWebUI) unterstützt Llama-Modelle standardmäßig.
Wie vergleicht sich Mistral Small 24B mit Qwen3 14B und Llama 3.1 8B?
Mistral Small 3.1 24B benötigt 14 GB RAM, Qwen3 14B etwa 9 GB und Llama 3.1 8B etwa 5,5 GB. Mistral Small 3.1 gilt als stärkstes Allround-Modell der drei, braucht aber am meisten RAM; Qwen3 14B ist die Wahl für Coding mit weniger Speicher. Wählen Sie Mistral Small 3.1, wenn 16 GB RAM Ihr Limit sind. Aktuelle Benchmarks finden Sie auf den Modellkarten.
Welches Modell hat die beste Tool-Calling-Unterstützung?
Alle drei Familien unterstützen Tool Calling (Function Calling) ab April 2026 nativ. Mistral Small 3.1 24B hat das beste Ansehen für Tool-Use-Zuverlässigkeit in der Produktion. Qwen3 und Llama 3.3 70B unterstützen Tool Calling nativ. Für Function Calling in agentic Workflows sind Mistral Small 3.1 und Qwen3 14B am meisten getestet.
Was ist das beste GGUF Chat-Modell 2026?
Bei 7B: Llama 3.2 3B-instruct-Q4_K_M oder Qwen3-8B-instruct-Q4_K_M. Bei 14B: Qwen3-14B-instruct-Q4_K_M (9 GB). Bei 24B: Mistral-Small-3.1-24B-instruct-Q4_K_M (14 GB). Beste Qualität Single-GPU: Qwen3-32B-instruct-Q4_K_M (20 GB). Aktuelle Benchmarks finden Sie auf den Modellkarten.
Ist Qwen besser als Llama für Reasoning?
Qwen-Modelle gelten als stark beim mathematischen und logischen Reasoning, Llama 3.x beim englischen Instruction-Following; die veröffentlichten Werte unterscheiden sich je nach Modellgröße und Benchmark-Version, vergleichen Sie die Modellkarten (z. B. Qwen3 32B oder Qwen3.8-27B gegenüber Llama 3.3 70B). Für Chain-of-Thought-Reasoning-Tasks übertrifft DeepSeek-R1 (MIT, 7B-32B) beide Familien.
Was hat sich seit September bei Qwen, Llama und Mistral geändert?
Qwen3.8 gibt es bei Ollama derzeit nur als 27B-Modell (18 GB bei Q4_K_M, 256K Kontext), daher bleiben Qwen3 8B und 14B die kleineren Qwen-Optionen. Devstral Small 2 (Mistral AI, 24B, 15 GB, 65,8 % SWE-bench Verified laut Mistral, Apache 2.0) ist der aktuelle Devstral-Tag, und Mistral Large 4 (1,05T Parameter gesamt / 52B aktiv, laut Ollama-Eintrag) kam als Rechenzentrums-Modell, das nicht auf Consumer-Hardware passt. Llama 4 Scout (etwa 55 GB bei Q4) bleibt in diesem Vergleich die Langkontext-Option. Die Rangfolge für Consumer-Hardware oben bleibt unverändert.
Änderungsprotokoll
- 2026-05-17: Abschnitt "Legacy Benchmark Reference" hinzugefügt, der Mistral Small 24B, Qwen3 14B und Llama 3.1 8B vergleicht. Titel aktualisiert, um Legacy- und aktuelle Modellsuchen zu überbrücken.