Was ist ein „kleines" lokales LLM, und wann sollten Sie eines einsetzen?
Ein kleines lokales LLM ist in der Regel ein Modell mit etwa 4 Milliarden Parametern oder weniger. Bei 4-Bit-Quantisierung umfassen diese Modelle etwa 1-4 GB Download (Gemma 4 mit seinem Konzept der effektiven Parameter ist die Ausnahme, siehe unten) -- gut machbar für Einsteiger-Laptops mit 4-8 GB Gesamtspeicher.
Kleine Modelle eignen sich für Zusammenfassungen, einfache Fragen und Antworten, die Erklärung von Code-Schnipseln, kurze Übersetzungen, Umformulierungen und Klassifikation. Für lange, mehrstufige Argumentationsketten, umfangreiche Code-Generierung oder zusammenhängende Langtexte sind sie nicht geeignet.
Der Qualitätsabstand zwischen einem 4B- und einem 7-9B-Modell ist weiterhin real. Wenn Ihr Rechner 8 GB oder mehr und etwas Spielraum hat, ist ein 7-9B-Modell wie Qwen3.5 9B (6,6-7,6 GB bei Ollama) meist die bessere Wahl. Empfehlungen für 7B-Modelle finden Sie unter Beste lokale LLM-Modelle für Einsteiger.
Welches kleine Modell sollten Sie verwenden? Schnelle Entscheidungshilfe
- 8 GB RAM oder mehr, beste Qualität gewünscht: Qwen3.5 4B (`ollama run qwen3.5:4b`).
- Bilder und Text in einem Modell, und Sie haben 12 GB oder mehr: Gemma 4 E4B (`ollama pull gemma4:e4b`).
- 4-6 GB RAM, Hilfe bei englischem Reasoning oder Programmierung: Phi-4 Mini 3.8B (`ollama run phi4-mini`).
- 4 GB RAM oder nicht-englische Texte: Qwen3.5 2B (`ollama run qwen3.5:2b`).
- Unter 3 GB freier RAM oder ein Gerät der Raspberry-Pi-Klasse: Qwen3.5 0.8B (`ollama run qwen3.5:0.8b`), mit Kenntnis seiner Grenzen.
Qwen3.5 4B -- Bestes kleines LLM insgesamt (bestes 4B-Modell)
Qwen3.5 4B ist in diesem Vergleich das stärkste Modell der 4B-Klasse, mit MMLU-Pro 79,1, GPQA Diamond 76,2 und LiveCodeBench v6 55,8 laut Qwens eigener Modellkarte. Es erschien Anfang 2026 als Teil der Serie Qwen3.5 Small unter Apache 2.0, verarbeitet Text und Bilder, unterstützt Tool Calling und hat ein natives Kontextfenster von 262.144 Token.
Zwei Dinge sollten Sie wissen. Erstens denken Qwen3.5-Modelle standardmäßig, was das Reasoning verbessert, auf der CPU aber langsam ist -- schalten Sie Thinking bei einfachen Aufgaben aus. Zweitens gibt die Modellkarte nicht an, in welchem Modus die Spitzenwerte gemessen wurden, und Qwens Testaufbau unterscheidet sich von denen von Google und Microsoft; vergleichen Sie die Zahlen daher als Richtwerte und nicht Punkt für Punkt.
Eigenschaft | Wert |
|---|---|
| MMLU-Pro | 79,1 (vom Hersteller angegeben) |
| GPQA Diamond | 76,2 (vom Hersteller angegeben) |
| LiveCodeBench v6 | 55,8 (vom Hersteller angegeben) |
| Download (Ollama) | 3,3-4,0 GB |
| Kontext | 256K Token |
| Lizenz | Apache 2.0 |
| Ollama-Befehl | ollama run qwen3.5:4b |
Gemma 4 E4B -- Bestes multimodales Modell der 4B-Klasse
Google Gemma 4 E4B erreicht laut Googles Modellkarte 69,4 % bei MMLU-Pro, 52,0 % bei LiveCodeBench v6 und 58,6 % bei GPQA Diamond. „E4B" steht für 4,5B effektive Parameter; einschließlich der schichtweisen Embeddings hat das Modell rund 8B Parameter, weshalb der Ollama-Download trotz der Bezeichnung „4B" 6,6-9,5 GB umfasst. Es verarbeitet Text und Bilder, hat ein Kontextfenster von 128K und steht unter Apache 2.0.
Wählen Sie E4B statt Qwen3.5 4B, wenn Sie Googles Ökosystem, starke mehrsprachige Ergebnisse (MMMLU 76,6 %) oder einen agentischen Tau2-Wert von 42,2 % wünschen. Wählen Sie Qwen3.5 4B, wenn Sie dieselbe Qualitätsklasse mit etwa der Hälfte an Speicherplatz und RAM möchten.
Eigenschaft | Wert |
|---|---|
| MMLU Pro | 69,4 % |
| LiveCodeBench v6 | 52,0 % |
| GPQA Diamond | 58,6 % |
| Download (Ollama) | 6,6-9,5 GB |
| Kontext | 128K Token |
| Lizenz | Apache 2.0 |
| Ollama-Befehl | ollama pull gemma4:e4b |
Phi-4 Mini 3.8B -- Leichtestes Modell der 4B-Klasse (2,5 GB)
Microsoft Phi-4 Mini erreicht laut Modellkarte 67,3 % bei MMLU und 52,8 % bei MMLU-Pro, bei einem Download von 2,5 GB -- der kleinste Speicherbedarf aller 4B-Modelle hier. Es steht unter der MIT-Lizenz, hat ein Kontextfenster von 128K und wurde mit kuratierten synthetischen Daten trainiert, die auf Reasoning ausgerichtet sind.
Bei den Reasoning-Benchmarks liegt es hinter Qwen3.5 4B und Gemma 4 E4B (GPQA 25,2 gegenüber 76,2 und 58,6). Wählen Sie es daher, wenn der Speicher die Grenze setzt -- Rechner mit 4-6 GB -- oder wenn Sie die freizügige MIT-Lizenz wünschen.
Eigenschaft | Wert |
|---|---|
| MMLU (5-shot) | 67,3 % |
| MMLU-Pro | 52,8 % |
| GPQA Diamond | 25,2 % |
| Download (Ollama) | 2,5 GB |
| Kontext | 128K Token |
| Lizenz | MIT |
| Ollama-Befehl | ollama run phi4-mini |
Qwen3.5 2B -- Am besten für Rechner mit 4 GB
Qwen3.5 2B ist die beste Wahl, wenn ein 4B-Modell nicht mehr passt. Laut Qwens Modellkarte erreicht es MMLU-Pro 55,3 im Modus ohne Thinking und 66,5 im Thinking-Modus sowie GPQA 51,6 im Thinking-Modus. Der Download umfasst bei Ollama 2,7-3,1 GB; das Modell verarbeitet Bilder, hat ein Kontextfenster von 256K und steht unter Apache 2.0.
Im Vergleich zum 0.8B-Modell ist es beim Befolgen von Anweisungen deutlich verlässlicher (IFEval 61,2 gegenüber 52,1 ohne Thinking) und das kleinste Modell hier, das wir für echte Zusammenfassungen und Frage-Antwort-Aufgaben einsetzen würden.
Eigenschaft | Wert |
|---|---|
| MMLU-Pro | 55,3 % ohne Thinking / 66,5 % mit Thinking |
| GPQA | 51,6 % (mit Thinking) |
| Download (Ollama) | 2,7-3,1 GB |
| Kontext | 256K Token |
| Lizenz | Apache 2.0 |
| Ollama-Befehl | ollama run qwen3.5:2b |
Gemma 4 E2B -- Option für Edge-Geräte und Multimodalität
Google Gemma 4 E2B erreicht laut Googles Modellkarte 60,0 % bei MMLU Pro, 44,0 % bei LiveCodeBench v6 und 43,4 % bei GPQA Diamond. Die effektive Parameterzahl beträgt 2,3B (5,1B einschließlich der schichtweisen Embeddings). Die Angabe der effektiven Parameter bedeutet nicht, dass die Datei 2 GB groß ist: Ollama gibt den Download mit 4,6-7,5 GB an, es braucht für Ergebnisse einer ähnlichen Klasse also mehr Speicher als Qwen3.5 2B.
Es hat ein Kontextfenster von 128K, verarbeitet Bilder und steht unter Apache 2.0. Der CPU-Durchsatz variiert je nach Hardware und Quantisierung (Google nennt ~7,6 Token/Sek. beim Decodieren auf einem Raspberry Pi 5; unabhängige x86-Berichte nennen 8-48 Token/Sek.). Wählen Sie es für Edge-Geräte, auf denen Sie Googles Tooling nutzen möchten; andernfalls ist Qwen3.5 2B schlanker.
Eigenschaft | Wert |
|---|---|
| MMLU Pro | 60,0 % |
| LiveCodeBench v6 | 44,0 % |
| GPQA Diamond | 43,4 % |
| Download (Ollama) | 4,6-7,5 GB |
| Kontext | 128K Token |
| Lizenz | Apache 2.0 |
| Ollama-Befehl | ollama pull gemma4:e2b |
Qwen3.5 0.8B -- Kleinstes Modell, das sich zu betreiben lohnt
Qwen3.5 0.8B ist das kleinste Modell in diesem Vergleich: ein Download von 1,2-1,3 GB bei Ollama mit einem Kontextfenster von 256K und Apache-2.0-Lizenz. Sein vom Hersteller angegebenes MMLU-Pro beträgt 29,7 (ohne Thinking) und 42,3 (mit Thinking), GPQA 11,9 -- genug für Klassifikation, Schlagwort-Extraktion und kurze Umformulierungen, aber nicht für mehrstufiges Schlussfolgern oder lange Antworten. Setzen Sie es nur ein, wenn der RAM tatsächlich die entscheidende Grenze ist (weniger als 3 GB verfügbar), auf Einplatinencomputern oder als schneller Vorfilter in einer Pipeline.
Eigenschaft | Wert |
|---|---|
| MMLU-Pro | 29,7 % ohne Thinking / 42,3 % mit Thinking |
| GPQA | 11,9 % (mit Thinking) |
| Download (Ollama) | 1,2-1,3 GB |
| Kontext | 256K Token |
| Ollama-Befehl | ollama run qwen3.5:0.8b |
Vollständiger Vergleich: Beste kleine lokale LLMs (Klasse 0.8B-4B)
Modell | MMLU-Pro | GPQA Diamond | Download (Ollama) | Kontext | Am besten für |
|---|---|---|---|---|---|
| Qwen3.5 4B | 79,1 | 76,2 | 3,3-4,0 GB | 256K | Bestes 4B-Modell insgesamt |
| Gemma 4 E4B | 69,4 | 58,6 | 6,6-9,5 GB | 128K | Multimodal, Google-Ökosystem |
| Phi-4 Mini 3.8B | 52,8 | 25,2 | 2,5 GB | 128K | Leichtestes Modell der 4B-Klasse, MIT |
| Qwen3.5 2B | 55,3 / 66,5 | 51,6 | 2,7-3,1 GB | 256K | Rechner mit 4 GB |
| Gemma 4 E2B | 60,0 | 43,4 | 4,6-7,5 GB | 128K | Edge-Geräte |
| Qwen3.5 0.8B | 29,7 / 42,3 | 11,9 | 1,2-1,3 GB | 256K | Kleinstes brauchbares Modell |
Die Werte sind Herstellerangaben von der jeweiligen Modellkarte oder Ollama-Seite und beruhen auf unterschiedlichen Testaufbauten; „a / b" bedeutet Modus ohne Thinking / mit Thinking. Verstehen Sie sie als Richtwerte. Die Download-Größen sind die von Ollama angegebenen Spannen und enthalten den Vision-Encoder, sofern das Modell einen besitzt.
Kleine lokale LLMs nach Region
DACH / EU (DSGVO): Für Fachkräfte und Mittelständler in Deutschland, Österreich und der Schweiz, die KI auf begrenzter Hardware betreiben -- Außendienst, abgeschottete Umgebungen (Air-Gap), ältere Firmenlaptops -- können kleine lokale Modelle die Inferenz vollständig auf dem Gerät ausführen, ohne Cloud-API-Aufrufe, sofern Laufzeitumgebung und Apps Telemetrie und Synchronisierung deaktiviert haben. Wer Qwen3.5 4B oder Phi-4 Mini auf einem handelsüblichen Firmenlaptop betreibt, behält den gesamten verarbeiteten Text auf dem Gerät, was die Ziele der Datenminimierung nach Art. 5 DSGVO unterstützt; ob ein konkreter Einsatz tatsächlich DSGVO-konform ist, hängt weiterhin von Ihrem gesamten Aufbau ab. Wer das BSI-Grundschutz-Vorgehen anwendet, kann ein lokal betriebenes Modell als eigenen Baustein im Informationsverbund dokumentieren; die Prüfung bleibt Ihre Aufgabe. Die Lizenzen sind freizügig: Phi-4 Mini steht unter MIT, Gemma 4 und Qwen3.5 unter Apache 2.0. Optionen europäischer Herkunft sind in dieser Größe begrenzt; prüfen Sie das aktuelle Angebot von Mistral, falls die EU-Herkunft eine Anforderung ist.
Japan (METI): Bei japanischsprachigen Aufgaben in der kleinen Klasse erreichen Qwen3.5 und Gemma 4 E4B laut ihren Modellkarten beide MMMLU-Werte um 76. Probieren Sie auf einem begrenzten Rechner `ollama run qwen3.5:2b` oder `ollama run qwen3.5:4b` für japanische Zusammenfassungen oder Übersetzungen. Der Geschwindigkeitsvorteil kleiner Modelle zählt im Unternehmenseinsatz auf Standard-Büro-Hardware, wobei die tatsächliche Geschwindigkeit von Ihrer CPU und der Quantisierung abhängt.
China: Qwen3.5 (Alibaba, Apache 2.0) ist die naheliegende Wahl für den Einsatz kleiner Modelle auf Chinesisch. Für IoT- und Edge-Einsätze unter Chinas Datensicherheitsgesetz (数据安全法) läuft `ollama run qwen3.5:2b` auf einem Linux-Gerät mit etwa 4 GB RAM und verarbeitet Text auf dem Gerät, ohne externe API-Aufrufe; klären Sie Ihre eigenen Compliance-Pflichten gesondert.
Welche typischen Fehler passieren beim Betrieb kleiner lokaler LLMs?
- Thinking-Modus bei einfachen Aufgaben angelassen: Qwen3.5-Modelle denken standardmäßig und verbrauchen vor der Antwort viele zusätzliche Token. Schalten Sie es für Chat und Extraktion auf der CPU aus (`--think=false` in Ollama) und heben Sie es sich für Mathematik und Logik auf.
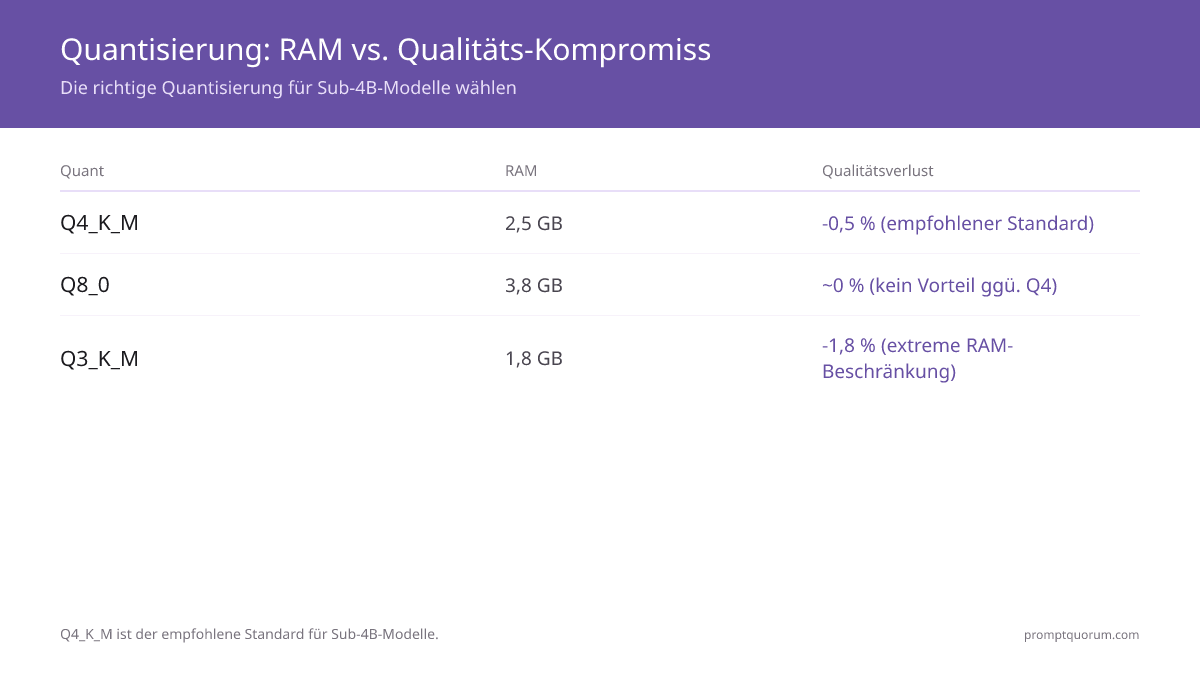
- Q8_0-Quantisierung statt Q4_K_M: Q8_0 benötigt fast doppelt so viel RAM wie Q4_K_M bei minimalem Qualitätsgewinn im kleinen Maßstab. Auf einem Rechner mit 4 GB kann Q8_0 Auslagerung (Swap) auslösen und die Inferenz um ein Mehrfaches verlangsamen. Verwenden Sie Q4_K_M als Standard für kleine Modelle.
- Basismodell statt Instruct-Variante: Basismodelle sind Checkpoints vor dem Fine-Tuning, die das nächste Token vorhersagen und keine Anweisungen befolgen. Fragen Sie eines „Was ist 2+2?", setzt es den Satz womöglich als Quiz fort, statt „4" zu antworten. Verwenden Sie die auf dieser Seite gezeigten Standard-Tags, die instruktionsoptimiert sind.
- Gemma 4 nach seinem Namenszusatz „E2B/E4B" beurteilen: Die Angabe der effektiven Parameter untertreibt die Download-Größe. Gemma 4 E4B umfasst bei Ollama 6,6-9,5 GB; prüfen Sie die angegebene Größe, bevor Sie es auf einen Rechner mit 8 GB laden.
- Qualität von 7B und mehr von einem kleinen Modell erwarten: Kleine Modelle bewältigen kurze, klar umrissene Aufgaben. Lange Argumentationsketten, Langtexte und anspruchsvolle Code-Generierung fallen gegenüber 7-9B-Modellen spürbar ab. Reicht die Ausgabequalität nicht, wechseln Sie zu Qwen3.5 9B (6,6-7,6 GB bei Ollama).
Quantisierung verstehen: RAM gegen Qualität abwägen
Häufige Fragen zu kleinen lokalen LLM-Modellen
Was ist das beste kleine LLM für den lokalen Betrieb?
Für die meisten Nutzer mit 8 GB RAM oder mehr ist das beste kleine lokale LLM 2026 Qwen3.5 4B (Apache 2.0, `ollama run qwen3.5:4b`): Auf der eigenen Modellkarte von Qwen werden MMLU-Pro 79,1 und GPQA Diamond 76,2 angegeben, vor Gemma 4 E4B (69,4 / 58,6) und Phi-4 Mini (52,8 / 25,2). Auf einem Rechner mit 4 GB weichen Sie auf Qwen3.5 2B oder Phi-4 Mini aus. Es handelt sich um Herstellerangaben mit unterschiedlichen Testaufbauten; die Abstände sind daher als Richtwerte zu verstehen, nicht als exakte Werte.
Was ist das beste 4B-Modell?
Qwen3.5 4B ist in diesem Vergleich nach den vom Hersteller angegebenen Reasoning-Benchmarks das stärkste Modell der 4B-Klasse; es bietet zudem ein Kontextfenster von 256K und einen Download von rund 3,3-4,0 GB bei Ollama. Gemma 4 E4B (4,5B effektive Parameter, einschließlich Embeddings etwa 8B) ist der engste Konkurrent und die bessere Wahl, wenn Sie das Google-Ökosystem nutzen möchten, doch der Ollama-Download umfasst 6,6-9,5 GB. Phi-4 Mini 3.8B ist mit 2,5 GB am leichtesten und MIT-lizenziert, liegt bei den Reasoning-Benchmarks aber hinter beiden.
Was ist das kleinste LLM, das sich lokal betreiben lässt?
Unter den Modellen, deren Betrieb sich lohnt, ist Qwen3.5 0.8B in diesem Vergleich das kleinste -- ein Download von 1,2-1,3 GB bei Ollama mit einem Kontextfenster von 256K. Es genügt für Klassifikation, Schlagwort-Extraktion und kurze Umformulierungen, doch sein vom Hersteller angegebener MMLU-Pro-Wert von 29,7 (ohne Thinking) zeigt, dass es bei allem Mehrstufigen scheitert. Noch kleinere Modelle gibt es, aber unterhalb von etwa 1B Parametern verliert der Text schon nach wenigen Sätzen den Zusammenhang; sie eignen sich eher als Autovervollständigung denn als Assistent.
Was ist das kleinste lokale LLM, das nützliche Ergebnisse liefert?
Ab etwa 2B Parametern werden die Ergebnisse für Zusammenfassungen, einfache Fragen und Antworten sowie Umformulierungen verlässlich. Qwen3.5 2B (Download 2,7-3,1 GB) ist das kleinste Modell hier, das wir für echte Arbeit einsetzen würden; Qwen3.5 0.8B ist die Untergrenze bei der Hardware, nicht bei der Qualität. Wenn Sie 4 GB oder mehr erübrigen können, bringt ein 4B-Modell bei der Kohärenz einen großen Sprung für wenig zusätzlichen Speicher.
Läuft ein kleines Modell auf einem Smartphone?
Ja. Qwen beschreibt die Modelle Qwen3.5 0.8B und 2B als für Edge-Geräte gebaut, und Google positioniert Gemma 4 E2B und E4B für Smartphones und Laptops. Ollama und LM Studio laufen weder unter iOS noch unter Android, daher braucht es für Mobilgeräte eine eigene App oder ein eigenes Framework; die tatsächliche Geschwindigkeit hängt stark vom Chip des Telefons und von der Laufzeitumgebung ab. Prüfen Sie vor dem Download die Modellliste der jeweiligen App.
Eignen sich kleine Modelle für Zusammenfassungen?
Ja -- Zusammenfassungen gehören zu ihren stärksten Einsatzgebieten. Alle sechs Modelle hier haben ein Kontextfenster von mindestens 128K Token, die Dokumentlänge ist also selten die Grenze; entscheidend ist, wie gut das Modell Anweisungen über eine lange Eingabe hinweg befolgt. Qwen3.5 4B und Gemma 4 E4B sind am zuverlässigsten; bei 0.8B-Modellen sollten Sie die Eingaben kurz und die Ausgaben einfach halten.
Wie viel schneller ist ein 2B-Modell als ein 7B-Modell auf derselben Hardware?
Auf der CPU spürbar schneller, wobei der Faktor stark von Hardware und Quantisierung abhängt -- Googles eigene Angaben für Gemma 4 E2B nennen ~7,6 Token/Sek. beim Decodieren auf einem Raspberry Pi 5, während unabhängige Berichte zu x86-CPUs je nach Quantisierungsstufe 8-48 Token/Sek. nennen. Auf einer GPU schrumpft der Geschwindigkeitsvorteil, weil der GPU-Durchsatz weniger stark von der Modellgröße begrenzt wird. Prüfen Sie aktuelle Benchmarks für Ihre konkrete Hardware, statt von einem festen Faktor auszugehen.
Unterstützen kleine Modelle Function Calling?
Manche ja. Laut der Modellkarte von Qwen3.5 zeichnet sich die Familie bei Tool Calling aus, und Gemma 4 E4B gibt auf Googles Karte einen agentischen Tau2-Wert von 42,2 % an (E2B: 24,5 %); E4B ist von beiden daher die sicherere Wahl für Tool-Nutzung. Prüfen Sie die Dokumentation des jeweiligen Modells, bevor Sie eine Pipeline bauen, die auf strukturierte Ausgaben angewiesen ist, denn die Unterstützung variiert je nach Version und Laufzeitumgebung.
Welches kleine Modell ist am besten für andere Sprachen als Englisch?
Qwen3.5 4B und Gemma 4 E4B liegen beim mehrsprachigen Benchmark MMMLU praktisch gleichauf (76,1 gegenüber 76,6 laut ihren Modellkarten), und beide sind deutlich besser als die Modelle der 2B-Klasse. Für Chinesisch, Japanisch, Koreanisch oder Arabisch auf einem Rechner mit 4 GB ist Qwen3.5 2B die praktische Wahl. Einen breiteren Sprachvergleich finden Sie im mehrsprachigen Vergleich Qwen vs. Llama vs. Mistral.
Sollte ich bei einem kleinen Modell den Thinking-Modus verwenden?
Für einfache Aufgaben in der Regel nicht. Qwen3.5-Modelle denken standardmäßig, was vor der Antwort viele zusätzliche Token verbraucht und sich auf der CPU langsam anfühlt. Schalten Sie Thinking für Chat, Umformulierungen und Extraktion aus (in Ollama: `ollama run qwen3.5:4b --think=false`); aktivieren Sie es nur für Mathematik, Logik oder mehrstufige Probleme, bei denen Genauigkeit wichtiger ist als Tempo.
Lohnt sich Llama 3.2 noch?
Es wird hier nicht mehr gelistet. Llama 3.2 1B und 3B (2024) sind älter als jedes Modell auf dieser Seite, und die neueren 2B-4B-Modelle oben leisten bei ähnlicher Größe mehr. Llama 3.2 bleibt nützlich, wenn ein Tool oder Fine-Tune, auf das Sie angewiesen sind, darauf aufbaut.
Wie viel RAM braucht ein 4B-Modell?
Rechnen Sie bei einem 4B-Modell mit 4-Bit-Quantisierung mit etwa 4-5 GB freiem Speicher -- Ollama listet Qwen3.5 4B mit 3,3-4,0 GB und Phi-4 Mini mit 2,5 GB -- zuzüglich Platz für das Kontextfenster und Ihr Betriebssystem. Ein Rechner mit 8 GB ist komfortabel; 4 GB sind es nicht. Gemma 4 E4B ist die Ausnahme: Sein angegebener Download umfasst 6,6-9,5 GB, daher braucht es für komfortable Nutzung einen Rechner mit 12-16 GB.
Kann ich zwei kleine Modelle gleichzeitig betreiben?
Ja, sofern der gesamte RAM ausreicht. Zwei Modelle der 2B-Klasse in Q4_K_M belegen zusammen etwa 6 GB -- machbar auf einem Rechner mit 8 GB und schlankem Betriebssystem. Ollama kann je nach Einstellungen und verfügbarem Speicher mehrere Modelle gleichzeitig geladen halten, oder Sie starten zwei Ollama-Instanzen auf unterschiedlichen Ports (OLLAMA_HOST=:11434 und OLLAMA_HOST=:11435). Das ist nützlich, um Ausgaben im A/B-Test zu vergleichen.
Funktionieren kleine Modelle für RAG (Retrieval-Augmented Generation)?
Für einfaches RAG ja. Qwen3.5 4B und Phi-4 Mini können Fragen zu abgerufenen Dokumentausschnitten zuverlässig beantworten. Bei RAG über große Wissensbasen, die mehrstufiges Schlussfolgern erfordern, arbeiten Modelle ab 7B konsistenter. Die LocalDocs-Funktion von GPT4All lässt ein kleines Modell Fragen zu Dokumenten beantworten und funktioniert gut für persönliche Dokumentensammlungen.
Quellen
- Modellkarten Qwen3.5-4B, -2B und -0.8B -- huggingface.co/Qwen/Qwen3.5-4B (Benchmarks, Lizenz, Kontextlänge)
- Ollama Library: qwen3.5 -- ollama.com/library/qwen3.5 (Tags, Download-Größen, Kontext)
- Google Gemma 4 Modellkarte -- huggingface.co/google/gemma-4-E4B-it (Benchmarks E2B und E4B, Lizenz)
- Ollama Library: gemma4 -- ollama.com/library/gemma4 (Tags, Download-Größen, Benchmark-Tabelle)
- Microsoft Phi-4-mini-instruct Modellkarte -- huggingface.co/microsoft/Phi-4-mini-instruct (MMLU, MMLU-Pro, GPQA, Lizenz)
- Ollama Library: phi4-mini -- ollama.com/library/phi4-mini (Download-Größe, Kontext)