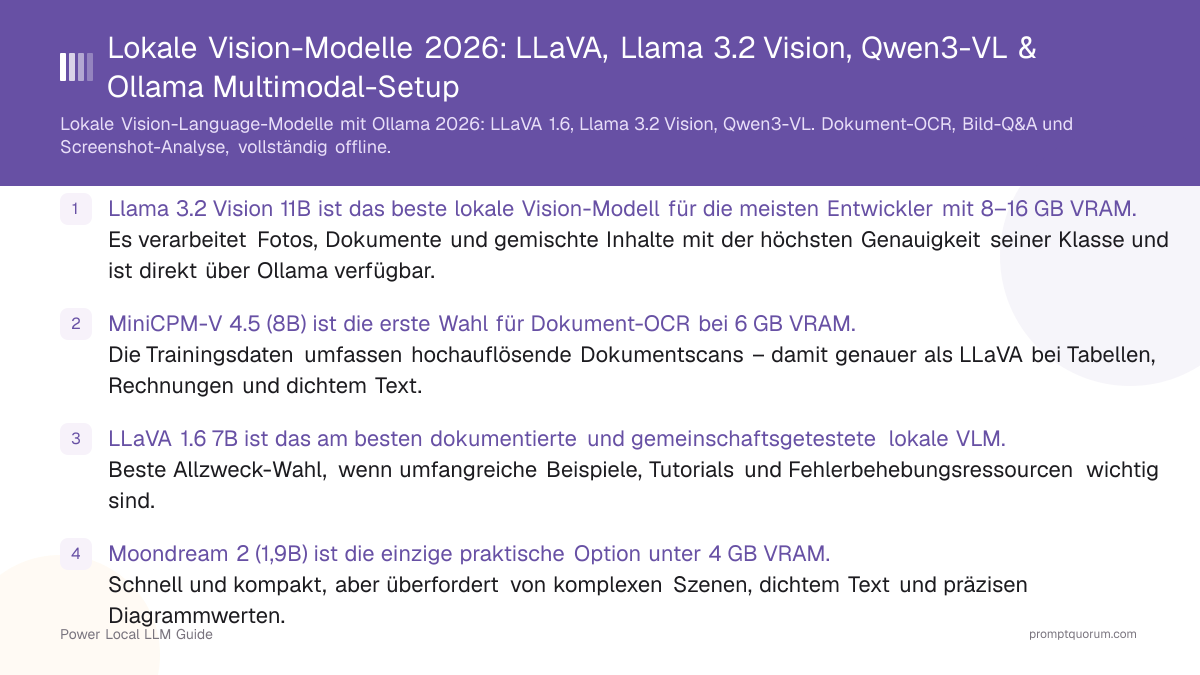
Schnellübersicht
- Was VLMs leisten: Bild- + Texteingabe → Textausgabe. Keine Bildgeneratoren – diese Modelle *verstehen* Bilder.
- Ollama-Unterstützung: Gemma 4, Qwen3.8, Qwen3.5, Qwen3-VL, Llama 3.2 Vision, MiniCPM-V, LLaVA und Moondream sind in der offiziellen Ollama-Bibliothek; InternVL, PaliGemma 2 und SmolVLM benötigen Community-Builds.
- Kleinste nutzbare Modelle: Moondream 2 (1,8B, 1,7 GB Download), Qwen3-VL 2B (1,9 GB) und Qwen3.5 0.8B (1,2–1,3 GB).
- Größte praktische lokale Modelle: Qwen3.5 122B (81 GB) auf einem Mac mit 128 GB und Llama 3.2 Vision 90B (55 GB) auf einem Mac mit 96 GB+ (Apple M-Series) oder Multi-GPU; Qwen3-VL 235B braucht 143 GB.
- Bild-Eingabeformat: JPEG, PNG, WebP. Maximale Auflösung variiert je Modell (typisch 1024×1024 bis 4096×4096).
- Audio und Video: Gemma 4 E2B, E4B und 12B akzeptieren auch Audio; alle Gemma-4-Größen und Qwen3.8 verarbeiten Video als Einzelbilder.
- OCR-Stärke: Qwen3.8 27B ≈ Qwen3-VL 8B ≈ Qwen3.5 9B > Gemma 4 > MiniCPM-V > LLaVA 1.6 13B > LLaVA 1.6 7B > Moondream 2.
- Multimodal ist langsamer: Vision-Modelle fügen einen Vision-Encoder zum LLM hinzu – ~30–60 % langsamere Token-Generierung als ein reines Textmodell gleicher Parameterzahl.
Was sind Vision-Language-Modelle (VLMs)?
Ein Vision-Language-Modell (VLM) ist ein neuronales Netz, das Bild- und Texteingaben gleichzeitig verarbeitet und Textausgaben erzeugt. Die Standardarchitektur verbindet einen Vision-Encoder (typischerweise CLIP oder SigLIP) mit einem Language-Decoder (einem LLM) über eine Projektionsschicht, die Bildmerkmale in den Token-Raum des LLMs überführt.
- Unterschied zu Bildgeneratoren: Stable Diffusion, FLUX und DALL-E 3 sind Text-zu-Bild-Generatoren. VLMs sind Bild-zu-Text-Modelle – sie beschreiben, analysieren und beantworten Fragen zu Bildern.
- Unterschied zu reinen OCR-Tools: Klassische OCR (Tesseract, PaddleOCR) extrahiert Text per Mustererkennung. VLMs verstehen Kontext – sie können den Inhalt einer Tabelle erklären, Fragen zu einem Diagramm beantworten oder Objekte identifizieren.
- Warum lokal betreiben: Private Dokumente (Krankenakten, juristische Scans, Finanzberichte), proprietäre Screenshots oder Workflows, bei denen das Senden von Bildern an Cloud-APIs Compliance- oder Vertraulichkeitsbedenken aufwirft.
- Was sie nicht können: Bilder generieren, Code aus Screenshots ausführen oder auf das Internet zugreifen. VLMs erzeugen ausschließlich Textausgaben basierend auf dem, was im Bild sichtbar ist.
Verfügbare lokale Vision-Modelle — Vergleichstabelle
Vergleich der leistungsfähigsten lokalen Vision-Modelle, verfügbar über Ollama oder direkte Inferenz, geprüft am 23. Oktober 2026. Die VRAM-Spalte nennt die Ollama-Download-Größe (4-Bit-quantisiert, sofern nicht anders angegeben) – für den Kontext 1–2 GB hinzurechnen. *Llama 3.2 Vision lädt laut Nutzerberichten unter aktuellen Ollama-Versionen nicht (siehe Hinweis zu Llama 3.2 Vision unten).
📍 In einem Satz
Für 8 GB VRAM: Gemma 4 E4B oder Qwen3-VL 8B; für 24 GB: Gemma 4 26B/31B oder Qwen3.8 27B – alle lokal via Ollama.
💬 In einfachen Worten
Gemma 4 ist das beste Gesamtmodell; Qwen3-VL, Qwen3.5 und Qwen3.8 führen bei Dokument-OCR und mehrsprachigem Text; Moondream und Qwen3.5 2B sind die leichten Optionen unter 4 GB VRAM.
Modell | Parameter | VRAM (Q4) | Bildtypen | Qualität | Via Ollama? |
|---|---|---|---|---|---|
| Moondream 2 | 1,8B | ~2 GB | Einfache Fotos | Grundlegend | Ja |
| SmolVLM 2,2B | 2,2B | ~2 GB | Einfache Fotos, Beschriftungen | Grundlegend+ | Community |
| Qwen3.5 2B | 2B | 2,7–3,1 GB | Fotos, Dokumente, OCR | Gut | Ja |
| PaliGemma 2 3B | 3B | ~3 GB | Fotos, Dokumente | Gut | Community |
| Qwen3-VL 4B | 4B | 3,3 GB | Fotos, Dokumente, OCR | Gut | Ja |
| Gemma 4 E2B | 2,3B eff. | 4,6–7,5 GB | Fotos, Dokumente, Audio | Gut | Ja |
| LLaVA 1.6 7B | 7B | ~6 GB | Fotos, Dokumente, Diagramme | Gut | Ja |
| MiniCPM-V | 8B | ~6 GB (5,5 GB Pull) | Fotos, Dokumente, OCR | Sehr gut | Ja |
| Qwen3-VL 8B | 8B | ~6,2 GB | Fotos, Dokumente, OCR, Mehrsprachig | Ausgezeichnet | Ja |
| Qwen3.5 9B | 9B | 6,6–7,6 GB | Fotos, Dokumente, OCR, Mehrsprachig | Ausgezeichnet | Ja |
| Gemma 4 E4B | 4,5B eff. | 6,6–9,5 GB | Fotos, Dokumente, Audio | Sehr gut | Ja |
| Gemma 4 12B | 12B | 7,7–8,0 GB | Fotos, Dokumente, Audio | Ausgezeichnet | Ja |
| InternVL 2.5 8B | 8B | ~8 GB | Dokumente, Diagramme, UI, Code | Ausgezeichnet (UI/Diagramme) | Community |
| Llama 3.2 Vision 11B | 11B | ~8 GB (7,8 GB Pull) | Fotos, Dokumente | Ausgezeichnet* | Ja* |
| LLaVA 1.6 13B | 13B | ~10 GB | Fotos, Dokumente, Diagramme | Sehr gut | Ja |
| Gemma 4 26B A4B | 26B (4B aktiv) | 16–19 GB | Fotos, Dokumente, Komplex | Ausgezeichnet | Ja |
| Qwen3.8 27B | 27B | 18 GB | Fotos, Dokumente, Video, OCR | Bestes Open-Source | Ja |
| Gemma 4 31B | 31B | 19–20 GB | Fotos, Dokumente, Komplex | Ausgezeichnet | Ja |
| Qwen3-VL 32B | 32B | 21 GB | Fotos, Dokumente, OCR, Komplex | Ausgezeichnet | Ja |
| Llama 3.2 Vision 90B | 90B | 55 GB | Fotos, Dokumente, Komplex | Sehr gut* | Ja* |
| Qwen3.5 122B | 122B | 81 GB | Fotos, Dokumente, Komplex | Bestes lokales Modell | Ja |

Beispielhafter Vergleich: Rechnungsextraktion
Beispielhafter Vergleich der Genauigkeit lokaler Vision-Modelle bei strukturierter Dokumentenextraktion: fünf Felder (Lieferant, Datum, Gesamt, Steuer, Positionen) aus einer Musterrechnung. Das ist kein Benchmark von PromptQuorum. Gerät, Laufzeitversion, Modell-Tags, Quantisierung, Prompt und Anzahl der Durchläufe wurden nicht festgehalten; die Markierungen sind daher Richtwerte und nicht reproduzierbar. Mit * markierte Zeilen setzen voraus, dass das Modell in Ihrer Ollama-Version lädt.
Modell | Anbieter | Datum | Gesamt | Steuer | Positionen | Bewertung |
|---|---|---|---|---|---|---|
| Moondream 2 | ✓ | ✓ | ✗ | ✗ | ✗ | 2/5 |
| LLaVA 1.6 7B | ✓ | ✓ | ✓ | ✗ | ✓ | 4/5 |
| MiniCPM-V | ✓ | ✓ | ✓ | ✓ | ✓ | 5/5 |
| Qwen3-VL 8B | ✓ | ✓ | ✓ | ✓ | ✓ | 5/5 |
| Llama 3.2 Vision 11B* | ✓ | ✓ | ✓ | ✓ | ✓ | 5/5 |
| GPT-5.5 Vision | ✓ | ✓ | ✓ | ✓ | ✓ | 5/5 |
📌Hinweis: Ergebnisse aus einem einzelnen Testdokument. Die Genauigkeit variiert je nach Dokumentqualität, Schriftart und Layoutkomplexität. Extrahierte Zahlen immer gegen das Quelldokument prüfen.
Multi-Bild-Unterstützung
Nicht alle lokalen Vision-Modelle akzeptieren mehrere Bilder in einer Anfrage. Multi-Bild-Unterstützung ist wichtig für Dokumentenverarbeitung und visuelle Vergleichsaufgaben.
- MiniCPM-V akzeptiert bis zu 4 Bilder pro Prompt; Qwen3-VL verarbeitet bis zu 8. LLaVA und Moondream akzeptieren nur einzelne Bilder pro Anfrage.
- Wann Multi-Bild wichtig ist: Alle Seiten eines mehrseitigen PDFs für vollständige Extraktion senden. Zwei Produktfotos nebeneinander vergleichen. Vorher/Nachher-Screenshots in einem Prompt analysieren.
Funktion | Moondream | LLaVA 7B | MiniCPM-V | Qwen3-VL | LLaVA 13B | Llama 3.2 Vision | InternVL |
|---|---|---|---|---|---|---|---|
| Multi-Bild-Eingabe | Nein | Nein | Ja (bis zu 4) | Ja (bis zu 8) | Nein | Ja (mehrere Seiten) | Ja |
Setup mit Ollama — Schritt für Schritt
Ollama ist der einfachste Weg, lokale Vision-Modelle auszuführen. Nach der Installation funktionieren Vision-Modelle mit einem einzigen Pull-Befehl.
- Schritt 1 — Ollama installieren: Download von ollama.com für macOS, Linux oder Windows. Installation unter 2 Minuten.
- Schritt 2 — Modell herunterladen:
ollama pull gemma4:e4b(6,6–9,5 GB Download) für 8-GB-Karten,ollama pull qwen3-vl:8b(6,2 GB) für OCR oderollama pull moondream(1,8B, 1,7 GB) für VRAM-beschränkte Systeme. - Schritt 3 — Über CLI nutzen:
ollama run gemma4:e4b "Was ist auf diesem Bild? /pfad/zum/foto.jpg"— den Bildpfad im Prompt angeben;ollama runhat kein--image-Flag. - Schritt 4 — HTTP-API nutzen: POST an
http://localhost:11434/api/generatemit dem Bild als Base64-String imimages-Array. Mit einem JSON-Schema im Feldformaterhalten Sie strukturierte Ausgaben. - Schritt 5 — Python-Beispiel:
requests-Bibliothek mit Base64-Kodierung verwenden – siehe Code-Block unten.
import base64
import requests

def ask_vision_model(image_path: str, prompt: str, model: str = "gemma4:e4b") -> str:
    with open(image_path, "rb") as f:
        image_b64 = base64.b64encode(f.read()).decode("utf-8")

    response = requests.post(
        "http://localhost:11434/api/generate",
        json={
            "model": model,
            "prompt": prompt,
            "images": [image_b64],
            "stream": False,
        },
    )
    return response.json()["response"]

# Beispielaufruf
result = ask_vision_model("rechnung.png", "Extrahiere alle Positionen und Gesamtbeträge aus dieser Rechnung.")
print(result)
Anwendungsfall 1: Dokument-OCR und -Extraktion
VLMs übertreffen klassische OCR bei halbstrukturierten Dokumenten – Rechnungen, Quittungen, Verträge und Tabellen, bei denen Layout und Text gleich wichtig sind.
- Was gut funktioniert: Gescannte Rechnungen, PDF-Screenshots, handgeschriebene Druckschrift, Tabellen mit klaren Linien, Visitenkarten.
- Was weniger gut funktioniert: Kursivhandschrift, Scans unter 150 DPI, stark komprimierte JPEGs, überlappender Text.
- Beste Modelle für OCR: Qwen3-VL 8B und Qwen3.5 9B (6–8-GB-Klasse), Qwen3.8 27B (18 GB, laut Modell-Card 91,1 bei OmniDocBench 1.5), Gemma 4 für gemischte Dokumenttypen.
- Prompt-Engineering für OCR: „Extrahiere den gesamten Text aus diesem Dokument genau wie geschrieben." Oder: „Gib den Inhalt dieser Rechnung als JSON zurück mit Feldern: Anbieter, Datum, Positionen[], Gesamt."
- Vs. klassische OCR: VLMs sind langsamer, aber semantisch mächtiger. Tesseract für reine Textextraktion aus sauberen Dokumenten; VLMs für strukturierte Datenextraktion.
Anwendungsfall 2: Bild-Q&A und -Beschreibung
Für allgemeines Szenenverständnis, Produktbeschreibungen und visuelle Q&A ist Gemma 4 (E4B bei 8 GB, 26B oder 31B bei 24 GB) das empfohlene lokale Modell. Es erzeugt natürliche, detaillierte Beschreibungen und beantwortet nuancierte Fragen zum Bildinhalt.
- Szenenbeschreibung: „Was ist auf diesem Foto?" – Objekte, Personen, Aktivitäten, Umgebung, Stimmung.
- Produktkatalogisierung: Produktfotos mit einem Template verarbeiten: „Beschreibe Farbe, Form, Material, Zustand." Nützlich für E-Commerce-Inventar ohne Cloud-APIs.
- Barrierefreiheit: Alt-Texte für Bilder im großen Maßstab generieren.
- Beste Modelle: Gemma 4 12B oder 26B A4B für allgemeine Foto-Q&A. Qwen3.5 4B oder LLaVA 1.6 7B für Massenverarbeitung, wenn Geschwindigkeit wichtiger ist als Genauigkeit.
- Geschwindigkeitshinweis: Die Geschwindigkeit hängt von Modell, GPU und Länge der Beschreibung ab – vor einem Batch mit Tausenden Bildern eine Stichprobe von 20 Bildern auf der eigenen Hardware testen.
Anwendungsfall 3: Screenshot- und UI-Analyse
Für die Analyse von Anwendungs-Screenshots, Fehlermeldungen und Dashboards ist InternVL 2.5 das stärkste lokale Modell.
- Entwickler-Workflows: Screenshots von Fehlermeldungen an das Modell weiterleiten: „Was ist falsch und wie würde man es beheben?"
- Bug-Report-Generierung: Automatische Erstellung von Bug-Beschreibungen aus Screenshots.
- Dashboard-Monitoring: Screenshots auf Anomalien analysieren – „Gibt es Metriken auf Warnstufe in diesem Grafana-Screenshot?"
- Accessibility-Testing: Screenshots vor und nach UI-Änderungen vergleichen.
- Beste Modelle: InternVL 2.5 8B (Community-Build, stark bei UI), Gemma 4 und Qwen3-VL (offizielle Ollama-Unterstützung, Tool Calling für Agenten-Workflows).
Anwendungsfall 4: Diagramm- und Grafikanalyse
Daten aus Diagrammen und Tabellen zu extrahieren ist möglich, erfordert aber sorgfältiges Prompting. Alle lokalen VLMs sind bei Diagrammen schwächer als bei Fotos – extrahierte Zahlen immer gegen Quelldaten prüfen.
- Was gut funktioniert: Achsenbeschriftungen lesen, Trends erkennen, relative Balkenhöhen vergleichen, Tabellenwerte auslesen.
- Was unzuverlässig ist: Präzise numerische Extraktion aus kontinuierlichen Diagrammen, Kreisdiagramm-Prozentsätze ohne Beschriftungen.
- Prompt-Strategie: „Beschreibe den Trend" funktioniert besser als „Was ist der exakte Wert?"
- Beste Modelle: InternVL 2.5 (starkes Diagrammverständnis), Gemma 4 und Qwen3-VL (gut bei klar beschrifteten Diagrammen).
- Einschränkungshinweis: Kein lokales VLM extrahiert 2026 zuverlässig präzise Zahlen aus komplexen Diagrammen.
Anwendungsfall 5: Video-Frame-Analyse
Lokale Vision-Modelle können Videos analysieren, indem sie einzelne Frames verarbeiten – Frames per ffmpeg extrahieren, durch das Vision-Modell schicken, dann mit einem Text-LLM zusammenfassen. Nicht in Echtzeit: 1 Frame pro 0,5–3 Sekunden.
- Frame-Extraktion:
ffmpeg -i video.mp4 -vf fps=1 frames/frame_%04d.jpg - Frame-für-Frame-Analyse: Jeden Frame mit konsistentem Prompt durch das Vision-Modell schicken.
- Übergreifende Zusammenfassung: Alle Frame-Beschreibungen an ein Text-LLM übergeben.
- Anwendungsfälle: Sicherheitskamera-Review, Vorlesungsaufzeichnungsanalyse, Qualitätskontrolle in der Fertigung.
- Beste Modelle: Gemma 4 oder Qwen3.8 für Qualität (beide akzeptieren Video nativ als Einzelbilder), Qwen3.5 4B oder LLaVA 1.6 7B für Geschwindigkeit (höherer Frame-Durchsatz).
- Geschwindigkeitsrealität: Bei 1 Frame/Sekunde Extraktion und ~1–3 Sekunden pro Frame dauert die Verarbeitung eines 10-minütigen Videos (600 Frames) je nach Modell und GPU etwa 10–30 Minuten.
import base64
import subprocess
import os
import requests

def extract_frames(video_path: str, output_dir: str, fps: int = 1) -> list[str]:
    os.makedirs(output_dir, exist_ok=True)
    subprocess.run([
        "ffmpeg", "-i", video_path,
        "-vf", f"fps={fps}",
        f"{output_dir}/frame_%04d.jpg",
        "-y"
    ], check=True)
    return sorted([
        os.path.join(output_dir, f)
        for f in os.listdir(output_dir)
        if f.endswith(".jpg")
    ])

def analyze_frame(image_path: str, model: str = "gemma4:e4b") -> str:
    with open(image_path, "rb") as f:
        image_b64 = base64.b64encode(f.read()).decode("utf-8")
    response = requests.post(
        "http://localhost:11434/api/generate",
        json={
            "model": model,
            "prompt": "Describe what is happening in this frame in one sentence.",
            "images": [image_b64],
            "stream": False,
        },
    )
    return response.json()["response"]

frames = extract_frames("vorlesung.mp4", "frames/", fps=1)
descriptions = [analyze_frame(f) for f in frames]
print("\n".join(f"[{i+1}s] {d}" for i, d in enumerate(descriptions)))
VRAM und Leistungs-Realitätscheck
Lokale Vision-Modelle fügen einen Vision-Encoder zum Basis-LLM hinzu, was sowohl VRAM-Bedarf als auch Inferenzzeit erhöht.
Modell | VRAM (Q4) | Token/Sek. (RTX 4070) | Token/Sek. (M5 Pro 36 GB) | Produktionstauglich? |
|---|---|---|---|---|
| Moondream 2 (1,8B) | ~2 GB | ~25–35 | ~30–40 | Ja — für einfache Aufgaben |
| LLaVA 1.6 7B | ~6 GB | ~15–20 | ~18–25 | Ja — Allzweck |
| MiniCPM-V (8B) | ~6 GB | ~12–18 | ~15–20 | Ja — OCR und Dokumente |
| Llama 3.2 Vision 11B | ~8 GB | ~10–14 | ~12–16 | Erst Ollama-Ladeproblem prüfen |
| LLaVA 1.6 13B | ~10 GB | ~8–12 | ~10–14 | Ja — mit 12-GB-GPU |
| Llama 3.2 Vision 90B | 55 GB | N/A (Multi-GPU oder M-Max) | N/A (M5 Max 128 GB+) | Nur High-End Apple Silicon |
📌Hinweis: Die Token-pro-Sekunde-Bereiche sind Richtwerte, keine neuen Messungen; sie wurden für Gemma 4, Qwen3.5 oder Qwen3.8 nicht erneut ermittelt. Auf der eigenen Hardware mit ollama run <model> --verbose testen, das die Eval-Rate ausgibt.
📌Hinweis: Die Token-Generierungsgeschwindigkeit ist langsamer als bei reinen Textmodellen, da der Vision-Encoder beim ersten Bild-Token erheblichen Mehraufwand verursacht. Nachfolgende Text-Tokens werden nahezu normal generiert.
📌Hinweis: Apple Silicon Unified Memory ermöglicht größere Modelle (Llama 3.2 Vision 90B mit 55 GB oder Qwen3.5 122B mit 81 GB auf einem Mac mit 128 GB), die nicht in diskreten GPU-VRAM passen. Etwas langsamer als NVIDIA, aber ohne VRAM-Beschränkung.
Lokale Vision-Modelle vs. GPT-5.5 Vision
Lokale VLMs haben den Rückstand bei strukturierten Dokumenten deutlich verringert, liegen aber bei komplexen Aufgaben noch hinter GPT-5.5 Vision. Die folgenden Vergleiche sind redaktionelle Einschätzungen, keine PromptQuorum-Benchmarks.
- Strukturierte Dokumente (Rechnungen, Formulare): Redaktionelle Einschätzung, kein gemessener Benchmark: Starke lokale Modelle kommen bei sauberen, gut formatierten Dokumenten nah an GPT-5.5 Vision heran – für den Produktionseinsatz ausreichend, sobald Sie die Ausgabe validieren.
- Komplexe Szenen, mehrdeutige Bilder: Lokale Modelle liegen bei Bildern mit ungewöhnlichem Kontext, schwierigem Licht oder mehrdeutigem Inhalt spürbar hinter GPT-5.5 Vision (redaktionelle Einschätzung, nicht gemessen).
- Handschrifterkennung: Lokale Modelle deutlich schwächer, besonders bei Kursivschrift.
- Diagrammdatenextraktion: Auf beiden unzuverlässig, aber GPT-5.5 bei präzisen Zahlenwerten genauer.
- Kosten: GPT-5.5 Vision bei 0,01–0,03 $ pro Bild vs. 0 $ lokal. 10.000 Bilder/Monat = 100–300 $ gespart.
- Datenschutz: Lokale Modelle verarbeiten Bilder standardmäßig auf dem Gerät – Bilder werden nicht an eine Cloud-API gesendet, solange Sie keine Cloud-Funktionen oder vernetzten Tools aktivieren.
- Geschwindigkeit: Lokale Modelle erzeugen auf einer RTX 4070 je nach Größe etwa 8–35 Token/Sek. (Richtwerte, siehe Tabelle oben); die Cloud-Geschwindigkeit schwankt je nach Anbieter und Auslastung, lokal gibt es dafür keine Netzwerklatenz.
📌Hinweis: Für Rechnungs- und Formularverarbeitung mit sauberem Input können lokale VLMs (Gemma 4, Qwen3-VL 8B, Qwen3.8 27B) GPT-5.5 Vision bei null Kosten ersetzen. Bei Handschrift, komplexer Szenenanalyse oder mehrdeutigen Inhalten liegt GPT-5.5 weiterhin vorn.
LLaVA im Detail
LLaVA (Large Language and Vision Assistant) ist die grundlegende Open-Source-VLM-Architektur. Veröffentlicht von der University of Wisconsin-Madison und Microsoft Research 2023.
- Architektur: CLIP ViT-L/14 Vision-Encoder + Llama-2 oder Mistral Text-Decoder, verbunden durch eine lineare Projektionsschicht.
- LLaVA 1.5 vs. 1.6: Version 1.6 (Anfang 2024) fügte dynamisches Patching für höhere Auflösungen hinzu und verbesserte OCR und Diagrammauswertung deutlich.
- Training: Instruction-tuning auf LLaVA-Instruct-150K – visuellen Konversationen aus Bildbeschriftungen und Objekterkennungsannotationen.
- Stärken: Breites Allgemeinwissen, gut dokumentiert, große Community, umfangreiche Ollama-Integration.
- Schwächen: Schwächere OCR als Qwen3-VL und MiniCPM-V, schwächere UI-Analyse als InternVL 2.5, insgesamt von Gemma 4 und der Qwen3-Familie übertroffen.
- Warum weiterhin empfohlen: Größte Community, meiste Tutorials, meiste Beispiel-Prompts aller lokalen VLMs.
- Vollständiger Test: LLaVA im Test (2026) — PromptQuorums dedizierter Test, einschließlich der Apache-2.0-plus-Basismodell-Lizenznuance und echter Ollama-Befehle.
Qwen3-VL, Qwen3.5 und Qwen3.8 — Beste multilinguale OCR-Leistung
Die Qwen-Familie ist 2026 die stärkste offene Option für Dokument-OCR und mehrsprachigen Text. Qwen3-VL (Größen 2B bis 235B) ist die dedizierte Vision-Linie, Qwen3.5 (0.8B bis 122B) integriert Vision in das Basismodell, und Qwen3.8 27B (August 2026, Apache 2.0) ist das neueste Modell mit gemeldeten 91,1 bei OmniDocBench 1.5.
- Architektur: Dynamische Auflösung bis 4096×4096 – deutlich höher als LLaVA 1.6 (672×672) oder Llama 3.2 Vision (1120×1120).
- Mehrsprachige OCR: Beste Klasse für Chinesisch, Japanisch, Koreanisch und Englisch. Umfangreiche mehrsprachige Dokumentkorpora im Training.
- Welche Größe: Qwen3-VL 8B ist ein Download von 6,2 GB und passt auf 8-GB-Karten; Qwen3.5 9B hat 6,6–7,6 GB; Qwen3.8 27B hat 18 GB und braucht eine 24-GB-Karte; Qwen3-VL 32B hat 21 GB. Qwen3-VL hat auf Ollama keine 72B-Variante.
- Qwen3-VL 4B: Download von 3,3 GB (256K Kontext) – die Mitte zwischen den Builds 2B (1,9 GB) und 8B (6,2 GB) für Karten mit etwa 4–6 GB VRAM.
- Ollama-Installation:
ollama pull qwen3-vl:8b,ollama pull qwen3.5:9boderollama pull qwen3.8— alle in der Ollama-Modellbibliothek. - Multi-Bild: Bis zu 8 Bilder pro Anfrage – höchste Kapazität im Vergleich.
- Modellseiten: Qwen3-VL auf Ollama, Qwen3.8-27B auf Hugging Face
Auswahl des richtigen Vision-Modells
Entscheidungsbaum für die Modellauswahl – VRAM zuerst:
📍 In einem Satz
Modell nach VRAM wählen (2→4→8→24 GB), dann nach Anwendungsfall verfeinern (OCR, UI, allgemeine Q&A oder maximale Qualität).
💬 In einfachen Worten
Unter 4 GB: Qwen3.5 2B oder Moondream. 8 GB: Gemma 4 E4B für Fotos, Qwen3-VL 8B für Dokumente. 24 GB: Gemma 4 26B/31B oder Qwen3.8 27B. 64+ GB: Qwen3.5 122B.
- Unter 4 GB VRAM: Qwen3.5 2B (2,7–3,1 GB), Qwen3-VL 2B (1,9 GB) oder Moondream 2 (1,7 GB) sind die praktischen Optionen. PaliGemma 2 (3B) und SmolVLM (2,2B) sind Alternativen als Community-Builds. Keines ist für dichten Text-OCR geeignet.
- 6–8 GB VRAM: Gemma 4 E4B für allgemeine Foto-Q&A, Qwen3-VL 8B oder Qwen3.5 9B für Dokument-OCR und mehrsprachigen Text, LLaVA 1.6 7B, wenn Community-Unterstützung wichtig ist.
- 12–16 GB VRAM: Gemma 4 12B (7,7–8,0 GB Download) ist die klare Empfehlung – starke Vision-Werte für seine Größe, mit Audio-Eingabe und 256K-Kontextfenster. LLaVA 1.6 13B und InternVL 2.5 8B (UI- und Code-Screenshots) passen ebenfalls.
- 24 GB VRAM: Gemma 4 26B A4B (16–19 GB), Gemma 4 31B (19–20 GB), Qwen3.8 27B (18 GB) oder Qwen3-VL 32B (21 GB) – die lokale Option, die der Vision-Qualität von Cloud-Modellen am nächsten kommt.
- 96+ GB Unified Memory (Apple M-Max/Ultra, Multi-GPU): Qwen3.5 122B (81 GB, braucht einen Mac mit 128 GB) oder Llama 3.2 Vision 90B (55 GB) für die größten lokalen Modelle; beide erfordern Hardware mit viel Speicher und sind pro Token langsamer als die Modelle der 24-GB-Klasse.
- Zahlen immer prüfen: Aus Diagrammen extrahierte Zahlenwerte immer gegen Quelldaten gegenchecken.
Häufig gestellte Fragen
Warum schlägt llama3.2-vision mit „unknown model architecture: mllama" fehl?
Nutzer melden diesen Fehler bei llama3.2-vision unter aktuellen Ollama-Versionen (GitHub-Issues #16490 und #16547, Mitte 2026 eröffnet; das zweite wurde als Duplikat geschlossen, ohne bestätigte Lösung). Ein Update von Ollama oder erneutes Herunterladen des Modells half in diesen Berichten nicht. Wechseln Sie zu Gemma 4 oder Qwen3-VL, die in der Ollama-Bibliothek aktiv gepflegt werden – es sei denn, Sie müssen bei Llama 3.2 Vision bleiben; dann sollten Sie eine Ollama-Version festlegen, unter der es noch lädt.
Was ist das beste kleine Vision-Language-Modell unter 3B Parametern?
Qwen3.5 2B (2,7–3,1 GB Download) und Qwen3-VL 2B (1,9 GB) sind die stärksten kleinen Optionen auf Ollama; Moondream 2 (1,8B, 1,7 GB) ist das leichteste. Gemma 4 E2B (2,3B effektive Parameter, 4,6–7,5 GB Download) bietet zusätzlich Audio-Eingabe. Rechnen Sie mit schwächerer OCR und geringerem Verständnis komplexer Szenen als in der 8B-Klasse.
Welche lokalen Modelle verarbeiten Live-Kamera- und Mikrofoneingaben?
Gemma 4 E2B, E4B und 12B akzeptieren Bilder und Audio und sind damit die naheliegende Basis für einen lokalen Assistenten, der sieht und hört. Das Modell allein ist kein Live-System: Sie benötigen weiterhin eine Erfassungsschleife (Frames abgreifen, Audio in Blöcke teilen), einen Speech-to-Text- oder Audio-Eingabepfad und einen Text-to-Speech-Schritt für gesprochene Antworten. Prüfen Sie vorab, ob Ihre Runtime-Version Audio tatsächlich an das Modell weiterreicht.
Wie erhalte ich zuverlässige strukturierte Ausgaben aus Screenshots und Dokumenten?
Übergeben Sie ein JSON-Schema im Feld format von Ollama, setzen Sie die Temperatur auf 0 und fragen Sie nur Felder ab, die im Bild sichtbar sind. Das beschränkt die Antwort auf gültiges JSON mit Ihren Schlüsseln; es macht die Werte aber nicht richtig. Prüfen Sie Zahlen und Datumsangaben daher gegen die Quelle und protokollieren Sie Fehler. Größere Modelle (ab 8B) halten Schemas konsistenter ein als 2B-Modelle.
Was sind die besten GPT-4V-Alternativen, die vollständig auf dem Gerät laufen?
Gemma 4 31B (19–20 GB), Qwen3.8 27B (18 GB) und Qwen3-VL 32B (21 GB) kommen auf einer 24-GB-GPU am nächsten; Gemma 4 E4B und Qwen3-VL 8B decken 8-GB-Rechner ab. Alle können über Ollama ohne Internetverbindung laufen. Bei sauberen Dokumenten und Fotos halten sie mit Cloud-Modellen mit, bei Handschrift, mehrdeutigen Szenen und komplexen Infografiken liegen sie zurück.
Kann ich LLaVA oder Llama 3.2 Vision ohne Ollama verwenden?
Ja. Beide können direkt über llama.cpp (mit Vision-Unterstützung), die transformers-Bibliothek oder LM Studio ausgeführt werden. Ollama wird der Einfachheit halber empfohlen.
Unterstützt Llama 3.2 Vision direkte PDF-Eingabe?
Kein lokales VLM akzeptiert PDFs direkt. PDF-Seiten zuerst in Bilder umwandeln (pdf2image, pypdfium2) und jede Seite als separate Anfrage senden.
Wie vergleichen sich lokale Vision-Modelle mit GPT-5.5 Vision?
GPT-5.5 ist bei mehrdeutigen Szenen, Handschrift und komplexen Infografiken noch deutlich besser. Gemma 4 und Qwen3-VL nähern sich GPT-5.5 bei strukturierten Dokumenten (Rechnungen, Formulare, klare Fotos), fallen bei nuancierten oder mehrdeutigen Bildern aber zurück. Den vollständigen Vergleich mit Kosten, Datenschutz und Geschwindigkeit siehe oben.
Welche Bildauflösung unterstützen lokale VLMs?
LLaVA 1.6 bis 672×672 (dynamisches Patching). MiniCPM-V bis 1344×1344 (≈1.8 MP). Llama 3.2 Vision bis 1120×1120. Gemma 4 und Qwen3-VL akzeptieren variable Seitenverhältnisse und Auflösungen. Für beste OCR-Ergebnisse Dokumente mit 150+ DPI senden.
Kann ich ein lokales Vision-Modell auf eigenen Bildern fine-tunen?
Ja, aber ressourcenintensiver als reines Text-LLM-Fine-Tuning. LLaVA-Fine-Tuning mit dem Original-Trainings-Code gut dokumentiert. MiniCPM-V über Hugging Face-Skripte. Für die meisten Fälle reicht Prompt-Engineering.
Was ist das beste lokale Vision-Modell für 8 GB VRAM?
Gemma 4 E4B (6,6–9,5 GB Download) für den allgemeinen Einsatz oder Qwen3-VL 8B (6,2 GB), wenn Dokument-OCR oder mehrsprachiger Text im Vordergrund steht. Beide sind über Ollama mit einem einzigen Pull-Befehl verfügbar. Qwen3.5 9B (6,6–7,6 GB) ist eine dritte Option.
LLaVA vs. MiniCPM-V – welches ist besser für OCR?
MiniCPM-V ist bei Dokument-OCR genauer als LLaVA, besonders bei dichten Tabellen und hochauflösenden Scans, doch Qwen3-VL 8B ist die stärkere OCR-Wahl als beide. LLaVA 1.6 ist besser dokumentiert und hat mehr Community-Unterstützung. Beachten Sie, dass die minicpm-v-Seite von Ollama weiterhin MiniCPM-V 2.6 (5,5 GB) beschreibt; neuere MiniCPM-V-Versionen erfordern einen Build über Hugging Face oder llama.cpp.
Können lokale Vision-Modelle Handschrift erkennen?
Druckschrift: Ja, mit moderater Genauigkeit bei Gemma 4, Qwen3-VL und MiniCPM-V. Kursivschrift: Unzuverlässig bei allen lokalen Modellen. GPT-5.5 Vision ist bei Kursivschrift deutlich besser.
Welche lokalen Vision-Modelle laufen mit llama.cpp oder vLLM, nicht nur mit Ollama?
Mehrere. Die Multimodal-Dokumentation von llama.cpp nennt unter den fertigen GGUF-Builds unter anderem Gemma 3, Gemma 4 (E2B, E4B, 26B A4B, 31B), InternVL 2.5 und 3, Moondream 2 und SmolVLM; llama-server stellt sie über eine OpenAI-kompatible API bereit. Die vLLM-Seite zu unterstützten Modellen führt Gemma 4, Qwen3-VL, Qwen3.5, MiniCPM-V, InternVL und LLaVA-NeXT auf. Die Unterstützung unterscheidet sich je nach Modell und Version – prüfen Sie daher beide Seiten für Ihr konkretes Modell, bevor Sie darauf aufbauen (Stand der Prüfung: 23. Oktober 2026). Ollama bleibt die einfachste Wahl, weil es Download, Quantisierung und API in einem Werkzeug erledigt.
Wie stark verändert die Quantisierung VRAM-Bedarf und Qualität bei Vision-Modellen?
Die Quantisierung verändert vor allem den Speicherbedarf: Auf Ollama belegt Gemma 4 E4B 6,6 GB bei q4_K_M, 9,0 GB bei q8_0 und 16 GB bei bf16; Gemma 4 31B belegt 20 GB, 34 GB und 63 GB. Die Standard-Tags liegen meist nahe an der Größe von q4_K_M – deshalb zeigt die VRAM-Spalte oben 4-Bit-Werte. Die QAT-Builds von Google sind etwas kleiner (gemma4:e4b-it-qat hat 6,1 GB). Höhere Präzision kostet Speicher und Geschwindigkeit; ob sie Ihre Ergebnisse verbessert, hängt von Modell und Aufgabe ab. Wir haben das nicht gemessen – vergleichen Sie q4_K_M und q8_0 deshalb an einer Stichprobe Ihrer eigenen Bilder. Planen Sie 1–2 GB für den Kontext ein.
Welches lokale Vision-Modell sollte ich auf einem Mac mit Apple Silicon ausführen?
Ollama bietet MLX-Builds für Apple Silicon: gemma4:e4b-mlx (9,5 GB), gemma4:12b-mlx (7,7 GB), gemma4:26b-mlx (18 GB), gemma4:31b-mlx (19 GB) und qwen3.8:27b-mlx (18 GB). Der Unified Memory muss Gewichte, macOS und Kontext aufnehmen. Als Faustregel (unsere Dimensionierungshilfe, kein Benchmark): Ziehen Sie zuerst 8 GB für macOS ab: Auf einem Mac mit 16 GB (etwa 8 GB nutzbar) eignet sich Qwen3-VL 8B (6,2 GB); bei 24 GB (etwa 16 GB nutzbar) Gemma 4 E4B oder Gemma 4 12B; bei 32 GB (etwa 24 GB nutzbar) der 18-GB-Build von 26B A4B, Gemma 4 31B oder Qwen3.8 27B, wobei nur etwa 4–6 GB für den Kontext bleiben.
Welches lokale Vision-Modell passt zu 16 GB VRAM, 32 GB RAM oder einer GPU mit 2 GB?
2 GB VRAM: Moondream 2 (1,7 GB) oder Qwen3-VL 2B (1,9 GB), nur für einfache Bilder. Etwa 4 GB: Qwen3-VL 4B (3,3 GB). 16 GB VRAM: Gemma 4 12B (7,7–8,0 GB) mit Reserve für langen Kontext; der Download von Gemma 4 26B A4B (16–19 GB) passt nicht vollständig, sodass Ollama Schichten in den Arbeitsspeicher auslagert und langsamer wird. 24–32 GB VRAM (zum Beispiel RTX 5090): Gemma 4 31B, Qwen3.8 27B oder Qwen3-VL 32B. Mit 32 GB Arbeitsspeicher und ohne GPU laufen Modelle auf der CPU: Bleiben Sie in der 8B-Klasse (Qwen3-VL 8B, Gemma 4 E4B) und rechnen Sie mit deutlich geringerer Geschwindigkeit als auf einer GPU.
Gibt es Gemma 5 oder ein neueres Vision-Modell als Gemma 4 und Qwen3.8?
In den von uns am 23. Oktober 2026 geprüften Quellen nicht. Ollama hat keine gemma5-Seite, die gemma4-Seite führt die Builds E2B, E4B, 12B, 26B und 31B auf, und Qwen3.8 27B ist das neueste Qwen-Modell, das dieser Leitfaden behandelt. Neue Releases erscheinen häufig – prüfen Sie daher vor einer Entscheidung die Vision-Modellliste der Ollama-Bibliothek und behandeln Sie Aussagen über unveröffentlichte Modelle als unbestätigt.
Muss ich beim Einsatz lokaler Vision-Modelle die DSGVO beachten?
Verarbeiten lokale VLMs Bilder auf dem eigenen Gerät und erhält kein Drittanbieter Zugriff, entfällt für diese Verarbeitungsstufe in der Regel eine Auftragsverarbeitung nach DSGVO Art. 28; die DSGVO gilt für Ihre Verarbeitung aber weiterhin. Für Unternehmen mit Personendaten in Dokumenten kann eine Dokumentation nach BSI-Grundschutz hilfreich sein. Lokale Verarbeitung kann Datenschutz durch Technikgestaltung (DSGVO Art. 25) unterstützen. Dies ist keine Rechtsberatung.
Ist der Einsatz lokaler Vision-Modelle für den deutschen Mittelstand geeignet?
Ja. Für KMU, die sensible Geschäftsdokumente verarbeiten, bieten lokale VLMs klare Vorteile: keine Datenweitergabe an Cloud-Anbieter, solange Sie keine Cloud-Funktionen aktivieren, Betrieb auf vorhandener Hardware (ab 8 GB VRAM), keine laufenden API-Kosten. Lokale Verarbeitung kann bei vertraulichen Geschäftsdaten die Anforderungen des BSI-Grundschutzes unterstützen (Einzelfallprüfung erforderlich). Gemma 4 E4B und Qwen3-VL 8B laufen ab 8 GB VRAM.
Quellen
- Gemma 4 Modell-Card auf Hugging Face — Googles Apache-2.0-Lizenz, unterstützte Modalitäten je Größe und MMMU-Pro-Ergebnisse.
- Gemma 4 auf Ollama — Tags, Download-Größen und Kontextfenster.
- Qwen3.8-27B auf Hugging Face — Apache-2.0-Lizenz, 262K Kontext, OmniDocBench-1.5-Ergebnis.
- Qwen3.5 auf Ollama und Qwen3-VL auf Ollama — Größen und Download-Größen.
- Llama 3.2 Vision auf Ollama und Ollama-Issue #16547 — Eintrag und der gemeldete mllama-Ladefehler.
- LLaVA-Projektseite — LLaVA 1.5 und 1.6 Modell-Cards, Architekturdetails und Trainingsdatensatz.
- MiniCPM-V auf Ollama und OpenBMB auf Hugging Face — Modell-Cards und OCR-Benchmarks.
- Moondream auf Ollama und Moondream auf GitHub — Modell-Download und Inferenzskripte.
- InternVL 2.5 auf Hugging Face — OpenGVLab Modell-Card und Benchmark-Werte.
- Ollama-Dokumentation — Vision-Modell-Unterstützung, strukturierte Ausgaben, API-Referenz und Modellbibliothek.
- PaliGemma 2 auf Hugging Face — Googles PaliGemma 2 3B Modell-Card.
- SmolVLM auf Hugging Face — HuggingFace SmolVLM Modell-Card und Inferenzanleitung.
- llama.cpp-Dokumentation zu multimodalen Modellen — unterstützte Vision-Modelle und Nutzung von llama-server.
- vLLM – unterstützte Modelle — multimodale Architekturen, die vLLM bereitstellen kann.
- Gemma-4-Tags auf Ollama — Größen der Builds q4_K_M, q8_0, bf16, QAT und MLX.