Welches LLM ist aktuell das beste?
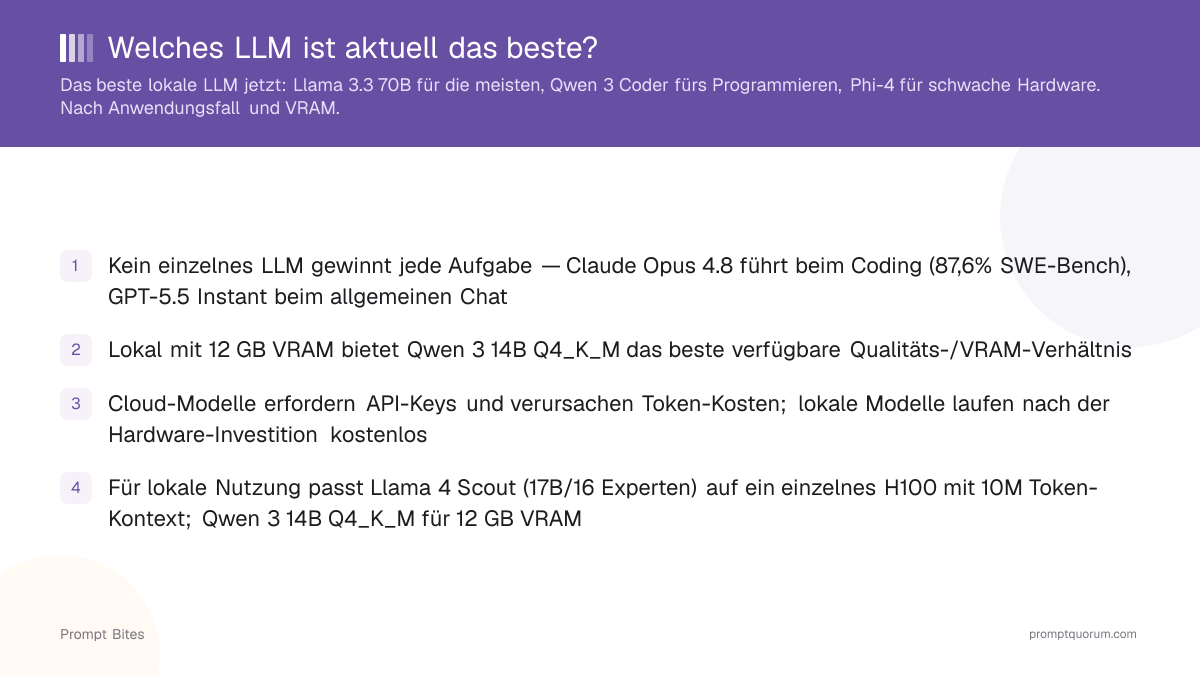
Schnelle Antwort
Im Juli 2026 kamen drei Flaggschiffe heraus, die jeweils anderes anführen. Claude Opus 5 (24. Juli) führt Frontier-Bench v0.1 und ist die Wahl fürs Coding. GPT-5.6 Sol (9. Juli) setzt den Stand der Technik bei Terminal-Bench 2.1 für Kommandozeilen- und Agentenarbeit. Gemini 3.1 Pro führt bei nativ multimodalen Aufgaben mit geprüften 77,1% auf ARC-AGI-2. Lokal ist qwen3.5:9b ein 6,6-GB-Download.
- ▸Cloud-Coding: Claude Opus 5 — führt Frontier-Bench v0.1
- ▸Cloud agentisch/CLI: GPT-5.6 Sol — Stand der Technik bei Terminal-Bench 2.1
- ▸Multimodal: Gemini 3.1 Pro — geprüfte 77,1% auf ARC-AGI-2
- ▸Lokal: qwen3.5:9b — 6,6 GB Download
Wichtigste Punkte
- ✓Kein einzelnes LLM gewinnt jede Aufgabe — Claude Opus 5 führt Frontier-Bench v0.1, GPT-5.6 Sol führt Terminal-Bench 2.1, Gemini 3.1 Pro führt multimodal
- ✓Alle drei Flaggschiffe erschienen im Juli 2026, jeder vorher geschriebene Vergleich ist also eine Generation veraltet
- ✓GPT-5.6 ist eine Familie, kein einzelnes Modell: Sol ist das Flaggschiff, Terra erreicht GPT-5.5-Niveau zum halben Preis, Luna kostet 80% weniger als Sol
- ✓Lokal deckt qwen3.5:9b (6,6 GB) allgemeine Arbeit ab und qwen2.5-coder:7b (4,7 GB) das Coding — beide weit unter der Hardware, die die meisten Ratgeber voraussetzen
- ✓Cloud-Modelle brauchen API-Schlüssel und kosten pro Token; lokale Modelle laufen nach dem Hardwarekauf kostenlos
Das beste LLM hängt von der Aufgabe ab — hier die Übersicht
Drei Flaggschiffe kamen im Juli 2026 binnen zwei Wochen heraus. Claude Opus 5 (24. Juli) fürs Coding, GPT-5.6 Sol (9. Juli) für agentische und Kommandozeilenarbeit, Gemini 3.1 Pro für alles Multimodale. Nachfolgend: wann welches gewinnt und welches zu welchem Arbeitsablauf passt.
Die Anbieter veröffentlichen keinen gemeinsamen Leitbenchmark mehr, ein Vergleich bedeutet also, unterschiedliche Evaluationen zu vergleichen. Anthropic berichtet, dass Opus 5 auf Frontier-Bench v0.1 alle anderen Modelle übertrifft und Opus 4.8 bei geringeren Kosten je Aufgabe mehr als verdoppelt. OpenAI berichtet, dass GPT-5.6 Sol den Stand der Technik auf Terminal-Bench 2.1 setzt, der Planung und Werkzeugkoordination in Kommandozeilen-Abläufen prüft. Google berichtet für Gemini 3.1 Pro geprüfte 77,1% auf ARC-AGI-2.
Eine strukturelle Änderung ist erwähnenswert: GPT-5.6 ist eine Dreier-Familie statt eines einzelnen Release. Sol ist das Frontier-Modell, Terra erreicht GPT-5.5 auf Intelligenz-Benchmarks zum halben Preis, und Luna liegt preislich 80% unter Sol. Wenn Kosten Ihre bindende Beschränkung sind, ist der interessante Vergleich Terra oder Luna gegen ein Konkurrenz-Flaggschiff, nicht Sol.
| Anwendungsfall | Bestes LLM | Warum |
|---|---|---|
| Coding | Claude Opus 5 | Führt Frontier-Bench v0.1; >2x Opus 4.8 bei geringeren Kosten je Aufgabe |
| Agentisch / Kommandozeile | GPT-5.6 Sol | Stand der Technik auf Terminal-Bench 2.1 |
| Multimodal (Video, Bild, Audio) | Gemini 3.1 Pro | Nativ multimodal; geprüfte 77,1% auf ARC-AGI-2 |
| Kostensensibler Durchsatz | GPT-5.6 Luna oder Terra | Luna 80% unter Sol; Terra auf GPT-5.5-Niveau zum halben Preis |
| Lokal / offline allgemein | qwen3.5:9b | 6,6 GB Download, neuestes in Ollama verfügbares Qwen |
| Lokal / offline Coding | qwen2.5-coder:7b | 4,7 GB Download, läuft auf einer 8-GB-Karte |
Wie Sie wählen, ohne 50 Reviews zu lesen
Beginnen Sie bei der Beschränkung. Budget, Datenschutz, Latenz oder Fähigkeit? Wählen Sie das Modell, das Ihre härteste Beschränkung zuerst löst. Ist Datenschutz die Beschränkung, kommt kein Cloud-Flaggschiff infrage und die Frage lautet, welches lokale Modell auf Ihre Karte passt.
Testen Sie zwei Modelle an Ihrer echten Aufgabe. Veröffentlichte Benchmarks sagen Ihren Anwendungsfall nicht vorher, und das gilt heute mehr als vor einem Jahr: Die drei Anbieter berichten über drei verschiedene Evaluationen, es gibt also keine vergleichbare Zahl, nach der sich ordnen ließe. Nutzen Sie kostenlose API-Stufen für die Cloud-Modelle und Ollama für die lokalen.
Prüfen Sie vierteljährlich, nicht monatlich. Alle drei Flaggschiffe erschienen im Juli 2026 binnen etwa zwei Wochen. Genau dieses Muster sollte Ihre Planung leiten: Der Markt bewegt sich in Schüben, und ein vor einem Schub geschriebener Vergleich ist eine ganze Generation veraltet statt nur leicht angestaubt.