Quels GPU AMD valent l'achat pour les LLM locaux ?
- RX 7900 XTX (24 Go GDDR6, 960 Go/s, RDNA 3) : la carte AMD grand public offrant le plus de VRAM et de bande passante. Un modèle 32B en Q4_K_M pèse environ 20 Go : il tient avec de la marge pour le contexte. Présente dans la matrice ROCm 7.2.1 d'AMD et sur la liste ROCm d'Ollama pour Linux et Windows. D'occasion : environ 900–1 250 $.
- RX 9070 XT (16 Go GDDR6, 640 Go/s, RDNA 4) : l'option récente de 16 Go, dans la matrice ROCm 7.2.1 d'AMD et sur la liste ROCm Linux d'Ollama. Exécute confortablement des modèles 14B en Q4–Q6. Neuve : environ 820–930 $.
- Radeon AI PRO R9700 (32 Go GDDR6, 640 Go/s, RDNA 4) : une carte de station de travail avec le plus de VRAM qu'AMD vende dans cette catégorie. Elle gère les modèles 32B en Q4–Q6 ; deux cartes (64 Go) accueillent un modèle 70B en Q4. Prix catalogue AMD : 1 299 $ ; les prix de rue signalés sont plus élevés.
- RX 7900 XT (20 Go GDDR6, 800 Go/s, RDNA 3) : accueille des modèles jusqu'à environ 24–27B en Q4. Ne l'achetez que si elle est nettement moins chère qu'une 7900 XTX d'occasion ; son prix n'a pas été revérifié pour cette mise à jour.
- RX 6800 XT (16 Go GDDR6, 512 Go/s, RDNA 2) : le choix économique, environ 380–410 $ d'occasion. Moins de bande passante signifie une génération plus lente, et la matrice ROCm actuelle d'AMD pour Radeon ne la liste plus : prévoyez la voie ROCm Linux d'Ollama ou Vulkan.
- Mini-PC Ryzen AI Max+ 395 (jusqu'à 128 Go de mémoire unifiée, 256 Go/s) : ce n'est pas une carte graphique, mais un moyen plus économique d'exécuter de très grands modèles mixture-of-experts sur AMD. Les systèmes de 128 Go étaient affichés à environ 3 300–4 350 $ fin septembre 2026 (comparateurs de prix). Voir Meilleurs mini-PC AMD pour LLM locaux.
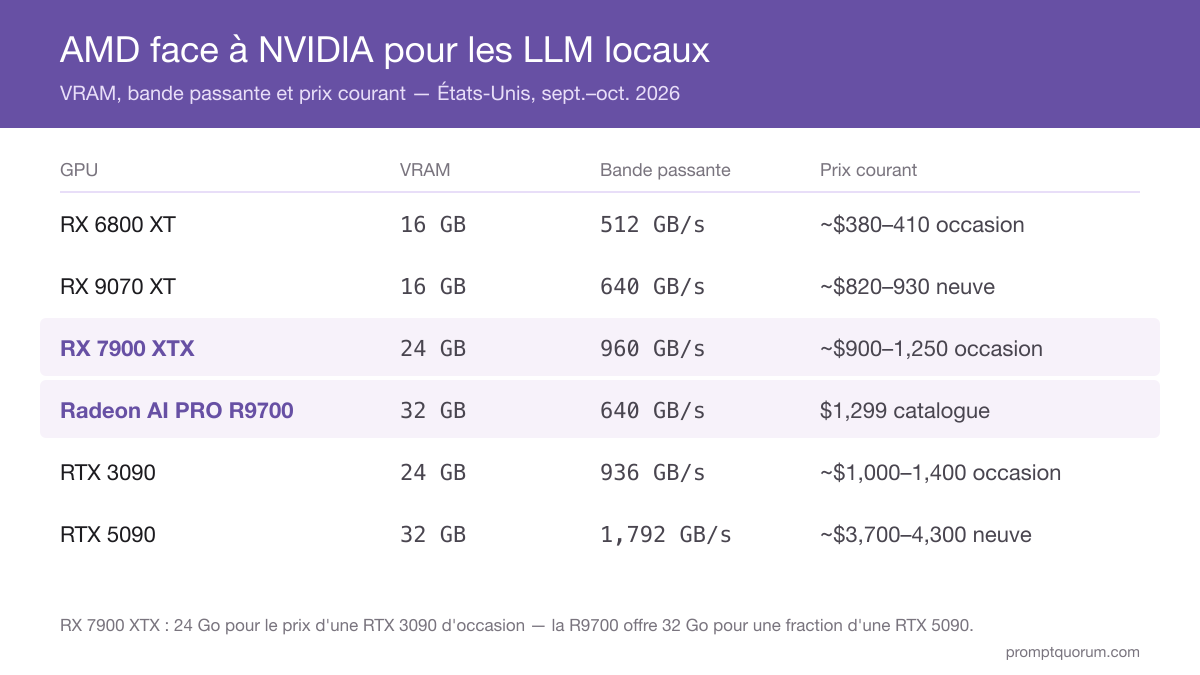
Comment les GPU AMD se comparent-ils à NVIDIA en VRAM et en prix ?
GPU | VRAM | Bande passante | Prix courant | Backend principal |
|---|---|---|---|---|
| RX 6800 XT | 16 Go | 512 Go/s | ~380–410 $ occasion | ROCm (Linux), Vulkan |
| RX 9070 XT | 16 Go | 640 Go/s | ~820–930 $ neuve | ROCm (Linux), Vulkan |
| RX 7900 XT | 20 Go | 800 Go/s | Non revérifié | ROCm, Vulkan |
| RX 7900 XTX | 24 Go | 960 Go/s | ~900–1 250 $ occasion | ROCm, Vulkan |
| Radeon AI PRO R9700 | 32 Go | 640 Go/s | 1 299 $ catalogue ; ~1 400–1 900 $ rue | ROCm (Linux), Vulkan |
| RTX 3090 | 24 Go | 936 Go/s | ~1 000–1 400 $ occasion | CUDA, Vulkan |
| RTX 4090 | 24 Go | 1 008 Go/s | ~2 250 $ occasion | CUDA, Vulkan |
| RTX 5090 | 32 Go | 1 792 Go/s | ~3 700–4 300 $ neuve | CUDA, Vulkan |
La VRAM et la bande passante sont des spécifications constructeur (AMD RX 7900 XTX, RX 9070 XT, Radeon AI PRO R9700). Les prix sont des instantanés de prix demandés aux États-Unis, issus de comparateurs publics et de tests (sept.–oct. 2026), et non des mesures de PromptQuorum ; ils varient en France. Vérifiez les ventes réelles avant d'acheter.

Quelle est la vitesse des GPU AMD face à NVIDIA pour l'inférence LLM ?
La vitesse de génération de tokens dépend davantage de la bande passante mémoire que des TFLOPS, et les meilleures cartes AMD se situent à cet égard près des anciens modèles phares de NVIDIA. La RX 7900 XTX (960 Go/s) est proche de la RTX 3090 (936 Go/s) et en dessous de la RTX 4090 (1 008 Go/s) et de la RTX 5090 (1 792 Go/s).
Le traitement du prompt (prefill) est le point où NVIDIA domine le plus nettement. Dans une comparaison communautaire sous llama.cpp (discussion llama.cpp n° 19890, reprise par des tests tiers), la RTX 5090 était environ 2.6 à 3.4 fois plus rapide que la Radeon AI PRO R9700 au prefill et environ 1.5 fois plus rapide en génération sur le même modèle. Ce sont des données rapportées par des développeurs, pas une mesure de PromptQuorum.
Le choix du backend change les résultats : Vulkan et ROCm (HIP) se disputent la première place selon le modèle, la carte et la version du pilote. llama.cpp peut être compilé avec les deux : testez-les sur votre propre carte avant de vous décider.
En pratique, attendez-vous à ce qu'AMD soit compétitif en vitesse de génération par Go/s de bande passante, plus lent sur les longs prompts et moins abouti côté logiciel.
Quelle difficulté présente l'installation de ROCm en 2026 ?
Vulkan ne demande qu'un pilote graphique ; ROCm exige un GPU, une distribution Linux et un noyau pris en charge. Vérifiez ces points avant d'acheter :
1. Comparez votre carte à la matrice d'AMD. La matrice ROCm 7.2.1 pour Radeon liste la RX 9070 XT, la RX 9060 XT, la RX 7900 XTX, la RX 7900 XT, la RX 7900 GRE, la RX 7800 XT et la Radeon AI PRO R9700 sous Ubuntu 24.04.4, Ubuntu 22.04.5 et RHEL 10.1.
2. Consultez aussi la liste d'Ollama. La documentation d'Ollama ajoute la RX 6800 XT, la 6900 XT et d'autres RX série 6000 pour ROCm sous Linux, et cite la Ryzen AI Max+ 395. Les cartes non listées peuvent essayer `HSA_OVERRIDE_GFX_VERSION` sous Linux ; ce n'est pas pris en charge sous Windows.
3. Installez la pile ROCm v7 avec l'utilitaire `amdgpu-install` d'AMD (Linux). Ollama exige ROCm v7 sous Linux.
4. Vérifiez la détection avec `rocminfo` : votre GPU doit apparaître comme agent (par exemple gfx1100 pour la RX 7900 XTX, gfx1201 pour la RX 9070 XT).
5. Sous Windows, la liste ROCm d'Ollama cite les RX série 7000. Les autres cartes, dont les RX série 9070, ne figurent pas sur cette liste : utilisez le backend Vulkan.
La version la plus récente de ROCm est la 7.14.0 (16 juillet 2026), qui a fait passer ROCm au système de build modulaire TheRock. La page de compatibilité Radeon d'AMD couvrait les versions jusqu'à la 7.2.1 lors de la vérification : comparez votre carte à la matrice de la version que vous installez.
Quels outils de LLM locaux fonctionnent sur GPU AMD ?
Ollama : ROCm v7 sous Linux pour les cartes citées plus haut ; sous Windows, les RX série 7000 via ROCm. Vulkan est activé par défaut quand son backend est installé et se désactive avec `OLLAMA_VULKAN=0`. La version actuelle est la v0.40.10 (23 octobre 2026), qui inclut un build ROCm pour Linux.
llama.cpp : se compile pour AMD avec HIP (ROCm) ou Vulkan (`-DGGML_VULKAN=1`). Les deux backends peuvent être compilés ensemble et choisis par périphérique avec `--device`. La plupart des interfaces s'appuient dessus.
LM Studio : prend en charge les GPU AMD via les runtimes llama.cpp : Vulkan et ROCm. Vulkan est la solution de repli habituelle quand le runtime ROCm ne détecte pas une carte. (Une version précédente de cette page disait que LM Studio était réservé à NVIDIA ; c'est faux.)
vLLM : fournit des builds ROCm (la version ROCm 7.14.0 liste vLLM 0.23.0). Il vise le serving et le traitement par lots ; consultez la documentation de vLLM pour votre cible GPU avant de vous y fier.
Règle pratique : Ollama ou LM Studio pour la simplicité, llama.cpp pour le contrôle, vLLM pour servir plusieurs utilisateurs.

Comment exécuter une inférence LLM quantifiée sur du matériel GPU AMD ?
- 1Adaptez le modèle à votre VRAM. Un fichier Q4_K_M occupe environ 0.6 Go par milliard de paramètres (environ 9 Go pour 14B, 20 Go pour 32B ; estimations). Laissez 2 à 4 Go pour le cache de contexte.
- 2Choisissez un backend. Vulkan est le démarrage le plus rapide (pilote graphique seul). ROCm (HIP) est préférable sur une configuration Linux prise en charge.
- 3Installez un runtime. Sous Linux, installez d'abord ROCm v7 avec `amdgpu-install` pour la voie ROCm, puis Ollama (`curl -fsSL https://ollama.com/install.sh | sh`) ou LM Studio.
- 4Lancez un modèle quantifié. Par exemple `ollama run qwen3:14b`, ou avec llama.cpp `llama-server -m model.gguf -ngl 99` pour décharger toutes les couches sur le GPU.
- 5Vérifiez que le GPU est utilisé. `ollama ps` doit afficher 100% GPU ; `rocm-smi` montre la VRAM utilisée. S'il indique CPU, revérifiez l'installation de ROCm ou passez à Vulkan.
Quand acheter AMD plutôt que NVIDIA pour les LLM locaux ?
Achetez AMD si :
- Vous voulez 32 Go sur une seule carte pour moins cher : la Radeon AI PRO R9700 coûte du tiers à la moitié d'une RTX 5090.
- Vous possédez déjà une Radeon compatible ou voulez une carte aussi performante en jeu.
- Vous utilisez Linux ou vous contentez de Vulkan, et vos outils (Ollama, llama.cpp, LM Studio) prennent déjà AMD en charge.
Achetez NVIDIA si :
- Vous avez besoin d'outils exclusivement CUDA, de piles d'entraînement ou de fine-tuning, ou du traitement de prompts le plus rapide.
- Vous comparez des cartes de 24 Go d'occasion : une RTX 3090 d'occasion coûte à peu près autant qu'une RX 7900 XTX d'occasion, donc la prise en charge de CUDA peut trancher.
- Vous voulez passer le moins de temps possible à configurer.
📍 En une phrase
Achetez AMD si vous voulez 24 à 32 Go de VRAM à un prix inférieur aux cartes NVIDIA les plus récentes ; passez votre chemin si vous dépendez d'outils exclusivement CUDA ou ne voulez aucune configuration.
💬 En termes simples
AMD est une bonne affaire quand c'est la VRAM qui vous manque et que le chemin logiciel (ROCm sous Linux ou Vulkan) vous convient. Si vous débutez avec les LLM locaux et voulez que cela fonctionne tout seul, commencez par NVIDIA.
AMD Instinct ou GPU de datacenter NVIDIA : lequel est meilleur pour les LLM ?
AMD Instinct (MI300X, MI350X) concurrence les GPU de datacenter de NVIDIA et s'achète pour des serveurs, pas pour un bureau. La liste ROCm d'Ollama inclut des cartes Instinct, et ROCm a été conçu autour d'elles : leur prise en charge est donc plus large que celle des Radeon grand public.
Le MI300X embarque 192 Go de mémoire HBM3 par accélérateur (spécification AMD), ce qui convient à de très grands modèles dans un seul boîtier. Pour une machine mono-utilisateur, les Radeon RX ou Radeon AI PRO sont les options AMD pertinentes.
Pour les choix de serveur et de cloud, voir le Guide d'achat de serveurs GPU d'entreprise et le Comparatif de location de GPU cloud.
Quelles sont les erreurs les plus courantes en passant à AMD ?
- Croire que 24 Go suffisent pour des modèles 70B : un modèle 70B en Q4 demande environ 40 Go ou plus, donc une seule carte de 24 Go plafonne vers 30–35B. Prévoyez deux cartes ou une paire de R9700 de 32 Go pour du 70B.
- Acheter une carte que ROCm ne prend pas en charge : vérifiez d'abord la matrice d'AMD et la liste d'Ollama. Les RX série 6000 ne figurent pas dans la matrice Radeon actuelle d'AMD.
- Ignorer Vulkan : si ROCm ne détecte pas votre carte, essayez le backend Vulkan avant de conclure que le GPU est inutilisable.
- Se fier aux prix demandés : les prix des GPU et de la mémoire ont sensiblement bougé en 2026. Comparez les ventes réelles, pas les prix affichés.
Étapes suivantes
- Meilleurs GPU économiques pour LLM locaux — Petit budget ? Les GPU au meilleur rapport qualité-prix pour l'inférence →
- GPU vs CPU vs Apple Silicon — AMD, Apple ou CPU : quelle plateforme convient à votre usage ? →
- De combien de VRAM ai-je besoin ? — Adaptez la VRAM de votre GPU à la taille du modèle →
Comment les lois régionales sur les données influencent-elles le choix AMD ou NVIDIA ?
Le fabricant du GPU ne change pas vos obligations de protection des données ; l'inférence locale, si. L'inférence sur l'appareil garde les prompts et les documents sur votre matériel, ce qui peut réduire l'exposition aux transferts transfrontaliers au titre du RGPD, de l'APPI japonaise et de la PIPL et de la loi sur la sécurité des données chinoises. La conformité exige toujours une base légale, des règles de conservation et des procédures en cas de violation ; pour des données financières, médicales ou juridiques sensibles, consultez les recommandations de la CNIL sur l'IA. Faites réaliser une revue formelle pour les données réglementées.
Les règles de contrôle des exportations peuvent restreindre les accélérateurs haut de gamme d'AMD comme de NVIDIA sur certains marchés. Vérifiez les règles en vigueur dans votre pays avant d'importer ou d'acheter.
Questions fréquentes
Les GPU AMD sont-ils adaptés aux LLM locaux ?
Oui, avec des réserves. Des cartes AMD comme la RX 7900 XTX (24 Go) et la Radeon AI PRO R9700 (32 Go) exécutent des LLM quantifiés via ROCm ou Vulkan dans Ollama, LM Studio et llama.cpp. NVIDIA CUDA offre toujours une prise en charge logicielle plus large et un traitement des prompts plus rapide : AMD convient donc surtout quand la VRAM par dollar compte.
Quelle est la meilleure carte AMD pour l'IA et les LLM locaux ?
La RX 7900 XTX est le meilleur GPU AMD polyvalent pour les LLM locaux : 24 Go de VRAM, 960 Go/s de bande passante et une prise en charge dans la matrice ROCm 7.2.1 d'AMD et dans Ollama. Pour plus de VRAM par carte, la Radeon AI PRO R9700 offre 32 Go ; pour les modèles de 7B à 14B, la RX 9070 XT (16 Go) suffit.
AMD ou NVIDIA pour les LLM locaux : que choisir ?
Choisissez NVIDIA si vous voulez la compatibilité CUDA et le minimum de configuration. Choisissez AMD si vous voulez plus de VRAM par dollar, surtout la R9700 de 32 Go face à la RTX 5090. Une RX 7900 XTX d'occasion coûte à peu près autant qu'une RTX 3090 d'occasion : là, le choix dépend du logiciel.
Ollama fonctionne-t-il avec les GPU AMD ?
Oui. Ollama exige le pilote ROCm v7 sous Linux et liste la RX 9070 XT, la RX 7900 XTX, la RX 6800 XT, la Radeon AI PRO R9700 et d'autres. Sous Windows, sa liste ROCm couvre les RX série 7000, et Vulkan est activé par défaut quand son backend est installé.
LM Studio prend-il en charge les GPU AMD ?
Oui. LM Studio exécute les GPU AMD via les runtimes llama.cpp, Vulkan ou ROCm. Si le runtime ROCm ne détecte pas votre carte, passez le runtime sur Vulkan. Des versions précédentes de cette page indiquaient à tort que LM Studio était réservé à NVIDIA.
Comment exécuter une inférence LLM quantifiée sur du matériel GPU AMD ?
Choisissez un modèle quantifié qui tient dans votre VRAM (Q4_K_M représente environ 0.6 Go par milliard de paramètres), installez Ollama ou LM Studio et utilisez Vulkan ou ROCm. Sous Linux, installez ROCm v7 avec amdgpu-install, lancez le modèle, puis confirmez l'usage du GPU avec ollama ps ou rocm-smi.
RX 9070 XT ou RX 7900 XTX pour les LLM locaux ?
Pour les LLM locaux, la RX 7900 XTX est le meilleur choix : 24 Go accueillent des modèles jusqu'à environ 30–35B en Q4, alors que les 16 Go de la RX 9070 XT plafonnent vers 14B–24B. La RX 9070 XT est plus récente et moins chère : choisissez-la si 16 Go vous suffisent.
Quel est le meilleur GPU AMD à moins de 500 $ ?
La RX 6800 XT (16 Go) à environ 380–410 $ d'occasion est le meilleur GPU AMD à moins de 500 $. Elle exécute des modèles de 7B à 14B en Q4–Q8, mais ne figure pas dans la matrice ROCm Radeon actuelle d'AMD : prévoyez la voie ROCm Linux d'Ollama ou Vulkan.
La Radeon AI PRO R9700 vaut-elle le coup pour l'IA locale ?
Oui, si vous avez besoin de 32 Go sur une seule carte. Son prix catalogue est de 1 299 $ contre environ 3 700–4 300 $ pour une RTX 5090, mais les prix de rue signalés sont plus élevés et le traitement des prompts est plus lent. Deux R9700 donnent 64 Go pour des modèles 70B en Q4.
Faut-il Linux pour AMD ROCm, ou Windows convient-il ?
Linux est la voie ROCm la mieux prise en charge : la matrice d'AMD liste Ubuntu 24.04.4, Ubuntu 22.04.5 et RHEL 10.1. Sous Windows, la liste ROCm d'Ollama couvre les RX série 7000, et les autres cartes utilisent le backend Vulkan.
Quel est le meilleur pour les LLM : AMD Instinct ou les GPU NVIDIA ?
Instinct (MI300X, MI350X) concurrence les GPU de datacenter de NVIDIA et s'achète pour des serveurs ; le MI300X a 192 Go de HBM3. Pour un poste de bureau unique, les Radeon ou Radeon AI PRO sont les options AMD pertinentes, et l'écosystème CUDA de NVIDIA reste plus large.
Quel est le meilleur GPU AMD pour le deep learning et le machine learning ?
Pour l'inférence, la RX 7900 XTX (24 Go) et la Radeon AI PRO R9700 (32 Go) sont les meilleurs choix AMD. ROCm fournit des builds de PyTorch (la version ROCm 7.14.0 liste PyTorch 2.12.0). Pour l'entraînement et le code de recherche qui suppose CUDA, NVIDIA garde l'écosystème le plus large : vérifiez la prise en charge d'AMD par votre framework avant d'acheter.
Un mini-PC Ryzen AI Max+ 395 vaut-il mieux qu'un GPU AMD dédié ?
Cela dépend de la taille du modèle. Les systèmes Ryzen AI Max+ 395 offrent jusqu'à 128 Go de mémoire unifiée mais seulement 256 Go/s de bande passante : ils conviennent aux grands modèles mixture-of-experts, tandis qu'une carte dédiée génère les tokens plus vite sur les modèles qui tiennent dans sa VRAM.
Sources
- Documentation GPU d'Ollama : exigence AMD ROCm v7, cartes Radeon, Radeon AI PRO, Radeon PRO, Ryzen AI et Instinct prises en charge, backend Vulkan
- Versions d'Ollama : v0.40.10, 23 octobre 2026
- AMD ROCm sur Radeon et Ryzen — compatibilité Linux : GPU Radeon et distributions pris en charge par ROCm 7.2.1
- Versions de ROCm : ROCm 7.14.0, 16 juillet 2026, versions des frameworks
- Documentation de build de llama.cpp : backends HIP et Vulkan
- Spécifications produit AMD : RX 7900 XTX, RX 9070 XT, Radeon AI PRO R9700
- Instantanés de prix (États-Unis, sept.–oct. 2026) : comparateurs publics de prix de GPU et tests tiers ; ce sont des prix demandés qui changent vite
- Les GPU AMD offrent de bons débits en tokens par seconde, mais la vitesse seule ne détermine pas la qualité des réponses. Ce que vous demandez au modèle compte autant que sa rapidité : fenêtres de contexte expliquées montre comment structurer de longues requêtes dans les limites de mémoire du GPU.