Points clés
- L'inférence CPU-only fonctionne bien pour les modèles 3–13B sur processeurs modernes avec 8–32 GB RAM.
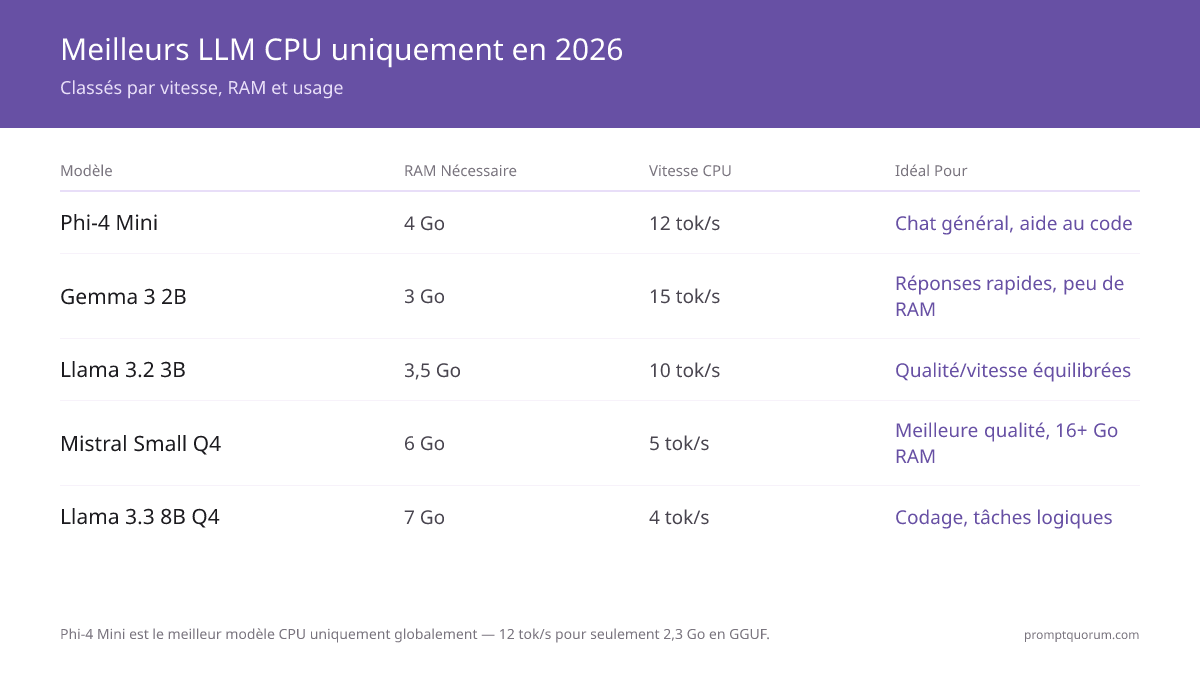
- Meilleurs modèles CPU: Phi-4 Mini (3.8B, 2.3 GB, 12 tokens/sec), Gemma 4 E2B (1.5 GB, 15 tokens/sec), Llama 3.2 3B (2 GB, 10 tokens/sec).
- L'inférence CPU est 10–30× plus lente que GPU mais utilise zéro VRAM dédié.
- Activez le mode CPU-only dans Ollama ou llama.cpp avec un simple flag en ligne de commande.
- L'inférence CPU est idéale pour les APIs production (pas d'overhead GPU), appareils edge, et environnements limités en coût.
📍 En une phrase
Phi-4 Mini (3,8B) tourne à environ 12 tokens/seconde sur un processeur récent avec 2,3 Go de RAM, ce qui en fait le meilleur choix CPU-only pour la discussion générale.
💬 En termes simples
Pas besoin de carte graphique : ces modèles tournent sur la mémoire système. Ils sont 10 à 30 fois plus lents que sur GPU, mais ne consomment aucune VRAM. Pour discuter, prenez Phi-4 Mini ; pour la vitesse, Gemma 4 E2B (1,5 Go) ; pour la qualité, Llama 3.2 3B — via Ollama ou llama.cpp en mode CPU.
Les CPUs Peuvent-Ils Exécuter des LLMs?
Oui, les CPUs modernes (Intel i7-10e gén+, AMD Ryzen 5000+, Apple M-series) peuvent exécuter des modèles 3–13B à 8–15 tokens par seconde. C'est 10–30× plus lent que GPU, mais ne nécessite pas de VRAM dédié. Un CPU avec assez de RAM système (8–32 GB) peut exécuter des modèles qui nécessiteraient un GPU à $300+.
L'inférence CPU échange la vitesse pour l'accessibilité: zéro overhead GPU, stabilité parfaite, aucun problème de pilote. Pour les cas d'usage occasionnels (chatbots répondant à quelques requêtes/seconde, traitement de documents hors ligne), CPU-only est pratique.
Les CPUs modernes ont des instructions vectorielles AVX-512 ou NEON/SVE qui accélèrent les opérations matricielles. Des outils comme llama.cpp et Ollama les utilisent automatiquement, rendant l'inférence CPU beaucoup plus rapide que les implémentations naïves.
Meilleurs Modèles CPU-only 2026
Le tableau ci-dessous classe les modèles par performance sur Intel i7-12700 (12-core, AVX-512) avec mode CPU-only:
Modèle | Paramètres | Taille GGUF | RAM Requise | Vitesse CPU | Meilleur Pour |
|---|---|---|---|---|---|
| Phi-4 Mini | 3.8B | ~2.3 GB | 4 GB | 12 tokens/sec | Chat général, assistance code |
| Gemma 4 E2B | 2B | ~1.5 GB | 3 GB | 15 tokens/sec | Réponses rapides, VRAM faible |
| Llama 3.2 3B | 3B | ~2 GB | 3.5 GB | 10 tokens/sec | Équilibre qualité/vitesse |
| Qwen3 8B | 8B | ~5 GB | 6 GB | 4-5 tokens/sec | Meilleur codage sur CPU, 76% HumanEval |
| DeepSeek-R1 7B | 7B | ~5 GB | 7 GB | 4 tokens/sec | Raisonnement, mathématiques (chaîne de pensée) |

Vitesse: CPU vs GPU
La vitesse varie selon le matériel. Ces benchmarks sont sur matériel standard 2026 exécuté via Ollama ou llama.cpp:
Matériel | Modèle | Vitesse | Notes |
|---|---|---|---|
| Intel i7-12700 (CPU) | Phi-4 Mini 3.8B | 12 tokens/sec | AVX-512 activé |
| AMD Ryzen 7 5700X (CPU) | Phi-4 Mini 3.8B | 9 tokens/sec | Ancien AVX2 seulement |
| Apple M3 (CPU) | Phi-4 Mini 3.8B | 14 tokens/sec | Avantage mémoire unifié |
| RTX 3060 (GPU, 12 GB) | Phi-4 Mini 3.8B | 80 tokens/sec | GPU 6.7× plus rapide |
| RTX 4090 (GPU, 24 GB) | DeepSeek-R1 7B | 120 tokens/sec | GPU 30× plus rapide que CPU |

Exigences RAM par Modèle
Règle d'or: taille GGUF + 500 MB overhead = RAM minimum nécessaire. Un modèle GGUF de 2 GB nécessite 2.5–3 GB de RAM système libre:
Modèle | Taille GGUF | RAM Min | Confortable | Longueur Contexte |
|---|---|---|---|---|
| Gemma 4 E2B | ~1.5 GB | 2–2.5 GB | 4 GB | 128K |
| Phi-4 Mini 3.8B | ~2.3 GB | 3 GB | 6 GB | 4K |
| Llama 3.2 3B | ~2 GB | 2.5–3 GB | 6 GB | 8K |
| Qwen3 8B | ~5 GB | 5 GB | 8 GB | 32K |
| DeepSeek-R1 7B | ~5 GB | 6 GB | 12 GB | 128K |
Comment Exécuter le Mode CPU-only
Ollama (le plus simple): Exécutez simplement `ollama run phi:mini`. Ollama détecte automatiquement CPU-only sur les systèmes sans GPUs NVIDIA/AMD et utilise la RAM système. LM Studio: Ouvrez Paramètres → sélectionnez "Aucun" sous GPU pour forcer le mode CPU. Llama.cpp: Utilisez le flag `--n-gpu-layers 0` pour désactiver l'offloading GPU.
ollama run phi:mini
# Ollama détecte automatiquement les systèmes CPU-only
Conseils d'Optimisation pour l'Inférence CPU
Pour extraire les performances maximales de l'inférence CPU:
- Utilisez quantisation Q4_K_M — réduit taille GGUF de ~70%, perte de qualité minimale, gain de vitesse 10–20% grâce à meilleur comportement du cache.
- Réduisez fenêtre de contexte — contextes plus longs = inférence plus lente. Utilisez `--context 2048` pour limiter le contexte à 2K tokens.
- Activez multi-threading — Ollama et llama.cpp détectent automatiquement le nombre de cœurs CPU. Vérifiez avec `nproc` qu'il correspond.
- Utilisez AVX-512 ou ARM NEON — les CPUs modernes Intel/AMD/ARM ont des instructions vectorielles. Vérifiez les flags CPU: `cat /proc/cpuinfo | grep avx512` (Linux) ou Apple À Propos → Rapport Système (Mac).
- Taille batch = 1 — CPU gère mieux l'inférence mono-séquence. Ne tentez pas multi-batch sur CPU.
- Épinglez threads aux cœurs — sur Linux, utilisez `numactl --cpunodebind=0 ollama run phi:mini` pour éviter l'overhead de changement de cœur.
Quand Utiliser CPU vs GPU
Cas d'usage | CPU | GPU |
|---|---|---|
| Chat temps réel (latence < 1 sec) | ❌ Trop lent (12 tokens/sec = 5 sec pour 60 tokens) | ✅ 80+ tokens/sec |
| Traitement batch (documents, logs) | ✅ Bon (vitesse n'importe pas) | ⚠️ Overkill |
| API production (coût limité) | ✅ $0 coût matériel | ⚠️ $200+ GPU + électricité |
| Appareil edge (Raspberry Pi) | ✅ Pas d'alternative | ❌ Options GPU limitées |
| Développement / tests locaux | ✅ Consommation basse, plus silencieux | ⚠️ Overkill |
| Fine-tuning LLM | ❌ Trop lent (heures → jours) | ✅ 10–30× accélération |
Questions fréquemment posées
À quelle vitesse l'inférence CPU-only est-elle comparée à un GPU?
CPU: 8–15 tokens/sec sur processeurs modernes. GPU (RTX 3060): 80 tokens/sec. GPU (RTX 4090): 120+ tokens/sec. CPU est 10–30× plus lent mais nécessite une investissement GPU de $0.
Quel est le plus petit modèle qui produit des sorties cohérentes sur CPU?
Gemma 4 E2B (1.5 GB) produit des réponses raisonnables. Au-dessous, la qualité baisse. Pour meilleure qualité sur 8 GB RAM, utilisez Phi-4 Mini (3.8B) ou Llama 3.2 3B (2 GB).
Puis-je exécuter un modèle 13B sur CPU?
Oui, avec quantisation Q4_K_M un modèle 13B est ~6.5 GB. Nécessite 8–12 GB RAM système. Vitesse: ~2–3 tokens/sec. Inconfortable pour utilisation interactive mais fonctionne pour traitement batch.
L'inférence CPU utilise-t-elle le GPU du tout?
Non. Mode CPU-only dans Ollama/llama.cpp désactive explicitement l'usage GPU et utilise exclusivement la RAM système.
L'inférence CPU-only est-elle stable?
Oui, plus stable que GPU. Aucun plantage pilote, aucune erreur mémoire GPU. Le seul risque est saturation RAM système, que vous contrôlez par choix de modèle.
Dois-je ajuster les paramètres pour les CPUs Apple Silicon?
Non. Ollama détecte automatiquement M1/M2/M3/M4 et utilise efficacement la mémoire unifiée. Apple Silicon est ~10–20% plus rapide que CPUs Intel équivalents grâce à l'architecture mémoire.
Dois-je me conformer à des réglementations lors de l'utilisation de LLMs CPU-only?
Pour données sensibles (financières, médicales, juridiques), respectez CNIL. L'inférence CPU-only garde toutes les données localement — idéal pour conformité données. Aucune transmission cloud = aucun problème de transfert international de données.
Les modèles CPU-only conviennent-ils aux petites entreprises françaises?
Oui, parfaitement. Aucune investissement GPU, respect des standards IT européens, coûteux pour traitement documents/chatbots clients, et données sensibles restent en interne. Cas d'usage: facturation, analyse contrats, bases de connaissances internes.
Quelle quantité de VRAM un modèle 7B nécessite-t-il en CPU-only?
Zéro VRAM dédié. Un modèle 7B Q4 (~4.5 GB) nécessite 5–6 GB de RAM système pour fonctionner confortablement. C'est le grand avantage: pas de GPU nécessaire.
Puis-je faire du fine-tuning LLM sur CPU?
Techniquement oui, mais impraticable. Le fine-tuning sur CPU est 10–30× plus lent. GPU est fortement recommandé pour fine-tuning. CPU-only convient à l'inférence uniquement (pas d'entraînement).
Comment puis-je optimiser davantage l'inférence CPU sur du vieux matériel?
Utilisez les plus petits modèles (Gemma 4 E2B), quantisation maximale (Q4_K_M), contexte minimal (2K tokens), et réduisez le nombre de threads. Sur Raspberry Pi, dépassez rarement 5 tokens/sec.
Les CPUs peuvent-ils exécuter des LLMs?
Oui. Les CPUs modernes (Intel i7-10e gén+, AMD Ryzen 5000+, Apple M-series) peuvent exécuter des modèles 3–13B à 8–15 tokens par seconde. C'est 10–30× plus lent que GPU, mais ne nécessite pas de VRAM dédié.
Quel est le meilleur LLM CPU-only?
Phi-4 Mini (3.8B, 2.3 GB, 12 tokens/sec) est le meilleur globalement. Pour vitesse: Gemma 4 E2B (1.5 GB, 15 tokens/sec). Pour équilibre: Llama 3.2 3B (2 GB, 10 tokens/sec).
Combien de RAM ai-je besoin pour l'inférence CPU-only?
Utilisez la règle: taille GGUF + 500 MB overhead. Phi-4 Mini (2.3 GB) nécessite 3 GB RAM. Gemma 4 E2B (1.5 GB) nécessite 2 GB RAM. Qwen3 8B (5 GB) nécessite 5 GB RAM.
Comment puis-je activer le mode CPU-only?
Dans Ollama, exécutez simplement: ollama run phi:mini. Ollama détecte automatiquement les systèmes CPU-only. Dans llama.cpp, utilisez --n-gpu-layers 0. Dans LM Studio, réglez GPU à Aucun sous Paramètres.
L'inférence CPU est-elle pratique pour la production?
Oui, si vous n'avez pas besoin de latence temps réel. Traitement batch, APIs asynchrones, et workflows offline fonctionnent très bien sur CPU. Pour chat interactif (latence < 1 seconde), utilisez GPU.
Étapes suivantes
- LLM locaux les plus rapides pour PC bas de gamme — PC ancien ou limité ? Modèles optimisés pour la vitesse →
- Quantification LLM expliquée — Pourquoi Q4_K_M est crucial pour la vitesse CPU →
- Meilleurs LLM locaux pour le code — Meilleurs modèles légers de code sur CPU →