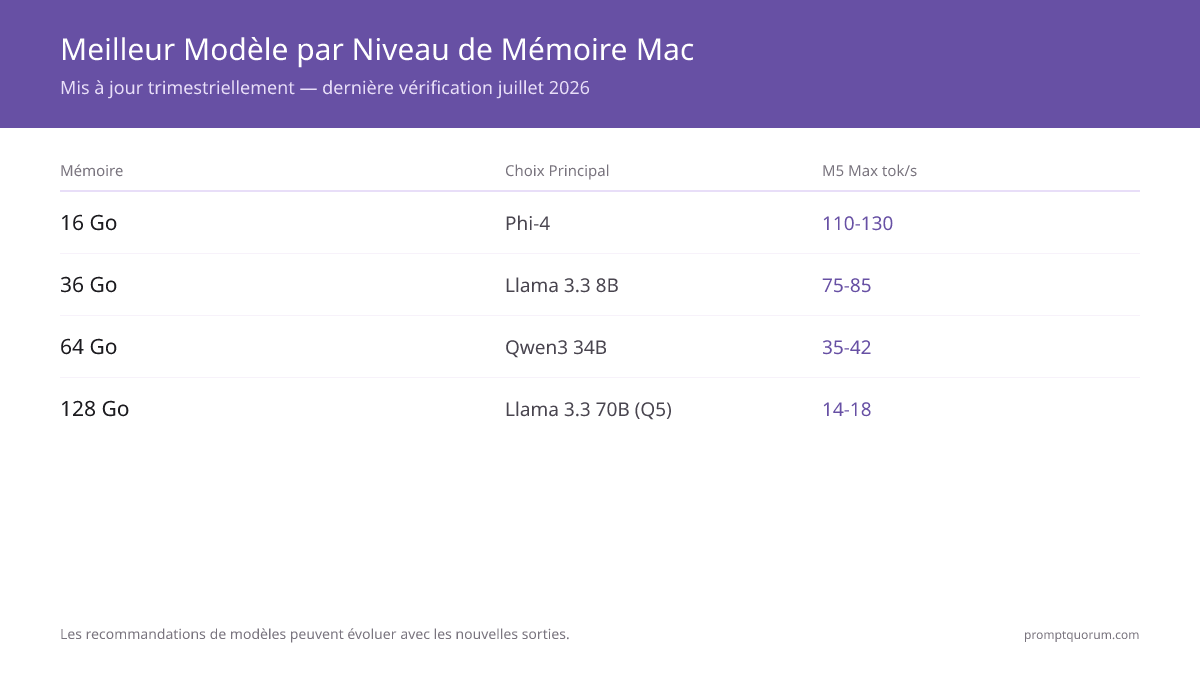
Meilleures recommandations par mémoire Mac
Dernière vérification : 2026-08-27. Mise à jour Apple du 25 août 2026 : le Mac mini est désormais proposé en configurations M6 (32 Go max, à partir de 899 $) et M5 Pro (64 Go max, à partir de 1 699 $) ; le Mac Studio en M5 Max (128 Go max, à partir de 2 499 $) et M5 Ultra (jusqu'à 512 Go, à partir de 5 499 $). Livraison à partir du 22 septembre 2026 (la configuration 512 Go arrive fin octobre 2026). Les recommandations peuvent évoluer avec les nouveaux modèles. Mise à jour trimestrielle.
Mémoire | Choix principal | Quantification | Taille | M5 Pro tok/s | M5 Max tok/s | Alternative |
|---|---|---|---|---|---|---|
| 16 Go | Phi-4 | Q4_K_M | 2,5 Go | 60–70 | 110–130 | Llama 3.1 8B Q4 (juste) |
| 36 Go | Llama 3.1 8B | Q8 | 8,5 Go | 38–45 | 75–85 | Qwen3 14B Q4 (8,5 Go) |
| 48 Go | Qwen3 14B | Q8 | 16 Go | 25–30 | 50–60 | Mixtral 8x7B Q4 (26 Go) |
| 64 Go | Qwen3 32B | Q5 | 24 Go | 18–22 | 35–42 | Mixtral 8x7B Q5 (33 Go) |
| 96 Go | Llama 3.3 70B | Q4 | 42 Go | 10–13 | 20–25 | — |
| 128 Go | Llama 3.3 70B | Q5 | 49 Go | 8–11 | 14–18 | — |
| 128 Go | Llama 3.3 70B | Q8 | 74 Go | N/A | 9–12 | Meilleure qualité, M5 Max uniquement |
Tailles au format GGUF. Les équivalents MLX 4-bit sont comparables. Le palier 36 Go correspond aux configurations de base du MacBook Pro M-Pro/M-Max, et non au Mac mini ou au Mac Studio — depuis la mise à jour d'août 2026, le Mac mini et le Mac Studio passent directement de 32 Go à 64 Go. Les valeurs de tok/s sont des estimations ; PromptQuorum ne les a pas mesurées de façon indépendante.

Benchmarks de qualité des modèles (tests standards 2026)
Modèle | MMLU | HumanEval | GSM8K | Moy. | Notes |
|---|---|---|---|---|---|
| Llama 3.1 8B | 73,0 | 72,6 | 84,5 | 76,7 | Polyvalent solide |
| Qwen3 14B | 79,7 | 83,5 | 90,2 | 84,5 | Raisonnement fort |
| Qwen3 32B | 83,3 | 88,4 | 93,0 | 88,2 | Meilleur taille moyenne |
| Mixtral 8x7B | 70,6 | 40,2 | 60,4 | 57,1 | Architecture MoE |
| Llama 3.3 70B | 86,0 | 80,5 | 95,1 | 87,2 | Meilleur général |
Valeurs indicatives ; consulter la fiche de chaque modèle. PromptQuorum n'a pas exécuté ces benchmarks de façon indépendante.

Meilleurs modèles par cas d'usage (2026)
Cas d'usage | Meilleur pour Mac 36 Go | Meilleur pour Mac 64 Go | Meilleur pour Mac 128 Go |
|---|---|---|---|
| Programmation (général) | Llama 3.1 8B | DeepSeek Coder V2 16B | Llama 3.3 70B |
| Programmation (Python) | DeepSeek Coder V2 Lite | DeepSeek Coder V2 16B | DeepSeek Coder V2 236B |
| Rédaction longue | Llama 3.1 8B Q8 | Qwen3 32B Q5 | Llama 3.3 70B Q5 |
| Chat / conversation | Mistral Small | Mixtral 8x7B | Llama 3.3 70B |
| Raisonnement / maths | Qwen3 14B | Qwen3 32B | Qwen3 32B |
| RAG / Q&R | Llama 3.1 8B + nomic-embed | Llama 3.1 8B + bge-large | Llama 3.3 70B + bge-large |
| Vision / multimodal | LLaVA 7B | Llama 3.2 Vision 11B | Llama 3.2 Vision 90B |
| Traduction | Qwen3 14B | Qwen3 32B | Aya Expanse 32B |
| Résumé | Llama 3.1 8B | Qwen3 32B | Llama 3.3 70B |
| Revue de code | DeepSeek Coder V2 Lite | DeepSeek Coder V2 16B | Llama 3.3 70B |
Les modèles spécialisés surpassent souvent les modèles généraux sur des tâches spécifiques.
Configurations réelles par type d'utilisateur
💡Astuce: Développeur indépendant (Mac Mini M5 Pro 64 Go, env. 1 650 €) - Programmation : DeepSeek Coder V2 Lite (16B Q4, 10 Go) - Rédaction : Llama 3.1 8B Q8 (8,5 Go) pour docs et e-mails - Toujours actif : les deux modèles restent chauds avec `OLLAMA_MAX_LOADED_MODELS=2` - Coût journalier : 0 € (vs 28–90 €/mois pour Copilot + ChatGPT)
💡Astuce: Professionnel soucieux de la confidentialité (MacBook Pro M5 Pro 48 Go, env. 2 400 €) - Principal : Llama 3.1 8B Q8 pour le travail général - Sensible : Qwen3 14B Q5 pour documents juridiques/médicaux/financiers - Voyage : fonctionne hors ligne en avion, dans les installations sécurisées - L'inférence s'exécute en local ; l'application peut tout de même rechercher des mises à jour sauf configuration contraire - Informations générales, pas un conseil juridique, médical ou financier ; la décision revient à une personne qualifiée
💡Astuce: Chercheur / Ingénieur ML (Mac Studio M5 Max 128 Go, env. 2 400 €) - Principal : Llama 3.3 70B Q5 (49 Go) pour la qualité - Spécialisé : Qwen3 32B Q4 pour la recherche non-anglophone - Programmation : DeepSeek Coder V2 16B - Vision : Llama 3.2 Vision 11B pour les figures d'articles - Les quatre modèles chargés simultanément
💡Astuce: Serveur IA familial (Mac Mini M5 Pro 64 Go, toujours allumé) - Assistant vocal : Llama 3.1 8B + Whisper + Piper - RAG : Q&R sur documents familiaux avec embeddings - Aide à la programmation pour les membres de la famille via REST API - Coût électrique : env. 30 €/an - Remplace : ChatGPT Plus pour 4 personnes = env. 960 €/an
Modèles à éviter en 2026 (et pourquoi)
⚠️Attention: Llama 2 (toute taille) n'est plus recommandé — remplacé par Llama 3.3 ; les leaderboards standards montrent des résultats nettement plus faibles par rapport aux versions récentes. Apparaît encore dans d'anciens tutoriels — ne pas les suivre. Remplacer par : Llama 3.1 8B.
⚠️Attention: Éviter Vicuna, Alpaca, WizardLM — Ajustements communautaires de 2023. Les modèles de base modernes (Llama 3.3, Qwen3) égalent ou surpassent leurs performances. Remplacer par : Qwen3 14B ou Llama 3.1 8B.
⚠️Attention: Éviter Falcon 180B — Ne tient pas sur Apple Silicon grand public. Llama 3.3 70B (plus petit) le surpasse. Remplacer par : Llama 3.3 70B Q5.
⚠️Attention: Éviter la quantification FP16 sur matériel grand public — Llama 3.3 70B FP16 = 140 Go, ne tient sur aucun Mac. Le gain de qualité par rapport à Q5 est inférieur à 1%. Remplacer par : Q4_K_M ou Q5_K_M.
⚠️Attention: Éviter les modèles de base purs (sans variante instruct) — Les modèles de base complètent du texte mais ne suivent pas les instructions. Rechercher le suffixe "-instruct" ou "-chat". Remplacer par : la variante instruct du même modèle.
⚠️Attention: Faire preuve de prudence avec les modèles peu développés récemment — StableLM, RedPajama, MPT, Pythia : avec peu d'activité de développement récente (mi-2026). Utiliser des modèles de Meta, Alibaba, Mistral, Microsoft avec des mises à jour régulières.
Référence rapide des formats de modèles
Format | Utilisé par | Taille vs original |
|---|---|---|
| GGUF Q4_K_M | Ollama, llama.cpp | ~30% de FP16 |
| GGUF Q5_K_M | Ollama, llama.cpp | ~35% de FP16 |
| GGUF Q8_0 | Ollama, llama.cpp | ~50% de FP16 |
| MLX 4-bit | Framework MLX | ~30% de FP16 |
| MLX 8-bit | Framework MLX | ~50% de FP16 |
| FP16 (original) | Tous les frameworks | 100% |
Les tailles dans cet article sont GGUF Q4_K_M sauf indication. Les équivalents MLX 4-bit sont similaires. Pour les octets exacts, consulter la fiche modèle sur HuggingFace. llama.cpp exécute directement les fichiers GGUF sur le backend Metal et c'est ce qu'Ollama utilise en interne — MLX est le framework propriétaire d'Apple et tend à être plus rapide pour les builds natifs MLX sur la même puce. LM Studio prend en charge à la fois GGUF et MLX et permet de changer de backend par modèle depuis son interface.
Référence rapide : télécharger ces modèles
# Mac 16 Go
ollama pull phi4

# Mac 36 Go (choisir un)
ollama pull llama3.1:8b
ollama pull qwen3:14b
ollama pull mistral-small

# Mac 64 Go
ollama pull qwen3:32b
ollama pull mixtral:8x7b

# Mac 128 Go
ollama pull llama3.3:70b

# Modèles spécialisés
ollama pull deepseek-coder-v2:16b   # programmation
ollama pull llama3.2-vision:11b     # vision
ollama pull aya-expanse:32b # traductionPuis-je exécuter deux modèles différents simultanément ?
Oui, définir `OLLAMA_MAX_LOADED_MODELS=2` dans l'environnement. 64 Go peut exécuter 8B + 32B simultanément.
Quel modèle convient le mieux aux débutants ?
Llama 3.1 8B. Largement disponible, bonne qualité de sortie, historique éprouvé. Fonctionne sur tout Mac M1+.
Mixtral 8x7B est-il plus rapide que Llama 8B ?
Probablement pas : Mixtral 8x7B est nettement plus volumineux (environ 26 Go en Q4 contre 8.5 Go pour Llama 3.1 8B Q8), donc s'attendre à moins de tok/s que les valeurs de Llama 3.1 8B Q8 du tableau ci-dessus (estimations pour M5 Pro ; non mesurées de façon indépendante par PromptQuorum). Le meilleur choix dépend de la tâche.
Quel est le meilleur LLM local en 2026 ?
Pour la plupart des utilisateurs sur Apple Silicon : Qwen3 (toute taille tenant sur votre Mac) est un choix solide, et Llama 3.3 70B est une autre option solide pour les Mac 128 Go. En dessous de 16 Go : Phi-4 est une option compacte et capable.
Puis-je exécuter Llama 3.1 405B sur un Mac ?
Uniquement avec une très grande mémoire unifiée. Llama 3.1 405B nécessite plus de 200 Go même en quantification Q4. Les configurations Mac Studio de 512 Go antérieures peuvent aussi contenir 405B en Q4 ; le Mac Studio M5 Ultra d'Apple, annoncé le 25 août 2026 (livraison à partir du 22 septembre 2026 ; la configuration 512 Go arrive fin octobre 2026), offre jusqu'à 512 Go de mémoire unifiée à partir de 5 499 $ et ajoute de la marge en bande passante.
Qwen est-il meilleur que Llama pour un usage local ?
Les résultats dépendent de la tâche et de la taille du modèle ; comparer les fiches des modèles pour votre cas d'usage. Llama bénéficie d'un plus large soutien communautaire et plus d'ajustements fins disponibles. La plupart des utilisateurs ne remarqueront pas la différence — choisir selon la disponibilité et l'écosystème d'ajustements.
Quel est le plus petit modèle vraiment utile ?
Phi-4 Mini à 3,8B paramètres. Pour le chat et les Q&R, il est capable pour sa taille. Pour la programmation ou le raisonnement complexe, passer à Llama 3.1 8B ou Qwen3 14B.
vLLM fonctionne-t-il sur Apple Silicon ?
Le support Metal de vLLM est limité comparé à son chemin CUDA — les optimisations de débit et de traitement par lots qui rendent vLLM attractif sur les GPU Nvidia ne s'appliquent en grande partie pas sur Mac. Sur Apple Silicon, Ollama (llama.cpp/Metal) ou LM Studio (GGUF/MLX) offrent de meilleurs tok/s en utilisateur unique et une installation plus simple. N'envisager vLLM que si vous servez de nombreuses requêtes simultanées depuis une machine Linux/Nvidia en complément de votre Mac.
Que peut exécuter un MacBook Air M5 ?
Le MacBook Air M5 est proposé sans ventilateur et dispose généralement de 16 à 32 Go de mémoire unifiée : le considérer comme un Mac de niveau 16 Go ou 36 Go selon le tableau ci-dessus — Phi-4 sans difficulté, Llama 3.1 8B Q8 à partir de 24 Go. Des générations longues et soutenues peuvent légèrement throttler sans ventilateur — s'attendre à la fourchette basse des tok/s M5 Pro indiqués dans cet article.
Quelle est la meilleure configuration pour un MacBook Pro M5 Max avec 128 Go de RAM ?
Llama 3.3 70B Q5 (49 Go) pour un usage quotidien, avec la marge nécessaire pour garder un second modèle chargé simultanément — Qwen3 14B Q5 ou DeepSeek Coder V2 16B — via `OLLAMA_MAX_LOADED_MODELS=2`. Prévoir environ 14–18 tok/s sur 70B Q5. Pour une qualité maximale et si vous tolérez environ 9–12 tok/s, Llama 3.3 70B Q8 (74 Go) tient également en mémoire.