Points clés
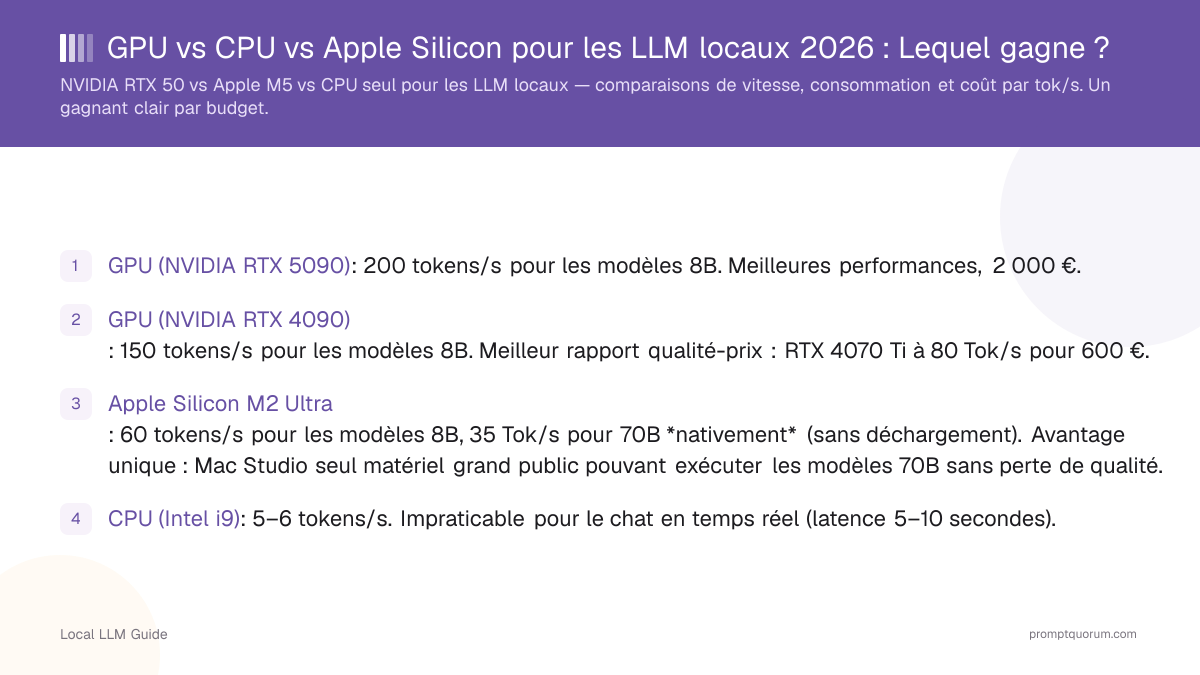
- Apple M5 Pro (64 Go, ~2 399 $) : le meilleur choix polyvalent pour la plupart des utilisateurs. 40–60 tok/s sur les modèles 30B, faible consommation (~25 W en inférence), sans limite de VRAM.
- NVIDIA RTX 5090 (32 Go, 2 000 $) : le plus rapide pour les modèles 7B–14B à 150–200 tok/s. Ne peut pas charger 30B+ sans CPU offloading. Idéal pour les charges de travail en production.
- NVIDIA RTX 5070 (12 Go, ~600 $) : meilleur rapport qualité-prix GPU. 60–80 tok/s sur les modèles 8B. Limité à 7B–8B en pleine précision.
- Apple M5 Max (64–128 Go, ~3 199 $+) : 460–614 Go/s de bande passante. Exécute 30B–70B nativement. Idéal pour les chercheurs et l'usage intensif de 30B+.
- CPU seul (Ryzen/Intel modernes) : 10–20 tok/s sur les modèles 7B avec RAM DDR5 rapide. Utilisable pour un usage occasionnel, peu pratique pour le chat en temps réel.
- Verdict : pour la plupart des utilisateurs, l'Apple M5 Pro 64 Go est le gagnant — des modèles plus grands que n'importe quel GPU seul, un coût moindre qu'une machine GPU dédiée, 10× moins d'énergie. Choisissez la série RTX 50 uniquement pour une vitesse maximale sur 7B–14B ou des charges de production.
📍 En une phrase
Pour les LLM locaux : Apple M5 Pro 64 Go (~2 399 $) est le meilleur polyvalent à 40–60 tok/s sur les modèles 30B ; RTX 5090 32 Go (~2 000 $) est le plus rapide pour 7B–14B (150–200 tok/s) mais impossible pour 30B+ ; RTX 5070 12 Go (~600 $) offre le meilleur rapport qualité/prix GPU ; CPU seul : 10–20 tok/s sur 7B.
💬 En termes simples
Les GPU sont les plus rapides sur les petits modèles (moins de 14B) grâce à leur haute bande passante de calcul. Apple Silicon gagne sur les grands modèles (30B+) en intégrant mémoire et calcul avec une faible consommation. CPU seul est le plus lent mais fonctionne sur n'importe quel ordinateur.
Comparaison des Performances : Vitesse, Bande Passante et Coût
*Nécessite un CPU offloading — pénalité de vitesse significative et dégradation de la qualité à faible précision
Matériel | Qwen3 8B | Qwen3 30B | Consommation | Coût |
|---|---|---|---|---|
| RTX 5090 (GPU, 32 Go GDDR7) | 150–200 tok/s | Impossible* | ~450W | 2 000 $ |
| RTX 5080 (GPU, 16 Go GDDR7) | 100–130 tok/s | Impossible* | ~360W | 1 000 $ |
| RTX 5070 Ti (GPU, 16 Go) | 80–100 tok/s | Impossible* | ~300W | 750 $ |
| RTX 5070 (GPU, 12 Go) | 60–80 tok/s | Impossible* | ~250W | 600 $ |
| MacBook Pro M5 Pro (36–64 Go, 307 Go/s) | 40–60 tok/s | 20–30 tok/s | ~25W | 2 399 $+ |
| MacBook Pro M5 Max (64–128 Go, 460–614 Go/s) | 60–80 tok/s | 35–50 tok/s | ~35W | 3 199 $+ |
| Mac mini M5 base (16–32 Go, 200 Go/s) | 25–35 tok/s | Offload* | ~15W | 599 $+ |
| Intel Core Ultra 9 / AMD Ryzen 9 (CPU, DDR5) | 10–20 tok/s | 3–5 tok/s | ~65W | Inclus |

Quand Choisir un GPU (Série RTX 50)
Choisissez un GPU NVIDIA de la série RTX 50 lorsque vous avez besoin d'une vitesse maximale sur les modèles 7B–14B ou que vous exécutez des charges de production 24/7.
- RTX 5090 (32 Go GDDR7, 1 792 Go/s) : 150–200 tok/s sur les modèles 8B. 2 000 $. Idéal pour les pipelines de production, le fine-tuning et les applications sensibles à la vitesse.
- RTX 5080 (16 Go GDDR7) : 100–130 tok/s sur 8B. 1 000 $. Bon équilibre entre vitesse et coût pour 8B–13B.
- RTX 5070 Ti / 5070 (12–16 Go) : 60–100 tok/s sur 8B. 600–750 $. Meilleur rapport qualité-prix pour le chat et le code en usage individuel.
- Avantage de l'écosystème CUDA : vLLM, llama.cpp et LM Studio sont tous optimisés nativement. Inférence la plus rapide à précision native.
- Limite structurelle : aucune carte de la série RTX 50 ne charge les modèles 30B en pleine qualité (nécessite 20+ Go de VRAM). Le déchargement vers la RAM système crée une pénalité de vitesse de 5–10×.
La consommation d'énergie est le compromis clé : le RTX 5090 consomme 450 W en charge contre 25 W pour le M5 Pro. À 0,35 €/kWh, le RTX 5090 coûte ~55 € de plus par mois en électricité à raison de 8 h/jour.
Quand Choisir Apple Silicon (M5)
Choisissez Apple Silicon M5 lorsque vous devez exécuter des modèles 14B–70B, que vous valorisez l'efficacité énergétique ou que macOS est votre système principal.
- M5 base (16–32 Go, 200 Go/s) : exécute 7B–8B nativement à 25–35 tok/s. À partir de 599 $ (Mac mini). Bon point d'entrée.
- M5 Pro (36–64 Go, 307 Go/s) : exécute jusqu'à 30B nativement à 20–30 tok/s. ~2 399 $ (MacBook Pro). Meilleur rapport qualité-prix polyvalent.
- M5 Max (64–128 Go, 460–614 Go/s) : exécute 30B–70B nativement à 35–50 tok/s. ~3 199 $+. Idéal pour les chercheurs et l'usage intensif de 70B.
- Avantage de la mémoire unifiée : pas de plafond VRAM. Un M5 Pro de 64 Go charge des modèles 30B nativement ; un M5 Max de 128 Go charge des modèles 70B nativement.
- Données Apple : inférence LLM 4× plus rapide que M4 pour la génération M5.
- Framework MLX : le MLX d'Apple est optimisé pour Apple Silicon. Les modèles Qwen3 tournent excellemment sur MLX. DeepSeek-R1 14B offre de bonnes performances.
Compromis : ne peut pas égaler la vitesse brute du RTX 5090 sur 7B. Plus lent pour le fine-tuning. Pas d'outils exclusifs CUDA.
Quand le CPU Seul Suffit
L'inférence uniquement CPU est viable si vous n'avez besoin que de réponses occasionnelles et exécutez de petits modèles (7B Q4).
- Intel Core Ultra 9 / AMD Ryzen 9 modernes avec DDR5-5600 : 10–20 tok/s sur Qwen3 8B ou Llama 3.2 8B. Utilisable pour les tâches par lot non interactives.
- CPU ancien / DDR4 : 5–8 tok/s. Latence notable (5–8 secondes par réponse) qui rend le chat interactif désagréable.
- Aucun coût matériel supplémentaire : si vous possédez déjà un ordinateur de bureau capable, llama.cpp ou Ollama fonctionnent immédiatement.
- Consommation d'énergie : les CPU en pleine charge d'inférence consomment 65–125 W — moins qu'un GPU, plus qu'Apple Silicon.
L'inférence CPU convient pour : le résumé de documents par lot, le traitement nocturne, les questions occasionnelles. Évitez le CPU seul pour le chat en temps réel, les assistants de code ou les modèles de plus de 8B.
Bande Passante Mémoire : Le Vrai Goulot d'Étranglement
L'inférence LLM est limitée par la mémoire, pas par le calcul. La vitesse de génération de tokens est limitée par la rapidité avec laquelle vous pouvez charger les poids du modèle à partir de la mémoire. Bande passante mémoire plus élevée = génération de tokens plus rapide.
La formule : Vitesse d'inférence ≈ Bande passante mémoire ÷ Poids du modèle en mémoire
- Le RTX 5090 avec 1 792 Go/s dispose de la bande passante GPU unique la plus rapide disponible en 2026.
- Le M5 Max avec 460–614 Go/s égale ou dépasse le RTX 5080 en bande passante — avec 128 Go de mémoire unifiée contre 16 Go de VRAM.
- Le M5 Pro avec 307 Go/s est le point idéal : suffisamment de bande passante pour les modèles 30B, à la moitié du coût du M5 Max.
- La RAM DDR5 du CPU à 89 Go/s est 20× plus lente que le RTX 5090 mais 4× plus rapide que la DDR4 — une amélioration notable pour l'inférence CPU.
- Avantage de la mémoire unifiée : pas de frais généraux de transfert CPU↔GPU. Le M5 Pro maintient un modèle 30B entièrement dans son pool de 64 Go.
Plateforme | Bande passante mémoire | Vitesse effective (8B) |
|---|---|---|
| RTX 5090 (GDDR7) | 1 792 Go/s | 150–200 tok/s |
| RTX 5080 (GDDR7) | 960 Go/s | 100–130 tok/s |
| RTX 5070 (GDDR7) | 672 Go/s | 60–80 tok/s |
| M5 Max (unifiée, 128 Go) | 460–614 Go/s | 60–80 tok/s |
| M5 Pro (unifiée, 64 Go) | 307 Go/s | 40–60 tok/s |
| M5 base (unifiée, 32 Go) | 200 Go/s | 25–35 tok/s |
| RAM DDR5-5600 (CPU seul) | 89 Go/s | 10–20 tok/s |
| RAM DDR4-3200 (CPU seul) | 51 Go/s | 5–8 tok/s |
Coût par Tok/s : Analyse Réelle de la Valeur
Le coût par tok/s compare la valeur matérielle : coût initial divisé par la vitesse de tokens soutenue.
Le RTX 5070 a le meilleur coût par tok/s en vitesse pure. Le M5 Pro gagne sur l'énergie : à 0,15 €/kWh pour 8 h/jour, le M5 Pro coûte ~1,10 €/mois contre ~16,50 €/mois pour le RTX 5090.
Si vous possédez déjà un Mac avec M5 Pro, le coût par tok/s est effectivement de 0 € pour la partie matérielle.
Matériel | Coût initial | Tok/s (8B) | Coût par tok/s | Consommation (inférence) |
|---|---|---|---|---|
| RTX 5090 (32 Go) | 2 000 $ | 175 | 11,4 $ | 450W |
| RTX 5070 (12 Go) | 600 $ | 70 | 8,6 $ | 250W |
| M5 Pro MacBook Pro (64 Go) | 2 399 $ | 50 | 48 $ | 25W |
| M5 Max MacBook Pro (128 Go) | 3 199 $ | 70 | 46 $ | 35W |
| CPU (bureau moderne DDR5) | Inclus | 15 | 0 $ | 65W |

Guide de Décision par Plateforme
Cadre de décision basé sur la taille du modèle, le budget et le cas d'usage :
- Choisir RTX 5090 / 5080 : vitesse maximale sur 7B–14B, pipelines de production, fine-tuning, charges serveur 24/7.
- Choisir RTX 5070 / 5070 Ti : meilleur rapport qualité-prix GPU pour le chat et le code en usage individuel sur 7B–13B. 600–750 $.
- Choisir M5 Pro (64 Go) : meilleur choix polyvalent pour la plupart des utilisateurs. Exécute 30B nativement, faible consommation, workflow macOS. ~2 399 $.
- Choisir M5 Max (128 Go) : usage recherche, modèles 70B nativement, performance maximale Apple Silicon. ~3 199 $+.
- CPU seul : aucun investissement supplémentaire, usage occasionnel de 7B, traitement par lot nocturne.

Erreurs Courantes dans le Choix du Matériel
- Choisir un GPU pour des modèles 30B+. Aucune carte de la série RTX 50 ne charge 30B en VRAM. Le déchargement vers la RAM crée une pénalité de vitesse de 5–10×. Utilisez plutôt M5 Pro ou M5 Max.
- Supposer que le M5 base (16 Go) suffit. Il ne charge que 7B. Pour les modèles 14B, il faut 32 Go ; pour 30B, il faut 64 Go (M5 Pro).
- Ignorer le coût énergétique des serveurs GPU toujours allumés. Le RTX 5090 à 8 h/jour équivaut à ~200 $/an d'électricité à 0,15 $/kWh. Le M5 Pro : ~14 $/an.
- Acheter un RTX 5090 pour du chat en 8B. Le RTX 5070 à 600 $ offre 70 tok/s en 8B — 80 % de la vitesse pour 30 % du coût.
- S'attendre à ce que le CPU soit viable pour le chat en temps réel. Même 20 tok/s semble lent. 5–8 tok/s sur DDR4 est inutilisable pour un usage interactif.
Questions Fréquemment Posées
Le GPU ou le CPU est-il meilleur pour exécuter les LLM locaux ?
Pour l'inférence en temps réel, le GPU NVIDIA est plus rapide : le RTX 5070 exécute les modèles 8B à 60–80 tok/s contre 10–20 tok/s sur un CPU moderne avec DDR5. L'Apple M5 Pro à 40–60 tok/s surpasse également le CPU et ajoute la capacité d'exécuter des modèles 30B nativement.
Apple Silicon peut-il exécuter les LLM locaux ?
Oui. La série Apple M5 exécute les modèles 7B à 25–80 tok/s selon la classe de puce. Le M5 Pro (64 Go) exécute des modèles 30B nativement à 20–30 tok/s — chose qu'aucun GPU grand public ne peut égaler. Le M5 Max (128 Go) exécute des modèles 70B nativement à 35–50 tok/s.
Quelle est la VRAM GPU minimale pour les LLM locaux ?
12 Go de VRAM (RTX 5070) exécutent les modèles 7B–8B en quantification Q4–Q8 sans problème. 16 Go (RTX 5080) gèrent les modèles 13B. Aucun GPU grand public seul ne charge 30B entièrement — utilisez plutôt l'Apple M5 Pro 64 Go.
Combien de fois le GPU est-il plus rapide que le CPU pour l'inférence LLM ?
Le RTX 5090 est 8–15× plus rapide qu'un CPU moderne avec DDR5 pour les modèles 8B (175 tok/s contre 15 tok/s). L'écart vient de la bande passante mémoire : 1 792 Go/s (GDDR7) contre 89 Go/s (DDR5). L'Apple M5 Pro avec 307 Go/s se situe entre les deux, à 40–60 tok/s.
Vaut-il la peine d'acheter un GPU juste pour les LLM locaux ?
Le RTX 5070 (600 $) amorti sur 3 ans coûte moins cher que les frais d'API OpenAI pour les utilisateurs intensifs à 2+ heures par jour. À 70 tok/s, il gère le chat en temps réel et l'assistance au code. Si vous avez besoin de modèles 30B+, le M5 Pro offre plus de valeur malgré un coût initial plus élevé.
Qu'est-ce que la bande passante mémoire et pourquoi est-ce important pour les LLM ?
L'inférence LLM est limitée par la mémoire. Vitesse de tokens ≈ bande passante mémoire ÷ poids du modèle. RTX 5090 : 1 792 Go/s. M5 Max : 460–614 Go/s. M5 Pro : 307 Go/s. CPU DDR5 : 89 Go/s. C'est pourquoi Apple Silicon avec mémoire unifiée peut exécuter de grands modèles efficacement malgré une bande passante brute inférieure aux meilleurs GPU.
Quel chip Apple Silicon est le meilleur pour les LLM locaux en 2026 ?
Le M5 Pro (64 Go, 307 Go/s) est le meilleur choix polyvalent pour la plupart — exécute des modèles 30B nativement à 20–30 tok/s pour ~2 399 $. Le M5 Max (128 Go, 460–614 Go/s) pour les modèles 70B à 35–50 tok/s (~3 199 $+). Évitez le M5 base (16 Go) pour tout ce qui dépasse 7B.
Apple Silicon peut-il exécuter des modèles 30B et 70B ?
Le M5 Pro (64 Go) exécute des modèles 30B nativement à 20–30 tok/s. Le M5 Max (128 Go) exécute des modèles 70B nativement à 35–50 tok/s. Ce sont des chiffres de débit réels sans CPU offloading — aucun GPU grand public ne peut égaler cela pour 30B+.
Le RTX 5090 à 2 000 $ vaut-il la peine pour les LLM locaux ?
Seulement si votre workflow nécessite des modèles 7B–14B à vitesse maximale ou des pipelines d'inférence en production. Pour la plupart, le RTX 5070 (600 $) offre 80 % de la vitesse pour 30 % du coût. Pour les modèles 30B+, le M5 Pro est le meilleur choix quel que soit le budget.
Comment la consommation d'énergie se compare-t-elle entre GPU et Apple Silicon ?
Le RTX 5090 consomme ~450 W en charge d'inférence. Le M5 Pro consomme ~25 W. À 8 h/jour et 0,15 $/kWh, cela équivaut à 200 $/an (RTX 5090) contre 14 $/an (M5 Pro). Pour les particuliers et ceux payant des tarifs d'électricité commerciaux, l'efficacité énergétique du M5 Pro représente un avantage de coût notable.
Quelle est la vitesse d'inférence LLM sur un MacBook Pro Intel (i9, 16 Go de RAM) ?
Plus lente qu'Apple Silicon et plus lente qu'un ordinateur de bureau moderne équipé de DDR5. Les MacBook Pro Intel n'ont pas de chemin GPU à mémoire unifiée pour llama.cpp — l'inférence s'exécute uniquement sur le CPU via DDR4, qui offre environ 38–45 Go/s de bande passante double canal contre 89 Go/s pour un CPU de bureau DDR5 moderne. En utilisant la formule bande passante mémoire ÷ taille du modèle mentionnée plus haut, un modèle quantifié 7B (~4,5 Go en Q4) atteint environ 8–10 Tok/s théoriques, 4–7 Tok/s réalistes une fois la surcharge de calcul du CPU prise en compte. Les 16 Go de RAM totale vous limitent également à environ 7B–8B en Q4 avec de la marge pour le système — n'attendez pas de faire tourner des modèles 13B+ sans swap important et une forte pénalité de vitesse.
Quelle est la différence entre pp tok/s et tg tok/s ?
pp tok/s (traitement du prompt) mesure la vitesse à laquelle le modèle ingère votre prompt d'entrée — la phase de "prefill", limitée par le calcul et qui s'adapte bien au matériel parallèle comme les GPU. tg tok/s (génération de tokens) mesure la vitesse à laquelle il génère chaque nouveau token de sortie — la phase de "decode", limitée par la bande passante mémoire (voir la formule de bande passante ci-dessus). Les GPU présentent généralement un grand écart pp/tg (prefill rapide, génération limitée par la bande passante) ; la mémoire unifiée d'Apple Silicon maintient les deux chiffres plus proches. Lorsque vous comparez des benchmarks, vérifiez toujours quel chiffre vous lisez — pp et tg peuvent différer de 5 à 20x sur le même matériel.
Sources
- Spécifications GPU NVIDIA — Spécifications GPU série RTX 50, VRAM, bande passante mémoire.
- Performance Apple M3 — Architecture mémoire unifiée M5 Max et performances d'inférence.
- Benchmarks vLLM — Benchmarks de débit d'inférence LLM production.
- Un matériel différent produit des taux de tokens différents, mais toute inférence bénéficie de prompts structurés. Les requêtes à contexte long nécessitent des techniques différentes des courtes : fenêtres de contexte expliquées couvre des stratégies pour tout matériel.