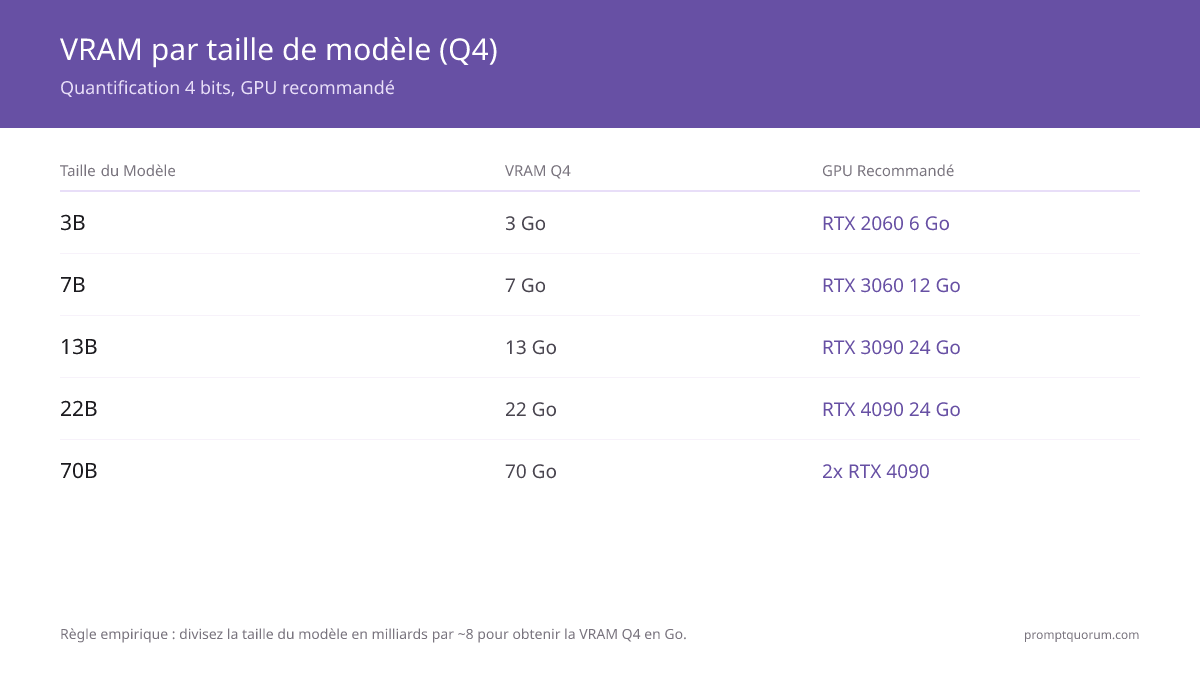
Quelle est la formule VRAM pour les LLMs?
La formule VRAM (les chiffres Q4 correspondent à trois tailles réelles de fichiers GGUF ; les autres niveaux sont des estimations calculées) :
VRAM (GB) = Paramètres en milliards × Octets par paramètre
Octets par paramètre par niveau de quantification (d'après des tailles de fichiers GGUF réelles -- les formats réels comme Q4_K_M ont une légère surcharge au-dessus du minimum théorique) :
- FP32 : 4,0 octets (précision complète)
- Q8 : ~1,05 octet (8 bits)
- Q5 : ~0,7 octet (5 bits)
- Q4 : ~0,6 octet (4 bits)
Exemples :
Llama 3.3 70B en FP32 :
70 × 4,0 octets = 280 GB -- impraticable.
Llama 3.3 70B en Q4 :
70 × 0,6 octet = 42 GB de poids (le GGUF Q4_K_M réel de Llama-3.3-70B-Instruct pèse 42,52 GB)
+ ~2 GB de surcharge (cache KV + runtime) = ~44 GB au total.
Entre dans deux RTX 4090 (48 GB combinés).
Un modèle 7B en Q4 :
7 × 0,6 octet = 4,2 GB de poids (Llama-2-7B Q4_K_M réel = 4,08 GB)
+ ~1-2 GB de surcharge = ~5-6 GB au total.
Entre dans n'importe quelle GPU 8 GB avec marge.
En une phrase : VRAM = Paramètres en milliards × octets par paramètre (≈0,6 pour Q4) + 1-2 GB de surcharge pour le cache KV et le runtime.
Combien de VRAM chaque taille de modèle nécessite-t-elle?
Taille du modèle | FP32 | Q8 | Q5 | Q4 | GPU recommandé |
|---|---|---|---|---|---|
| 3B | 12 GB | 3 GB | 2 GB | 2 GB | RTX 3050 4GB ou RTX 2060 6GB |
| 7B | 28 GB | 7 GB | 5 GB | 4 GB | RTX 4060 8GB ou RTX 3060 12GB |
| 13B | 52 GB | 14 GB | 9 GB | 8 GB | RTX 3060 12GB ou RTX 4070 12GB |
| 22B | 88 GB | 23 GB | 15 GB | 13 GB | RTX 4080 16GB ou RTX 4090 24GB |
| 70B | 280 GB | 74 GB | 50 GB | 42 GB | 2× RTX 4090 (24GB chacune), ou 1× H100 80GB |
| Qwen 3.6 35B-A3B (3B actif / 35B total, MoE)* | ~140 GB | ~37 GB | ~25 GB | ~21 GB | RTX 5090 32GB, ou RTX 4090/3090 24GB (juste ; Q4) |
| DeepSeek-V4.1-Flash-1017 (763B total, MoE)* | ~3,1 TB | ~800 GB | ~530 GB | ~460 GB | Serveur multi-GPU ou 512 GB de mémoire unifiée (Q4 uniquement) |
| Llama 4 Scout (17B actif / 109B total, MoE)† | 436 GB | 114 GB | 76 GB | 55 GB | 2× RTX 4090 (48 GB) — entre dans 24 GB seulement en 1,78-bit (indicatif, non mesuré par PromptQuorum) |
| gpt-oss:20b (3,6B actif / 21B total, MoE)* | 84 GB | 22 GB | 15 GB | 12 GB | RTX 5070 12GB ou n'importe quelle GPU 16 GB |
| Kimi K2.6 (32B actif / 1T total, MoE)* | ~4 TB | ~1 TB | ~700 GB | ~600 GB | Serveur multi-GPU (~600 GB en Q4) |
Les chiffres sont des tailles de poids bruts ; les autres niveaux de quantification et les lignes MoE sont des estimations calculées, tandis que les chiffres Q4 correspondent à trois tailles réelles de fichiers GGUF sur Hugging Face (ex. Llama-2-7B Q4_K_M = 4,08 GB, Mistral-Small-24B Q4_K_M = 14,33 GB, Llama-3.3-70B Q4_K_M = 42,52 GB) -- ajoutez 1-2 GB de marge pour le contexte/cache KV. * Lignes MoE : calculées à partir des paramètres totaux (environ 0,6 GB par milliard en Q4) : tous les experts restent résidents en mémoire et les paramètres actifs n'influencent que la vitesse. Chiffres approximatifs. † Llama 4 Scout garde ses 109B paramètres résidents, donc il nécessite ~55 GB en Q4 malgré seulement 17B actifs par token. Sources: Llama-2-7B GGUF, Mistral-Small-24B GGUF, Llama-3.3-70B GGUF.
Comment la quantification réduit-elle les exigences VRAM?
La quantification réduit le nombre de bits nécessaires pour représenter chaque paramètre du modèle.
- FP32 (float 32-bit): Précision complète. 1 paramètre = 4 bytes. Aucune perte. Plus lent.
- Q8 (8-bit): 1 paramètre = 1 byte. Généralement quasi sans perte. 75% économies VRAM.
- Q5 (5-bit): 1 paramètre = 0,625 bytes. Généralement une petite perte de qualité. 84% économies VRAM.
- Q4 (4-bit): 1 paramètre = 0,5 bytes. Généralement une perte de qualité modérée, variable selon le modèle et la tâche. 87,5% économies VRAM.
Pour la plupart des utilisateurs, Q4 est le juste équilibre: perte de précision généralement modérée, empreinte VRAM 87% plus petite.
En avril 2026, Q4 est standard. Q5 et Q8 sont disponibles si vous avez du VRAM supplémentaire et désirez des gains de qualité marginaux.
En termes simples: La quantification ressemble à prendre une photo haute résolution et la réduire en résolution inférieure -- vous perdez quelques détails, mais la taille du fichier diminue considérablement. La quantification Q4 rétrécit VRAM de 87% tout en conservant, dans la plupart des cas, l'essentiel de la qualité.
💡 Conseil Pro: Q4 est le juste équilibre pour l'inférence locale des LLM. Tout ce qui est inférieur à Q4 (comme Q2 ou Q3) commence à dégrader notablement la qualité du modèle. Au-delà (Q5+), le gain de qualité est généralement faible pour une VRAM nettement supérieure.
La VRAM détermine la taille du modèle, mais la conception du prompt détermine la qualité des sorties. Les techniques comme la chain-of-thought et le few-shot prompting peuvent combler l'écart de qualité entre les modèles plus petits et plus grands. Explorez la boîte à outils complète de prompt engineering pour tirer le meilleur parti des modèles que votre matériel prend en charge. Si vous disposez de 12–16 Go de VRAM et cherchez un cas concret pour tester cette boîte à outils, Remplacer GitHub Copilot par un LLM local projette la stack Continue.dev + Ollama + Qwen3-Coder sur ces paliers de VRAM exacts.

Et la taille de lot et l'inférence multi-utilisateurs?
La taille de lot affecte le débit (tokens par seconde), pas la latence d'une seule inférence.
Un utilisateur unique demandant "Qu'est-ce que 2+2?" utilise le même VRAM que la taille du lot soit 1 ou 32.
Taille de lot = 32 signifie traiter 32 prompts en parallèle. Les poids sont partagés : la VRAM augmente surtout via le cache KV (un par requête, selon la longueur du contexte), pas de 32× ; l'augmentation exacte varie selon le runtime, le modèle et le contexte.
Pour un utilisateur unique (utilisation typique des LLM locaux): Taille de lot = 1. VRAM est taille du modèle + 1-2 GB surcharge.
Pour un serveur multi-utilisateurs : réservez les poids du modèle une seule fois, plus un cache KV par requête simultanée. Un modèle 70B en Q4 (environ 42 GB de poids) servant 4 utilisateurs nécessite généralement les poids plus un cache KV par requête (souvent quelques GB chacun avec un contexte modéré, davantage avec un contexte long), pas 4 fois les poids.
⚠️ Malentendu critique: La taille du lot n'affecte PAS les exigences VRAM des utilisateurs uniques. Si vous exécutez un LLM local seul, augmenter la taille du lot gaspille du VRAM sans avantage.
Avez-vous besoin de plus de VRAM que la taille du modèle?
Oui. Au-delà des poids du modèle, ajoutez:
- KV cache (cache clé-valeur pour le contexte): ~5-10% VRAM supplémentaire.
- État optimiseur (si fine-tuning): 2-4× taille du modèle (pertinent uniquement pour l'entraînement, pas l'inférence).
- Surcharge système (OS, drivers, Ollama/LM Studio runtime): ~1-2 GB.
Règle: Un modèle 70B Q4 (42 GB) + KV cache (3 GB) + système (2 GB) = ~47 GB alloué. Nécessite 2× RTX 4090 (48 GB combiné) ou A100 80GB.
Achetez toujours des GPU avec au moins 1-2 GB de marge au-dessus des minimums théoriques.
⚠️ Risque de marge: Les fenêtres de contexte longues (32K tokens) peuvent gonfler la surcharge KV cache à 8+ GB sur un modèle 70B. Un modèle 70B utilisant ~42 GB sur une GPU 48 GB (2× RTX 4090) laisse seulement 6 GB pour KV cache. Avec une conversation de 32K tokens, le modèle manque de VRAM à mi-conversation, causant des crashes. Réduisez soit la longueur max du contexte, soit achetez une GPU plus grande.
Quelles sont les erreurs VRAM les plus courantes?
- Plus de VRAM = inférence plus rapide. Faux. La taille VRAM n'affecte pas la vitesse. La bande passante mémoire (GB/sec) le fait, et c'est fixe par GPU.
- Taille de lot = limite de token séquentielle. Faux. Taille de lot = requêtes parallèles. L'inférence unique utilise batch=1 indépendamment de la taille VRAM.
- Le modèle 70B nécessite 24 GB VRAM. Faux. 70B en Q4 nécessite ~42 GB. Une seule RTX 4090 (24 GB) ne peut pas exécuter de modèle 70B à n'importe quelle quantification. Q8 nécessite ~74 GB. Calculez toujours: paramètres (milliards) × octets/paramètre (≈0,6 pour Q4) plus 1-2 GB de marge.
- Ne pas compter la croissance du KV cache avec les contextes longs: Un modèle 70B en Q4 nécessite ~42 GB pour les poids. Une fenêtre de contexte 32K ajoute ~3-8 GB supplémentaires selon le mécanisme d'attention. Sur une seule GPU 24 GB, cela ne rentre pas et cause des erreurs OOM. Réduisez soit la longueur du contexte, soit utilisez une GPU avec plus de marge VRAM.
- Confondre RAM système avec VRAM GPU: Quand les gens disent "J'ai 32 GB de RAM", ils signifient généralement RAM système (mémoire CPU). VRAM est la mémoire dédiée sur la GPU. Ce sont des pools séparés. Une machine avec 32 GB RAM système et une GPU 8 GB peut exécuter un modèle 7B sur GPU, mais ne peut pas exécuter un modèle 13B sur GPU -- elle retomberait sur inférence CPU à 5-15 tok/sec.
Contexte régional
UE / RGPD
Les organisations de l'UE traitant des données localement ont intérêt à s'assurer que leur matériel dispose de suffisamment de VRAM pour exécuter le modèle requis entièrement sur l'appareil -- le basculement CPU partiel n'envoie aucune donnée en externe, mais réduit dramatiquement la vitesse d'inférence, le rendant impraticable pour utilisation en production. Pour les équipes d'entreprise de l'UE exécutant le traitement de documents ou l'extraction de données localement sous le RGPD, une RTX 4090 (24 GB) pour les modèles 13-30B, ou deux RTX 4090 (48 GB combiné) pour les modèles 70B, est un point de départ indicatif pour le matériel. La conformité au RGPD dépend de l'ensemble de votre traitement (base légale, mesures techniques et organisationnelles, éventuelle analyse d'impact), pas seulement du lieu d'exécution du modèle ; consultez votre DPO ou un conseil juridique. Information générale, pas un conseil juridique.
Japon (METI)
Les exigences de documentation de gouvernance METI bénéficient d'une configuration de matériel définie et stable. Documenter le modèle GPU, la capacité VRAM et le niveau de quantification du modèle crée un record d'environnement d'inférence complet. Certaines équipes d'entreprise standardisent sur une seule SKU GPU par déploiement (ex: RTX 4090 pour serveurs d'inférence d'équipe) pour simplifier la documentation de gouvernance.
Chine
Pour déployer localement un modèle de classe 70B (environ 42 GB en Q4), par exemple dans le cadre de la Loi sur la sécurité des données de Chine (数据安全法), il faut 40+ GB de VRAM -- un serveur dual RTX 4090 (48 GB combiné) est une configuration grand public courante ; la conformité légale dépend de l'ensemble de votre traitement. Qwen3 32B (20 GB en Q4) est déployable sur une seule RTX 4090 avec marge pour surcharge de contexte et est la configuration recommandée pour les équipes sans budget pour configurations GPU double.
Calculatrice VRAM
Sélectionnez la taille de votre modèle et la quantification pour estimer les exigences VRAM.
Modèles populaires
Modèle de base
6.50 GB
Surcharge contexte
1.50 GB
Surcharge lot
0.00 GB
Surcharge système
1.00 GB
VRAM minimum
9.00 GB
Recommandé (avec marge de sécurité 25 %)
11.25 GB
👉 Choisissez un GPU avec au moins 11.25 GB VRAM
GPU compatibles
RTX 3060 (12 GB)
0.8 Go de marge
RTX 4060 Ti (16 GB)
4.8 Go de marge
RTX 4070 Ti Super (16 GB)
4.8 Go de marge
RTX 4080 Super (16 GB)
4.8 Go de marge
RTX 4090 (24 GB)
12.8 Go de marge
RTX 5090 (32 GB)
20.8 Go de marge
Mac Mini M6 (32 GB) (−8 GB macOS = 24 GB)
12.8 Go de marge
Mac Mini M5 Pro (64 GB) (−8 GB macOS = 56 GB)
44.8 Go de marge
Mac Studio M5 Max (128 GB) (−8 GB macOS = 120 GB)
108.8 Go de marge
Mac Studio M5 Ultra (96 GB+) (−8 GB macOS = 88 GB)
76.8 Go de marge
💡 Conseils pratiques :
- Achetez toujours en vous basant sur la valeur "avec marge de sécurité"
- Q4 offre 90-95 % de qualité avec 25 % de réduction de taille. Q5 est préférable si vous avez de la marge
- La surcharge de contexte augmente avec la longueur des conversations. Prévoyez 1-3 Go pour un usage typique
- La taille du lot compte pour les API multi-utilisateurs. Le chat mono-utilisateur peut ignorer la surcharge de lot
📋 Partager cette configuration :
Questions fréquemment posées
Puis-je exécuter Mistral Small sur une GPU 6 GB?
Non. Mistral Small est un modèle de 22-24B -- même en Q4 il nécessite environ 13-14 GB de VRAM pour les poids seuls. Une GPU de 6 GB ou 8 GB fera une erreur OOM. Prévoyez 16 GB pour une marge confortable, ou descendez à un modèle 7B-8B pour une carte 6-8 GB.
Combien de VRAM ai-je besoin pour fine-tuner un modèle 7B?
Pour LoRA: 12-16 GB. Fine-tuning complet: 28 GB+. Le fine-tuning nécessite l'état optimiseur (2-4× VRAM du modèle), pas seulement l'inférence.
Est-ce que 12 GB est suffisant pour un modèle 13B?
Oui, largement. Un modèle 13B nécessite environ 8 GB en Q4, donc 12 GB laisse une vraie marge. En Q5 (~9 GB) c'est encore confortable ; en Q8 (~14 GB) c'est juste.
Ai-je besoin de 24 GB pour un modèle 70B?
Non, mais presque -- un modèle 70B nécessite environ 42 GB à Q4 pour les poids seuls. À Q5+, il faut 50 GB+. 24 GB ne suffit pas pour un modèle 70B en Q4 ou au-dessus ; les quantifications inférieures à 4 bits tiennent avec une perte de qualité.
L'augmentation de la taille du lot réduit-elle VRAM pour l'inférence unique?
Non. L'inférence unique utilise toujours VRAM batch=1. La taille du lot n'aide que le débit (scénarios multi-utilisateurs).
Quelle est la meilleure quantification pour la précision?
Q8 est généralement quasi sans perte ; Q5 et Q4 perdent un peu plus de qualité, selon le modèle et la tâche. Pour la plupart, Q4 est le juste équilibre.
Puis-je décharger une partie du VRAM sur RAM CPU?
Oui, via un déchargement partiel des couches vers la RAM système. Llama.cpp et Ollama le supportent. Les performances peuvent chuter nettement (souvent de 30-50% ou plus, selon le nombre de couches en RAM) mais ça marche.
Quel est le minimum VRAM pour exécuter un LLM local?
4 GB VRAM avec un modèle 3B à quantification Q4 -- le modèle utilise ~1,8 GB, laisse de la marge pour KV cache et runtime. Le minimum pratique pour des résultats utiles est 8 GB VRAM avec un modèle 7B à Q4. Sous 6 GB, la sélection de modèle est sévèrement limitée et la plupart des modèles 7B causent des erreurs OOM.
Le VRAM Apple Silicon fonctionne-t-il de la même manière que le VRAM GPU pour les LLMs?
Apple Silicon utilise une mémoire unifiée partagée entre CPU et GPU -- la mémoire unifiée n'est que partiellement utilisable comme mémoire GPU ; macOS en réserve une partie. Un MacBook Pro M3 avec 18 GB de mémoire unifiée peut exécuter un modèle 13B à Q4 (~7 GB) avec marge pour KV cache et surcharge OS. Cela équivaut à 18 GB VRAM GPU sur une GPU discrète.
Combien de VRAM un modèle 7B nécessite-t-il à différents niveaux de quantification?
7B en FP32: ~28 GB -- impraticable sur GPU grand public. 7B en Q8: ~7 GB -- rentre sur RTX 4070 Ti 12 GB avec marge. 7B en Q5: ~4,5 GB -- rentre sur n'importe quelle GPU 8 GB. 7B en Q4: ~3,5 GB modèle + ~1,5 GB surcharge = ~5 GB total -- rentre sur n'importe quelle GPU 6 GB avec marge serrée, 8 GB confortablement.
Sources
- NVIDIA. (2026). "CUDA Memory Architecture." -- documentation architecture VRAM GPU, bande passante mémoire et hiérarchie.
- Ollama. (2026). "Ollama Model Library." -- exigences VRAM officielles et niveaux de quantification pour tous les modèles supportés.
- llama.cpp Contributors. (2026). "llama.cpp Quantization Guide." -- implémentation quantification Q4/Q5/Q8, calculs mémoire et benchmarks de qualité.