Comparaison directe
Fonctionnalité | |||
|---|---|---|---|
| Temps d'installation | 2 min | 5 min | 10 min |
| Metal GPU | Automatique | Natif | Supporté |
| Format de modèle | GGUF | Format MLX | GGUF |
| API | REST (localhost:11434) | Python natif | CLI + HTTP |
| Vitesse (8B Q4) | 45–50 tok/s | 55–65 tok/s | 45–55 tok/s |
| Vitesse (70B Q4) | ~10 tok/s | ~14 tok/s | ~11 tok/s |
| Fine-tuning | Non | Oui (LoRA) | Non |
| Idéal pour | Débutants, API | Développeurs ML | Multiplateforme |
Ollama sur Apple Silicon
- Installation en une commande : `brew install ollama`
- Metal GPU automatique — aucune configuration requise
- API REST pour l'intégration (tout langage)
- Gestion des modèles : `ollama pull`, `ollama list`, `ollama rm`
- Limitation : pas de fine-tuning, pas de quantification personnalisée
- Limitation : légèrement plus lent que MLX en raison de l'overhead GGUF
- Idéal pour : débutants, utilisateurs API, intégration Whisper
Modèles supportés par Ollama (100+ curatés)
- Llama 3.1 (8B, 70B, 405B), Llama 3.2 (1B, 3B), Llama 3.3 (70B)
- Ministral 3 8B, Mixtral 8x22B/22B
- Qwen3 (0.5B à 72B)
- Phi-3, Phi-4
- Gemma 3 (4B, 12B, 27B)
- DeepSeek Coder V2
- Vision : Llama 3.2 Vision, LLaVA
- Embedding : nomic-embed-text, mxbai-embed-large
MLX — Le framework natif d'Apple
- Conçu par Apple spécifiquement pour Apple Silicon
- API Python similaire à NumPy : `import mlx.core as mx`
- Évaluation paresseuse + mémoire unifiée = utilisation optimale
- MLX-LM : package dédié à l'inférence et au fine-tuning LLM
- Inférence la plus rapide sur Apple Silicon (20–40% plus rapide qu'Ollama)
- Fine-tuning : LoRA et QLoRA directement sur Mac
- Limitation : modèles au format MLX uniquement (bibliothèque en croissance)
- Limitation : macOS uniquement — code non portable
- Idéal pour : développeurs ML, vitesse maximale, fine-tuning
Modèles supportés par MLX (mlx-community sur HuggingFace)
- Tous les LLM majeurs (Llama, Mistral, Qwen, Gemma, Phi)
- Versions quantifiées (Q3, Q4, Q5, Q6, Q8)
- Modèles vision : Llama 3.2 Vision, LLaVA, Qwen3-VL, Qwen2.5-VL
- Note : nécessite conversion au format MLX (la communauté convertit la plupart)
llama.cpp sur Apple Silicon
- C/C++ multiplateforme — même binaire sur Mac, Linux, Windows
- Support Metal via flag de build : `make LLAMA_METAL=1`
- Format GGUF : plus grande bibliothèque de modèles
- Mode serveur : `./llama-server -m model.gguf` — API REST
- Whisper.cpp du même auteur — support Metal STT
- Limitation : compilation depuis les sources (pas d'installation en un clic)
- Limitation : plus lent que MLX, comparable à Ollama
- Idéal pour : projets multiplateformes, support maximal des formats de modèles
Modèles supportés par llama.cpp (tout GGUF)
- Tout GGUF sur HuggingFace fonctionne (10 000+ modèles)
- Plus grand écosystème de modèles affinés et personnalisés
- Les modèles originaux/expérimentaux y apparaissent souvent en premier
- Pour les modèles courants (Llama, Mistral, Qwen), les trois frameworks conviennent. Pour les modèles obscurs ou expérimentaux, llama.cpp gagne grâce à son écosystème.
Comparaison installation : 5 lignes de code pour lancer Llama 3.1 8B
Ollama (2 commandes) :
```bash
brew install ollama
ollama run llama3.1:8b "Hello, world"
```
MLX (4 lignes Python) :
```python
from mlx_lm import load, generate
model, tokenizer = load("mlx-community/Llama-3.1-8B-Instruct-4bit")
response = generate(model, tokenizer, prompt="Hello, world", max_tokens=100)
print(response)
```
llama.cpp (5 commandes) :
```bash
git clone https://github.com/ggerganov/llama.cpp
cd llama.cpp
make LLAMA_METAL=1
wget https://huggingface.co/ggml-org/models/resolve/main/llama-3.1-8b-q4.gguf
./main -m llama-3.1-8b-q4.gguf -p "Hello, world"
```
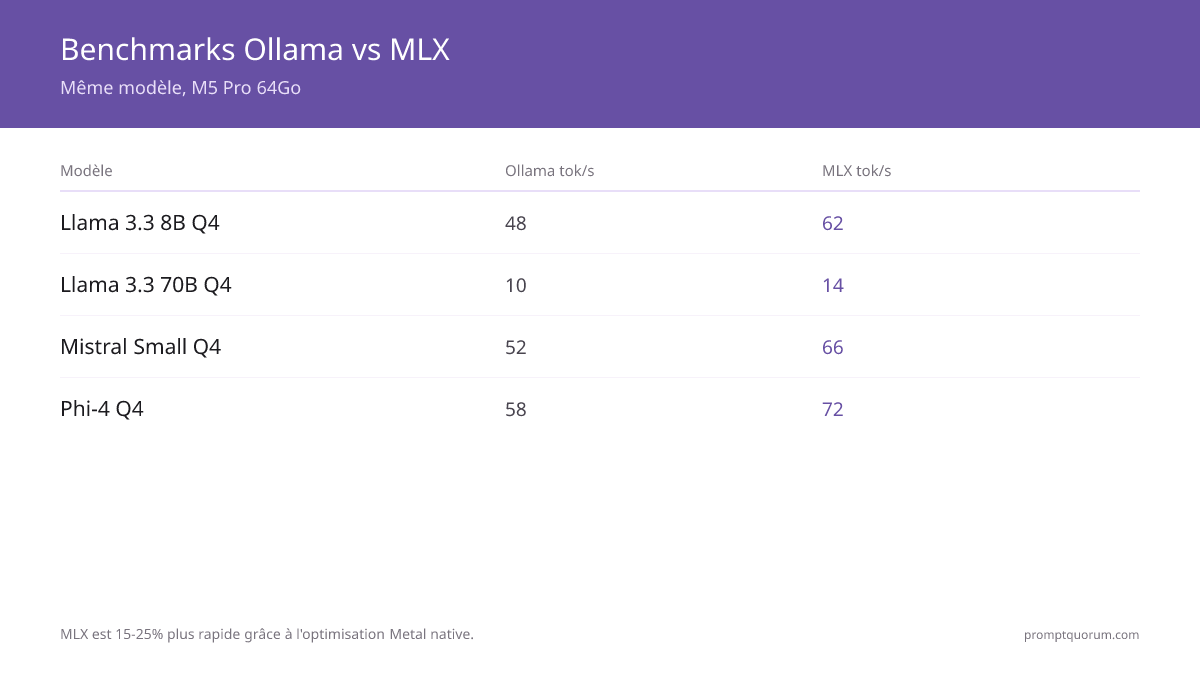
Benchmarks : même modèle, trois frameworks, M5 Pro 64 Go
Modèle | |||
|---|---|---|---|
| Llama 3.1 8B Q4 | 48 | 62 | 52 |
| Llama 3.1 8B Q8 | 38 | 48 | 40 |
| Llama 3.3 70B Q4 | 10 | 14 | 11 |
| Ministral 3 8B Q4 | 52 | 66 | 55 |
| Phi-4 Q4 | 58 | 72 | 60 |
MLX est 20–40% plus rapide grâce à l'optimisation Metal native. Benchmarks préliminaires — améliorations attendues. Les valeurs sont indicatives pour une configuration donnée, et non des mesures indépendantes de laboratoire ; les résultats varient selon le modèle, la version et les réglages.

Utilisation mémoire : même modèle, trois frameworks (M5 Pro 64 Go)
Modèle | |||
|---|---|---|---|
| Llama 3.1 8B Q4 | 5.2 Go | 4.8 Go | 5.0 Go |
| Llama 3.3 70B Q4 | 43 Go | 41 Go | 42 Go |
| Ministral 3 8B Q4 | 4.6 Go | 4.3 Go | 4.4 Go |
Dans le tableau ci-dessus, MLX montre une utilisation mémoire légèrement inférieure à celle d'Ollama pour le même modèle ; les valeurs sont indicatives. Sur les configurations limitées (16 Go, 36 Go), cela peut faire la différence entre un modèle qui tient en mémoire ou qui passe en swap.
Matrice de décision : quand utiliser quel framework
- 1Débutant
Why it matters: Ollama — configuration en 2 minutes, opérationnel immédiatement. - 2Développer une app Python
Why it matters: MLX — Python natif, vitesse maximale. - 3API REST requise
Why it matters: Ollama — serveur API intégré. - 4Fine-tuning sur Mac
Why it matters: MLX — parmi ces trois, l'option avec support LoRA intégré. - 5Projet multiplateforme
Why it matters: llama.cpp — même code sur Mac + Linux + Windows. - 6
- 7Vitesse maximale requise
Why it matters: MLX — 20–40% plus rapide que les alternatives. - 8Modèles peu courants
Why it matters: llama.cpp — plus grande bibliothèque de modèles GGUF.

Quand NE PAS utiliser chaque framework
Ne pas utiliser Ollama si :
• Vous avez besoin de fine-tuning (non supporté)
• Vous avez besoin du maximum de vitesse (20–30% plus lent que MLX)
• Vous voulez une quantification entièrement personnalisée (contrôle limité)
Ne pas utiliser MLX si :
• Vous avez besoin d'un déploiement multiplateforme (macOS uniquement)
• Vous n'êtes pas à l'aise avec Python
• Vous avez besoin d'une API REST prête à l'emploi (encapsulation nécessaire)
• Vous avez besoin de modèles vision en production (sélection réduite)
Ne pas utiliser llama.cpp si :
• Vous voulez une expérience en un clic (compilation requise)
• Vous avez besoin de fine-tuning (non supporté)
• Vous ne voulez pas gérer vos propres téléchargements de modèles
Utiliser plusieurs frameworks simultanément ?
Oui — ils ne sont pas en conflit. Installez les trois. Schéma courant : Ollama pour l'usage quotidien, MLX pour les tâches nécessitant de la vitesse, llama.cpp pour les modèles absents d'Ollama/MLX. Ils partagent les mêmes modèles sous-jacents (formats différents).
Que signifie MLX ?
MLX est le framework de machine learning propre à Apple, conçu spécifiquement pour Apple Silicon. Il offre une API Python de type NumPy, l'évaluation paresseuse (lazy evaluation) et une optimisation de la mémoire unifiée, ainsi qu'un fine-tuning LoRA/QLoRA natif. MLX n'a aucun rapport avec Ollama ou llama.cpp — ce sont des moteurs d'inférence distincts. Sur Apple Silicon, MLX est, d'après les chiffres indicatifs de cette page, environ 20 à 40 % plus rapide qu'Ollama, mais il n'exécute que des modèles au format MLX, et uniquement sur macOS.
Quel framework est le plus rapide ?
MLX, 20–40% plus rapide qu'Ollama sur Apple Silicon. llama.cpp est comparable à Ollama. La différence de vitesse ne s'observe que sur les grands modèles (70B+) ; pour les 8B, tous sont suffisamment rapides.
Puis-je changer de framework plus tard ?
Oui. Installez Ollama aujourd'hui, passez à MLX demain. Les modèles sont compatibles (juste en formats différents). Pas de verrouillage.
MLX est-il uniquement pour Python ?
MLX possède une API Python native, mais vous pouvez l'appeler depuis d'autres langages via subprocess ou un wrapper de serveur HTTP. Meilleure utilisation depuis Python.
Ollama a-t-il une interface graphique ?
Ollama lui-même est en ligne de commande uniquement. Utilisez des interfaces open source comme Open-WebUI pour une interface de chat.
Puis-je exécuter Ollama et MLX simultanément ?
Oui. Ils utilisent des répertoires de modèles séparés et ne sont pas en conflit. Beaucoup de développeurs font tourner Ollama comme service en arrière-plan pour l'accès API et utilisent MLX pour les notebooks Python. Avec suffisamment de mémoire unifiée, ils peuvent même charger le même modèle simultanément.
MLX fonctionne-t-il sur les Mac Intel ?
Non. MLX est conçu spécifiquement pour Apple Silicon (M1+). Les utilisateurs de Mac Intel doivent utiliser Ollama ou llama.cpp. Les deux fonctionnent sur Intel, mais sans accélération Metal GPU — nettement plus lents qu'Apple Silicon.
Quel framework supporte le mieux les modèles vision ?
Ollama offre l'intégration de modèles vision la plus propre via `ollama run llama3.2-vision`. MLX supporte les modèles vision mais nécessite plus de configuration. llama.cpp a un support vision via un exécutable llava séparé. Pour le multimodal, commencer par Ollama.
Versions des frameworks & fraîcheur
• Les valeurs des tableaux sont indicatives pour une configuration donnée, et non des mesures indépendantes de laboratoire ; PromptQuorum n'a pas vérifié de façon indépendante les versions des frameworks correspondantes
• Les performances des frameworks s'améliorent chaque mois — re-benchmarker trimestriellement pour des chiffres à jour
MLX et Ollama en France : Apple Silicon, Homebrew et la communauté développeurs
La France est le marché domestique de Mistral AI, ce qui crée un contexte particulier : les développeurs français ont tendance à tester MLX et Ollama avec des modèles Mistral en priorité. Apple Silicon est très répandu dans l'écosystème tech français (agences, startups, freelances).
Pour les équipes utilisant des Mac M-series, MLX offre un avantage concret : accélération Metal native sans configuration supplémentaire. Des benchmarks MLX vs Ollama sont régulièrement partagés par la communauté ; les résultats varient selon le matériel et les versions.
- Homebrew vs nix pour les développeurs FR : La majorité de la communauté tech française utilise Homebrew pour gérer Ollama (`brew install ollama`). Nix est populaire chez les développeurs fonctionnels (Haskell, Elixir, OCaml) — MLX s'installe via pip dans un environnement Nix-shell. Homebrew reste le chemin le plus direct.
- Modèles Mistral avec MLX : `mlx_lm.convert` peut convertir les modèles Mistral Hugging Face en format MLX. Mistral AI publie régulièrement des updates sur X (@MistralAI) — suivre pour les nouvelles variantes optimisées.
- RGPD et inférence locale : L'inférence locale évite d'envoyer les données à un tiers pour cette étape, mais le RGPD continue de s'appliquer à votre traitement (base légale, mesures de sécurité, finalité). Ceci ne constitue pas un conseil juridique.