Meilleur modèle 14B pour le coding ?
Par Hans Kuepper · Fondateur de PromptQuorum · Moteur de découverte de l'IA open-weight et open source
Points clés
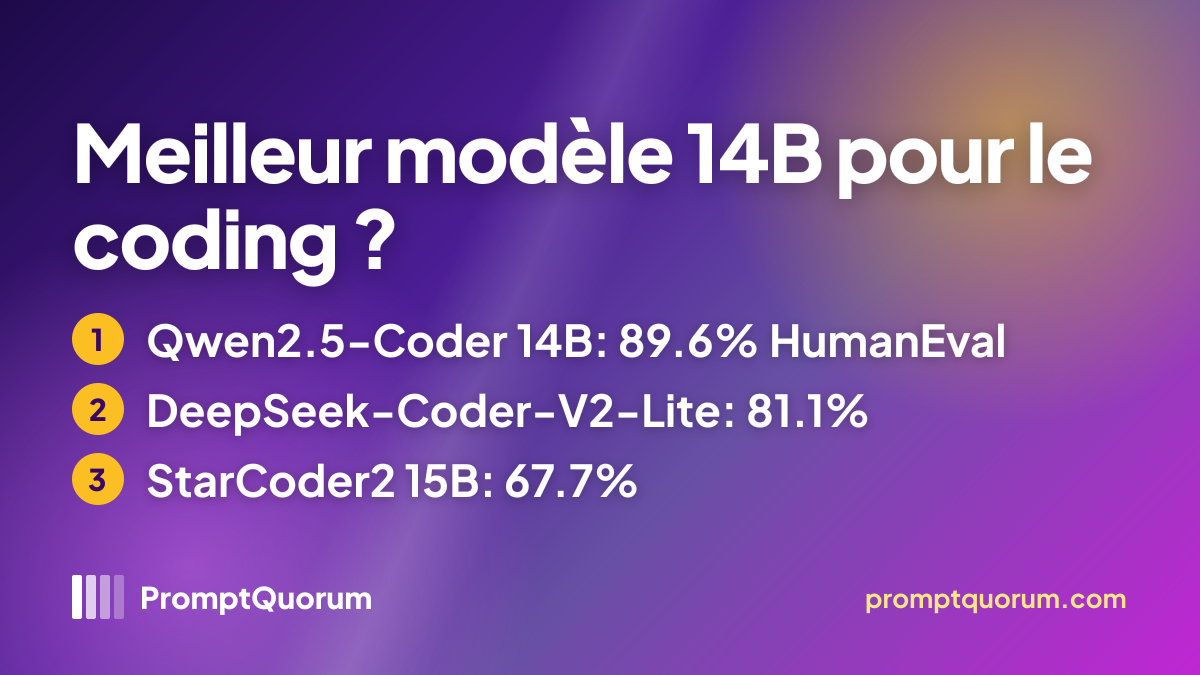
- ✓Qwen2.5-Coder 14B Instruct obtient 89,6 % sur HumanEval dans le rapport de Qwen, le meilleur score des trois modèles comparés ici, et demande environ 10 Go de VRAM (9,0 Go à télécharger)
- ✓DeepSeek-Coder-V2-Lite est un modèle 16B à mélange d'experts (2,4B de paramètres actifs) qui obtient 81,1 % sur HumanEval pour 8,9 Go à télécharger
- ✓StarCoder2 15B Instruct obtient 67,7 % sur HumanEval et reste derrière les deux autres sur ce benchmark
- ✓Avec 12 Go de VRAM, utilisez Qwen2.5-Coder 14B ; sous 8 Go, passez à un modèle de code 7B. Tous les chiffres HumanEval sont des résultats instruct publiés par les éditeurs, pas des mesures PromptQuorum
Réponse rapide
Qwen2.5-Coder 14B est le plus fort de ces trois modèles de code dans le rapport de Qwen : 89,6 % sur HumanEval (instruct) contre 81,1 % pour DeepSeek-Coder-V2-Lite et 67,7 % pour StarCoder2 15B. Le téléchargement de qwen2.5-coder:14b pèse 9,0 Go ; prévoyez environ 10 Go de VRAM.
- ▸Qwen2.5-Coder 14B Instruct : 89,6 % HumanEval, 9,0 Go à télécharger (ollama run qwen2.5-coder:14b)
- ▸DeepSeek-Coder-V2-Lite (16B MoE, 2,4B actifs) : 81,1 % HumanEval, 8,9 Go à télécharger
- ▸StarCoder2 15B Instruct : 67,7 % HumanEval — scores publiés par les éditeurs, pas des mesures PromptQuorum
Qwen2.5-Coder 14B en tête sur HumanEval
Qwen2.5-Coder-14B-Instruct obtient 89,6 % sur HumanEval dans le rapport technique Qwen2.5-Coder, le meilleur score des trois modèles comparés ici. Ce sont des résultats instruct publiés par l'éditeur, pas des mesures PromptQuorum ni des résultats en Q4_K_M ; les versions locales quantifiées peuvent donner des scores légèrement différents.
DeepSeek-Coder-V2-Lite-Instruct obtient 81,1 % dans le même tableau. C'est un modèle à mélange d'experts de 16B au total et 2,4B actifs, donc pas un modèle dense de 14B, mais son téléchargement Ollama de 8,9 Go le place dans la même classe de VRAM. L'écart de 8,5 points sur HumanEval favorise Qwen ; DeepSeek reste une alternative raisonnable si vous l'utilisez déjà.
StarCoder2-15B-Instruct-v0.1 obtient 67,7 % dans le même tableau. Entraîné sur The Stack v2, il convient au travail orienté dépôts de code, mais sur HumanEval il reste derrière les deux modèles ci-dessus.
| Modèle | HumanEval (instruct) | Architecture |
|---|---|---|
| Qwen2.5-Coder 14B | 89,6 % | 14,7B dense |
| DeepSeek-Coder-V2-Lite | 81,1 % | 16B MoE (2,4B actifs) |
| StarCoder2 15B | 67,7 % | 15B dense |
La marge VRAM détermine le choix
Qwen2.5-Coder 14B et DeepSeek-Coder-V2-Lite nécessitent tous deux environ 10 Go de VRAM en Q4_K_M, ne laissant que 2 Go de marge sur une carte 12 Go. Cette marge est serrée pour les sessions à long contexte : à 8k de contexte, l'utilisation VRAM monte à ~11,5 Go. Si votre flux de travail implique de grands fichiers, préférez une carte de 16+ Go.
Pour des fenêtres de contexte inférieures à 4k tokens — le cas courant pour la complétion de fichier unique — les trois modèles fonctionnent confortablement sur une RTX 3060 12 Go ou RTX 3080 Ti 12 Go. La vitesse pour Qwen et DeepSeek Coder est d'environ 14 à 18 tok/s ; StarCoder2 15B s'exécute à un débit similaire compte tenu de son empreinte VRAM comparable. Préférez StarCoder2 quand votre flux de travail porte sur la recherche au niveau du référentiel ou les modèles de contributions open-source.
Pour une comparaison plus complète des modèles de coding à différentes tailles et niveaux de VRAM, consultez le guide du meilleur LLM de coding pour 12 Go de VRAM.
Meilleurs modèles 14B généralistes : Qwen3 14B et Phi-4
Hors coding, les deux principaux modèles 14B généralistes sur Ollama sont Qwen3 14B (qwen3:14b, 9,3 Go à télécharger, contexte 40K) et Phi-4 (phi4:14b, 9,1 Go, contexte 16K). Tous deux tiennent sur une carte de 12 Go en quantification Q4 par défaut, dans la même classe de VRAM que les modèles de coding ci-dessus.
Qwen3 14B convient à un contexte plus long et à un usage multilingue large ; Phi-4 vise les requêtes riches en raisonnement et en mathématiques. Pour le code pur, les modèles spécialisés ci-dessus restent en tête. Nous n'avons pas mené de benchmark comparatif des modèles généralistes ; aucun score n'est donc indiqué.
| Modèle | Tag Ollama | Téléchargement | Contexte |
|---|---|---|---|
| Qwen3 14B | qwen3:14b | 9,3 Go | 40K |
| Phi-4 | phi4:14b | 9,1 Go | 16K |