Meilleur LLM local pour le coding avec 12 Go de VRAM ?
Par Hans Kuepper · Fondateur de PromptQuorum · Moteur de découverte de l'IA open-weight et open source
Points clés
- ✓Gemma 4 12B (Google, Apache 2.0) : 7,7–8,0 Go à télécharger, contexte 256K, 72,0 % LiveCodeBench v6 (donnée du fabricant) — le meilleur choix de code pour tout GPU de 12 Go
- ✓Qwen2.5-Coder 14B Q4_K_M (~9 Go) reste une option solide spécialisée en code, mais date de 2024 ; les Qwen plus récents comme Qwen3.8 27B (18 Go) demandent plus de 12 Go
- ✓Devstral Small 2 (24B, 15 Go) et Qwen3.8 27B (18 Go) ne tournent sur 12 Go qu'avec un déport vers le CPU, ce qui ralentit fortement la génération
- ✓Augmentez la fenêtre de contexte à 8192 ou plus pour coder — la fenêtre par défaut tronque les vrais fichiers source — et vérifiez avec ollama ps que le modèle est entièrement sur le GPU
Réponse rapide
Gemma 4 12B est le meilleur modèle de code pour un GPU de 12 Go de VRAM : son téléchargement Ollama fait 7,7–8,0 Go, et Google annonce 72,0 % sur LiveCodeBench v6 pour le modèle 12B. Qwen2.5-Coder 14B (~9 Go) est l'alternative spécialisée en code. Qwen3.8 27B (18 Go) et Devstral Small 2 (15 Go) ne tiennent pas dans 12 Go.
- ▸Gemma 4 12B : 7,7–8,0 Go à télécharger, contexte 256K, Apache 2.0
- ▸Qwen2.5-Coder 14B Q4_K_M : ~9 Go, spécialisé en code, gère le fill-in-the-middle
- ▸Ornith 9B : 5,6 Go, licence MIT, conçu pour le codage agentique
Le choix de code pour 12 Go
Gemma 4 12B est le meilleur modèle de code pour un GPU de 12 Go de VRAM : le téléchargement Ollama fait 7,7–8,0 Go, ce qui laisse environ 4 Go pour le cache KV, et Google annonce 72,0 % sur LiveCodeBench v6 et un Elo Codeforces de 1659 pour le modèle 12B. Il est sous licence Apache 2.0, gère une fenêtre de contexte de 256K et accepte les images, vous pouvez donc coller une capture d'écran d'une erreur ou d'un bug d'interface. Ces scores sont ceux du fabricant ; nous n'avons pas mené nos propres mesures.
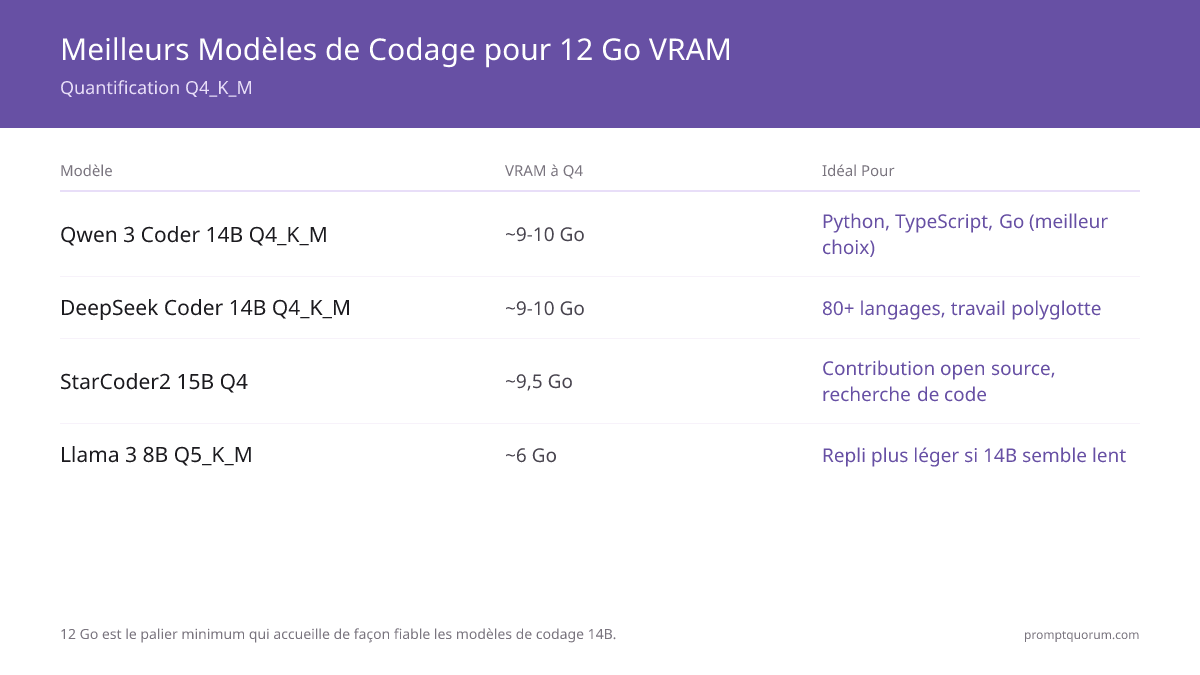
Qwen2.5-Coder 14B Q4_K_M (~9 Go) tient toujours et reste le choix spécialisé en code avec prise en charge du fill-in-the-middle, mais c'est un modèle de 2024. Ornith 9B (5,6 Go, licence MIT) vise le codage agentique et laisse le plus de marge pour un long contexte. Devstral Small 2 (24B, 15 Go) et Qwen3.8 27B (18 Go) dépassent 12 Go et ne tournent qu'avec un déport vers le CPU.
Si vous avez plutôt une carte de 8 Go, consultez les meilleurs LLM pour AMD 5700X + RTX 3070 Ti pour les compromis à 8 Go.
| Modèle | Taille du téléchargement | Idéal pour |
|---|---|---|
| Gemma 4 12B | 7,7–8,0 Go | Premier choix : code, images, contexte 256K |
| Qwen2.5-Coder 14B Q4_K_M | ~9 Go | Spécialisé en code, fill-in-the-middle |
| Ornith 9B | 5,6 Go | Codage agentique, marge pour long contexte |
| Devstral Small 2 24B | 15 Go | Ne tient pas ; déport CPU requis |
| Qwen3.8 27B | 18 Go | Ne tient pas ; 18 Go+ de mémoire requis |
Les réglages qui comptent pour coder
Fixez la fenêtre de contexte à 8k au minimum pour coder — une fenêtre par défaut courte tronque les fichiers source de quelques centaines de lignes. Les ~8 Go de poids de Gemma 4 12B laissent environ 4 Go d'une carte de 12 Go pour le cache KV et le runtime ; Qwen2.5-Coder 14B à ~9 Go en laisse moins, gardez donc un contexte modéré. Réglez-le avec OLLAMA_CONTEXT_LENGTH=8192 avant de lancer le serveur, ou /set parameter num_ctx 8192 dans ollama run, puis lancez ollama ps pour vérifier que le modèle est sur le GPU et non partagé avec le CPU.
Activez Flash Attention (OLLAMA_FLASH_ATTENTION=1) et, si vous avez besoin de plus de contexte, définissez OLLAMA_KV_CACHE_TYPE=q8_0, qui réduit à peu près de moitié la mémoire du cache KV par rapport au cache f16 par défaut, pour une légère perte de qualité. Les variables d'environnement se combinent en un seul lancement.
Pour le classement complet au-delà de 12 Go, consultez le guide des meilleurs LLM locaux pour le code.
ollama pull gemma4:12b
ollama run gemma4:12b

# code-specialised alternative
ollama pull qwen2.5-coder:14b-instruct-q4_K_MGuides associés
- ▸Meilleurs LLM locaux pour le code -- classement complet au-delà de 12 Go
- ▸Best MoE Models for Local Coding -- modèles de code MoE
- ▸Continue.dev racheté par Cursor : arrêt et alternatives -- comparatif d'outils de code
Réponses rapides sur les LLM de code pour 12 Go de VRAM
Quel est le meilleur modèle de code pour 12 Go de VRAM ?▾
Quel est le meilleur LLM local pour 12 Go de VRAM en général ?▾
Qwen3.8 27B et Devstral Small 2 tiennent-ils dans 12 Go de VRAM ?▾
Faut-il choisir Q4_K_M ou une quantification supérieure sur 12 Go ?▾
Puis-je utiliser l'autocomplétion fill-in-the-middle (FIM) avec ces modèles sur Ollama ?▾
suffix de /api/generate pour les modèles dont le template le permet. Vérifiez la page Ollama de chaque modèle pour la prise en charge de l'insertion avant de l'intégrer à un éditeur ; pour l'autocomplétion, Qwen2.5-Coder est le choix le plus sûr.