重要なポイント
- RTX 3060 12GB(中古$270–300):すべての7B-8BモデルをQ4/Q5で、ほとんどの稠密13B-14BをQ4で実行。最良の中古バジェット選択。
- RTX 5060 Ti 16GB(新品約$570–600):RTX 3060より4GB多いVRAMを持つ現行世代カード。最良の新品バジェット選択。
- RTX 3060 6GB:3Bモデルのみ(Phi-4 Mini、Llama 3.2 3B)。7Bには不足。
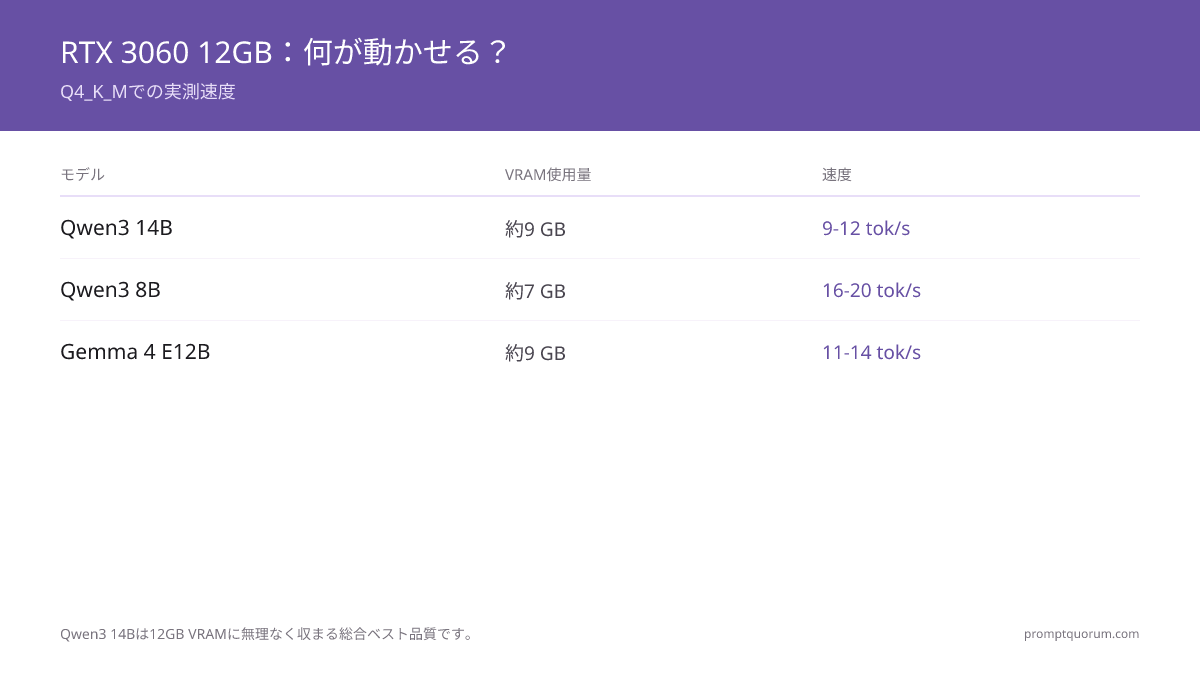
- 12GBでの最良総合モデル: Qwen3 14B、~9GB VRAM、9–12トークン/秒。快適に収まる最良の稠密品質。
- 12GBでの最良コーディングモデル: Qwen3 8B、16–20トークン/秒。
- 12GBでの最良推論モデル: DeepSeek-R1 7B、10–12トークン/秒。
- 対象外: 70Bモデル、Llama 4 Scout(~55GB必要)、13B Q8が必要な場合は24GB以上(RTX 4090)が必要。
📍 一文で説明
RTX 3060 12GB(中古$270–300)はQwen3 14Bを9–12トークン/秒で実行し、2026年のローカルLLM向け最良のバジェットGPUです。
💬 簡潔に説明
AI向けのバジェットGPUとは、$300未満で購入できながら、自分のパソコンで使えるAIモデルを実用的な速度で動かすのに十分なビデオメモリ(VRAM)を持つグラフィックカードのことです。
RTX 3060 12GBで何が動く?
RTX 3060 12GBは2026年のローカルLLM用最良バジェットGPUです。 12GB VRAMはQ4/Q5のすべての7Bモデルと、Q4のほとんどの13Bモデルに対応。モデルサイズ別のVRAM要件について詳しくは、VRAM要件ガイド →をご参照ください。期待できる正確なモデルと速度は次の通りです:
📍 一文で説明
RTX 3060 12GBはQ4でQwen3 14B(9GB、約9–12トークン/秒)、Qwen3 8B(5.5GB、約16–20トークン/秒)、すべての7Bモデルを余裕を持って実行します。
💬 簡潔に説明
RTX 3060 12GBは12ギガバイトのビデオメモリを搭載しており、約140億パラメータまでのAIモデルに十分です。それより大きなモデルは収まらず、動作が遅くなります。
モデル | サイズ | 量子化 | VRAM使用 | 速度 | 最適用途 |
|---|---|---|---|---|---|
| Qwen3 14B | 14B(稠密) | Q4_K_M | ~9 GB | 9–12トークン/秒 | 収まる範囲で最良総合品質 |
| Qwen3 8B | 8B | Q4_K_M | ~7 GB | 16–20トークン/秒 | コーディング、万能 |
| Gemma 4 E12B | 26B MoE | Q4_K_M | ~9 GB | 11–14トークン/秒 | ビジョン、マルチモーダル |
| Mistral Small v0.3 | 7B | Q4_K_M | ~7 GB | 18トークン/秒 | 指示従行 |
| DeepSeek-R1 7B | 7B | Q4_K_M | ~7 GB | 10–12トークン/秒 | 推論、数学 |
| Gemma 4 E4B | E4B(マルチモーダル) | Q4_K_M | ~5 GB | 18–22トークン/秒 | 軽量ビジョン、高速チャット |
| Llama 3.2 13B | 13B | Q4_K_M | ~11 GB | 8–10トークン/秒 | 高品質チャット(Q4のみ) |
Qwen3 14B(稠密)はQ4_K_MでRTX 3060 12GBに快適に収まる最高品質のモデルで、~9 GBを使用します。`ollama pull qwen3:14b`。注:Llama 4 Scout(17Bアクティブ/109B合計のMoE、10Mトークンコンテキスト、マルチモーダル)はQ4で~55GB必要で、通常12GBには収まりません — 大容量VRAM環境向けの長コンテキスト/大規模マルチモーダル用途であり、バジェットGPUの推奨ではありません。gpt-oss:20b(21B合計/3.6BアクティブMoE)は16GB必要なため、12GBカードでは僅かに手が届きません。すべての速度はOllama、RTX 3060 12GB、16GBシステムRAM、Ryzen 7 7700Xで計測。Q4_K_M量子化。速度は±15%変動。

RTX 3060 6GBで何が動く?
6GB版は大幅に制限されています。 3Bモデルのみ快適に動作。7BモデルのQ4は~7GB必要で、容量不足です。
- Phi-4 Mini 3.8B(Q4): ~3GB VRAM、20–25トークン/秒。このサイズでの最良推論。
- Llama 3.2 3B(Q4): ~2.5GB VRAM、25–35トークン/秒。最速オプション。
- Gemma 2 2B(Q4): ~1.7GB VRAM、35–45トークン/秒。最軽量モデル。
- 7Bオフローディング: 可能だが遅い。Llama 7BのCPUオフロード = ~5–8トークン/秒。
- 推奨: 6GBカードをお持ちなら、12GB中古($270–300)にアップグレードを。
RTX 3060 vs 他のバジェットGPU
GPU | VRAM | 価格(中古) | 7B速度 | 最大モデル | 評価 |
|---|---|---|---|---|---|
| RTX 3060 12GB ★ | 12 GB | ¥40,000–44,000 | 15–20トークン/秒 | 13B(Q4) | 最良の中古バジェット |
| RTX 5060 Ti 16GB | 16 GB | 新品¥84,000–89,000 | 25–30トークン/秒 | 20B(Q4) | 最良の新品バジェット選択 |
| RTX 4060 Ti 8GB | 8 GB | 中古約¥40,000(新品¥62,000〜) | 20–25トークン/秒 | 7B(Q5最大) | 高速だがVRAM少 |
| RTX A4000 | 16 GB | ¥117,000–126,000 | 12–15トークン/秒 | 13B(Q5) | もはやバジェット外 |
| RTX 4070 Super | 12 GB | 新品¥81,000–104,000 | 25–30トークン/秒 | 13B(Q5) | 12GB最速だが2倍の価格 |
| RX 6700 XT | 12 GB | ¥26,000–37,000 | 10–14トークン/秒 | 13B(Q4) | 12GB最安、AMDの手間 |
RTX 3060 12GBが中古の価格性能比で勝利:¥40,000–44,000の12GB VRAMですべての7Bとほとんどの13Bを実行。新品ならRTX 5060 Ti 16GB(¥84,000–89,000)がVRAMに余裕のある現行世代の選択肢ですが、希望小売価格を約40%上回っています。12GBへの最安ルートは中古のRX 6700 XT(¥26,000–37,000)で、AMD ROCmの設定を許容できる場合に限ります。RTX A4000はかつてVRAM/円で最良でしたが、中古¥117,000–126,000となった今はその座を失い、格下げしました。

7Bモデルに必要なVRAMは?
Q4(4ビット)で量子化された7Bモデルは6~8GB VRAMを必要とし、Q5(5ビット)は8~10GB、Q8(8ビット)は14~16GBを必要とします。
実際には:8GBは最低限で、Q4で7Bモデルでの快適な推論とバッチ処理用のスペースがあります。
6GBカード(RTX 2060)は技術的に機能しますがアグレッシブな最適化が必要で、より高いバッチに余裕がありません。
GPUコストは経済性の一面であり、トークンコストはもう一面です。ローカル推論はAPIのトークン課金を排除しますが、プロンプト長は依然としてレイテンシとスループットに影響します。トークン、価格体系、最適化戦略を含むコスト全体像については、トークン、コスト、制限:AIプロンプティングの経済学をご覧ください。
RTX 3060でのユースケース別最適モデル
パラメータ数ではなく、実際のニーズに基づいてモデルを選択してください:
バジェットハードウェアは小さなモデルを実行しますが、巧みなプロンプティングが品質差を縮めます。プロンプトエンジニアリングガイドでは、Chain-of-Thoughtや構造化出力など、小さなモデルの実力を引き出すテクニックを解説しています。RTX 3060 12 GB の VRAM に収まる具体的なワークロードのひとつが、プルリクエストの自動レビューです。まさに同じハードウェア上で Qwen3 8B を PR にぶつける GitHub Actions のパターンは、CI/CD でのローカル LLM コードレビューで解説しています。
- チャット / Q&A: `ollama run qwen3:14b` — 稠密14B、~9GB VRAM、12GBで最良品質。軽量オプションは `ollama run qwen3:8b`(~7GB)。
- コーディング: `ollama run qwen3:8b` — 万能で強力なコーディング。~7GB VRAM。16–20トークン/秒。
- 推論 / 数学: `ollama run deepseek-r1:7b` — Chain-of-Thought。10–12トークン/秒。
- ライティング / クリエイティブ: `ollama run mistral:7b` — 最良の指示従行。18トークン/秒。
- ビジョン / 画像: `ollama run gemma4:e12b` — マルチモーダル。11–14トークン/秒。~9GB VRAM。軽量な選択肢は `ollama run gemma4:e4b`(~5GB)。
- プライバシー / オフライン: 上記すべて。100%ローカル。データは外部送信されません。
- ホームオートメーション / 常時稼働AI: `ollama run phi4-mini` — Phi-4 Mini(3.8B、~3 GB VRAM)は専用GPUなしのミニPCでHome Assistantの音声クエリを処理します。ローカルスマートホームAIの最適ハードウェア →をご覧ください。
中古 vs 新品:どこで買う?
- 中古(50~100ドル安い):eBay、Facebook Marketplace、Craigslist、地元のコンピュータ修理店。死んだカードまたは不良VRAMのリスクが高い。確約する前に常にテストしてください。
- 新品(280~400ドル):Newegg、Amazon、Best Buy、Microcenter。保証付き。驚きなし。価格安定。リスク回避買い手に最適。
- マイニングカード(暗号、超安い):極端なリスク。VRAM劣化は一般的。その場で完全にベンチテストできる場合のみ購入してください。
よくあるバジェットGPUの間違い
- 4GB RTX 2060を購入してスムーズな7B推論を期待する。常にメモリ不足エラーが発生します。
- 250ドルのGPUを30ドルのPSU(電源)と組み合わせます。電圧サグは安定性を殺します。80+ Gold認定、650W最小をバジェット化してください。
- DDR5 RAMとi9 CPUがLLM推論を高速化すると想定する。それらは高速化しません。GPU VRAMバンド幅は推論速度に影響する唯一のボトルネックです。
次のステップ
- ローカルLLM向け最高AMD GPU — AMDを検討中?AMD対NVIDIA完全比較 →
- 最高オープンソースOllamaモデル — 予算GPUで最高の性能を出すモデルは →
- 必要なVRAMは? — GPUとモデルサイズを一致させる →
よくある質問
RTX 3060 12GBは2026年でもまだ価値があるか?
はい。4年以上前のカードですが、12GB VRAMは今も色褪せません。Qwen3 14B、Qwen3 8B、Gemma 4 E12B、Mistral SmallをQ4で問題なく実行します。すべての7B-8Bモデルとほとんどの稠密13B-14Bモデルに対応します。
ローカルLLM用にRTX 5060 TiまたはRTX 4060 Tiを購入すべきか?
RTX 5060 Ti 16GB(約$570–600)が現在はより良い選択です:8GB RTX 4060 Tiより8GB多いVRAMを持ち、世代あたり10–15%高速です。新品カードでは現行世代のバジェット選択です。予算が厳しい場合、8GB RTX 4060 Tiも7Bモデルには十分実用的です。13B以上を実行する予定なら、ベースの4060/5060(8GB)と4070(12GB)はVRAMの余裕が乏しいため避けてください。
AMD RX 7900 XTまたはRX 7900 XTXを代わりに使用できるか?
はい、ただしAMDのドライバサポートはNVIDIA + CUDAより弱いです。HIP/ROCmのセットアップにはより多くの手間がかかります。初心者にはRTXの方が安全です。
12GB VRAMは13Bモデルに十分か?
かろうじて、Q4量子化でなら。Q5またはQ8はOOMエラーを起こします。13Bを快適に実行したいなら16GBを目指してください。
RTX A4000などの中古エンタープライズGPUを購入すべきか?
現在は勧めません。RTX A4000は中古$180–230で買えた頃は本物のバジェット掘り出し物でしたが、2026年のメモリ不足で中古$790–850まで上昇しました。RTX 3060 12GBの約3倍の価格で、VRAMは4GB多いだけ、推論はより低速です。RTX A2000 12GB($440–615)も同様です。代わりに中古のRTX 3060 12GBか新品のRTX 5060 Ti 16GBを購入してください。
$250のGPUに合わせるべきPSU電力は?
650W、80+ Gold認証以上が最低ライン。$250のGPU+CPU+マザーボードは400Wを超えませんが、スパイクへの余裕を持たせるべきです。
$200のバジェットGPUでOllamaを実行できるか?
はい。Ollamaは軽量です。4年落ちのRTX 3060にOllamaを組み合わせれば、Qwen3 14Bを9–12トークン/秒、Qwen3 8Bを16–20トークン/秒で実行できます — 対話的なチャットやコーディング支援に十分実用的です。
RTX 3060 12GBでLlama 4 Scoutを実行できるか?
通常はできません。Llama 4 Scoutは17Bアクティブ/109B合計のMoEで、Q4で約55GBのVRAMが必要です — 12GBカードでは全く足りません。24GBでも極端な1.78ビット量子化(約20トークン/秒)でようやく収まる程度です。RTX 3060 12GBでは代わりに稠密モデルを実行してください:`ollama pull qwen3:14b`(収まる範囲で最良品質)、Qwen3 8B、またはGemma 4 E12B。Scoutは48GB以上の環境向けの長コンテキスト(1000万トークン)・大規模マルチモーダル用途です。
$200未満の最良のバジェットGPUは?
中古RTX 2080(8GB、約$150)または RTX A2000(12GB、約$440–615)。どちらもQ4で7Bモデルを実行できます。12GBのVRAM余裕があるA2000がおすすめです。
購入前に中古GPUのVRAM不良をどうテストするか?
VRAMストレステストを実行してください:gpu-burn(Linux)、HWiNFO64のメモリストレステスト(Windows)、またはOllamaで大きなモデルを読み込みOOMエラーが出ないか確認します。返品可能な間にテストしてください。
後で大きなモデルを実行するためにGPUをアップグレードできるか?
はい、デスクトップPCでのGPUアップグレードは簡単です。RTX 3060 12GBから始めて、後でRTX 4090や5090にアップグレードできます。PCIeスロットは世代をまたいで後方互換性があります。
ローカルLLM推論に最適なバジェットNVIDIA GPUは?
7BモデルにはRTX 4060 Ti(8GB、約$250)、13BモデルにはRTX 4070 Super(12GB、約$550–700)。中古なら、RTX 3060 12GB($270–300)がQ4で7-13Bモデルを問題なく実行します。最良の価値はRTX 3060 12GB中古、または新品のRTX 4070 Super。
AMD 6800XTはAI推論でRTX 4070とどう比較されるか?
AMD RX 6800 XT(16GB)はVRAMとゲーム性能でRTX 4070(12GB)を上回りますが、LLM推論速度では劣ります(15–20%遅い)。llama.cpp向けのROCmドライバ設定もCUDAより複雑です。純粋なLLM作業にはRTX 4070の方が簡単で、ゲーム+LLMなら6800 XTの方がコストパフォーマンスに優れます。
2026年のローカルLLM向けGB単価が最良のGPUは?
中古RTX 3090(24GB、約$850–1,050)=1GBあたり$35–44。中古RTX 3060(12GB、約$270–300)=1GBあたり$23–25。RTX 4070 Ti(12GB、新品約$600)=1GBあたり$50。最良の価値:RTX 3060 12GB中古。1ドルあたりの最大容量:RTX 3090 24GB中古。価格と性能のバランス:新品のRTX 4070。
ローカルLLM用にAMD RX 6700または6800 XTをNVIDIAの代わりに使えますか?
はい、ただしAMDのONNX Runtime向けROCmドライバサポートはNVIDIA CUDAより弱いです。セットアップの手間が増えることを想定してください。バジェット構成にはNVIDIAの方が安全です。
関連資料
- ローカルLLMに必要なVRAMはいくらか
- コンシューマーハードウェアの70Bモデル
- RTX 5090 vs RTX 4090
- ローカルLLM用の中古GPU
- ローカルLLM向けの最高のGPU
- VRAM計算機
- Mac Mini M5ローカルAIサーバーとして
- ローカルLLM向けApple Silicon M5 — M5 Pro/Max完全ガイド:ベンチマーク、Mac構成、メモリ層、ローカル推論用Mac購入ガイド
- ローカルLLM向けApple Silicon対NVIDIA GPU
- Apple Silicon向けベストモデル2026
- 秋葉原の販売店、メルカリ・Yahoo!オークションの中古市場を含む日本のGPU価格については、<a href="/ja/prompt-bites/best-gpu-local-llm-japan-price" class="text-primary hover:underline">日本でコスパ最強のローカルLLM用GPUガイド</a>をご覧ください。
- UAE(アラブ首長国連邦)・湾岸地域のGPU価格については、Sharaf DG、noon.com、Amazon.aeなどの販売店や中古市場dubizzleを含め、<a href="/ja/prompt-bites/best-gpu-local-llm-uae-price" class="text-primary hover:underline">UAEでコスパ最強のローカルLLM用GPUガイド</a>をご覧ください。
ソース
- TechPowerUp GPUデータベース:RTX 3060 / RTX 4060 Ti / RTX 4070 Super仕様と電力消費
- NVIDIA CUDA能力マトリックス:推論ワークロード用GPU メモリバンド幅と理論的スループット
- Ollama モデル要件:Llama 3.3 7B、Mistral Small、Qwen量子化レベルVRAM推奨