「小型」ローカルLLMとは? どんなときに使うべきか
小型ローカルLLMとは、一般にパラメータ数がおよそ40億以下のモデルを指します。 4ビット量子化すると、ダウンロードサイズはおよそ1〜4 GBです(Gemma 4の実効パラメータ設計は例外で、後述します)。メモリが合計4〜8 GBのエントリークラスのノートPCでも十分に収まる大きさです。
小型モデルは、要約、簡単なQ&A、コードスニペットの解説、短い翻訳、書き換え、分類に向いています。一方で、長く複数の手順を踏む推論、大規模なコード生成、長文で一貫した文章作成には向きません。
4Bと7〜9Bモデルの品質差は、依然として明確にあります。マシンのメモリが8 GB以上で余裕があるなら、Qwen3.5 9B(Ollamaで6.6〜7.6 GB)のような7〜9Bモデルのほうが通常は良い選択です。7Bの推奨については最高の初心者向けローカルLLMモデルをご覧ください。
どの小型モデルを選ぶべきか? クイック選択ガイド
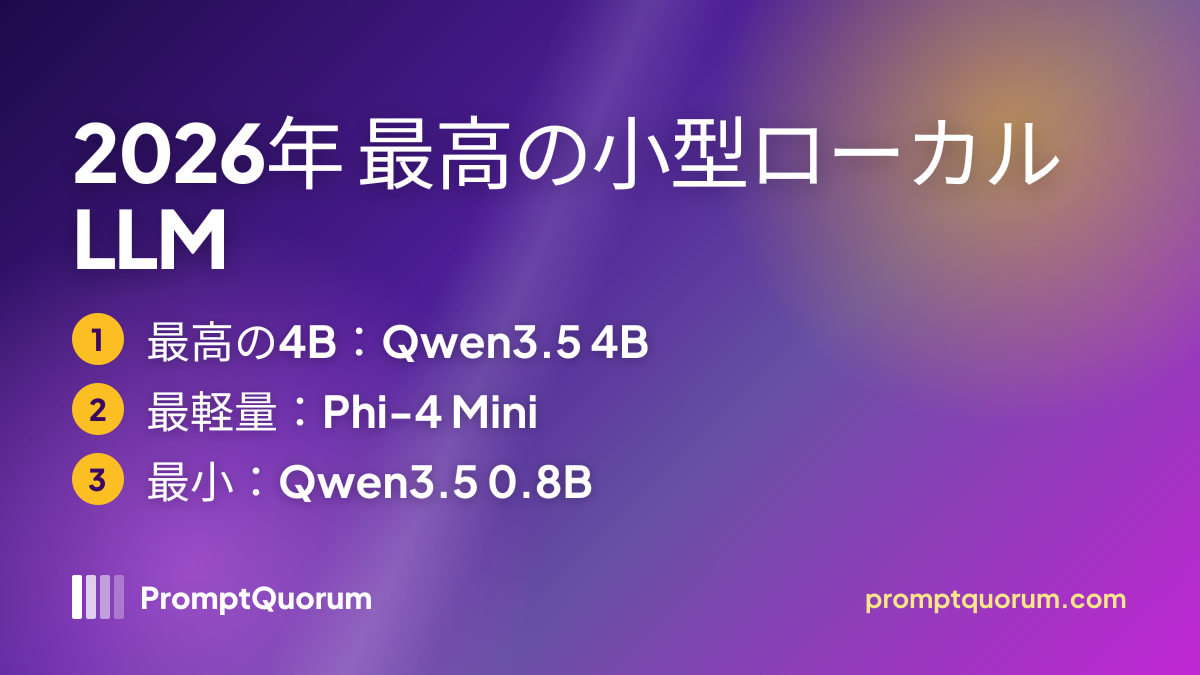
- RAM 8 GB以上で最高の品質がほしい場合: Qwen3.5 4B(`ollama run qwen3.5:4b`)。
- 画像とテキストを1つのモデルで扱いたく、12 GB以上ある場合: Gemma 4 E4B(`ollama pull gemma4:e4b`)。
- RAM 4〜6 GBで、英語の推論やコーディング支援がほしい場合: Phi-4 Mini 3.8B(`ollama run phi4-mini`)。
- RAM 4 GB、または英語以外のテキストを扱う場合: Qwen3.5 2B(`ollama run qwen3.5:2b`)。
- 空きRAMが3 GB未満、またはRaspberry Piクラスの機器の場合: Qwen3.5 0.8B(`ollama run qwen3.5:0.8b`)。性能の限界を踏まえてお使いください。
Qwen3.5 4B -- 総合で最高の小型LLM(最高の4Bモデル)
Qwen3.5 4Bは、この比較で最も強い4Bクラスのモデルです。Qwen自身のモデルカードでは、MMLU-Pro 79.1、GPQA Diamond 76.2、LiveCodeBench v6 55.8と報告されています。 2026年初頭にQwen3.5 Smallシリーズの一つとしてApache 2.0で公開されました。テキストと画像を扱え、ツール呼び出しに対応し、ネイティブのコンテキストウィンドウは262,144トークンです。
知っておくべき点が2つあります。1つ目は、Qwen3.5モデルが既定で思考することです。推論は向上しますがCPUでは遅いため、単純なタスクでは思考をオフにしてください。2つ目は、モデルカードが代表的なベンチマークをどのモードで測定したかを明記しておらず、Qwenの評価条件はGoogleやMicrosoftのものと異なることです。数値は一点一点を厳密に比べるのではなく、目安として比較してください。
スペック | 値 |
|---|---|
| MMLU-Pro | 79.1(ベンダー報告値) |
| GPQA Diamond | 76.2(ベンダー報告値) |
| LiveCodeBench v6 | 55.8(ベンダー報告値) |
| ダウンロード(Ollama) | 3.3〜4.0 GB |
| コンテキスト | 256Kトークン |
| ライセンス | Apache 2.0 |
| Ollamaコマンド | ollama run qwen3.5:4b |
Gemma 4 E4B -- 最高のマルチモーダル対応4Bクラスモデル
Google Gemma 4 E4Bは、Googleのモデルカードによると、MMLU-Pro 69.4%、LiveCodeBench v6 52.0%、GPQA Diamond 58.6%を記録しています。 「E4B」は実効パラメータ4.5Bを意味し、レイヤーごとの埋め込みを含めると約8Bパラメータになります。そのため「4B」という名称にもかかわらず、Ollamaのダウンロードは6.6〜9.5 GBです。テキストと画像を扱え、128Kのコンテキストウィンドウを備え、Apache 2.0で公開されています。
Googleのエコシステムを使いたい場合、強力な多言語性能(MMMLU 76.6%)がほしい場合、あるいはTau2エージェントスコア42.2%を重視する場合は、Qwen3.5 4BよりE4Bを選んでください。同クラスの品質をおよそ半分のディスク容量とメモリで得たいなら、Qwen3.5 4Bを選んでください。
スペック | 値 |
|---|---|
| MMLU Pro | 69.4% |
| LiveCodeBench v6 | 52.0% |
| GPQA Diamond | 58.6% |
| ダウンロード(Ollama) | 6.6〜9.5 GB |
| コンテキスト | 128Kトークン |
| ライセンス | Apache 2.0 |
| Ollamaコマンド | ollama pull gemma4:e4b |
Phi-4 Mini 3.8B -- 最も軽い4Bクラスモデル(2.5 GB)
Microsoft Phi-4 Miniは、モデルカードによるとMMLU 67.3%、MMLU-Pro 52.8%を記録しながら、ダウンロードは2.5 GBです。ここで紹介する4Bクラスのモデルの中で最小の容量です。 MITライセンスで、128Kのコンテキストウィンドウを備え、推論に重点を置いた厳選された合成データで学習されています。
推論ベンチマークではQwen3.5 4BやGemma 4 E4Bに及びません(GPQA 25.2に対して76.2と58.6)。そのため、メモリが制約となる4〜6 GBのマシンや、寛容なMITライセンスを重視する場合に選んでください。
スペック | 値 |
|---|---|
| MMLU(5-shot) | 67.3% |
| MMLU-Pro | 52.8% |
| GPQA Diamond | 25.2% |
| ダウンロード(Ollama) | 2.5 GB |
| コンテキスト | 128Kトークン |
| ライセンス | MIT |
| Ollamaコマンド | ollama run phi4-mini |
Qwen3.5 2B -- 4 GBマシン向けの最適解
4Bモデルが収まらないときは、Qwen3.5 2Bが最良の選択です。 Qwenのモデルカードでは、MMLU-Proは非思考モードで55.3、思考モードで66.5、GPQAは思考モードで51.6と報告されています。Ollamaでのダウンロードは2.7〜3.1 GBで、画像を扱え、256Kのコンテキストウィンドウを備え、Apache 2.0です。
0.8Bモデルと比べると、指示追従の信頼性がはるかに高く(IFEvalは非思考モードで61.2対52.1)、この比較の中で、実際の要約やQ&Aの作業に使える最小のモデルです。
スペック | 値 |
|---|---|
| MMLU-Pro | 非思考モード 55.3% / 思考モード 66.5% |
| GPQA | 51.6%(思考モード) |
| ダウンロード(Ollama) | 2.7〜3.1 GB |
| コンテキスト | 256Kトークン |
| ライセンス | Apache 2.0 |
| Ollamaコマンド | ollama run qwen3.5:2b |
Gemma 4 E2B -- エッジ向け・マルチモーダル対応の選択肢
Google Gemma 4 E2Bは、Googleのモデルカードによると、MMLU Pro 60.0%、LiveCodeBench v6 44.0%、GPQA Diamond 43.4%を記録しています。 実効パラメータは2.3B(レイヤーごとの埋め込みを含めると5.1B)です。実効パラメータ数は2 GBのファイルサイズを意味しません。Ollamaのダウンロードは4.6〜7.5 GBと掲載されており、同クラスの結果を得るのにQwen3.5 2Bより多くのメモリが必要です。
128Kのコンテキストウィンドウを備え、画像を扱え、Apache 2.0です。CPUのスループットはハードウェアと量子化によって異なります(Googleの報告ではRaspberry Pi 5のデコード速度は約7.6トークン/秒、独立したx86の報告では8〜48トークン/秒)。Googleのツールを使いたいエッジデバイスにはこちらを選んでください。それ以外では、Qwen3.5 2Bのほうが軽量です。
スペック | 値 |
|---|---|
| MMLU Pro | 60.0% |
| LiveCodeBench v6 | 44.0% |
| GPQA Diamond | 43.4% |
| ダウンロード(Ollama) | 4.6〜7.5 GB |
| コンテキスト | 128Kトークン |
| ライセンス | Apache 2.0 |
| Ollamaコマンド | ollama pull gemma4:e2b |
Qwen3.5 0.8B -- 実用になる最小モデル
Qwen3.5 0.8Bはこの比較で最小のモデルで、Ollamaでのダウンロードは1.2〜1.3 GB、256Kのコンテキストウィンドウを備え、ライセンスはApache 2.0です。ベンダー報告のMMLU-Proは29.7(非思考モード)、42.3(思考モード)、GPQAは11.9で、分類、キーワード抽出、短い書き換えには十分ですが、複数手順の推論や長い回答には向きません。RAMが本当に最大の制約である場合(利用可能なメモリが3 GB未満)、シングルボードコンピュータ上、またはパイプラインの高速な事前フィルタとしてのみ使ってください。
スペック | 値 |
|---|---|
| MMLU-Pro | 非思考モード 29.7% / 思考モード 42.3% |
| GPQA | 11.9%(思考モード) |
| ダウンロード(Ollama) | 1.2〜1.3 GB |
| コンテキスト | 256Kトークン |
| Ollamaコマンド | ollama run qwen3.5:0.8b |
完全比較:最高の小型ローカルLLM(0.8B〜4Bクラス)
モデル | MMLU-Pro | GPQA Diamond | ダウンロード(Ollama) | コンテキスト | 最適な用途 |
|---|---|---|---|---|---|
| Qwen3.5 4B | 79.1 | 76.2 | 3.3〜4.0 GB | 256K | 総合で最高の4B |
| Gemma 4 E4B | 69.4 | 58.6 | 6.6〜9.5 GB | 128K | マルチモーダル、Googleエコシステム |
| Phi-4 Mini 3.8B | 52.8 | 25.2 | 2.5 GB | 128K | 最も軽い4Bクラス、MIT |
| Qwen3.5 2B | 55.3 / 66.5 | 51.6 | 2.7〜3.1 GB | 256K | 4 GBマシン |
| Gemma 4 E2B | 60.0 | 43.4 | 4.6〜7.5 GB | 128K | エッジデバイス |
| Qwen3.5 0.8B | 29.7 / 42.3 | 11.9 | 1.2〜1.3 GB | 256K | 実用になる最小モデル |
スコアは各モデルのカードまたはOllamaページに掲載されたベンダー報告値で、評価条件はモデルごとに異なります。「a / b」は非思考モード / 思考モードを表します。あくまで目安としてご覧ください。ダウンロードサイズはOllamaに掲載されている範囲で、ビジョンエンコーダを備えるモデルはそれを含みます。
地域別の小型ローカルLLM
日本(METI・APPI): 小型モデルの日本語タスクでは、Qwen3.5とGemma 4 E4Bのどちらも、モデルカード上でMMMLUスコアが76前後です。制約のあるマシンで日本語の要約や翻訳を行う場合は、`ollama run qwen3.5:2b`または`ollama run qwen3.5:4b`を試してください。標準的なオフィス用PCで企業が使う場合、小型モデルの速度面の利点は大きいものの、実際の速度はCPUと量子化によって決まります。経済産業省(METI)のAI事業者ガイドラインや個人情報保護法(APPI)への対応を検討する企業では、Ollamaによるローカル実行により処理対象のテキストを端末内にとどめられます。ただし、個々の導入が要件を満たすかどうかは、システム全体の構成と社内ルールで別途確認が必要です。
中国・東アジア: Qwen3.5(Alibaba、Apache 2.0)は、中国語の小型モデル運用の自然な選択肢です。中国のデータセキュリティ法(数据安全法)の下でのIoTやエッジ展開では、`ollama run qwen3.5:2b`が約4 GBのRAMを備えたLinuxデバイスで動作し、外部APIを呼び出さずにテキストを端末内で処理します。自社の法令遵守義務は別途ご確認ください。韓国語を含む東アジア言語の処理にも、同じく2Bと4Bのモデルが現実的な出発点になります。
その他の地域(EU・GDPRなど): 現場作業、エアギャップ環境、古い業務用ノートPCなど、限られたハードウェアでAIを動かすEUの専門家にとって、小型ローカルモデルは、ランタイムやアプリのテレメトリーと同期を無効にしていれば、クラウドAPIを呼び出さずに端末内だけで推論を実行できます。標準的な社用ノートPCでQwen3.5 4BやPhi-4 Miniを動かせば、処理するテキストはすべて端末内にとどまり、GDPR第5条のデータ最小化の目標に資しますが、個々の導入が適合するかどうかは構成全体によって決まります。ライセンスは寛容で、Phi-4 MiniはMIT、Gemma 4とQwen3.5はApache 2.0です。このサイズでEU発の選択肢は限られるため、EU産であることが要件なら、Mistralの最新ラインナップをご確認ください。
小型ローカルLLMを動かすときのよくある間違いは?
- 単純なタスクで思考モードをオンのままにする: Qwen3.5モデルは既定で思考し、回答の前に多くの余分なトークンを消費します。CPUでのチャットや抽出ではオフにし(Ollamaでは`--think=false`)、数学や論理のためにとっておいてください。
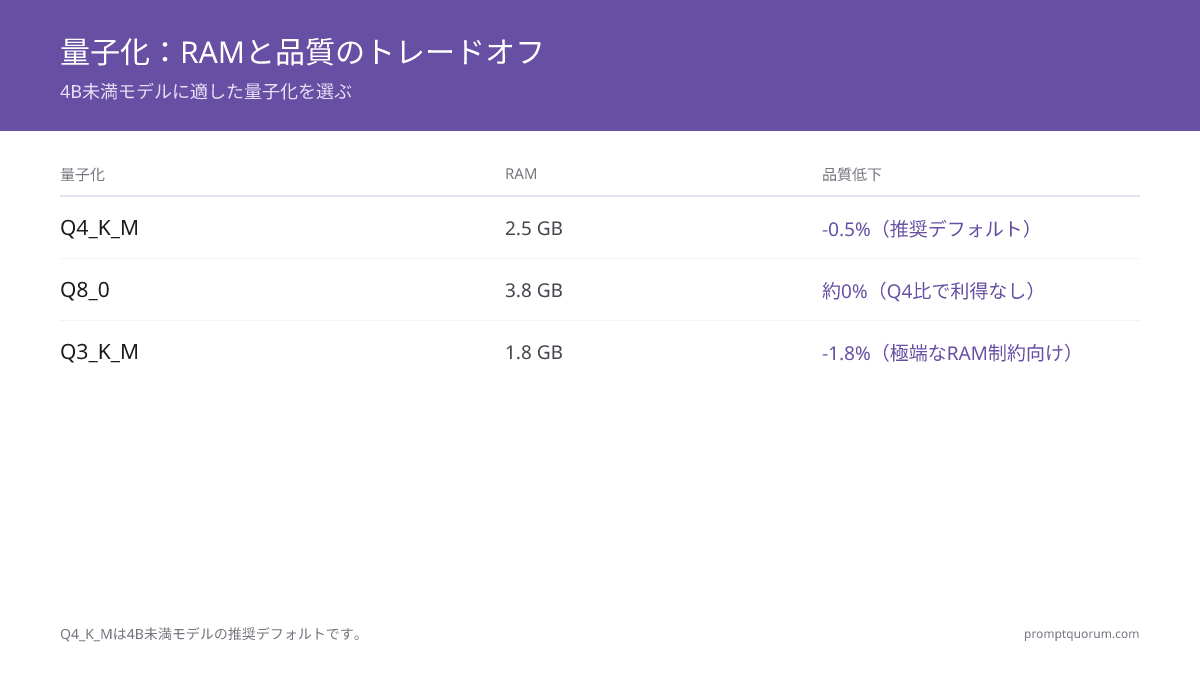
- Q4_K_Mではなく、Q8_0量子化を使う: Q8_0はQ4_K_Mのほぼ2倍のRAMを必要とするのに、小型モデルでは品質の向上はわずかです。4 GBのマシンではQ8_0がスワップを引き起こし、推論が数倍遅くなることがあります。小型モデルでは、Q4_K_Mを既定にしてください。
- instruct版ではなく、ベースモデルを動かす: ベースモデルはファインチューニング前のチェックポイントで、次のトークンを予測するだけで指示には従いません。「2+2は?」と尋ねると、「4」と答える代わりに、クイズの続きのように文を続けることがあります。このページに示した既定のタグは、いずれもinstruct版(指示チューニング済み)です。
- Gemma 4を「E2B/E4B」という名前だけで判断する: 実効パラメータという表記は、ダウンロードサイズを過小に見せます。Gemma 4 E4BはOllamaで6.6〜9.5 GBあるため、8 GBのマシンに取得する前に掲載サイズを確認してください。
- 小型モデルに7B以上の品質を期待する: 小型モデルが得意なのは、短く明確に定義されたタスクです。長い推論の連鎖、長文の執筆、繊細なコード生成は、7〜9Bモデルより明らかに弱くなります。出力品質が足りない場合は、Qwen3.5 9B(Ollamaで6.6〜7.6 GB)にステップアップしてください。
量子化を理解する:RAMと品質のトレードオフ
小型ローカルLLMモデルに関するよくある質問
ローカルで動かせる最高の小型LLMは?
RAM 8 GB以上のほとんどの方にとって、2026年の最高の小型ローカルLLMはQwen3.5 4B(Apache 2.0、`ollama run qwen3.5:4b`)です。Qwen自身のモデルカードではMMLU-Pro 79.1、GPQA Diamond 76.2と報告されており、Gemma 4 E4B(69.4 / 58.6)やPhi-4 Mini(52.8 / 25.2)を上回っています。4 GBのマシンでは、Qwen3.5 2BかPhi-4 Miniに切り替えてください。これらはベンダー報告値で評価条件も異なるため、差は正確な値ではなく目安として捉えてください。
最高の4Bモデルはどれですか?
ベンダー報告の推論ベンチマークでは、Qwen3.5 4Bがこの比較で最も強い4Bクラスのモデルです。256Kのコンテキストウィンドウを備え、Ollamaでのダウンロードも約3.3〜4.0 GBです。Gemma 4 E4B(実効パラメータ4.5B、埋め込みを含めると約8B)は最も近い対抗馬で、Googleのエコシステムを使いたい方には向いていますが、Ollamaのダウンロードは6.6〜9.5 GBになります。Phi-4 Mini 3.8Bは2.5 GBと最も軽く、MITライセンスですが、推論ベンチマークでは両モデルに及びません。
ローカルで動かせる最小のLLMは?
動かす価値のあるモデルの中では、Qwen3.5 0.8Bがこの比較で最小です。Ollamaでのダウンロードは1.2〜1.3 GBで、256Kのコンテキストウィンドウを備えています。分類、キーワード抽出、短い書き換えには十分ですが、ベンダー報告のMMLU-Pro 29.7(非思考モード)が示すとおり、複数の手順を要する処理は失敗します。さらに小さいモデルも存在しますが、約1Bパラメータを下回ると数文で文章が破綻し始めるため、アシスタントよりもオートコンプリート向きです。
実用的な出力が得られる最小のローカルLLMは?
要約、簡単なQ&A、書き換えで出力が安定してくるのは、2Bパラメータあたりからです。Qwen3.5 2B(ダウンロード2.7〜3.1 GB)は、この比較の中で実際の作業に使える最小のモデルです。Qwen3.5 0.8Bはハードウェア面の下限であり、品質面の下限ではありません。4 GB以上の余裕があるなら、4Bモデルはわずかなメモリ増加で一貫性が大きく向上します。
小型モデルはスマートフォンで動きますか?
動きます。QwenはQwen3.5の0.8Bと2Bをエッジデバイス向けに作られたモデルと説明しており、GoogleもGemma 4 E2BとE4BをスマートフォンやノートPC向けと位置づけています。ただしOllamaとLM StudioはiOSやAndroidでは動作しないため、モバイルでは別のアプリやフレームワークが必要で、実際の速度はスマートフォンのチップやランタイムに大きく左右されます。ダウンロードする前に、アプリ自体の対応モデル一覧を確認してください。
小型モデルは要約に向いていますか?
向いています。要約は小型モデルが特に得意とする用途の一つです。ここで紹介する6モデルはいずれも128Kトークン以上のコンテキストウィンドウを備えているため、文書の長さが制約になることはほとんどなく、制約になるのは長い入力全体で指示にどこまで従えるかです。最も安定しているのはQwen3.5 4BとGemma 4 E4Bです。0.8Bのモデルでは、入力を短く、出力を単純にしてください。
同じハードウェアで2Bモデルは7Bモデルよりどのくらい高速ですか?
CPUでは明確に速くなりますが、倍率はハードウェアと量子化に大きく左右されます。Google自身の数値ではGemma 4 E2Bのデコード速度はRaspberry Pi 5で約7.6トークン/秒、独立したx86 CPUの報告では量子化レベルによって8〜48トークン/秒と幅があります。GPUではスループットがモデルサイズに制約されにくいため、速度面の優位は小さくなります。固定の倍率を当てにせず、お使いのハードウェアの最新ベンチマークを確認してください。
小型モデルは関数呼び出し(ファンクションコーリング)に対応していますか?
対応しているモデルもあります。QwenはQwen3.5のモデルカードでこのファミリーがツール呼び出しに優れるとしており、Gemma 4 E4BはGoogleのカードでTau2エージェントスコア42.2%(E2Bは24.5%)と報告されているため、ツール利用ならE4Bのほうが無難です。構造化出力に依存するパイプラインを作る前に、対応状況はバージョンやランタイムによって異なるため、各モデルのドキュメントを確認してください。
英語以外の言語に最適な小型モデルは?
多言語ベンチマークのMMMLUでは、Qwen3.5 4BとGemma 4 E4Bは事実上並んでおり(モデルカード上で76.1対76.6)、どちらも2Bクラスのモデルを明確に上回ります。4 GBのマシンで中国語、日本語、韓国語、アラビア語を扱う場合は、Qwen3.5 2Bが現実的な選択です。より幅広い言語の比較については、Qwen・Llama・Mistralの多言語比較をご覧ください。
小型モデルで思考モードを使うべきですか?
単純なタスクでは、基本的に不要です。Qwen3.5モデルは既定で思考するため、回答の前に多くの余分なトークンを消費し、CPUでは遅く感じられます。チャット、書き換え、抽出では思考をオフにし(Ollamaでは `ollama run qwen3.5:4b --think=false`)、速度より精度が重要な数学、論理、複数手順の問題でのみオンにしてください。
Llama 3.2は今でも使う価値がありますか?
このページではもうランク付けしていません。Llama 3.2の1Bと3B(2024年)は、このページのどのモデルよりも古く、上記の新しい2B〜4Bモデルのほうが同程度のサイズで高性能です。ただし、依存しているツールやファインチューニング済みモデルがLlama 3.2を前提にしている場合は、引き続き有用です。
4BモデルにはどのくらいのRAMが必要ですか?
4ビット量子化の4Bモデルでは、空きメモリが4〜5 GB程度必要と考えてください(OllamaではQwen3.5 4Bが3.3〜4.0 GB、Phi-4 Miniが2.5 GB)。これに加えて、コンテキストウィンドウとOSの分も必要です。8 GBのマシンなら余裕があり、4 GBでは足りません。例外はGemma 4 E4Bで、掲載されているダウンロードが6.6〜9.5 GBのため、快適に使うには12〜16 GBのマシンが必要です。
小型モデルを2つ同時に動かせますか?
RAMの合計に余裕があれば可能です。Q4_K_Mの2Bクラスモデル2つで合計およそ6 GBを使うため、OSを軽く保てば8 GBのマシンでも動かせます。Ollamaは設定や空きメモリに応じて複数のモデルを読み込んだままにできるほか、別々のポート(OLLAMA_HOST=:11434とOLLAMA_HOST=:11435)で2つのOllamaインスタンスを起動する方法もあります。出力のA/Bテストに便利です。
小型モデルはRAG(検索拡張生成)に使えますか?
単純なRAGなら使えます。Qwen3.5 4BとPhi-4 Miniは、検索で取得した文書チャンクに対する質問に安定して答えられます。複数段階の推論を要する大規模なナレッジベースのRAGでは、7B以上のモデルのほうが安定した結果を出します。GPT4AllのLocalDocs機能は小型モデルで文書Q&Aを実行し、個人の文書コレクションに適しています。
出典
- Qwen3.5-4B、-2B、-0.8Bのモデルカード -- huggingface.co/Qwen/Qwen3.5-4B(ベンチマーク、ライセンス、コンテキスト長)
- Ollamaライブラリ:qwen3.5 -- ollama.com/library/qwen3.5(タグ、ダウンロードサイズ、コンテキスト)
- Google Gemma 4 モデルカード -- huggingface.co/google/gemma-4-E4B-it(E2BとE4Bのベンチマーク、ライセンス)
- Ollamaライブラリ:gemma4 -- ollama.com/library/gemma4(タグ、ダウンロードサイズ、ベンチマーク表)
- Microsoft Phi-4-mini-instruct モデルカード -- huggingface.co/microsoft/Phi-4-mini-instruct(MMLU、MMLU-Pro、GPQA、ライセンス)
- Ollamaライブラリ:phi4-mini -- ollama.com/library/phi4-mini(ダウンロードサイズ、コンテキスト)