重要なポイント
- Qwen3-Coder 30B(Alibaba、Apache 2.0) は2026年5月のデフォルトローカルコーディングモデルです — オープンウェイトモデル中でベンダー報告のHumanEval+方向をリードし、256Kトークンコンテキストウィンドウをサポートし、24GB消費者GPUのQ4_K_Mで実行できます。
- Qwen3-Coder 7B は最強の10B未満コーディングモデルです — 8~10GBカードに対応し、16GB MacBookで実行でき、30Bがオーバーキルである自動補完クラスワークフローに対応します。
- DeepSeek Coder V3 はこのセット中の最大の実用的なコンテキストウィンドウを提供し、マルチファイル推論で優れています — しかしフルモデルはQ4_K_Mで48GB以上のVRAMが必要です。小さいMoE派生バリアントが24GBカードのギャップを埋めます。
- Codestral 22B(Mistral) は高速選択肢です — より低いアクティブパラメータ数、高速推論、Mistralコマーシャルライセンスを通じた明確なコマーシャルパス。コーディング方向ではQwen3-Coderより若干遅れていますが、トークン毎秒では上回ります。
- Kimi K2.7 Code(Moonshot AI、2026年6月)はこのガイドで最も強力なエージェント型コーディングモデルです — Kimi K2.6をベースにしたコーディング特化ビルドで256Kコンテキストを備えますが、1T総パラメータ/約32Bアクティブ(MoE)で約340GB必要なため、サーバー級ハードウェア専用でワークステーション向けではありません。
- Granite Code(IBM、Apache 2.0) はライセンス明確性と監査態勢がリーダーボード位置より重要なエンタープライズコンテキスト向けに構築されています。34Bバリアントはファミリー中の最強です。8Bバリアントはノートパソコン選択肢です。
- StarCoder 2(BigCode、BigCode OpenRAIL-M) はこのセット中のプログラミング言語の最も広い範囲にまたがり、ニッチ言語(Rust、Lua、Haskell、Solidity)の強力な対応があります。
- VRAMはほとんどの読者にとって拘束制約です。 Q4_K_Mで最大のモデルを選択し、コンテキストとツーリング向けに2~4GBのヘッドルームを残してください — リーダーボードスコアが最も高いモデルではなく。
クイックファクト
- スイートスポット選択(2026年5月): 24GB GPUでのQ4_K_MのQwen3-Coder 30B。
- ノートパソコン/8~10GB GPU選択: Q4_K_MのQwen3-Coder 7B(~5GB)。
- ロングコンテキスト選択: 48GB以上のVRAMでQ4_K_MのDeepSeek Coder V3。
- 高速選択: Q4_K_Mの22B+ティア中最速のCodestral 22B。
- エンタープライズ/監査フレンドリー選択: Granite Code 34B(IBM、Apache 2.0)。
- ニッチ言語選択: StarCoder 2 15B(Rust、Lua、Haskell、Solidity対応)。
- Q4_K_MでのVRAM計算: おおよそ
(Bのパラメータ) × 0.6 GBプラス 2~4 GB コンテキストオーバーヘッド。 - ライセンスは等しくありません。 Qwen3-Coder、DeepSeek Coder V3、Granite CodeはApache 2.0です。CodestralはMistralノンプロダクションライセンスと個別のコマーシャル条件があります。Kimi K2.7 Code(Moonshot AI)はModified MITを使用し、大規模デプロイでは帰属表示が必要です。StarCoder 2はBigCode OpenRAIL-Mの下で提供されています。
2026年の6つのローカルコーディングモデルの比較
以下のすべての数字は、引用されたモデルカード(「ソース」セクションを参照)に対して公開されている検証可能です。HumanEval+方向はベンダー報告であり、ランキングシグナルとして扱ってください。正確な精度ではなく — 本番決定前にモデルカードで再確認してください。
📍 一文で説明
Qwen3-Coder 30Bはデフォルト2026年5月選択です;残りのフィールドはハードウェア適合、コンテキスト長、ライセンス態勢、または言語対応で勝ちます。
💬 簡潔に説明
6つのオープンウェイトコーディングモデル、すべてに対応する明確な「最良」の勝者はいません。Qwen3-Coderは公開コーディングベンチマーク方向でリードします;DeepSeekはコンテキストウィンドウでリードします;Codestralは高速でリードします;Graniteはライセンス明確性でリードします;StarCoderはニッチ言語対応でリードします。正しい選択は最大の制約が最大の制約と一致するものです。
モデル | サイズ | VRAM(Q4_K_M) | コンテキストウィンドウ | ライセンス | 最適な用途 |
|---|---|---|---|---|---|
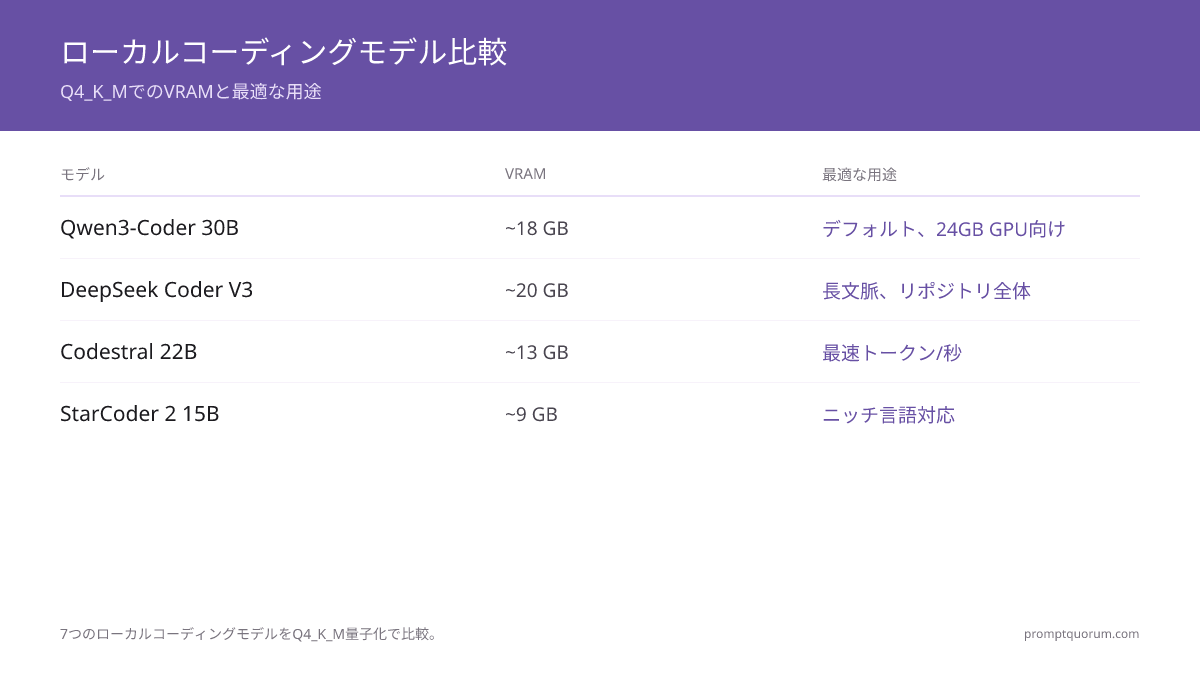
| Qwen3-Coder 30B | ~30Bパラメータ | ~17~18 GB | 256K | Apache 2.0 | 2026年5月24GB GPUs向けデフォルト選択 |
| Qwen3-Coder 7B | ~7Bパラメータ | ~5 GB | 128K | Apache 2.0 | ノートパソコン、8~10GB GPUs、自動補完ワークロード |
| DeepSeek Coder V3 | MoE、~36Bアクティブ(合計より大きい) | ~48GB+(フル);小さいバリアント~24GB | 128K(拡張可能) | Apache 2.0 | ロングコンテキスト、マルチファイル、リポジトリ全体推論 |
| Codestral 22B | ~22Bパラメータ | ~13 GB | 32K | Mistralノンプロダクション(Mistral経由でコマーシャル) | 高速推論、EUチームコマーシャルライセンスパス |
| Kimi K2.7 Code | 1T総パラメータ/32Bアクティブ(MoE) | ~340GB(RAM+VRAM合計) | 256K | Modified MIT | サーバー級エージェント型コーディング、長時間タスク |
| Granite Code 34B | ~34Bパラメータ | ~20 GB | 128K | Apache 2.0 | エンタープライズ監査、予測可能なライセンス態勢 |
| StarCoder 2 15B | ~15Bパラメータ | ~9 GB | 16K | BigCode OpenRAIL-M | 広言語対応。ニッチ言語を含む |

どれを選ぶべき
正しいモデルはリーダーボードランクではなく、拘束制約(VRAM、コンテキストウィンドウ、またはライセンス)によって決まります。 このショートカットを使用してください。
あなたの状況 | 選択 |
|---|---|
| 24GB GPUがあり、最高の汎用ローカルコーディングモデルが欲しい | Qwen3-Coder 30B |
| 12~16GB GPUがあり、強力な日常用モデルが欲しい | Qwen3-Coder 7B(品質ヘッドルーム付き)またはCodestral 22B(高速ヘッドルーム付き) |
| 8GB GPUまたは16GB MacBookがある | Qwen3-Coder 7B |
| 48GB以上のVRAMがあり、リポジトリ全体タスクで作業している | DeepSeek Coder V3 |
| コマーシャル製品を構築しており、ライセンス明確性が最も重要 | Granite Code 34B(Apache 2.0)またはDeepSeek Coder V3(Apache 2.0) |
| サーバー級ハードウェア(300GB以上のRAM/VRAM)があり、最強のエージェント型コーダーが欲しい | Kimi K2.7 Code |
| Rust、Lua、Haskell、Solidity、またはその他のニッチ言語を書く | StarCoder 2 15B |
| 優先順位は絶対品質ではなく、トークン毎秒である | Codestral 22B |

Qwen3-Coder:デフォルトローカルコーディング選択肢
Qwen3-CoderはAlibabaのオープンウェイトコーディングチューンモデルラインであり、2026年5月ではデフォルトローカルコーディングモデルです。 最強のHumanEval+方向、256Kコンテキストウィンドウ、Apache 2.0ライセンスの3つの、めったに一つのモデルで一緒に来ない特性を組み合わせています。
- サイズ: 30B(ヘッドラインモデル)および7B(ノートパソコンと8GB GPUモデル)。両方とも密なトランスフォーマー(専門家の混合ではない)。
- コンテキストウィンドウ: 30B向け256Kトークン;7B向け128K。MoE派生モデルに行かずにこのセット中で最大の1つです。
- トレーニング重点: コードヘビーな多言語トレーニングコーパス、Python、TypeScript/JavaScript、Java、C++、Go、Rustの強力な対応。ツール呼び出し例はポストトレーニングミックスの一部です。
- ライセンス: Apache 2.0 — 個別ライセンスなしのコマーシャル利用が許可され、帰属は保持されます。
- Q4_K_MでのVRAM: 30Bはおおよそ17~18GBに適合し、24GBカードのコンテキストとツーリング向けヘッドルームを残します。7Bはおおよそ5GBに適合します。
- ツール呼び出し信頼性: 厳格なツールスキーマ(Cline、Continue.dev Agent mode)を持つハーネス向けのオープンウェイトコーディングモデル中で最強。Clineが依存するXML形式信頼性は30Bで高く、7Bではより信頼できません。
- 輝く場所: 汎用コーディング(Python、TypeScript)、大規模コンテキストタスク(ファイル全体リファクター)、ツール使用エージェントループ。
- 弱い場所: 7Bバリアントはそのサイズについては良好ですが、マルチステップ推論で30Bと一致できません。ニッチ言語(Lua、Haskell、Solidity)はStarCoder 2より少ない対応を得ています。
💡ヒント: 24GB GPUで、Qwen3-Coder 30BをチャットAIエージェントロール向けQ4_K_Mで実行し、Qwen3-Coder 1.5BをQ4_K_Mで個別自動補完プロセスとして実行してください。合計VRAM:~19GB。分割は自動補完遅延を200ms未満に保ちながら、より大きいモデルはチャット内の非自明な作業を処理できます。
DeepSeek Coder V3:ロングコンテキストヘビーウェイト
DeepSeek Coder V3はコンテキスト長が拘束制約の場合に達するモデルです。 これは混合専門家(MoE)アーキテクチャを使用し、中程度のアクティブパラメータフットプリントで強力な推論を提供しますが、ハードウェア決定を形作る重いトータルモデルフットプリント。
- アーキテクチャ: MoE — アクティブパラメータより遠かに高いトータルパラメータ。フルモデルはアクティブカウントが示唆するより、ディスクとVRAMでより重い。
- コンテキストウィンドウ: 128Kトークン。量子化と推論エンジンに応じて、実用的なコンテキストをさらに拡張する拡張技術。
- トレーニング重点: コードと推論。Python、TypeScript、C++、Go上で強力。マルチステップ計画とチェーンオブソートスタイル推論は注目すべき強力さです。
- ライセンス: Apache 2.0 — コマーシャル利用が許可されます。
- Q4_K_MでのVRAM: フルV3は快適な推論向け48GB以上が必要です。蒸留と24GBカード向けより小さいMoE派生バリアントが存在します;ダウンロード前にモデルカードでバリアントを確認してください。
- ツール呼び出し信頼性: OpenAIスタイルツール呼び出しを許可するハーネスで強力;2026年5月ではClineの厳格XMLスキーマでQwen3-Coderより若干弱い。
- 輝く場所: リポジトリ全体推論、ロングコンテキストタスク、マルチステップエージェント計画。
- 弱い場所: ハードウェアバーはこのガイド内のどのモデルより最も高い。24GBカードでは、より小さい派生バリアントが唯一の実行可能なオプションであり、ロングコンテキストタスクでフルモデルに遅れています。
⚠️注意: DeepSeek Coder V3はこのガイド内で最も高いハードウェアバーを持っています — Q4_K_MでのフルモデルのためのVRAM 48GB以上。コミュニティ24GBターゲット派生物が存在し、実用的ですが、Qwen3-Coderを選択するメインの理由であるロングコンテキスト推論を放棄します。決定前にハードウェアにバリアントを一致させてください。
Codestral 22B:明確なコマーシャルパス付き高速選択肢
**Codestralはこが、おおむね後で基礎を補うのがわかります。
- サイズ: 22B(ヘッドライン)。コンテキストヘッドルーム付き16GB GPUに快適に対応します。
- コンテキストウィンドウ: 32Kトークン。Qwen3-CoderおよびDeepSeekより小さく、単一ファイルおよびほとんどのマルチファイル編集に十分ですが、リポジトリ全体作業で限定的。
- トレーニング重点: 幅広い多言語コード対応。Python、TypeScript、Java、C++、Bash強力パフォーマンス。
- ライセンス: デフォルトではMistralノンプロダクションライセンス;コマーシャル利用はMistralコマーシャルライセンス(有料)が必要。これはこのセット内で異通であり、コマーシャル製品の上にモデルを出荷するチーム向けの最も重要な事実です。
- Q4_K_MでのVRAM: ~13 GB — 16GB GPUで快適に対応し、24GBで快適です。
- 推論高速: 同じ量子化でQwen3-Coder 30Bより高速;DeepSeek Coder V3より幅広い速度。品質対高速トレードオフはこの6つ内で最もきれいです。
- 輝く場所: 16~24GBカード上のリアルタイム自動補完、Mistralコマーシャル関係が重要なEUチームワークフロー、チャット内の高速反復。
- 弱い場所: 32Kコンテキストはこのセット内のStarCoder 2の後で最小です。ライセンスストーリーはApache 2.0より関与しています — 統合前にMistralノンプロダクション条件を読んでください。
📌補足: Codestralのライセンスはこのセット内の唯一最大の「落とし穴」です。Mistralノンプロダクションは個人利用、評価、内部R&Dで問題ありません。コマーシャル製品向けには、Mistralコマーシャルライセンスを交渉するか、別のモデルを選択する必要があります — Apache 2.0代替案(Qwen3-Coder、DeepSeek Coder V3、Granite Code)はライセンス管理オーバーヘッドなしで同じ利用事例を対応します。
Kimi K2.7 Code:サーバー級エージェント型選択肢
Kimi K2.7 Codeはこのガイドで最も強力なエージェント型コーディングモデルです — そして単一のコンシューマー向けGPUでは動作しない唯一のモデルでもあります。 Moonshot AIが2026年6月にKimi K2.6をベースとしたコーディング特化ビルドとしてリリースしました。1兆パラメータのMixture-of-Expertsモデルで、アクティブパラメータは約320億。公開されている最小の量子化でも約340GBが必要なため、ワークステーションではなくサーバー級ハードウェアを前提とします。
- サイズ: サイズ展開は1つのみ — 1T総パラメータ、トークンあたり約32Bアクティブ(Mixture-of-Experts)。小型バリアントは存在せず、ノートパソコン向けの選択肢はありません。
- コンテキストウィンドウ: Kimi K2.6から引き継いだ256Kトークン。
- トレーニング重点: コーディング特化かつエージェント指向。Moonshotの報告によればK2.6と比較して推論トークンが約30%少なく、長時間タスクでの性能が向上— その差は単発の関数補完ではなく、複数ステップのタスクで表れます。
- ライセンス: Modified MIT — 商用利用は許可されていますが、大規模デプロイメントには帰属表示の要件があります。製品に組み込む前に修正条項を確認してください。
- メモリフットプリント: 同一アーキテクチャのK2.6で公開されている最小の量子化は約340GB。実用的な速度を得るには合計約350GBのRAM+VRAMが必要です。INT4が現実的なローカルフォーマットです。これはマルチGPUサーバーか非常に大きな統合メモリマシン向けであり、24GBカード向けではありません。
- ツール呼び出し信頼性: 長時間にわたるエージェント型ツール利用に設計の焦点があり、それがここでの高密度コーディングモデルとの違いです。ワークロードがマルチステップのエージェントループではなくインライン補完である場合、追加のハードウェアはほとんど見返りがありません。
- 輝く場所: すでに推論用ハードウェアを保有し、長時間のエージェント型コーディングジョブ — リポジトリ全体のリファクター、複数ファイルにまたがる移行、継続的なツールループを実行するチーム。
- 弱い場所: ハードウェアのハードルがほぼすべての個人開発者にとって選択肢から外れる理由になります。1台のマシンで作業する場合、Qwen3-Coder 30Bがより良いデフォルトであり、日常的なコーディングでの差は10倍のハードウェアコストが示唆するよりもはるかに小さいです。
💡ヒント: Kimi K2.7 Codeは小型モデルと二者択一の関係ではありません。現実的なパターンは、開発者一人ひとりのマシンでインライン補完と日常のチャットにQwen3-Coder 30Bを使い、共有サーバー上のKimi K2.7 Codeはリポジトリ全体のリファクターや移行など、256Kコンテキストと低い推論トークンコストがハードウェア投資に見合う長時間のエージェント作業のために確保しておくことです。
Granite Code:エンタープライズ/監査フレンドリー選択肢
IBMのGranite Codeラインはリーダーボード位置より多くのライセンス予測可能性と監査態勢が重要なエンタープライズコンテキスト向けに構築されています。 Apache 2.0、透過的トレーニングデータドキュメント、および測定されたリリース速度により、調達レビューで防御しやすい6つ内で最も簡単です。
- サイズ: 34B(ヘッドライン)および8B(ノートパソコン/8GB GPU)。密なトランスフォーマー、MoEではありません。
- コンテキストウィンドウ: 128Kトークン。
- トレーニング重点: コードヘビー多言語。意図的なトレーニングコーパスドキュメント — コード品質より調達上で重要なポジショニング選択。
- ライセンス: Apache 2.0 — Qwen3-CoderおよびDeepSeek Coder V3と同じ態勢。
- Q4_K_MでのVRAM: 34B向け~20GB、8B向け~5GB。
- コーディング方向: ほとんどの公開ベンチマークでQwen3-Coder 30Bに遅れています;PythonおよびJavaではCodestralと競争的、TypeScriptで後退。
- 輝く場所: 調達駆動選択、エンタープライズ監査コンテキスト、モデルカードのデータプロビナンスドキュメント自体が納品物である規制産業デプロイメント。
- 弱い場所: 絶対コーディング能力はリーダー以下です。調達が拘束制約ではない場合、Qwen3-CoderはQwen3-Coderがハードウェア予算上で強い選択肢です。
StarCoder 2:ニッチ言語選択肢
StarCoder 2はBigCodeのオープンウェイトコーディングモデルラインであり、2026年5月ではニッチプログラミング言語向けの最強のオープンウェイトモデルです。 このセット内のどのモデルより多くの言語を対応し、Lua、Haskell、Solidity、および長い少数の言語を含みます。
- サイズ: 15B(実用的なローカル選択肢)、7B、3B。密なトランスフォーマー。
- コンテキストウィンドウ: 16Kトークン — このセット内で最小であり、メイン制約。
- トレーニング重点: 深さを超えた幅 — 数百のプログラミング言語でトレーニング。少数言語の故意の対応。Pythonおよび TypeScriptパフォーマンスはリーダーに遅れていますが、Rust、Lua、Haskell、Solidity対応はオープンウェイトモデル向けベストインクラスです。
- ライセンス: BigCode OpenRAIL-M — 利用事例制限を伴う責任あるAIライセンス。コマーシャル統合前にライセンスを読んでください;Mistralノンプロダクションよりはるかに許容ですがApache 2.0より制限的。
- Q4_K_MでのVRAM: 15B向け~9 GB — 12または16GBカードに快適に対応します。
- 輝く場所: ニッチ言語作業(Rust、Lua、Haskell、Solidity、Elm、Julia)、ポリグロットコードベース、他のモデルが提供しない言語対応。
- 弱い場所: 16Kコンテキストウィンドウはこのセット内で最も小さい;絶対PythonおよびTypeScriptパフォーマンスはQwen3-CoderおよびDeepSeekの下。
量子化レベルによるVRAM計算
VRAMはほとんどのローカルコーディングモデル決定向けの拘束制約です。 簡単なルール:Q4_K_Mで、モデルウェイト向けおおよそ (Bのパラメータ) × 0.6 GB に加えて、コンテキストとツーリング向け2~4GB。より高い量子化(Q5、Q6、Q8)はVRAMを品質回復と取引します。
- Q4_K_M(デフォルト): ほとんどのコーディング作業向けサイズと品質の最強バランス。おおよそ十億パラメータ毎0.6GB。30Bモデルは~18GBに適合;7Bは~5GBに適合します。
- Q5_K_M: おおよそ十億パラメータ毎0.75GB。30Bモデルは~22GBが必要。品質回復はマルチステップ推論で小さいが測定可能。
- Q6_K: おおよそ十億パラメータ毎0.85GB。30Bモデルは~26GBが必要。32GBカード上のヘッドルームの価値あり。
- Q8_0: おおよそ十億パラメータ毎1.05GB。30Bモデルは~32GBが必要。FP16品質の半分VRAM最も近い。
- FP16(量子化なし): おおよそ十億パラメータ毎2.0GB。30Bモデルは~60GBが必要。ファインチューニングまたは研究向けのみ;ローカル推論には決して使用しません。
- コンテキストVRAMコスト: シーケンス長でスケール。経験則として、コーディングモデル上のアクティブコンテキスト毎32Kトークン約1GBが予想されます — DeepSeek Coder V3およびQwen3-Coderロングコンテキスト利用向け意味深い。
- ツーリングオーバーヘッド: Ollama、LM Studio、およびllama.cppはそれぞれモデルとコンテキストの上に~500MB~1GBを追加。アクティブツーリング向け合計2~4GBヘッドルームを許可してください。

💡ヒント: 量子化がどのように機能するか、およびQ4_K_Mがなぜほとんどの引用デフォルトであるかについてのより深い説明については、LLM量子化説明を参照してください。このガイドの残りは上記の計算を想定しています。
コンテキストウィンドウ比較
コンテキストウィンドウはVRAMの後の2番目の拘束制約であり、マーケティングコピーで最もオーバー評価されるメトリック。 コーディングモデルは請求されたウィンドウ全体で完全な注意品質を保持しません — 作業部分は通常より小さい。以下の引用された数字を実用的な制限ではなく、上界として使用してください。
モデル | 請求されたコンテキスト | 実用的作業コンテキスト(コーディング) | ノート |
|---|---|---|---|
| Qwen3-Coder 30B | 256K | ~64K~128K | 2026年5月内で最強のロングコンテキストコーディングモデルの中で。 |
| Qwen3-Coder 7B | 128K | ~32K~64K | 7Bクラスは常にいくつかのロングコンテキストリコール損失。 |
| DeepSeek Coder V3 | 128K | ~64K~96K | ウィンドウ全体を通じた強いリコール;ロングコンテキストリーダー。 |
| Codestral 22B | 32K | ~16K~24K | 22B+ティアで最小;リポジトリ全体作業向けきつい。 |
| Kimi K2.7 Code | 256K | ~32K~64K | ロングコンテキストリコールはQwen3-Coderに遅れています。 |
| Granite Code 34B | 128K | ~32K~64K | バランス済み;ロングコンテキストリーダーではありません。 |
| StarCoder 2 15B | 16K | ~8K~12K | このセット内の難い制限。 |

💡ヒント: 実用的作業コンテキストはマーケティング列ではなく、モデルがあなたのリポジトリを心に保つことができるかを決めます。マルチファイルリファクター向けには、見出しの数ではなく実際のリコール列を優先してください — Codestralの32Kは実際、Kimi K2.7 Codeの256Kは大部分が理論値です。
ライセンス比較
ライセンス条件はどのモデルがコマーシャル製品の内側で出荷されるかを決めます。 統合時にライセンスを確認してください — オープンソースコーディングモデルライセンスはリリース間で漂う傾向があり、ベンダーライセンスラインの場合は特に(Mistral、Llama)。
モデル | ライセンス | 個別ライセンスなしのコマーシャル利用? | キー制約 |
|---|---|---|---|
| Qwen3-Coder | Apache 2.0 | はい | 標準帰属;他の制限なし。 |
| DeepSeek Coder V3 | Apache 2.0 | はい | 標準帰属;他の制限なし。 |
| Codestral | Mistralノンプロダクション | いいえ | コマーシャル利用は有料Mistralコマーシャルライセンスが必要。 |
| Kimi K2.7 Code | Modified MIT | はい(但し注意) | 利用可能ポリシー;利用閾値以上で個別条件が適用。 |
| Granite Code | Apache 2.0 | はい | 標準帰属;他の制限なし。 |
| StarCoder 2 | BigCode OpenRAIL-M | はい(利用事例制限付き) | 高リスク応用向け利用事例制限;ライセンステキストに対して確認してください。 |

⚠️注意: Codestralのライセンスはそれでプロトタイプを作成し、再確認なしで出荷するチームを引っかかります。モデルが支払中のユーザーに触れる場合 — 間接的にも内部ツールを通じてカスタマーフェーシング成果物を生成してください — Mistralコマーシャルが必要です。ライセンス再交渉サイクルを避けるために統合前にQwen3-CoderまたはGranite Code(両方Apache 2.0)に移動してください。
デシジョンツリー:どれを選ぶべき
6つの質問、順序を通して、ほとんどの読者を正しい選択肢に到達させます。
📍 一文で説明
決定はリーダーボード順位ではなく、VRAMが最初、ライセンスが2番目、コンテキストが3番目 — Qwen3-Coderは24GBでApache 2.0上で安全なデフォルト;他の5つのピックはそれぞれQwen3-Coderが対応しない1つの特定の拘束制約のアドレス。
💬 簡潔に説明
しない限りQwen3-Coderにピック。理由は:ハードウェア(12GB未満→7B;48GB以上→DeepSeek)、言語(ニッチ言語対応→StarCoder 2)、調達(規制産業→Granite Code)、またはすでに保有するサーバー級ハードウェア(300GB以上のRAM/VRAM→Kimi K2.7 Code)。Codestralはコマーシャルライセンスを支払うことができる場合の高速選択肢。
- 1. あなたはどのくらいのVRAMを持っていますか? 12GB未満:Qwen3-Coder 7B。12~16GB:Qwen3-Coder 7BまたはCodestral 22B。24GB:Qwen3-Coder 30B。48GB以上:DeepSeek Coder V3(フル)。
- 2. あなたはコマーシャル製品の内側で出荷していますか? はい:Apache 2.0(Qwen3-Coder、DeepSeek Coder V3、Granite Code)を優先。Mistral コマーシャルライセンスを支払わない限りCodestralを避けてください。
- 3. あなたは32K以上のコンテキストウィンドウが必要ですか? はい:CodestralおよびStarCoder 2をスキップ。Qwen3-Coder、DeepSeek、またはGranite Codeを選択(ハードウェアがあればKimi K2.7 Codeも)。
- 4. あなたはニッチ言語(Rust、Lua、Haskell、Solidity)を書いていますか? はい:16Kコンテキスト制限にもかかわらずStarCoder 2 15B。
- 5. あなたは規制産業で、ライセンスとトレーニングデータプロビナンスが調達防御を必要としていますか? はい:Granite Code 34Bはケースを最も簡単に作ります。
- 6. まだ不確かですか? Qwen3-Coderにデフォルト — 24GB GPUがある場合は30B、そうでなければ7B。それをアウトグローする時に再評価。

💡ヒント: デシジョンツリーは意図的に短いです。ほとんどのチームはモデル選択を過度に考え、ハーネス選択を過度に考えていません — ハーネス側についてはContinue.dev vs Cline vs Aiderを参照してください。信頼できるピック内のモデル違いはハーネスフィット違いより小さい。
ローカルコーディングモデル選択の一般的な間違い
- 間違い1:ハードウェアに関係なくリーダーボードスコアが最も高いモデルを選択。 Q4_K_Mで対応せず、2~4GBのヘッドルームが緩い場合、ディスクに流出してインタラクティブコーディング不可能になります。VRAMはほとんどの読者向けの拘束制約。
- 間違い2:請求されたコンテキストウィンドウを実用的な作業ウィンドウとして信頼。 コーディングモデルは請求されたコンテキストのおおよそ半分を超えた注意品質を失う。見出しの数ではなく実用的なウィンドウの計画。
- 間違い3:ライセンスの読をスキップ。 Codestral(Mistral非本番)コマーシャル製品では調達失敗。Modified MITは高利用応用向けゲート。統合前にライセンスを読んでください。
- 間違い4:エージェントハーネス向けピック時にツール呼び出し信頼性を無視。 Clineの厳格XMLスキーマ、Continue.devのエージェントモード、およびMCPベースループはすべてモデルクリーンツール呼び出し発出信頼性に依存。コーディングチューン30B以上は信頼できる;7Bクラスは頻繁に失敗。
- 間違い5:より大きいチャットモデルと小さい自動補完モデルをペアにしていない。 30Bチャットモデルは200ms未満の自動補完向けオーバーキル。チャットモデル隣に1.5B~7B自動補完モデルを実行 — 合計VRAMは管理可能で、遅延はインタラクティブのままです。
- 間違い6:モデルカードを6か月毎に再確認していない。 オープンウェイトモデルラインは更新;量子化レシピは改善;ライセンスは時々緊縮。今日のデフォルト選択は2026年11月のデフォルト必ずしもではありません。

ソース
- Hugging FaceのQwen3-CoderモデルカードQwen3-CoderおよびQwen3-Coder 30B向けのアーキテクチャ、パラメータ数、コンテキストウィンドウ、ライセンス、およびベンダー報告ベンチマーク方向。
- DeepSeek Coder V3 Model Card — DeepSeek Coder V3向けのMoEアーキテクチャ詳細、コンテキストウィンドウ、ライセンス、およびベンチマーク方向。
- Codestral Model Card — Codestral 22B向けのアーキテクチャ、コンテキストウィンドウ、およびライセンス条件。
- Mistral Commercial Licensing — Codestralおよび他のMistralノンプロダクションライセンスモデルのコマーシャル利用向けに必要な条件。
- Kimi K2.7 Code on Hugging Face — Moonshot AIのモデルカード、量子化バリアント、およびModified MITライセンス全文。
- Granite Code Model Cards(IBM) — Granite Code向けのサイズ、コンテキストウィンドウ、トレーニングデータドキュメント、およびApache 2.0ライセンス。
- StarCoder 2 Model Cards(BigCode) — StarCoder 2向けのサイズ、コンテキストウィンドウ、言語対応、およびBigCode OpenRAIL-Mライセンス。
- Ollama Model Library — 上記の各モデル向けの量子化バリアント、ファイルサイズ、およびプルコマンド。
- BigCode OpenRAIL-M License Text — StarCoderラインモデル向けの完全ライセンステキストおよび利用事例制限。
よくある質問
ローカルコーディングモデル中でGPT-5コーディング最も近いのはどれですか?
オープンウェイトモデルはこのマンスで絶対コーディング能力向けフロンティア閉じたモデルと一致しません — GPT-5/Claude 4.x/Geminiフロンティアコーディングモードへのギャップはマルチステップ推論と希少ライブラリ利用で実際です。オープンウェイトモデル間で、Qwen3-Coder 30Bはに日常的コーディング作業向けの公開ベンチマーク方向でリード;DeepSeek Coder V3はロングコンテキストマルチファイル推論で最も近い。エディタ内インタラクティブコーディング向けには、ギャップはそれがサウンドより少ないものです — ローカルモデルはルーチンに自動補完および70~90%コード編集タスク向けに「十分」です。
Qwen3-CoderはTypeScript向けDeepSeekを打ちますか?
各ベンダーによって報告される見出しHumanEval+方向で、Qwen3-Coder 30Bは2026年5月の汎用コーディングタスク向けDeepSeek Coder V3の前方です。TypeScriptの具体的パフォーマンスはすべてのベンダーが言語毎分割を公開しないため比較しづらい — TypeScriptがあなたの一次言語の場合、現在の言語毎数向けのモデルカードを再確認。ほとんどのTypeScript作業向けIDEでは、両モデルは互換性があります。
埋め込まれた/Rust開発向けベストモデルはどれですか?
24GBのVRAMを持っている場合は汎用Rustの向けQwen3-Coder 30B。ニッチ埋め込まれた言語またはポリグロット埋め込まれたシステム作業と組み合わせてRustの向けStarCoder 2 15B — その言語対応はリーダーが重くトレーニングした場所を超えて拡張。より小さいGPU上の純Rust向けには、Qwen3-Coder 7Bは絶対Rust能力向けStarCoder 2の前にソリッド選択肢のままです。
16GB VRAMで30Bコーディングモデルを実行できますか?
Q4_K_Mではいいえ — 30Bモデルはq4_K_Mにおよそ17~18GBプラス2~4GBコンテキストオーバーヘッドが必要。オプション:攻撃的な量子化(Q3_K_Mは~14GBにVRAMを削減しますが注意可能な品質を犠牲)、代わりに22Bモデル使用(CodestralはQ4_K_Mでは16GBで快適に対応)、またはQwen3-Coderの7Bバリアント使用(ヘッドルーム向け)。24GBのGPUの買いは最もきれいな修正。
Codestralは2026年でまだ関連していますか?
はい — Codestral 22Bは22B+ティア内で高速リーダーのままであり、絶対リーダーボード順位より多くのトークン毎秒が重要な場合の正しい選択肢。その主要な欠点はMistral非本番ライセンスであり、コマーシャルデプロイメント向けの摩擦を追加。非コマーシャル利用向けまたは既にMistralコマーシャルライセンスを支払うチーム向けには、Codestralはほとんどの日常的コーディング作業でQwen3-Coderと競争。
どのモデルが100k+行ロングコンテキスト()をはるかに処理します?
このセット内のロングコンテキストコーディングタスク向けDeepSeek Coder V3は先導し、ウィンドウ全体を通じた強いリコール。Qwen3-Coder 30Bは256Kを請求しますが、実用的作業コンテキストはおおよそ64K~128Kに近い。真のリポジトリ全体タスク向け(100K行より多い)、どのモデルも完全注意を保有していない — タスクをより小さいスコープに分割するか、生コンテキスト長に依存するのではなく、コードベース上のレトリーバル拡張アプローチを使用。
コーディング特化モデルはコード向けの汎用モデルを打ちますか?
典型的なコーディング作業向けでは、はい。Qwen3-Coder 30BおよびDeepSeek Coder V3は両方ともコーディングベンチマークで類似サイズ汎用モデル(Llama 3.3 70B、Qwen3 32Bジェネラル)を上回る。ギャップはツール使用エージェントループおよびコード上のマルチステップ推論向け最大です。混合コーディング+推論タスク向け(仕様を読むデバッギングを必要と、アーキテクチャ提案)、強力な推論を伴う汎用モデルは時々優先。
これらの何のどれでもファインチューンできますか?
すべての6つはそれぞれのライセンスの下でファインチューニングを許可し、最も許容的はApache 2.0モデル(Qwen3-Coder、DeepSeek Coder V3、Granite Code)。30Bモデルの有意義なファインチューニングには推論より多くのVRAM(LoRA向けで典型的に80GB以上、完全ファインチューニング向けで多くの)が必要。ほとんどの読者向けには、コードベースのインデックスに対するレトリーバル拡張生成はファインチューニングより最初のよい大きな一歩です。
どのモデルが最も多くのプログラミング言語をサポートしますか?
StarCoder 2 — そのトレーニングコーパスはニッチ言語(Lua、Haskell、Solidity、Elm、Julia、Nim、Zig)を含む数百のプログラミング言語にまたがります。ポリグロットコードベースまたは一般的ではない言語での作業向けには、StarCoder 2 15Bはリーダー上で絶対品質が遅れていることにもかかわらず、最良のオープンウェイト選択肢。
オープンソースコーディングモデルはClaude/GPTに追いついていますか?
ルーティン コーディングタスク向けに(自動補完、単一ファイル編集、一般的なリファクター)、ギャップは狭く、継続的に閉まっています。ハードマルチステップ推論上、大規模コンテキスト全体リポジトリ作業、および希少ライブラリ利用向けには、ギャップは実際のままです。実用的含意:ほとんどのインタラクティブエディタ作業向けには、24GBのGPUでQwen3-Coder 30Bを実行することは「十分」で70~90%のタスク向けクラウドコーディングアシスタントを置き換える;残り10~30%はフロンティア閉じたモデルは依然として前方に引っ張ります。