コーディングに最適な14Bモデルは?
Hans Kuepper 著 · PromptQuorum創設者 · オープンウェイト/オープンソースAIの発見エンジン
重要なポイント
- ✓Qwen2.5-Coder 14B InstructはQwen自身のレポートでHumanEval 89.6%と、比較した3モデルで最高で、約10 GBのVRAM(ダウンロード9.0 GB)が必要です
- ✓DeepSeek-Coder-V2-Liteは16BのMixture-of-Expertsモデル(アクティブパラメータ2.4B)で、8.9 GBのダウンロードでHumanEval 81.1%です
- ✓StarCoder2 15B InstructはHumanEval 67.7%で、このベンチマークでは両モデルに及びません
- ✓VRAMが12 GBならQwen2.5-Coder 14Bを、8 GB未満なら7Bのコーディングモデルを使ってください。HumanEvalの数値はすべて各社公表のinstruct結果であり、PromptQuorumの実測ではありません
クイック回答
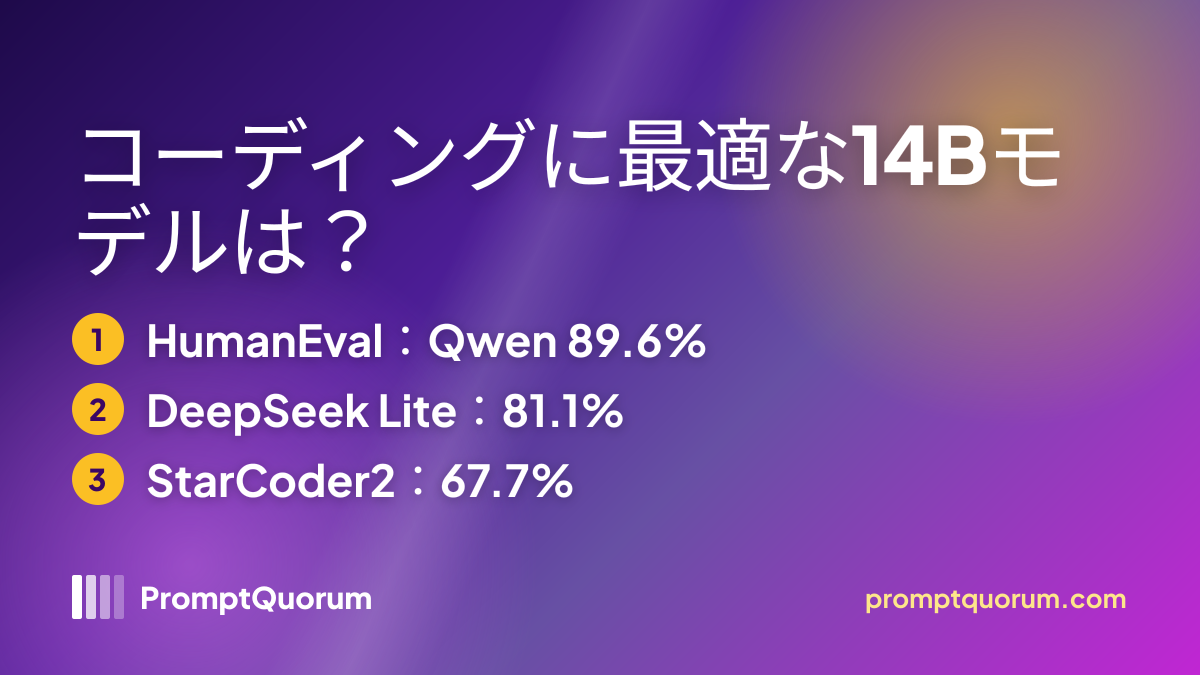
Qwen2.5-Coder 14Bは、Qwen自身のレポートで3つのコーディングモデルのうち最も高く、HumanEval(instruct)で89.6%です(DeepSeek-Coder-V2-Liteは81.1%、StarCoder2 15Bは67.7%)。qwen2.5-coder:14bのダウンロードは9.0 GBなので、約10 GBのVRAMを見込んでください。
- ▸Qwen2.5-Coder 14B Instruct:HumanEval 89.6%、ダウンロード9.0 GB(ollama run qwen2.5-coder:14b)
- ▸DeepSeek-Coder-V2-Lite(16B MoE、アクティブ2.4B):HumanEval 81.1%、ダウンロード8.9 GB
- ▸StarCoder2 15B Instruct:HumanEval 67.7% — いずれも各社の公表値であり、PromptQuorumの実測ではありません
Qwen2.5-Coder 14BがHumanEvalで首位
Qwen2.5-Coder-14B-Instructは、Qwen2.5-Coder技術レポートでHumanEval 89.6%を記録し、比較した3モデルで最高です。これは各社公表のinstruct結果であり、PromptQuorumの実測でもQ4_K_Mの結果でもありません。量子化したローカル版では多少異なる場合があります。
DeepSeek-Coder-V2-Lite-Instructは同じ表で81.1%です。総パラメータ16B・アクティブ2.4BのMixture-of-Expertsモデルで、密な14Bモデルではありませんが、Ollamaのダウンロードが8.9 GBのため同じVRAMクラスに入ります。HumanEvalの8.5ポイント差はQwenに有利で、すでに使っているならDeepSeekも妥当な代替です。
StarCoder2-15B-Instruct-v0.1は同じ表で67.7%です。The Stack v2で学習されリポジトリ指向の作業に向きますが、HumanEvalでは上の2モデルに及びません。
| モデル | HumanEval(instruct) | アーキテクチャ |
|---|---|---|
| Qwen2.5-Coder 14B | 89.6% | 14.7B(密) |
| DeepSeek-Coder-V2-Lite | 81.1% | 16B MoE(アクティブ2.4B) |
| StarCoder2 15B | 67.7% | 15B(密) |
VRAMの余裕が選択を決める
Qwen2.5-Coder 14BとDeepSeek-Coder-V2-Liteはいずれも Q4_K_Mで約10 GB VRAMが必要で、12 GBカードでは2 GBしか余裕がありません。この余裕は長いコンテキストセッションでは不十分です:8kコンテキストではVRAM使用量は~11.5 GBに達します。大きなファイルを扱うワークフローでは16 GB以上のカードを推奨します。
4kトークン未満のコンテキストウィンドウ(単一ファイル補完の一般的なケース)では、3つのモデルすべてがRTX 3060 12 GBやRTX 3080 Ti 12 GB上で快適に動作します。QwenとDeepSeek Coderでの速度は約14〜18 tok/sです;StarCoder2 15Bは同等のVRAM消費量を考えると同様のスループットで動作します。リポジトリ規模の検索やオープンソース貢献パターンに焦点を当てるワークフローではStarCoder2を優先します。
他のサイズとVRAMティアにおけるコーディングモデルの包括的な比較については、12 GB VRAM向け最適コーディングLLMガイドをご覧ください。
汎用14Bモデルのおすすめ:Qwen3 14BとPhi-4
コーディング以外の用途では、Ollamaの主な汎用14BモデルはQwen3 14B(qwen3:14b、ダウンロード9.3 GB、コンテキスト40K)とPhi-4(phi4:14b、9.1 GB、コンテキスト16K)です。どちらも標準のQ4量子化で12 GBカードに収まり、上記のコーディング向けモデルと同じVRAMクラスです。
Qwen3 14Bは長いコンテキストと幅広い多言語利用に向き、Phi-4は推論や数学が中心のプロンプトを狙っています。純粋なコードでは、上記の専用モデルが引き続き優位です。汎用モデル同士の直接ベンチマークは実施していないため、スコアは記載していません。
| モデル | Ollamaタグ | ダウンロード | コンテキスト |
|---|---|---|---|
| Qwen3 14B | qwen3:14b | 9.3 GB | 40K |
| Phi-4 | phi4:14b | 9.1 GB | 16K |