12 GB VRAMでコーディングに最適なローカルLLMは?
Hans Kuepper 著 · PromptQuorum創設者 · オープンウェイト/オープンソースAIの発見エンジン
重要なポイント
- ✓Gemma 4 12B(Google、Apache 2.0):ダウンロード7.7〜8.0 GB、256Kコンテキスト、LiveCodeBench v6で72.0%(メーカー公表値)— 12 GBのGPUならこれが最有力のコーディングモデル
- ✓Qwen2.5-Coder 14B Q4_K_M(約9 GB)はコード特化の有力な選択肢ですが2024年のモデルで、Qwen3.8 27B(18 GB)など新しいQwenコーダーは12 GBを超えます
- ✓Devstral Small 2(24B、15 GB)とQwen3.8 27B(18 GB)は、12 GBではCPUオフロードでしか動かず、生成速度が大きく低下します
- ✓コーディングではコンテキストウィンドウを8192以上に引き上げてください(既定値では実際のソースファイルが切り詰められます)。ollama psでモデルがGPUに完全に載っているか確認します
クイック回答
12 GB VRAMのGPUで最適なコーディングモデルはGemma 4 12Bです。Ollamaのダウンロードは7.7〜8.0 GBで、Googleは12BモデルのLiveCodeBench v6スコアを72.0%と公表しています。コード特化の代替はQwen2.5-Coder 14B(約9 GB)です。Qwen3.8 27B(18 GB)とDevstral Small 2(15 GB)は12 GBに収まりません。
- ▸Gemma 4 12B:ダウンロード7.7〜8.0 GB、256Kコンテキスト、Apache 2.0
- ▸Qwen2.5-Coder 14B Q4_K_M:約9 GB、コード特化、fill-in-the-middle対応
- ▸Ornith 9B:5.6 GB、MITライセンス、エージェント型コーディング向け
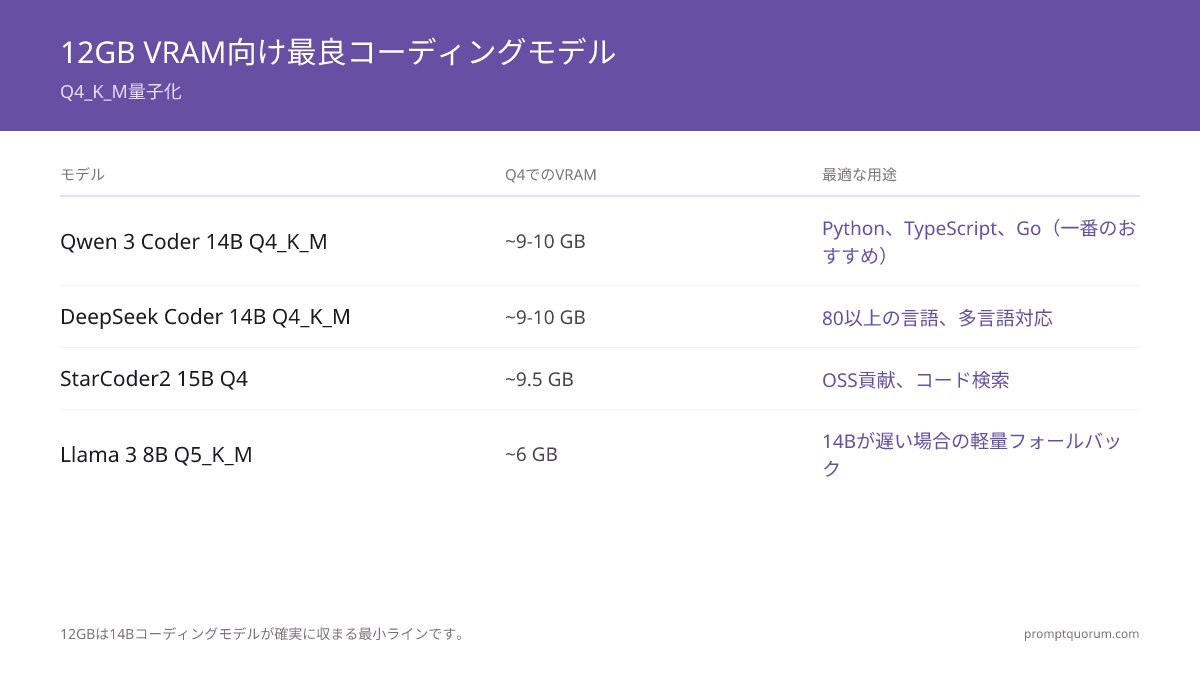
12 GBで選ぶべきコーディングモデル
12 GB VRAMのGPUで最適なコーディングモデルはGemma 4 12Bです。Ollamaのダウンロードは7.7〜8.0 GBでKVキャッシュに約4 GBの余裕が残り、Googleは12BモデルについてLiveCodeBench v6で72.0%、Codeforces Eloで1659を公表しています。ライセンスはApache 2.0、256Kのコンテキストウィンドウに対応し、画像入力も受け付けるため、エラーやUI不具合のスクリーンショットをそのまま貼り付けられます。これらのベンチマーク値はメーカー公表値で、当サイトでは独自測定を行っていません。
Qwen2.5-Coder 14B Q4_K_M(約9 GB)も収まり、fill-in-the-middleに対応するコード特化の選択肢ですが、2024年のモデルです。Ornith 9B(5.6 GB、MITライセンス)はエージェント型コーディングを狙ったモデルで、長いコンテキスト用の余裕が最も大きくなります。Devstral Small 2(24B、15 GB)とQwen3.8 27B(18 GB)は12 GBを超え、CPUオフロードでのみ動作します。
8 GBのカードをお使いの場合は、AMD 5700X + RTX 3070 Ti向けのおすすめLLMで8 GBの妥協案を確認してください。
| モデル | ダウンロードサイズ | 最適な用途 |
|---|---|---|
| Gemma 4 12B | 7.7〜8.0 GB | 第一候補:コーディング、画像、256K |
| Qwen2.5-Coder 14B Q4_K_M | 約9 GB | コード特化、fill-in-the-middle |
| Ornith 9B | 5.6 GB | エージェント型、長文脈の余裕 |
| Devstral Small 2 24B | 15 GB | 収まらない。CPUオフロード必須 |
| Qwen3.8 27B | 18 GB | 収まらない。18 GB以上が必要 |
コーディングで効く設定
コーディングではコンテキストウィンドウを最低8kに設定してください。既定の短いウィンドウでは数百行のソースファイルが切り詰められます。Gemma 4 12Bの重み約8 GBなら、12 GBのカードでKVキャッシュとランタイムに約4 GBの余裕が残ります。Qwen2.5-Coder 14Bは約9 GBで余裕が小さいため、コンテキストは控えめにしてください。サーバー起動前にOLLAMA_CONTEXT_LENGTH=8192を設定するか、ollama run内で/set parameter num_ctx 8192を実行し、ollama psでモデルがCPUと分割されずGPUに載っていることを確認します。
Flash Attention(OLLAMA_FLASH_ATTENTION=1)を有効にし、さらにコンテキストが必要ならOLLAMA_KV_CACHE_TYPE=q8_0を設定します。既定のf16キャッシュに比べKVキャッシュのメモリが約半分になり、品質低下はわずかです。環境変数は1回の起動で組み合わせられます。
12 GBを超える全体ランキングは、コーディング向けベストローカルLLMガイドをご覧ください。
ollama pull gemma4:12b
ollama run gemma4:12b

# code-specialised alternative
ollama pull qwen2.5-coder:14b-instruct-q4_K_M関連ガイド
- ▸コーディング向けベストローカルLLM -- 12 GBを超える全体ランキング
- ▸Best MoE Models for Local Coding -- MoEコーディングモデル
- ▸Continue.devがCursorに買収:終了と代替ツール -- コーディングツール比較
12 GB VRAM向けコーディングLLMのクイック回答
12 GB VRAMで最適なコーディングモデルは?▾
12 GB VRAM全般で最適なローカルLLMは?▾
Qwen3.8 27BとDevstral Small 2は12 GB VRAMに収まりますか?▾
12 GBではQ4_K_Mと、より高い量子化のどちらを使うべきですか?▾
OllamaでこれらのモデルのFIM(fill-in-the-middle)補完は使えますか?▾
/api/generateのsuffixフィールドでカーソル以降のテキストを受け取ります。エディタに組み込む前に、各モデルのOllamaページで挿入対応を確認してください。オートコンプリートにはQwen2.5-Coderが無難です。