CPU専用で使えるOllamaの最適モデルは?
Hans Kuepper 著 · PromptQuorum創設者 · オープンウェイト/オープンソースAIの発見エンジン
重要なポイント
- ✓CPU推論はGPUより5〜10倍遅く、最新の8コアデスクトップCPUで7Bモデルは3〜6 tok/sが目安です
- ✓CPUで最速:Qwen3 0.6B(約35 tok/s)とGemma 3 1B(約19 tok/s)、古いi5ノートPCでの独立テスト
- ✓CPUで最高品質:Phi-4 Mini Q4、RAM約4 GB、同じテストで約7 tok/s
- ✓CPU推論はバッチ処理や単発クエリには実用的ですが、対話型チャットには遅すぎます
クイック回答
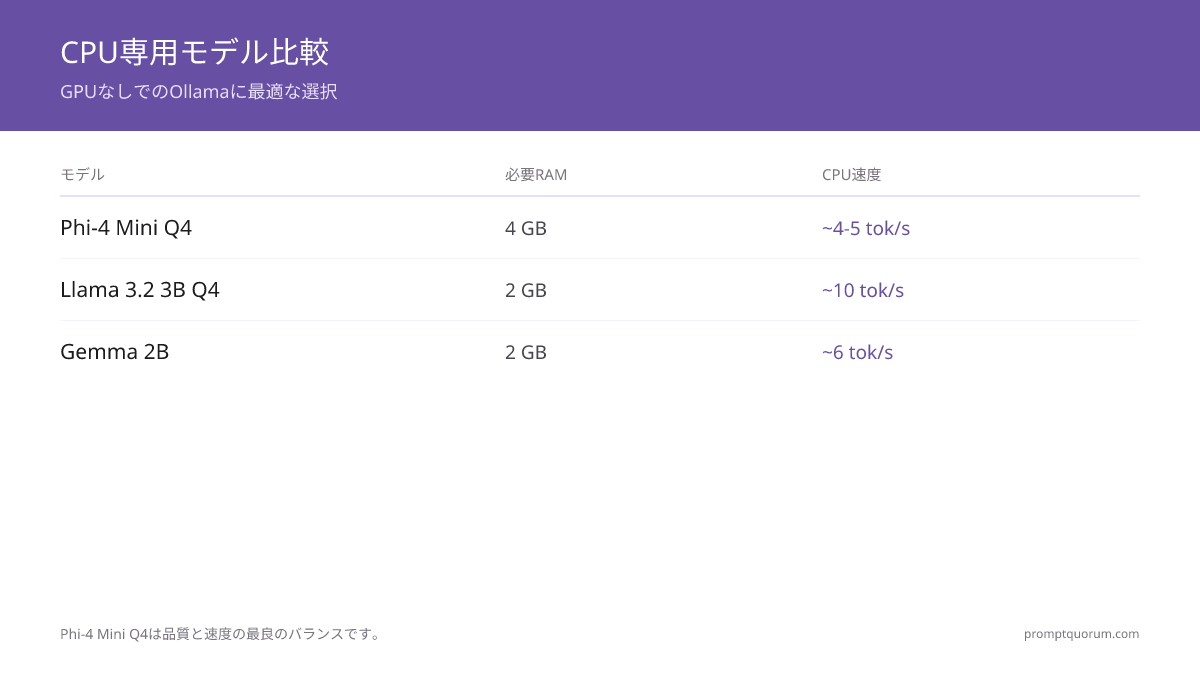
CPU専用で最速のOllamaモデルはQwen3 0.6B(独立テストで約35 tok/s)またはGemma 3 1B(約19 tok/s)です。GPUなしで回答品質を重視するなら、Phi-4 Mini Q4(約7 tok/s、RAM約4 GB)またはLlama 3.2 3B Q4を選びます。RAM 2 GBのマシンは1Bパラメータ以下に留めてください。
- ▸最速:Qwen3 0.6B(約35 tok/s)とGemma 3 1B(約19 tok/s)、どちらもRAM 2 GBに収まる
- ▸最高品質:Phi-4 Mini Q4(約7 tok/s)、RAM約4 GB必要
- ▸バランス型:Llama 3.2 3B Q4、ダウンロード2.0 GB、RAM約4 GB
CPUの速度の現実
CPU推論は最新の8コアデスクトップCPUで毎秒3〜6トークンで動作します — ミドルレンジGPUの約5〜10倍遅いです。 Q4のモデル 7BはCPU上でおよそ200〜300ミリ秒ごとに1単語を生成します。
この速度が許容できるのは2つのユースケースです:ドキュメントの要約やデータ分類などの夜間バッチ処理、および30秒の待機が許容できる単発クエリ。対話型チャットやリアルタイムコード補完には、CPU推論は実用的には遅すぎます。
根本的な制約はメモリ帯域幅であり、CPUのクロック速度ではありません。コンシューマーCPUはRAMを40〜80 GB/sで読み取ります。専用GPUはVRAMを400〜900 GB/sで読み取ります。LLM推論はメモリ帯域幅に直接比例します — そのためミドルレンジGPUでさえハイエンドCPUよりも劇的に高速な推論を実現します。
CPU専用で使えるモデル上位4選
Qwen3 0.6BとGemma 3 1BはCPU専用で最速のOllamaモデルで、回答品質が最も高いのは約7 tok/sのPhi-4 Mini Q4です。以下の速度は、RAM 12 GBの古いIntel i5ノートPCでの独立したIt's FOSSのCPU専用テストによるものです。メモリが高速なCPUではより速くなります。
RAMが2 GBに制限される場合、Gemma 3 1B(ダウンロード806 MB)とQwen3 0.6B(523 MB)が現実的な選択肢ですが、多段階の推論力は劣ります。Gemma 4 E2B(ダウンロード4.6 GB以上、同じテストで約10 tok/s)のような大型モデルは、4 GBのマシンでは足りないメモリを必要とします。
RAMの要件やOSレベルの最適化を含むCPU専用設定の完全な比較については、CPU専用LLMガイドをご覧ください。
| モデル | Ollama DL容量 | 最小RAM | CPU速度 |
|---|---|---|---|
| Qwen3 0.6B | 523 MB | 約2 GB | 約34〜36 tok/s |
| Gemma 3 1B | 806 MB | 約2 GB | 約19 tok/s |
| Llama 3.2 3B Q4 | 2.0 GB | 約4 GB | 未テスト |
| Phi-4 Mini Q4 | 2.5 GB | 約4 GB | 約7 tok/s |
関連ガイド
- ▸Radeon 6800MでローカルLLMを動かす:完全セットアップガイド -- Radeon GPU guide
- ▸Strix Halo + Ollama + Vulkan: パフォーマンスガイド -- Strix Halo guide