今おすすめのOllamaモデルは?
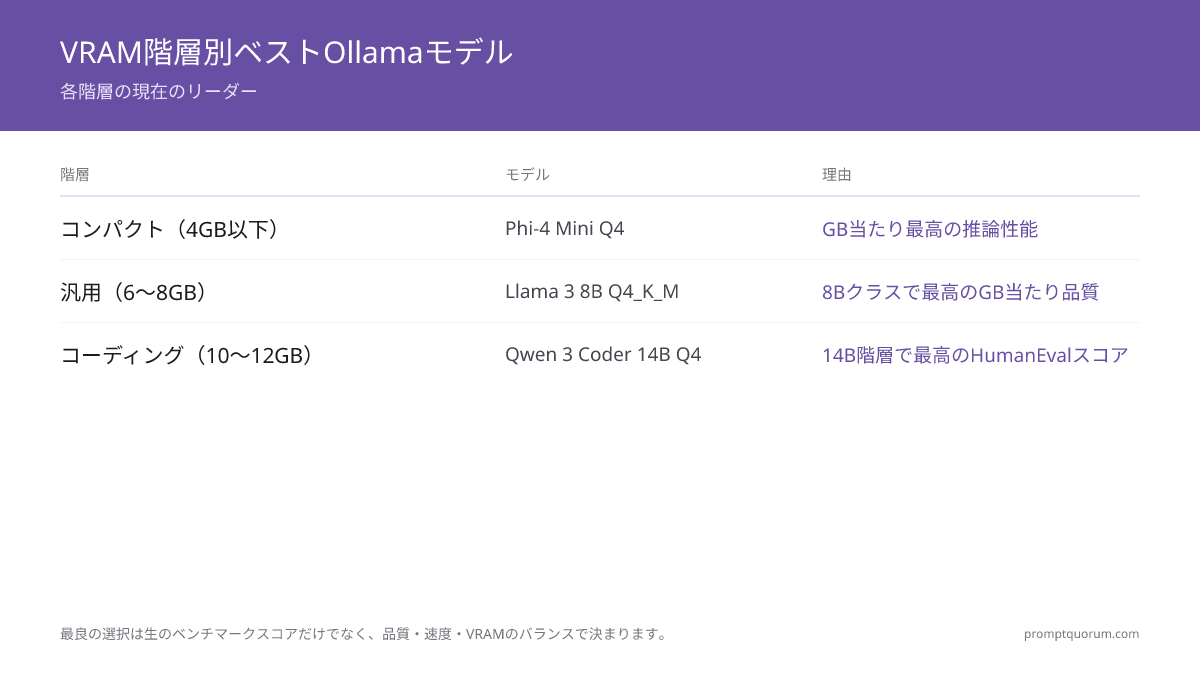
クイック回答
汎用ではqwen3.5:9b(ダウンロード6.6 GB)が現時点で最も有力です。コーディングにはqwen2.5-coder:7b(4.7 GB)があり、多くの記事が主張するよりずっと控えめなハードウェアで足ります。軽量構成ならllama3.2:3bが2.0 GBで動きます。サイズはすべて2026年8月28日にOllamaライブラリから読み取ったものです。
- ▸汎用最良: qwen3.5:9b — 6.6 GB
- ▸コーディング最良: qwen2.5-coder:7b — 4.7 GB
- ▸軽量最良: llama3.2:3b — 2.0 GB
重要なポイント
- ✓汎用最良: qwen3.5:9b — ダウンロード6.6 GB。Ollamaで実際に入手できる最新のQwen世代
- ✓コーディング最良: qwen2.5-coder:7b — 4.7 GB。qwen3-coderが19 GBからなので、費用対効果ではこちらが有利
- ✓軽量最良: llama3.2:3b — 2.0 GB。推論の過程を見たいならdeepseek-r1:1.5b(1.1 GB)も
- ✓比較している数値に注意してください。これはOllamaライブラリのダウンロードサイズであり、VRAM要件ではありません。コンテキストウィンドウのぶん、ダウンロードサイズより余裕を見てください
- ✓半年前のモデルでも量子化が成熟していれば、コミュニティの支援が限られた最新リリースを上回ることが多くあります
3つのティアのリーダー
汎用では現在qwen3.5:9b(ダウンロード6.6 GB)が選択肢です。以下のサイズは2026年8月28日にOllamaライブラリから直接読み取りました。
実際の「最良」とは、出力品質・推論速度・メモリ効率の最高バランスを意味します。生のベンチマークスコアだけではありません。実際に収まる9Bモデルのほうが、ディスクにあふれる30Bモデルより役立ちます。
訂正しておきたい数値があります。コーディングモデルは多くの記事が示すより手頃です。qwen2.5-coder:7b はダウンロード4.7 GBで、特別なプロンプトなしにPython、TypeScript、Goを扱えます。新しい qwen3-coder は19 GBからで、単なるアップグレードではなくまったく別のハードウェア階層です。
| ティア | モデル | ダウンロード | リードの理由 |
|---|---|---|---|
| 軽量 | llama3.2:3b | 2.0 GB | 小型帯でGB当たり品質が最良。8,160万プル |
| 汎用 | qwen3.5:9b | 6.6 GB | Ollamaで入手できる最新のQwen世代 |
| コーディング | qwen2.5-coder:7b | 4.7 GB | qwen3-coderのごく一部のサイズで強いコード出力 |
| 推論 | deepseek-r1:8b | 5.2 GB | 9,200万プルでOllama第2位のダウンロード数 |
新しいモデルが必ずしも優れているわけではない
新しいモデルのリリースが自動的に最良のOllamaの選択になるわけではありません。量子化の品質、コミュニティのファインチューン、Ollama統合の成熟には、新しいリリースから4〜8週間かかります。
プル数はどのベンチマークよりも雄弁です。llama3.1 は1億1,890万プルでいまもライブラリ最多、llama3.2 は8,160万プルで、いずれも新しい参入をすべて上回ります。これは惰性ではなく、量子化がよく最適化され、ハードウェアをまたいで挙動が読める製品が選ばれているということです。
新世代を使いたいなら gemma4(7.2 GB)と gpt-oss:20b(14 GB、128Kコンテキスト)が候補です。本番で頼る前に、6週間以上首位を保つか見てください。ワークロードに応じた評価方法の詳細はOllama向けトップオープンソースモデルをご覧ください。
関連ガイド
- ▸AIモデルダウンロードに最適なVPN -- VPN for AI downloads
- ▸Ollama 128Kコンテキストモデル -- long context models
- ▸Ollamaの最新バージョン:何が新しい? -- Ollama updates
- ▸Mistral Small 24B vs Qwen 3 14B vs Llama 3.1 8B -- model comparison