Ollamaの最新バージョンと変更点は?
現在のOllamaバージョン:v0.40.5(2026年10月14日リリース)。これが最新の安定版で、ollama.com/downloadから入手できます。10月16日にv0.40.6のプレリリースが公開されましたが、まだ安定版ではありません。`curl https://ollama.ai/install.sh | sh`(macOS:`brew upgrade ollama`)で更新し、`ollama --version`で確認してください。
v0.33〜v0.40系列の変更点(2026年8月〜10月): v0.33.0(8月21日)はClaude Desktopをサードパーティゲートウェイとして有効化し、KVキャッシュのプリフィル復元ポイントの信頼性を高めました。v0.34.0(9月5日)はChatGPT DesktopでOllamaモデルを使えるようにし、Apple Siliconでの構造化出力を高速化。v0.34.1(9月14日)はMLX safetensorsでの`ollama create`の実験扱いを解除しました。v0.40.0(9月25日)はApple Siliconでqwen3.8、gemma4、qwen3.6などの対応アーキテクチャを標準でMLXで実行します。v0.35.0(9月28日)は`/v1/systemone`経由の判断モデル(テキストではなく選択肢・確率・スコアを返すモデルで、最初はNimbleとTev1)を追加し、v0.35.1(9月29日)はマルチモーダルのClefモデルを追加しました。v0.40.2(10月8日)は旧モデルのバックグラウンド更新時にバックアップを保持し、v0.40.4(10月12日)は`ollama run <判断モデル> --ask`を追加、v0.40.5(10月14日)はNVIDIA Nemotron 3.5 Superのサポートと、Clef判断モデルのクラウド利用を追加しました。詳細なリリースノート:github.com/ollama/ollama/releases。
今月追加された最新モデル(2026年7月):
- Laguna XS 2.1(Poolside、2026年7月2日)— エージェント型・長期タスクコーディング向けモデル:33B総パラメータ / 3B活性MoE、256Kトークンのコンテキストウィンドウ、SWE-bench Verified 70.9%、SWE-bench Multilingual 63.1%。OpenMDW-1.1ライセンス。プル:`ollama pull laguna-xs-2.1`、実行:`ollama run laguna-xs-2.1`
- Kimi K2.7 Code(Moonshot AI、2026年6月頃)— Kimi K2.6をベースに構築されたコーディング特化のエージェントモデル。プル:`ollama pull kimi-k2.7-code:cloud`
- DeepSeek V4 Pro(DeepSeek、2026年4月23日)— アルゴリズミックコーディングの専門モデル、93.5% LiveCodeBench、MITライセンス。軽量ハードウェア向けの廉価版DeepSeek V4 Flashもあります。プル:`ollama pull deepseek-v4-pro`
- Kimi K2.6(Moonshot AI、2026年4月20日)— フロンティアコーディングモデル、SWE-Bench Pro 58.6、SWE-bench Verified 80.2%。MoEアーキテクチャ(32B活性/1T合計)。Modified MIT ライセンス。
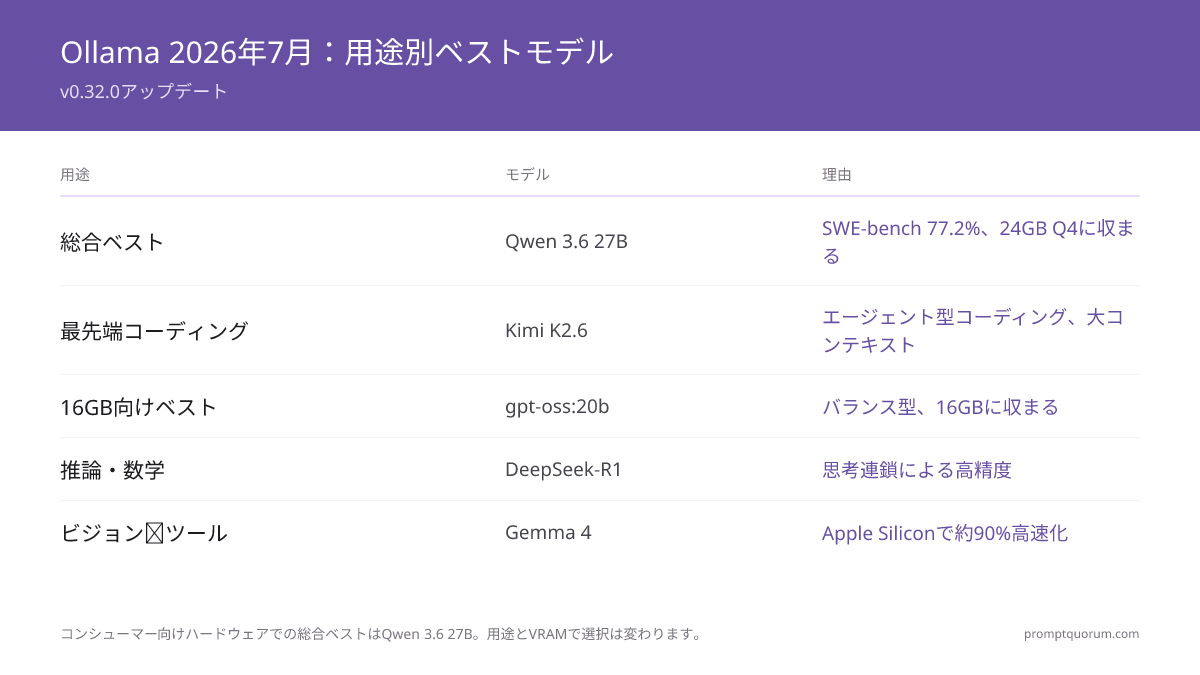
- Qwen3.8-27B(Alibaba、2026年4月16日)— コンシューマー向け総合最高、61.7 SWE-bench Pro、Apache 2.0、Q4で24GBに収まる。Qwen3.6-35B-A3B(MoE、73.4 SWE-bench)も。
- GLM-5.3(Z.ai)— 744B / 40B活性MoE、MITライセンス。構造化コード生成リーダー。
- gpt-oss(OpenAI、2026年)— オープンウェイトMoE:gpt-oss:20b(21B合計 / 3.6B活性、16GBで動作、~o3-miniレベル、推論調整可能)とgpt-oss:120b(80GB)。
- Gemma 4(Google、2026年4月2日)— マルチモーダルサイズ E2B / E4B / E12B(26B MoE)/ E27B(31B密度)、すべてビジョンとツール呼び出し対応。QAT重みを2026年6月5日に追加。v0.31.1のMLXバッチ行列積カーネル刷新でApple Silicon推論が約90%高速化。E4Bは~6GB VRAMで動作。
- Dolphin 3.0(Cognitive Computations、継続保守)— 検閲なし・汎用チャットモデル、Llama 3.1ベース、コンテンツフィルタリングなし。プル:`ollama pull dolphin3`(旧`dolphin-mistral`は2024年の古いモデルのため非推奨)。
# Ollamaを最新版にアップデート(v0.40.5)
curl https://ollama.ai/install.sh | sh

# またはMac:brew upgrade ollama

# 現在のバージョンを確認
ollama --version  # 出力:ollama version 0.40.5

# 2026年7月の最新モデルをプル
ollama pull laguna-xs-2.1
ollama pull kimi-k2.7-code:cloud
ollama pull nemotron-3.5-lightning
ollama pull dolphin3
Ollamaのバージョン履歴とリリースタイムラインは?
Ollamaは2023年7月8日に最初のリリースv0.0.1を公開し、2026年10月14日にv0.40.5に到達しました。 表はOllamaでできることを変えたリリースをまとめたものです。全タグとリリースノートはgithub.com/ollama/ollama/releasesにあります。2026年9月下旬にバージョン番号がv0.35からv0.40へ飛んだため、GitHub上ではv0.40.0(9月25日)がv0.35系(9月28〜29日)と並んでいます。
バージョン | 公開日 | 主な変更 |
|---|---|---|
| v0.40.5 | 2026年10月14日 | Nemotron 3.5 Super、クラウド判断モデル |
| v0.40.0 | 2026年9月25日 | Apple Siliconで標準MLX |
| v0.35.0 | 2026年9月28日 | /v1/systemone経由の判断モデル |
| v0.34.0 | 2026年9月5日 | ChatGPT DesktopでOllamaモデル |
| v0.33.0 | 2026年8月21日 | Claude Desktopゲートウェイ、KV復元 |
| v0.32.0 | 2026年7月11日 | 「Chat, Code & Work」エージェント |
| v0.0.1 | 2023年7月8日 | 初の公開リリース |
Ollama最人気モデル
Ollamaは完全公開ダウンロード統計を提供。 2026年7月データより:
Llama 3.2 3Bは全体で最多ダウンロード。主にチュートリアルとして使用。コンシューマー向け品質では、Qwen3.8-27B(61.7 SWE-bench Pro、Q4で24GBに収まる)が現在の総合最良の選択。
Qwen3・Qwen3.8はOllama ライブラリで最速成長のモデルファミリー。Qwen3と新しいQwen 3.6密度バリアントがQwen3を急速に置き換え。DeepSeek-R1はリリース後に大きなスパイクを記録し、推論タスク向けに常に高ダウンロード状態。
Meta Llama 4 2026年4月リリースでScout(17B活性、109B合計、MoE)とMaverick(17B活性、400B合計)を展開。Ollama ライブラリで安定済み(`ollama pull llama4:scout`)。Llama 4はMoEアーキテクチャを採用し、トークンあたり17Bのみが活性だが、109B合計のためScoutはQ4で~55GB VRAMが必要(24GBは1.78ビットのみ、~20 tok/s)。Scoutの強みは10Mトークンのコンテキストとマルチモーダル入力であり、コンシューマーハードウェアへの適合性ではない。Ollama エコシステムは2026年4月に大幅拡張。Kimi K2.6(Moonshot AI、Modified MIT、32B活性/1T合計MoE)はSWE-Bench Pro 58.6を記録しGPT-5.5と同等。Qwen3.8-27Bは61.7 SWE-bench Proでコンシューマー向け総合最高を達成(Q4で24GBに収まる)。OpenAIのオープンウェイトgpt-oss:20b(21B合計/3.6B活性MoE)は16GBで~o3-miniレベル、推論調整可能で動作。現在のリリースであるOllama v0.40.5(2026年10月14日)はNVIDIA Nemotron 3.5 Superのサポートを追加しました。Ollama ライブラリは現在数百のモデルを参照しており、最新追加はLaguna XS 2.1(Poolside、エージェント型コーディング)とKimi K2.7 Code(Moonshot AI)です。
バージョン注記:Ollamaでは、Qwen3.6とQwen3.8がより新しいQwen世代です(qwen3.6:35bは約24GB、qwen3.8:27bは18GB)。qwen3:30bとqwen3-coder:30b(各19GB)は前世代の選択肢で、引き続き利用できます。Mistralの現行のSmallモデルはMistral Small 4ですが、確認時点でOllamaライブラリには掲載されていませんでした。そのため、mistral-small3.1とmistral-small:24b(Mistral Small 3)が、取得できるSmallモデルです。
カテゴリ別トップモデル
モデルの出力品質はプロンプトの設計に大きく左右されます。Chain-of-Thought、Few-Shot例、出力フォーマットなど、すべてのローカルモデルで使える構造化テクニックについてはプロンプトエンジニアリングガイドをご覧ください。推論タスク用に、Chain-of-ThoughtプロンプティングはDeepSeek-R1とQwen3出力品質を大幅に改善。各モデルに必要なRAMを確認するには、VRAM要件ガイド →をご参照ください。Gemma 4エージェントワークフロー用はTree-of-Thoughtと ReAct参照。このリストにあるツール呼び出し対応モデルを、ファイルアクセスやデータベース照会まで含むマルチステップのループに組み込む方法は、MCP を使ったローカル AI エージェントを参照してください。オープンソースのオーケストレーションパターンを解説しています。
- 一般チャット(初心者):`ollama run llama3.2:3b` -- ドキュメント多数、最適入門モデル。
- 一般チャット(最良の選択):`ollama run qwen3.8:27b` -- 61.7 SWE-bench Pro、コンシューマー向け総合最高、Q4で24GBに収まる。バランス型:`ollama run qwen3:30b`。8GB機はllama3.2:3b維持。
- 長コンテキスト / マルチモーダル:`ollama run llama4:scout` -- 10Mトークンコンテキスト + マルチモーダル、MoE(17B活性/109B合計)。Q4で~55GB VRAM必要(24GBは1.78ビットのみ、~20 tok/s)。
- 小型・16GB最強:`ollama run gpt-oss:20b` -- 21B合計 / 3.6B活性MoE、~o3-miniレベル、推論調整可能。大型:`ollama run gpt-oss:120b`(80GB)。
- コード(7B):`ollama run qwen3:8b` -- 多言語対応、8GB機向けの堅実なコード用選択肢。
- コード(最高エージェント、24B):`ollama run devstral-small-2` -- 最高エージェントコーディング(マルチファイル編集、デバッグ)。16GB RAM。Mistral AI製。
- コード(最高密集、27B):`ollama run qwen3.8:27b` -- 61.7 SWE-bench Pro。最高密集コーディングモデル。18 GB VRAM。
- コード(フロンティアMoE):`ollama run kimi-k2.6:cloud` -- SWE-Bench Pro 58.6(GPT-5.5と同等)、トップティア。MoE(32B活性/1T合計)。Modified MIT License。
- コード(エージェント型・長期タスク):`ollama run laguna-xs-2.1` -- SWE-bench Verified 70.9%、SWE-bench Multilingual 63.1%、256Kコンテキスト。33B総パラメータ/3B活性MoE。OpenMDW-1.1ライセンス。
- エージェント・ツール呼び出し:`ollama run gemma4:e4b` -- 2026年4月2日リリース。組み込みツール呼び出し+ビジョンサポート。ローカルエージェント、機能呼び出し、構造出力推奨。6GB RAM。
- 推論・数学:`ollama run deepseek-r1:7b` -- Chain-of-Thoughtモデル、ローカル数学最高性能at 7B。
- 多言語:`ollama run qwen3:8b` -- 29+言語対応、多言語向けの汎用選択肢。
- 画像理解:`ollama run gemma4:e4b` -- Vision + Tool Calling。v0.31.1のMLXカーネル刷新でApple Silicon推論が約90%高速化。または `ollama run llama3.2-vision:11b`専用Vision。
- うんちく系/検閲なし:`ollama run dolphin3` -- Dolphin 3.0、Llama 3.1ベース、コンテンツフィルタリングなし。Cognitive Computations製。
- 高速・軽量:`ollama run gemma2:2b` -- 最速CPU推論、1.7GB RAM。
- 高品質(16GB RAM):`ollama run mistral-small3.1` -- 14GB RAMで良好な品質。
- ホームオートメーション / ウェイクワードAI:`ollama run phi4-mini` — Phi-4 Mini(3.8B、VRAM約3 GB)は専用GPUなしのミニPCでHome Assistantの音声コマンドを処理できます。速度はハードウェア次第です。Home Assistant + Ollama 統合ガイド →をご覧ください。

Ollamaに最近追加されたモデルは?
Ollamaライブラリの最新モデルを新しい順に示します。ワークフローを組む前に`ollama pull <モデル>`で利用可否を確認してください。新モデルはリリースから数日でollama.com/libraryに掲載されます。
モデル | リリース | 最適な用途 | Ollamaコマンド |
|---|---|---|---|
| nemotron-3.5-super | 2026年10月14日 | NVIDIA — 120Bビジョン言語、コーディング、推論、ツール利用、最大1Mコンテキスト | ollama run nemotron-3.5-super |
| nemotron-3.5-bolt | 2026年10月14日 | NVIDIA — 総計74B/アクティブ9BのMoE、ローカルのコーディングとツール、25GB | ollama run nemotron-3.5-bolt |
| nemotron-3.5-lightning | 2026年 | NVIDIA — 30B MoE、アクティブ3B、常時稼働エージェント、1Mコンテキスト | ollama run nemotron-3.5-lightning |
| glm-5.3 | 2026年 | Z.ai — コーディングと長時間エージェント向けのフラッグシップ | ollama run glm-5.3 |
| granite4.2 | 2026年 | IBM — Apache 2.0、3B / 8B / 30B、128Kコンテキスト | ollama run granite4.2 |
| qwen3.8:27b | 2026年8月 | コンシューマー向け総合最高、SWE-bench Pro 61.7(Qwen公表値)、18GB | ollama run qwen3.8:27b |
| laguna-xs-2.1 | 2026年7月2日 | Poolside — エージェントコーディング、33B/アクティブ3B MoE、20GB、256K | ollama run laguna-xs-2.1 |
| kimi-k2.7-code | 2026年 | Moonshot AI — コーディング特化、Ollamaではクラウドタグのみ | ollama run kimi-k2.7-code:cloud |
| kimi-k2.6 | 2026年4月20日 | フロンティアコーディング(SWE-Bench Pro 58.6)、Ollamaではクラウドタグのみ | ollama run kimi-k2.6:cloud |
| gpt-oss:20b | 2026年 | 小型最強/16GB、~o3-mini、推論調整可能 | ollama run gpt-oss:20b |
| gemma4:e4b | 2026年4月2日 | ビジョン+ツール呼び出し(E2B/E4B/12B/26B/31B) | ollama run gemma4:e4b |
| qwen3:30b | 2026年 | バランス型;コード補完はqwen3-coder:30b | ollama run qwen3:30b |
DeepSeek-R1:推論ブレークスルー
DeepSeek-R1は2025年1月リリース。ローカルサイズでの推論大躍進。Chain-of-Thought(CoT)実装で思考過程を表示。バージョン注記:DeepSeek-R1は前世代のモデルです。DeepSeekの現行のオープンウェイトファミリーはDeepSeek-V4ですが、確認時点でOllamaライブラリには掲載されていませんでした。そのため、deepseek-r1の蒸留版(1.5B〜70B)が、取得できる推論モデルの選択肢です。DeepSeekは、ホスト型のR1 APIモデルをDeepSeek-V4に置き換えました。
- サイズ展開:1.5Bから70Bまでの蒸留版。
- 特徴:ロジック・多段階問題解決向上。
- RAM必須:1.5B:2GB、7B:6GB、70B:44GB(Q4量子化)。
- ライセンス:DeepSeek-R1モデルはMITライセンスです。蒸留版はさらにQwenまたはLlamaのベースモデルの条件を引き継ぎます。導入前にモデルカードを確認してください。
- データの扱い:自社のサーバーや端末でローカル実行すれば、プロンプトと応答はシステムの外に出ません。GDPRや日本の個人情報保護法などへの適合は全体の構成次第です(法的助言ではありません)。
ollama run deepseek-r1:7b
# プロンプト例:「時速100kmで駅に近づく列車2台、いつ出会う?」
# DeepSeek-R1:7bが思考過程を表示:
# <思考>
# ...経路を探索、仮定を検証...
# </思考>
# 答え:彼らは出会う...
ビジョンモデル
4つの優秀ビジョンモデルがOllamaネイティブ対応:
モデル | RAM | 画像対応 | Ollamaコマンド |
|---|---|---|---|
| Llama 3.2 Vision 11B | 11 GB | JPEG、PNG、GIF・複数画像入力 | ollama run llama3.2-vision:11b |
| Qwen2.5-VL 7B | 8 GB | JPEG、PNG・OCR精密 | ollama run qwen2.5vl:7b |
| Gemma 3 Vision 9B | 9.5 GB | JPEG、PNG・ネイティブ128Kコンテキスト | ollama run gemma3:9b |
| Mistral AI Pixtral 12B | 12.5 GB | JPEG、PNG・潜在表現 | ollama run pixtral:12b |

トップ10完全比較
ダウンロード数は、チュートリアルの多さからいまもLlama 3.xが優勢です。2026年の新規プロジェクトでは、Qwen3.8-27B(コンシューマー向け総合最高)、Laguna XS 2.1またはDevstral Small 2(コーディング)、gpt-oss:20b、qwen3:30bをおすすめします。
# | モデル | 最適用途 | RAM | ベンチマーク |
|---|---|---|---|---|
| 1 | Qwen3.8-27B | コンシューマー向け総合最高 | 24GB(Q4) | SWE-bench Pro 61.7(Qwen公表値) |
| 2 | Kimi K2.6 | フロンティアコーディング、MoE(32B/1T)、Modified MIT | 量子化 | SWE-Bench Pro 58.6 |
| 3 | gpt-oss:20b | 小型最強/16GB、推論調整可能 | 16GB | ~o3-mini |
| 4 | qwen3:30b | バランス型;コードはqwen3-coder:30b | ~18GB | — |
| 5 | Laguna XS 2.1 | エージェント型コーディング、長期タスク(計画/コード/テスト/反復) | 量子化 | SWE-bench Verified 70.9% |
| 6 | Devstral Small 2 24B | エージェント型コーディング(マルチファイル) | 15GB | SWE-bench Verified 68.0%(Mistral公表値) |
| 7 | deepseek-r1:7b | 推論、数学 | 5GB | — |
| 8 | gemma4:e4b | ビジョン+ツール呼び出し(マルチモーダル) | ~6GB | エージェント対応 |
| 9 | Llama 4 Scout | 長コンテキスト10M+マルチモーダル、MoE | ~55GB(Q4) | 10Mコンテキスト |
| 10 | Llama 3.2 3B | 最初のモデル、一般チャット | 2.5GB | — |

Ollama ライブラリの探索方法
Ollamaモデルの操作には2つの方法があります。インストール済みモデルの切り替え: Ollama Macアプリのチャット入力欄下部にあるモデルドロップダウンボタン(例:"gemma3:1b"と表示)をクリックして、ローカルにインストールされたモデルを切り替えます。新しいモデルの検索・ダウンロード: ollama.com/libraryで数百のモデルをカテゴリ別に検索し、以下のCLIコマンドでインストールします。
- ブラウザで ollama.com/library を開く。数百のモデル検索可能。
- 新しいモデルは通常、リリースから数日でライブラリに掲載されます。
ollama list
# インストール済みモデル表示

ollama pull llama3.1:8b
# Llama 3.1 8B ダウンロード・インストール

ollama pull qwen2.5:7b
# Qwen3 8B ダウンロード(コード・数学向け)

ollama run qwen2.5:7b
# インタラクティブセッション開始

ollama run -m deepseek-r1:7b "2^10を解く"
# CoTで推論タスク実行
地域のプライバシー規則はOllamaのモデル選択にどう影響しますか?
EU / GDPR+ライセンス遵守。 本番環境でOllamaモデルを展開するEU組織にとって、ライセンスの選択は性能と同じくらい重要です。Apache 2.0(完全オープン、商用利用可):Mistral Small 3、Mistral Small 3.1、Qwen3 8B、Qwen3.8-27B、Devstral Small 2、Granite 4.2。Meta Llama Community Licence(月間アクティブユーザー7億人超で商用利用制限):Llama 3.1 8B、Llama 3.2 3B、Llama 3.2 Vision 11B。Llama 3.2 Visionは例外で、その利用規定(Acceptable Use Policy)はEUに居住または主たる事業所を置く個人・企業にライセンス上の権利を付与していません(それを組み込んだ製品のエンドユーザーは対象外)。EUで使う前に確認してください。MIT(商用利用可):DeepSeek-R1 7B・14B。修正MIT(帰属表示条項つきで商用利用可):Kimi K2.6。OpenMDW-1.1(寛容、商用利用可):Laguna XS 2.1。商用展開の前に必ずライセンス条件を確認してください。規制業種のEU企業には、Devstral Small 2などのMistralモデル(フランス、Apache 2.0)が妥当な既定の選択です。EU発で寛容なライセンスだからです。Ollamaでモデルを完全オンプレミスで動かせばプロンプトは外部サーバーに送信されません。これはGDPR対応を支えますが、それだけで満たすわけではありません(`:cloud`タグはOllamaのホスト型サービスにデータを送信します)。
日本(METI)。 日本企業のOllama展開では、Qwen3 / Qwen3.8が推奨できるモデルファミリーです。日本語テキストをネイティブに扱えるため、推論時間とKVキャッシュの面で有利です。日本語のコーディングワークフローでは、Qwen3.8-27B(Qwen公表のSWE-bench Pro 61.7)が日本語のコードコメントをネイティブに扱います。正確なモデルバージョンを記録しておくことは、コンプライアンス文書の良い実務です。`ollama show <モデル>`で、パラメータ数、量子化レベル、コンテキスト長を含む完全な仕様をコンプライアンス記録用に取得できます。
中国。 中国のCAC生成AI管理弁法(2023年)は、中国で一般向けに生成AIサービスを提供する事業者に、届出や安全評価の義務を課す場合があります。ご自身に該当するかどうかは法務の専門家にご確認ください。Qwen3 / Qwen3.8(Alibaba、Apache 2.0)は、中国企業のOllama展開に自然な選択肢です。中国発のモデルで、Apache 2.0ライセンス、中国語性能も高いためです。Kimi K2.6(Moonshot AI、修正MIT)も中国発ですが、Ollamaではクラウドタグのみで、ローカル実行にはサーバー級ハードウェアが必要です。コマンド:最高品質なら`ollama run qwen3.8:27b`、速度重視なら`ollama run qwen3:8b`。推論にはDeepSeek-R1(MITライセンス)が適しています。Ollamaでローカル実行する推論それ自体はデータを国外へ送信しないため、その工程については越境移転の問題が生じません。ただし、PIPLなどの義務がご自身のデータ処理に適用されるかどうかは、法務の専門家とご確認ください。本セクションは一般的な情報であり、法的助言ではありません。
Ollama選択の一般的ミス
Ollamaの最新バージョンは?
Ollamaの最新安定版はv0.40.5(2026年10月14日リリース)です。10月16日にv0.40.6のプレリリースが続きましたが、まだ安定版ではありません。ollama.com/downloadからダウンロードするか、Linuxでは`curl https://ollama.ai/install.sh | sh`、macOSでは`brew upgrade ollama`で更新できます。
Ollamaの変更履歴とリリースノートはどこで見られますか?
各バージョンのリリースノートはgithub.com/ollama/ollama/releasesにあり、タグごとに日付と変更履歴が記載されています。直近の安定版はv0.40.5(2026年10月14日 -- NVIDIA Nemotron 3.5 Superのサポート、判断モデルのクラウド利用)、v0.40.4(10月12日 -- `ollama run --ask`での判断モデル、読み込み高速化)、v0.40.0(9月25日 -- Apple Siliconで標準MLX)です。
インストール済みのOllamaバージョンを確認するには?
ターミナルで`ollama --version`を実行します。`ollama version 0.40.5`のような行が出力されます。番号が最新版より低い場合は、`curl https://ollama.ai/install.sh | sh`(Linux)または`brew upgrade ollama`(macOS)で更新し、再度`ollama --version`で確認してください。
Ollamaが最初にリリースされたのはいつですか?
Ollamaの最初のリリースv0.0.1は、リポジトリ作成(2023年6月26日)の直後の2023年7月8日にGitHubで公開されました。2026年10月時点ではv0.40.5に到達しています。全リリース一覧はgithub.com/ollama/ollama/releasesで確認できます。
大きいモデルタグをプルしたがRAM満杯。何が?
確認なしプル。プル前に`ollama show [model-name]`実行。例:`ollama show llama3.1:70b`でRAM表示(約42-48GB、Q4量子化)。初心者は7B-13Bに留める(RAM 16GB以下)。`ollama rm [model-name]`で削除。
Llama 3.3みたいな汎用モデル使うがコード遅い。なぜ?
Llama 3.1 8Bは汎用向きだがQwen3やMistral Smallは技術専門。コード:Llama 3.1 8BからQwen3 8Bに切り替え、ご自身のタスクで結果を比較してください。両方RAM 8GB以下。
モデルプルしたが表示されない。確認は?
`ollama list`実行。モデルはMac: `~/.ollama/models/`またはWindows: `%USERPROFILE%.ollamamodels`に保存。表示されなければOllamaデーモン再起動:終了して再起動。
次のステップ
- コーディング向け最高ローカルLLM — コード特化の最良Ollamaモデルを選ぶ →
- CPUのみで動く最高LLM — GPU なし?ここから始める →
- ローカルLLMハードウェアガイド — あなたのPCでこれらのモデルが動くか確認 →
よくある質問
Ollamaの最新バージョンは?
Ollamaの最新安定版はv0.40.5(2026年10月14日リリース)です。10月16日にv0.40.6のプレリリースが続きましたが、まだ安定版ではありません。ollama.com/downloadからダウンロードするか、Linuxでは`curl https://ollama.ai/install.sh | sh`、macOSでは`brew upgrade ollama`で更新できます。
Ollamaの変更履歴とリリースノートはどこで見られますか?
各バージョンのリリースノートはgithub.com/ollama/ollama/releasesにあり、タグごとに日付と変更履歴が記載されています。直近の安定版はv0.40.5(2026年10月14日 -- NVIDIA Nemotron 3.5 Superのサポート、判断モデルのクラウド利用)、v0.40.4(10月12日 -- `ollama run --ask`での判断モデル、読み込み高速化)、v0.40.0(9月25日 -- Apple Siliconで標準MLX)です。
インストール済みのOllamaバージョンを確認するには?
ターミナルで`ollama --version`を実行します。`ollama version 0.40.5`のような行が出力されます。番号が最新版より低い場合は、`curl https://ollama.ai/install.sh | sh`(Linux)または`brew upgrade ollama`(macOS)で更新し、再度`ollama --version`で確認してください。
Ollamaが最初にリリースされたのはいつですか?
Ollamaの最初のリリースv0.0.1は、リポジトリ作成(2023年6月26日)の直後の2023年7月8日にGitHubで公開されました。2026年10月時点ではv0.40.5に到達しています。全リリース一覧はgithub.com/ollama/ollama/releasesで確認できます。
ローカルモデルに必要なRAM量は?
7B:6.5-8GB。13B:11-14GB。70B:42-48GB(Q4_K_M量子化)。3B:2-3GB。プル前に`ollama show [model-name]`で確認。
Ollamaモデルはオフラインで実行できる?
はい。初期DL後、推論は完全ローカル実行。インターネット不要。Ollamaが定期更新確認(自動適用なし)。
日本語サポート最高のモデルは?
Qwen3 / Qwen3.8やMistral Small 3.1などの多言語モデルは日本語に対応していますが、このページでは日本語品質での順位付けは行っていません。ご自身のテキストで試してください。
Ollamaモデルは本当に無料?
ダウンロードとローカル実行にサブスクリプションやAPI料金はかかりませんが、すべてのモデルがOSI基準のオープンソースというわけではありません。Llama 3.x/4.xはMeta Llama Community Licence(OSI非承認、月間アクティブユーザー7億人超で商用利用を制限)、Mistral Small 3.1、Qwen3、Gemma 4はApache 2.0、Gemma 2とGemma 3はGoogleのGemma利用規約です。商用展開の前にライセンスを確認してください。
DeepSeek-R1の速度は本当?
速度はハードウェア、量子化、プロンプトによって変わり、このページでは実測値を掲載していません。DeepSeek-R1は回答の前に思考過程を出力するため、標準のチャットモデルより1回答あたりのトークン数が多く、その分時間がかかります。リアルタイム用途には標準のチャットモデルが向いています。
OllamaでなくChatGPT Plusを選ぶ理由は?
プライバシー:ローカル実行ではプロンプトが端末の外に出ません(`:cloud`タグを除く)。コスト:モデル自体にサブスクリプションやAPI料金はかかりませんが、ハードウェアと電気代は必要です。オフライン:ダウンロード後は、インターネット接続なしで推論できます。カスタマイズ:システムプロンプトとモデルのパラメータを自分で制御できます。
Ollamaモデルは画像処理できる?
はい。Llama 3.2 Vision、Qwen2.5-VL、Gemma 3全てマルチモーダル。画像をローカルファイルとしてアップロード。ローカル実行ではクラウド転送なし。JPEG、PNG、GIF対応。
Ollamaモデルを新版にアップデートは?
`ollama pull [model-name]`再実行。差分のみDL(重複排除)。旧版削除:`ollama rm [model-name]:tag`。
GDPRはOllamaで気にすべき?
はい、個人データを扱う場合は該当します。GDPR第32条は適切なセキュリティ対策を求めています。プライベートな端末やサーバー上でのローカル推論は、設計によるデータ保護の要件への対応に役立つ場合があります。クラウドへの転送がなければデータはシステムの外に出ないため、データ主権や保護措置の実施が容易になりますが、実際の適合性は全体の構成次第です(法的助言ではありません)。注:クラウドモデルを使う場合は、まず処理契約をご確認ください。
日本企業向けOllama活用は?
はい、多くの場合に有効です。日本企業にとっての利点:データ主権(クラウドロックインの回避)、IT標準への対応支援(実際の適合性は全体の構成次第で、法的助言ではありません)、標準ハードウェアでのスケーラビリティ、API料金の削減。Qwen3 8Bは標準的なデスクトップGPUで動作し、Llama 3.1 8Bは社内ツール、顧客対応の自動化、文書処理に使われることが多いモデルです。
Ollamaを開発している会社の正式名称は何ですか?
Ollamaを開発している会社はOllama Inc.です。「Ollama」は、同社と、同社が公開するオープンソースのCLIツール/モデルランタイムの両方を指します。プロジェクト最初の公開リリースv0.0.1は2023年7月8日にGitHubで公開されました。
ロシア語タスクに最適なOllamaモデルはどれですか?
Qwen3/Qwen 3.6とMistral Small 3.1はどちらもロシア語をネイティブの多言語トレーニングデータに含みます。このページではロシア語での優劣は判定していません。ご自身のプロンプトで両方を試してください。どちらもロシア発のモデルではありません。
OllamaでどのDolphinモデルを使うべきですか?
`ollama pull dolphin3`(Dolphin 3.0)を使用してください。Cognitive Computationsが保守する現行版で、Llama 3.1をベースにコンテンツフィルタリングなしで構築されています。旧版の`dolphin-mistral`は2024年リリースで更新が止まっています。組み込みの安全フィルタがないため、出力の利用についてはご自身が責任を負い、Llama 3.1のライセンス条件が適用されます。
参考資料
- Ollamaビジョンモデル(2026) -- Ollamaで画像対応モデルを実行するための実践ガイド。実際のCLI/API構文を解説。
- VS CodeとCursorでローカルLLMインストール -- VS CodeとCursorが今Ollama自動認識。
- ローカルモデル選択:Llamaは Qwenか Mistralか -- ビギナー向け完全比較。
- OllamaはLM Studioより速い? -- GPU・スループットベンチ。
- Ollama Windows/Mac インストール方法 -- ステップバイステップ・環境設定。
- ローカルLLM ハードウェアガイド GPU要件 -- どのGPU・RAM・ストレージがモデルに必須。
- トラブル:Ollama エラーと解策 -- CUDA・MPS・CPU落とし穴・一般エラー。
- ローカルLLMモデル更新情報2026 -- Ollama対応日付付きの主要オープンウェイトリリース完全タイムライン。
ソース
- Ollama モデルライブラリ -- 数百のモデル、ライブDL統計。
- DeepSeek-R1 論文 -- "DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning"(2025年1月)。
- Gemma 3 発表 -- Google DevelopersブログGemma 3マルチモーダル・128Kコンテキスト(2025年3月)。