Ollama最新版本是什么?有哪些变化?
当前Ollama版本:v0.40.5(2026年10月14日发布)。这是最新稳定版本,可通过ollama.com/download获取。v0.40.6预发布版于10月16日发布,但尚未标记为稳定版。使用`curl https://ollama.ai/install.sh | sh`(macOS:`brew upgrade ollama`)更新,然后用`ollama --version`确认。
v0.33–v0.40系列的变化(2026年8月–10月): v0.33.0(8月21日)启用Claude Desktop作为第三方网关,并提升了KV缓存预填充恢复点的可靠性。v0.34.0(9月5日)允许在ChatGPT Desktop中使用Ollama模型,并加快了Apple Silicon上的结构化输出;v0.34.1(9月14日)不再将MLX safetensors的`ollama create`标记为实验性。v0.40.0(9月25日)在Apple Silicon上默认用MLX运行qwen3.8、gemma4、qwen3.6等受支持架构。v0.35.0(9月28日)通过`/v1/systemone`加入决策模型——返回选项、概率和分数而非文本的模型,首批为Nimble和Tev1——v0.35.1(9月29日)加入多模态Clef模型。v0.40.2(10月8日)在后台升级旧模型时保留备份,v0.40.4(10月12日)新增`ollama run <决策模型> --ask`,v0.40.5(10月14日)新增NVIDIA Nemotron 3.5 Super支持以及Clef决策模型的云端访问。完整说明:github.com/ollama/ollama/releases。
自上次更新以来新增的最新模型(6月下旬-7月):
- Laguna XS 2.1(Poolside、2026年7月2日)— 33B总数/3B活跃MoE,专为智能体编程和长周期本地任务构建:规划、编写代码、运行测试、迭代。256K上下文,OpenMDW-1.1许可。SWE-bench Verified 70.9%,SWE-bench Multilingual 63.1%。拉取:`ollama pull laguna-xs-2.1`
- Kimi K2.7 Code(Moonshot AI、2026年6月)— 专注编程的智能体模型,基于Kimi K2.6构建,专为长周期编程会话设计。拉取:`ollama pull kimi-k2.7-code:cloud`
- DeepSeek V4 Pro(DeepSeek、2026年4月23日)— 算法编码专家,93.5% LiveCodeBench,MIT许可。轻量硬件可选预算版DeepSeek V4 Flash。拉取:`ollama pull deepseek-v4-pro`
- Kimi K2.6(Moonshot AI、2026年4月20日)— 前沿编码模型,SWE-Bench Pro 58.6,SWE-bench Verified 80.2%。MoE架构(32B活跃/1T总数)。Modified MIT许可。
- Qwen3.8-27B(Alibaba、2026年4月16日)— 消费级硬件综合最佳,61.7 SWE-bench Pro,Apache 2.0,Q4下可装入24GB。另有Qwen3.6-35B-A3B(MoE,73.4 SWE-bench)。
- GLM-5.3(Z.ai)— 744B / 40B活跃MoE,MIT许可。结构化代码生成领导者。
- gpt-oss(OpenAI、2026年)— 开放权重MoE:gpt-oss:20b(21B总数 / 3.6B活跃,16GB可运行,~o3-mini水平,推理可调)和gpt-oss:120b(80GB)。
- Gemma 4(Google、2026年4月2日)— 多模态尺寸 E2B / E4B / E12B(26B MoE)/ E27B(31B密集),全部支持视觉和工具调用。现在Apple Silicon上快约90%(2026年7月MLX更新)。E4B在~6GB显存下运行。
# 更新Ollama到最新版本(v0.40.5)
curl https://ollama.ai/install.sh | sh

# 或Mac:brew upgrade ollama

# 检查当前版本
ollama --version  # 输出:ollama version 0.40.5

# 拉取2026年最新模型
ollama pull laguna-xs-2.1
ollama pull kimi-k2.7-code:cloud
ollama pull nemotron-3.5-lightning
ollama pull kimi-k2.6:cloud
Ollama的版本历史和发布时间线是什么?
Ollama于2023年7月8日发布首个版本v0.0.1,并在2026年10月14日达到v0.40.5。 下表列出了改变Ollama使用方式的版本;所有标签及完整发布说明见github.com/ollama/ollama/releases。2026年9月下旬版本号从v0.35跳到v0.40,因此GitHub上v0.40.0(9月25日)与v0.35系列(9月28-29日)并列。
版本 | 发布日期 | 主要变化 |
|---|---|---|
| v0.40.5 | 2026年10月14日 | Nemotron 3.5 Super;云端决策模型 |
| v0.40.0 | 2026年9月25日 | Apple Silicon默认使用MLX |
| v0.35.0 | 2026年9月28日 | 通过/v1/systemone使用决策模型 |
| v0.34.0 | 2026年9月5日 | ChatGPT Desktop可用Ollama模型 |
| v0.33.0 | 2026年8月21日 | Claude Desktop网关;KV缓存恢复 |
| v0.32.0 | 2026年7月11日 | “Chat, Code & Work”智能体 |
| v0.0.1 | 2023年7月8日 | 首个公开版本 |
最受欢迎的模型(2026年7月)
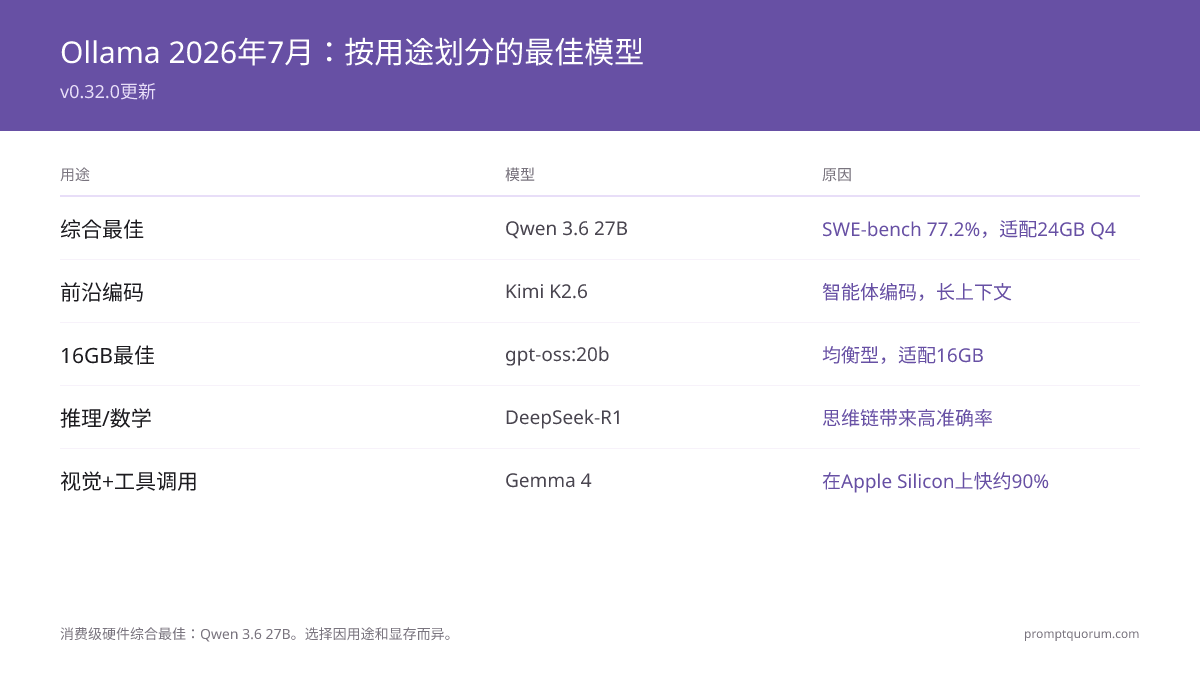
Llama 3.2 3B 仍为总下载量最高,主要作为初安装测试模型。在消费级硬件品质方面,Qwen3.8-27B(61.7 SWE-bench Pro、Q4下可装入24GB)仍为综合最佳选择。
Qwen3和Qwen3.8 是Ollama库中增长最快的模型家族,Qwen3和新的Qwen 3.6密集变体正在快速取代Qwen3。DeepSeek-R1在发布后出现大幅增长,并保持推理任务的高下载量。Dolphin 3.0(Cognitive Computations、基于Llama 3.1构建)是希望获得无内容过滤本地助手的用户中下载量最高的无审查通用模型,拉取命令为`ollama pull dolphin3`(不是已过时的`dolphin-mistral`)。
Meta Llama 4 于2026年4月推出Scout(17B活跃、109B总数、MoE)和Maverick(17B活跃、400B总数)变体。Llama 4 Scout现已稳定在Ollama库中(`ollama pull llama4:scout`)。Llama 4采用Mixture-of-Experts(MoE)架构,每个token仅17B参数活跃,但因109B总参数,Scout在Q4下需~55GB显存(24GB仅限1.78位,~20 tok/s)。Scout的亮点是10M token上下文窗口和多模态输入,而非消费级硬件适配性。Ollama生态在2026年4月显著扩展。Kimi K2.6(Moonshot AI、Modified MIT许可、32B活跃/1T总数MoE)取得SWE-Bench Pro 58.6,与GPT-5.5持平。Laguna XS 2.1(Poolside)是智能体编程领域的最新挑战者,专为长周期本地编程会话构建。Qwen3.8-27B达到61.7 SWE-bench Pro,成为消费级硬件综合最佳(Q4下可装入24GB)。OpenAI的开放权重gpt-oss:20b(21B总数/3.6B活跃MoE)在16GB下以~o3-mini水平运行,推理可调。当前版本Ollama v0.40.5(2026年10月14日)新增NVIDIA Nemotron 3.5 Super支持。Ollama库现涵盖数百个精选模型,其中Laguna XS 2.1和Kimi K2.7 Code为最新新增。
版本说明:Qwen3.6 和 Qwen3.8 是 Ollama 上较新的 Qwen 世代(qwen3.6:35b 约 24GB;qwen3.8:27b 为 18GB);qwen3:30b 和 qwen3-coder:30b(各 19GB)是上一代选项,仍可正常使用。Mistral 当前的 Small 模型是 Mistral Small 4,但核查时 Ollama 库中未列出该模型;因此 mistral-small3.1 和 mistral-small:24b(Mistral Small 3)仍是可拉取的 Small 模型。
按用途分类
模型的输出质量在很大程度上取决于你的提示方式。关于适用于所有本地模型的结构化技术——包括思维链、Few-Shot示例和输出格式化——请参阅Prompt工程指南。对于推理任务,Chain-of-Thought提示显著改善DeepSeek-R1和Qwen3输出质量。了解每个模型所需的VRAM,见VRAM需求指南 →。对于Gemma 4代理工作流,见Tree-of-Thought和ReAct。一旦把这份榜单中的工具调用模型接入具备文件访问和数据库查询能力的多步循环,就可以参阅使用 MCP 的本地 AI 代理,了解这套开源编排方案。
- 通用聊天(初学者):`ollama run llama3.2:3b` -- 文档最多,最佳入门模型。
- 通用聊天(最佳选择):`ollama run qwen3.8:27b` -- 61.7 SWE-bench Pro,消费级硬件综合最佳,Q4下可装入24GB。均衡全能:`ollama run qwen3:30b`。8GB机器保持`ollama run llama3.2:3b`。
- 长上下文 / 多模态:`ollama run llama4:scout` -- 10M token上下文 + 多模态,MoE(17B活跃/109B总数)。Q4下需~55GB显存(24GB仅限1.78位,~20 tok/s)。
- 小型/16GB最强:`ollama run gpt-oss:20b` -- 21B总数 / 3.6B活跃MoE,~o3-mini水平,推理可调。更大:`ollama run gpt-oss:120b`(80GB)。
- 编程(7B):`ollama run qwen3:8b` -- 多语言,适合8GB设备的编程选择。
- 编程(最优代理、24B):`ollama run devstral-small-2` -- 最优代理编程(多文件编辑、调试)。16GB RAM。Mistral AI出品。
- 编程(最优密集、27B):`ollama run qwen3.8:27b` -- 61.7 SWE-bench Pro。最优密集编程模型。18 GB显存。
- 编程(前沿MoE):`ollama run kimi-k2.6:cloud` -- SWE-Bench Pro 58.6(与GPT-5.5持平),顶级。MoE(32B活跃/1T总数)。Modified MIT许可。
- 代理和工具调用:`ollama run gemma4:e4b` -- 2026年4月2日发布。内置工具调用+视觉支持。推荐本地代理、函数调用、结构化输出。6GB RAM。
- 推理和数学:`ollama run deepseek-r1:7b` -- Chain-of-Thought模型,7B最高本地数学性能。
- 多语言:`ollama run qwen3:8b` -- 29+本地语言,多语言通用选择。
- 俄语任务:`ollama run qwen3:8b` 或 `ollama run mistral-small3.1` -- 两者的原生多语言训练均包含俄语;本页不对二者的俄语表现排序;请用你自己的提示词分别测试。
- 无审查/通用:`ollama run dolphin3` -- Dolphin 3.0(Cognitive Computations,基于Llama 3.1构建),无内置内容过滤,适用于通用聊天、编程和智能体任务。
- 图像理解:`ollama run gemma4:e4b` -- 视觉+工具调用。或`ollama run llama3.2-vision:11b`专用视觉。
- 快速轻量:`ollama run gemma2:2b` -- 最快CPU推理,1.7GB RAM。
- 高质量(16GB显存):`ollama run mistral-small3.1` -- 14GB显存下质量良好。
- 家庭自动化 / 唤醒词AI:`ollama run phi4-mini` — Phi-4 Mini(3.8B,约3 GB VRAM)可在无独显的迷你PC上处理Home Assistant语音命令;速度取决于你的硬件。参阅Home Assistant + Ollama集成指南 →。

最近有哪些模型加入了Ollama?
以下是Ollama库中最新的模型,按从新到旧排列。在构建工作流前,请用`ollama pull <模型>`确认可用性——新模型通常在发布后数天内出现在ollama.com/library。
模型 | 发布时间 | 最适合 | Ollama命令 |
|---|---|---|---|
| nemotron-3.5-super | 2026年10月14日 | NVIDIA — 120B视觉-语言,编程、推理、工具使用,最高1M上下文 | ollama run nemotron-3.5-super |
| nemotron-3.5-bolt | 2026年10月14日 | NVIDIA — 总计74B/激活9B的MoE,本地编程和工具,25GB | ollama run nemotron-3.5-bolt |
| nemotron-3.5-lightning | 2026年 | NVIDIA — 30B MoE,激活3B,常驻代理,1M上下文 | ollama run nemotron-3.5-lightning |
| glm-5.3 | 2026年 | Z.ai — 面向编程和长时间代理的旗舰开放权重 | ollama run glm-5.3 |
| granite4.2 | 2026年 | IBM — Apache 2.0,3B / 8B / 30B,128K上下文 | ollama run granite4.2 |
| qwen3.8:27b | 2026年8月 | 消费级硬件综合最佳,SWE-bench Pro 61.7(Qwen公布),18GB | ollama run qwen3.8:27b |
| laguna-xs-2.1 | 2026年7月2日 | Poolside — 代理编码,33B/激活3B MoE,20GB,256K上下文 | ollama run laguna-xs-2.1 |
| kimi-k2.7-code | 2026年 | Moonshot AI — 面向编程,Ollama上仅有云端标签 | ollama run kimi-k2.7-code:cloud |
| kimi-k2.6 | 2026年4月20日 | 前沿编程(SWE-Bench Pro 58.6),Ollama上仅有云端标签 | ollama run kimi-k2.6:cloud |
| gpt-oss:20b | 2026年 | 小型最佳/16GB,~o3-mini,推理可调 | ollama run gpt-oss:20b |
| gemma4:e4b | 2026年4月2日 | 视觉+工具调用(E2B/E4B/12B/26B/31B) | ollama run gemma4:e4b |
| qwen3:30b | 2026年 | 均衡全能;代码补全用qwen3-coder:30b | ollama run qwen3:30b |
DeepSeek-R1:面向推理任务的模型
DeepSeek-R1 7B是专为推理任务设计的模型。 采用Chain-of-Thought(思维链)架构,让模型在生成答案前进行"思考"。
适用场景:适合数学推导、代码审查、复杂逻辑。
生成速度:取决于硬件、量化方式和提示词,本页不提供实测数据。由于需要先生成思考过程,总延迟高于标准聊天模型。
安装命令:
版本说明:DeepSeek-R1 是上一代模型。DeepSeek 当前的开放权重系列是 DeepSeek-V4,核查时 Ollama 库中未列出;deepseek-r1 蒸馏版(1.5B 至 70B)仍是可拉取的推理选项。DeepSeek 已用 DeepSeek-V4 取代其 API 中托管的 R1 模型。
ollama run deepseek-r1:7b视觉和多模态模型对比
2026年4月,以下开源视觉模型可在Ollama中本地运行:
模型 | RAM要求 | 图像支持 | Ollama命令 |
|---|---|---|---|
| Llama 3.2 Vision 11B | 11 GB | 是(JPEG、PNG、GIF) | ollama run llama3.2-vision:11b |
| Gemma 3 9B | 9.5 GB | 是(Gemma 3全系多模态) | ollama run gemma3:9b |
| Qwen2.5-VL 7B | 7.5 GB | 是(JPEG、PNG) | ollama run qwen2.5vl:7b |
| Phi-4 Vision 14B | 14 GB | 是(高分辨率输入) | ollama run phi4:14b |

Ollama完整Top 10模型排行
下载量仍以Llama 3.x居前,主要因为教程众多。2026年的新项目建议优先考虑Qwen3.8-27B(消费级硬件综合最佳)、Laguna XS 2.1或Devstral Small 2(编程)、gpt-oss:20b和qwen3:30b。
# | 模型 | 最适用于 | RAM要求 | 基准 |
|---|---|---|---|---|
| 1 | Qwen3.8-27B | 消费级硬件综合最佳 | 24GB(Q4) | SWE-bench Pro 61.7(Qwen公布) |
| 2 | Kimi K2.6 | 前沿编程,MoE(32B/1T),Modified MIT | 量化 | SWE-Bench Pro 58.6 |
| 3 | gpt-oss:20b | 小型最佳/16GB,推理可调 | 16GB | ~o3-mini |
| 4 | qwen3:30b | 均衡;代码用qwen3-coder:30b | ~18GB | — |
| 5 | Laguna XS 2.1 | 代理式编程,长周期(规划/编码/测试/迭代) | 量化 | SWE-bench Verified 70.9% |
| 6 | Devstral Small 2 24B | 代理式编程(多文件) | 15GB | SWE-bench Verified 68.0%(Mistral公布) |
| 7 | deepseek-r1:7b | 推理、数学 | 5GB | — |
| 8 | gemma4:e4b | 视觉+工具调用(多模态) | ~6GB | 适合代理 |
| 9 | Llama 4 Scout | 长上下文10M+多模态,MoE | ~55GB(Q4) | 10M上下文 |
| 10 | Llama 3.2 3B | 第一个模型,通用聊天 | 2.5GB | — |

如何浏览和选择Ollama模型
使用Ollama模型有两种方式。切换已安装模型: 在Ollama Mac应用中,点击聊天输入框底部的模型下拉按钮(显示当前模型名,如"gemma3:1b")切换本地已安装的模型。查找并下载新模型: 访问ollama.com/library按类别浏览数百个精选模型,然后使用下方CLI命令下载安装。
ollama pull llama3.1:8b
ollama run llama3.2
地区隐私规则如何影响你的Ollama模型选择?
欧盟 / GDPR + 许可证合规。 对于在生产中部署Ollama模型的欧盟组织,许可证的选择与性能同样重要。Apache 2.0(完全开放,允许商用):Mistral Small 3、Mistral Small 3.1、Qwen3 8B、Qwen3.8-27B、Devstral Small 2、Granite 4.2。Meta Llama社区许可证(月活用户超过7亿时限制商用):Llama 3.1 8B、Llama 3.2 3B、Llama 3.2 Vision 11B。Llama 3.2 Vision是例外:其可接受使用政策不向住所或主要营业地在欧盟的个人或公司授予许可权利(基于它构建的产品的最终用户不受影响),在欧盟使用前请先核实。MIT(允许商用):DeepSeek-R1 7B和14B。修改版MIT(允许商用,含署名条款):Kimi K2.6。OpenMDW-1.1(宽松,允许商用):Laguna XS 2.1。商用部署前务必核对许可证条款。对于受监管行业的欧盟企业,Devstral Small 2等Mistral模型(法国,Apache 2.0)是合理的默认选择:欧盟来源且许可证宽松。通过Ollama完全在本地运行模型意味着提示词不会发送到外部服务器;这有助于满足GDPR义务,但本身并不足以满足(`:cloud`标签会把数据发送到Ollama的托管服务)。
日本(METI)。 对于日本企业的Ollama部署,Qwen3 / Qwen3.8是值得推荐的模型家族:它原生处理日文文本,有利于推理时间和KV缓存。对于日语编程工作流:Qwen3.8-27B(Qwen公布的SWE-bench Pro为61.7)原生处理日文代码注释。记录确切的模型版本是合规文档的良好做法。使用`ollama show <模型>`可获取包含参数量、量化级别和上下文长度的完整规格,用于合规记录。
中国。 根据CAC《生成式人工智能服务管理暂行办法》(2023年),面向中国公众提供生成式AI服务的提供者可能需要履行备案或安全评估等义务;是否适用于你,请咨询法律顾问。Qwen3 / Qwen3.8(Alibaba,Apache 2.0)是中国企业Ollama部署的自然选择:中国来源、Apache 2.0许可证、中文表现出色。Kimi K2.6(Moonshot AI,修改版MIT)同样来自中国,但Ollama仅提供云端标签,本地运行需要服务器级硬件。命令:追求最佳质量用`ollama run qwen3.8:27b`,追求速度用`ollama run qwen3:8b`。DeepSeek-R1(MIT许可证)适合推理任务。通过Ollama在本地运行的推理本身不会将数据发送到境外,因此这一步不涉及跨境传输问题;PIPL或其他义务是否适用于你的数据处理,请与法律顾问确认。本节仅为一般信息,不构成法律建议。
常见误区
Ollama最新版本是什么?
Ollama最新稳定版本为v0.40.5,发布于2026年10月14日。v0.40.6预发布版于10月16日发布,但尚未标记为稳定版。可从ollama.com/download下载,或在Linux上用`curl https://ollama.ai/install.sh | sh`、在macOS上用`brew upgrade ollama`原地更新。
在哪里可以查看Ollama更新日志和发布说明?
每个版本的发布说明都在github.com/ollama/ollama/releases,按标签列出日期和更新日志。最新的稳定版条目为v0.40.5(2026年10月14日 -- NVIDIA Nemotron 3.5 Super支持、决策模型云端访问)、v0.40.4(10月12日 -- `ollama run --ask`决策模型、加载更快)和v0.40.0(9月25日 -- Apple Silicon默认使用MLX)。
如何查看已安装的Ollama版本?
在终端运行`ollama --version`,会输出类似`ollama version 0.40.5`的一行。如果版本号低于当前版本,请用`curl https://ollama.ai/install.sh | sh`(Linux)或`brew upgrade ollama`(macOS)更新,然后再次运行`ollama --version`确认。
Ollama最早是什么时候发布的?
Ollama的首个版本v0.0.1于2023年7月8日在GitHub发布,仓库创建于2023年6月26日。到2026年10月,项目已发展到v0.40.5。完整版本列表见github.com/ollama/ollama/releases。
中国企业使用本地LLM如何符合数据安全法?
《中华人民共和国数据安全法》(2021年)对数据分类分级保护和重要数据出境等作出规定。本地推理本身不会把数据发送到境外,可以减少这一环节的出境问题;但企业是否符合数据安全法,取决于数据分类、整体系统设计和管理措施,请与法律顾问确认。模型选择应与自身的数据分类相匹配。本文为一般信息,不构成法律建议。
亚太地区跨境数据如何处理?
东南亚、日本、澳大利亚等地设有个人数据跨境规则(例如各国的PDPA、日本的APPI、澳大利亚的Privacy Act)。本地部署的推理本身不会把数据发送到境外,可以减少跨境传输环节;各地规则是否适用于你的处理活动,请与当地法律顾问确认。本文为一般信息,不构成法律建议。
金融、医疗、法律企业如何部署?
金融、医疗和法律等受严格监管的行业,通常对数据主权、审计和合规认证有较高要求。本地部署有助于让数据留在自有环境,常见做法包括网络隔离、访问控制、日志记录和定期审计;是否满足监管要求取决于具体用例、数据保护措施和适用法规。模型输出不能替代合格专业人员的判断:涉及信贷、医疗诊断或法律意见等场景时,应由合格人员作最终决定,并咨询法律顾问。Ollama可与Kubernetes、Docker等常见企业IT工具配合使用。本文为一般信息,不构成法律建议。
下一步
- 最佳本地编程LLM — 专为编程优化的最佳Ollama模型 →
- 仅CPU运行LLM指南 — 没有GPU?从这里开始 →
- 本地LLM硬件指南 — 不确定你的电脑能否运行这些模型? →
常见问题
Ollama最新版本是什么?
Ollama最新稳定版本为v0.40.5,发布于2026年10月14日。v0.40.6预发布版于10月16日发布,但尚未标记为稳定版。可从ollama.com/download下载,或在Linux上用`curl https://ollama.ai/install.sh | sh`、在macOS上用`brew upgrade ollama`原地更新。
在哪里可以查看Ollama更新日志和发布说明?
每个版本的发布说明都在github.com/ollama/ollama/releases,按标签列出日期和更新日志。最新的稳定版条目为v0.40.5(2026年10月14日 -- NVIDIA Nemotron 3.5 Super支持、决策模型云端访问)、v0.40.4(10月12日 -- `ollama run --ask`决策模型、加载更快)和v0.40.0(9月25日 -- Apple Silicon默认使用MLX)。
如何查看已安装的Ollama版本?
在终端运行`ollama --version`,会输出类似`ollama version 0.40.5`的一行。如果版本号低于当前版本,请用`curl https://ollama.ai/install.sh | sh`(Linux)或`brew upgrade ollama`(macOS)更新,然后再次运行`ollama --version`确认。
Ollama最早是什么时候发布的?
Ollama的首个版本v0.0.1于2023年7月8日在GitHub发布,仓库创建于2023年6月26日。到2026年10月,项目已发展到v0.40.5。完整版本列表见github.com/ollama/ollama/releases。
本地LLM需要多少RAM?
7B模型:6.5-8GB。13B模型:11-14GB。70B模型:42-48GB(Q4_K_M量子化)。3B模型:2-3GB。运行前用 `ollama show [model-name]` 检查确切要求。
Ollama模型可以离线运行吗?
可以。首次下载后,推理完全本地进行。无网络需求。Ollama定期检查更新但不自动应用。
哪个模型对中文支持最好?
Qwen3 / Qwen3.8、Mistral Small 3.1等多语言模型支持中文,但本页不按中文质量对它们排序,请用你自己的文本测试。
Ollama模型真的完全免费吗?
下载并在本地运行无需订阅或API费用,但并非所有模型都是OSI意义上的开源:Llama 3.x/4.x使用Meta Llama社区许可证(未获OSI认可,月活用户超过7亿时限制商用),Mistral Small 3.1、Qwen3和Gemma 4采用Apache 2.0,Gemma 2和Gemma 3采用Google的Gemma使用条款。商用部署前请核对许可证。
DeepSeek-R1的速度真的那么快?
速度取决于硬件、量化方式和提示词,本页不提供实测数据。DeepSeek-R1在回答前会输出思维链,因此每次回答产生的token比标准聊天模型更多,耗时相应更长;实时交互场景更适合标准聊天模型。
为什么不直接用ChatGPT Plus而用本地Ollama?
隐私:本地运行时提示词不会离开设备(`:cloud`标签除外)。成本:模型本身没有订阅或API费用,但需要硬件和电费。离线:下载后推理无需联网。自定义:系统提示词和模型参数由你自行控制。
Ollama模型支持图像处理吗?
支持。Llama 3.2 Vision、Qwen2.5-VL、Gemma 3都是多模态。图像本地上传,本地运行时无云传输。支持JPEG、PNG、GIF。
如何更新Ollama模型?
重新运行 `ollama pull [model-name]`。仅下载差分(去重)。删除旧版本:`ollama rm [model-name]:tag`。
GDPR对Ollama有影响吗?
是的,只要处理个人数据就需要。GDPR第32条要求采取适当的安全措施。在私有设备或服务器上进行本地推理有助于满足数据保护设计的要求:没有云传输,数据不会离开你的系统,这有利于数据主权和防护措施的落实;但实际是否合规取决于你的整体配置(不构成法律建议)。注意:使用云模型时,请先确认数据处理合同。
日本企业如何利用Ollama?
是的,在很多情况下适用。优势:数据主权(避免云锁定)、有助于落实IT安全标准(实际合规取决于你的整体配置,不构成法律建议)、标准硬件上的可扩展性、无API费用。Qwen3 8B可在标准企业GPU上运行;Llama 3.1 8B常用于企业内部工具、客户自动化和文档处理。
在Ollama中应该使用哪个Dolphin模型?
应使用Dolphin 3.0(`ollama pull dolphin3`),而非已过时的`dolphin-mistral`(2024年模型,已停止维护)。Dolphin 3.0由Cognitive Computations开发,基于Llama 3.1构建,无内置内容过滤,适用于通用聊天、编程和智能体任务。由于没有内置的安全过滤,其输出的使用责任由你自行承担,并适用Llama 3.1许可证条款。
Ollama背后公司的官方名称是什么?
Ollama背后的公司是Ollama Inc.。“Ollama”既指该公司,也指其发布的开源CLI工具和模型运行时;项目首个公开版本v0.0.1于2023年7月8日在GitHub发布。
哪些Ollama模型最适合俄语任务?
Qwen3/Qwen 3.6和Mistral Small 3.1的原生多语言训练均包含俄语;本页不对二者的俄语表现排序;请用你自己的提示词分别测试。
参考来源
- Ollama官方库----所有支持的模型和下载命令
- OpenCompass----第三方基准榜单
- DeepSeek-R1研究论文----推理模型技术细节
- Qwen2.5开源发布博客----Qwen模型系列与性能说明