Key Takeaways
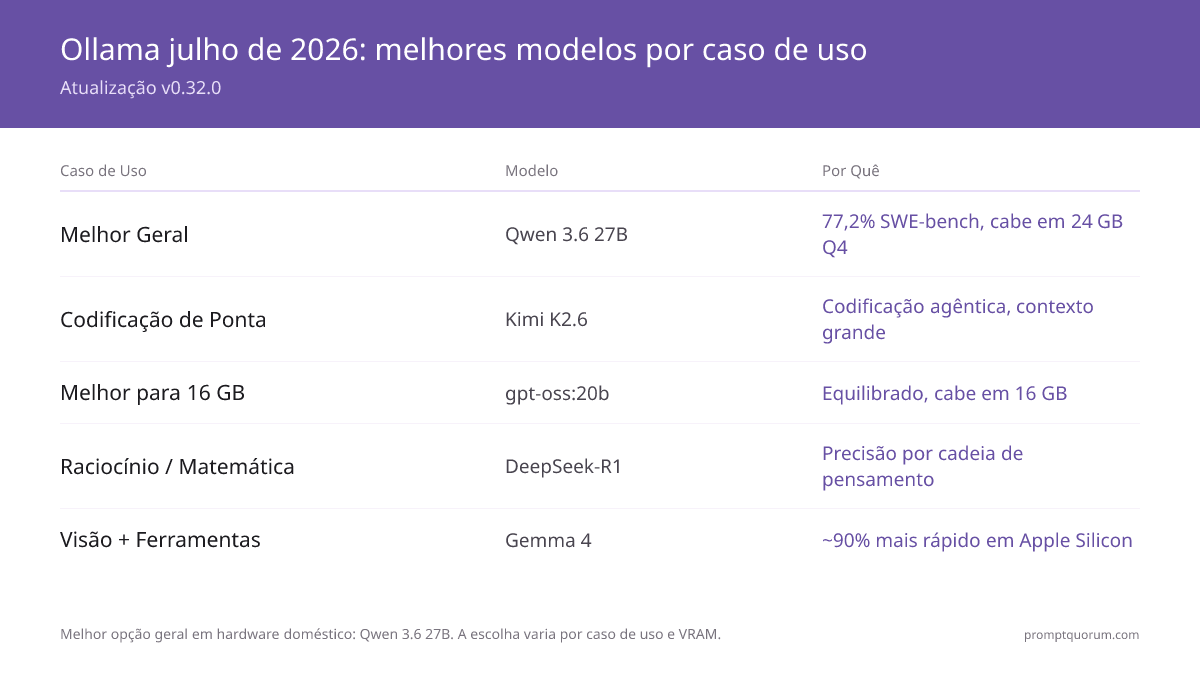
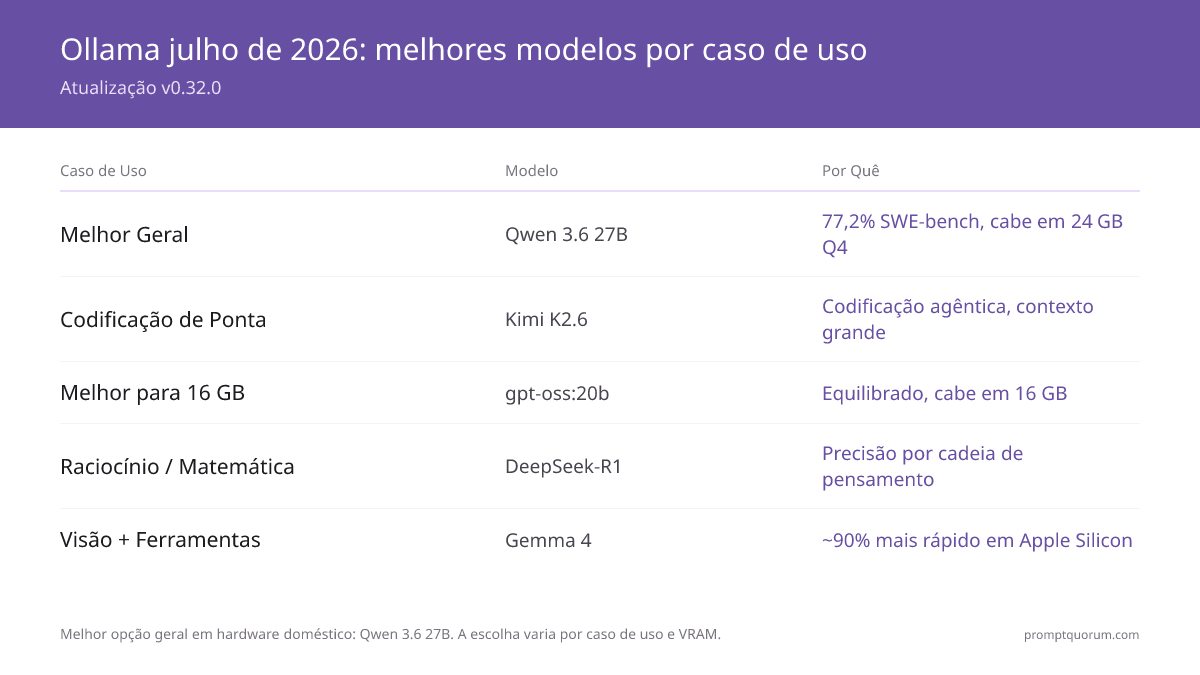
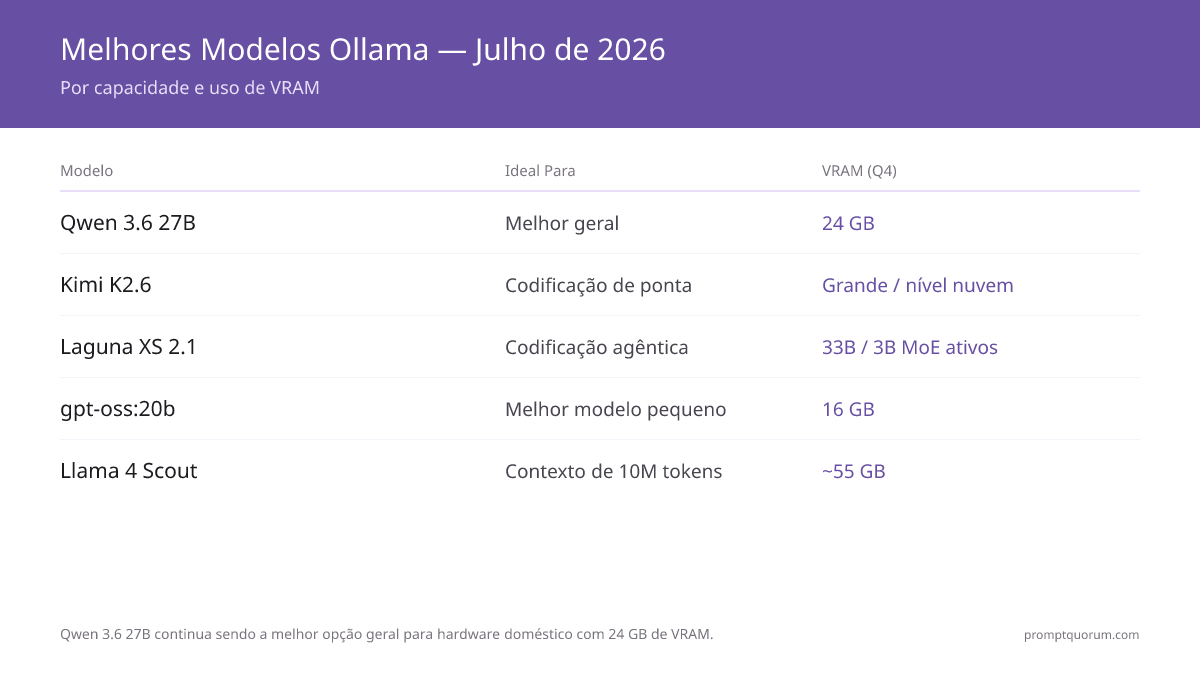
- Melhor geral em hardware de consumo: Qwen3.8-27B (61,7 no SWE-bench Pro segundo a Qwen, download de 18 GB, cabe em uma placa de 24 GB). Equilibrado: qwen3:30b.
- Mais baixado: Llama 3.2 3B (tutoriais) e a família Llama -- maior suporte de ferramentas.
- Melhor raciocínio: DeepSeek-R1 (cadeia de pensamento) e gpt-oss:20b (raciocínio ajustável, nível ~o3-mini).
- Melhor para programar: Qwen3.8-27B (melhor denso), Laguna XS 2.1 (agêntico, longa duração), Devstral Small 2 (melhor agêntico de 24B), qwen3-coder:30b (autocompletar); o Kimi K2.6 é de escala de fronteira, mas só existe na nuvem no Ollama -- maiores benchmarks divulgados para o tamanho.
- Melhor pequeno / 16 GB: gpt-oss:20b. Melhor visão/multimodal: Gemma 4 (E4B+). Melhor contexto longo (10M) / multimodal grande: Llama 4 Scout (~55 GB). Melhor uso geral sem censura: Dolphin 3.0. Agentes sempre ativos: Nemotron 3.5 Lightning.
- A biblioteca do Ollama tem centenas de modelos selecionados (milhares a mais via Modelfiles GGUF personalizados). Todos estão disponíveis com `ollama pull <nome>`.
O melhor modelo do Ollama em 2026 é o Qwen3.8-27B (61,7 no SWE-bench Pro segundo a Qwen, 18 GB); as melhores escolhas locais para programar são Qwen3.8-27B, Devstral Small 2 e Laguna XS 2.1 (o Kimi K2.6 só existe na nuvem no Ollama).
O Ollama é uma ferramenta gratuita que permite rodar modelos de IA no seu próprio computador — sem precisar de internet ou chave de API. Estes são os melhores modelos disponíveis para download com um único comando, organizados pelo que você realmente precisa.
Qual é a versão mais recente do Ollama e o que mudou?
Versão atual do Ollama: v0.40.5 (lançada em 14 de outubro de 2026). É a versão estável mais recente, disponível em ollama.com/download; a v0.40.6 (16 de outubro) está marcada como pré-versão. Atualize com `curl https://ollama.ai/install.sh | sh` (macOS: `brew upgrade ollama`) e confirme com `ollama --version`.
O que mudou da v0.33.1 (26 de agosto) à v0.40.5 (14 de outubro): a v0.34.0 (5 de setembro) tornou os modelos do Ollama utilizáveis no ChatGPT Desktop e acelerou a saída estruturada no Apple Silicon. A v0.34.1 (14 de setembro) tirou o `ollama create` com safetensors do MLX do estado experimental e acelerou `/api/tags`. A v0.34.2 (15 de setembro) adicionou um fluxo de configuração na primeira execução. A v0.34.4 (23 de setembro) adicionou saídas estruturadas em uma única passagem para modelos de raciocínio e processamento de prompts mais rápido do Qwen 3.8 no Apple Silicon. As v0.35.0 e v0.35.1 (28–29 de setembro) introduziram modelos de decisão via `/v1/systemone` e elevaram a busca na web para dez buscas por resposta. A v0.40.0 (25 de setembro) tornou o MLX o motor padrão no Apple Silicon para arquiteturas compatíveis como gemma4, qwen3.5 e qwen3.6. A v0.40.2 (8 de outubro) atualiza modelos em segundo plano na primeira execução e mantém backups. A v0.40.4 (12 de outubro) adicionou `ollama run --ask` para modelos de decisão e embeddings multimodais via llama-server. A v0.40.5 (14 de outubro) adicionou Nemotron 3.5 Super e Bolt e atualizou llama.cpp e MLX. Notas completas: github.com/ollama/ollama/releases.
Modelos mais novos da biblioteca (2026):
- Nemotron 3.5 Super, Bolt e Lightning (NVIDIA) — o Super é um modelo visão-linguagem de 120B (até 1M de contexto) adicionado na v0.40.5; o Bolt é um MoE visão-linguagem de 74B no total / 9B ativos para programação local e uso de ferramentas (25 GB, contexto de 256K); o Lightning é um MoE de 30B com 3B ativos para agentes sempre ativos (19–25 GB, contexto de 1M). Download: `ollama pull nemotron-3.5-lightning`
- Mistral Large 4 (Mistral AI) — MoE multimodal de pesos abertos com 1,05T de parâmetros no total / 52B ativos segundo sua página no Ollama: escala de datacenter, não uma escolha para hardware de consumo.
- GLM-5.3 (Z.ai) — modelo principal de pesos abertos para programação e tarefas agênticas de longa duração; o GLM-5.3 Flash é o primeiro modelo nativamente multimodal. Download: `ollama pull glm-5.3`
- Granite 4.2 (IBM, Apache 2.0) — 3B (2,2 GB), 8B (5,3 GB) e 30B (18 GB), contexto de 128K, multilíngue, código, RAG e uso de ferramentas. Download: `ollama pull granite4.2`
- Qwen3.8-27B (Alibaba, agosto de 2026) — melhor geral em hardware de consumo, 61,7 no SWE-bench Pro (segundo a Qwen), Apache 2.0, download de 18 GB com contexto de 256K. Também o Qwen3.8-Flash-Next, prévia experimental da arquitetura que deve sustentar o Qwen4. Download: `ollama pull qwen3.8:27b`
- Laguna XS 2.1 (Poolside, 2 de julho de 2026) — MoE de 33B no total / 3B ativos para programação agêntica e trabalho local de longa duração: planejar, escrever código, rodar testes e iterar. 20 GB, contexto de 256K, licença OpenMDW-1.1. SWE-bench Verified 70,9%, SWE-bench Multilingual 63,1%. Download: `ollama pull laguna-xs-2.1`
- Kimi K2.7 Code e Kimi K2.6 (Moonshot AI) — modelos de programação MoE de escala de fronteira (1T de parâmetros); no Ollama só existem como tags na nuvem (`ollama pull kimi-k2.7-code:cloud`, `ollama pull kimi-k2.6:cloud`), e builds GGUF locais exigem 300+ GB.
- gpt-oss (OpenAI) — MoE de pesos abertos: gpt-oss:20b (21B no total / 3,6B ativos, 14 GB, nível ~o3-mini, raciocínio ajustável) e gpt-oss:120b (65 GB). Download: `ollama pull gpt-oss:20b`
- Gemma 4 (Google) — E2B, E4B, 12B (contexto de 256K), MoE de 26B (4B ativos) e denso de 31B, todos com visão e chamada de ferramentas; o E4B roda com cerca de 6 GB. Download: `ollama pull gemma4:e4b`
# Atualizar o Ollama para a versão mais recente (v0.40.5)
curl https://ollama.ai/install.sh | sh

# Ou no Mac: brew upgrade ollama

# Ver a versão atual
ollama --version  # exibe: ollama version 0.40.5

# Baixar os modelos mais novos de 2026
ollama pull nemotron-3.5-lightning
ollama pull granite4.2
ollama pull laguna-xs-2.1
Quais modelos são mais populares no Ollama em 2026?
A popularidade no Ollama é medida pelo número de downloads exibido na página de cada modelo. Os mais baixados ainda são dominados pela família Llama da Meta -- o Llama 3.2 3B é o mais puxado no geral, em grande parte por ser o primeiro modelo de teste de quem instala. Já o Llama 4 Scout subiu rápido desde o lançamento em abril de 2026.
O Qwen3 é a família que mais cresce na biblioteca do Ollama, e o Qwen3 e a nova variante densa Qwen3.8 estão substituindo rapidamente o Qwen2.5. O DeepSeek-R1 teve grandes picos após o lançamento e segue muito baixado para raciocínio. O Dolphin 3.0 (Cognitive Computations, baseado no Llama 3.1) continua sendo o modelo sem censura de uso geral mais puxado para quem quer um assistente local sem filtros.
A Meta lançou o Llama 4 em abril de 2026 com as variantes Scout (17B ativos, 109B no total, MoE) e Maverick (17B ativos, 400B no total). O Llama 4 Scout está estável na biblioteca do Ollama (`ollama pull llama4:scout`). A família usa arquitetura Mixture-of-Experts (MoE) — o Scout precisa de ~55 GB de VRAM em Q4 (só cabe em 24 GB a 1,78 bit, ~20 tok/s).
Os destaques do Scout são a janela de contexto de 10M tokens e a entrada multimodal, não a adequação ao hardware de consumo. Para configurações leves (8 GB de RAM), o Llama 3.2 3B continua sendo o primeiro modelo mais fácil.
O Kimi K2.6 (Moonshot AI, licença MIT modificada, MoE de 32B ativos / 1T no total) obteve 58,6 no SWE-Bench Pro, segundo a Moonshot, mas no Ollama só existe como tag na nuvem. O Laguna XS 2.1 (Poolside) é o desafiante agêntico mais novo, feito para sessões longas de programação local. O Qwen3.8-27B atingiu 61,7 no SWE-bench Pro (segundo a Qwen) como melhor modelo geral em hardware de consumo (download de 18 GB). O gpt-oss:20b da OpenAI (MoE de 21B no total / 3,6B ativos) roda em 16 GB em nível ~o3-mini com raciocínio ajustável.
A biblioteca do Ollama tem centenas de modelos selecionados, com a família NVIDIA Nemotron 3.5, o Granite 4.2 e o GLM-5.3 entre as adições mais recentes desde a atualização anterior.
Quais modelos do Ollama funcionam melhor para cada caso de uso?
A qualidade da saída de um modelo depende muito de como você o instrui. Para técnicas estruturadas que funcionam em todos os modelos locais — incluindo cadeia de pensamento, exemplos few-shot e formatação de saída — veja o guia de engenharia de prompts. Para entender os trade-offs de quantização, veja o guia de quantização →. Para saber quanta VRAM cada modelo exige, veja o guia de requisitos de VRAM →. Para os requisitos de hardware, veja o guia de hardware →.
Para chat geral use Qwen3.8-27B; para programar, Qwen3.8-27B, Devstral Small 2 ou Laguna XS 2.1; para raciocínio, DeepSeek-R1; para visão, Gemma 4 E4B; para chat sem censura, Dolphin 3.0.
Modelos de IA diferentes se destacam em tarefas diferentes — como uma calculadora que vence um processador de texto em matemática. Esta seção associa o modelo certo a cada trabalho.
- Chat geral (iniciante): `ollama run llama3.2:3b` -- mais documentação, primeiro modelo mais bem suportado.
- Chat geral (melhor no geral): `ollama run qwen3.8:27b` -- 61,7 SWE-bench Pro (segundo a Qwen), melhor geral em hardware de consumo, download de 18 GB. Equilibrado: `ollama run qwen3:30b`. Para máquinas de 8 GB, fique com `ollama run llama3.2:3b`.
- Contexto longo / multimodal: `ollama run llama4:scout` -- contexto de 10M tokens + multimodal, MoE (17B ativos/109B no total). Precisa de ~55 GB de VRAM em Q4.
- Melhor pequeno / 16 GB: `ollama run gpt-oss:20b` -- MoE de 21B no total / 3,6B ativos, ~o3-mini, raciocínio ajustável. Maior: `ollama run gpt-oss:120b` (65 GB).
- Programação com 8 GB: `ollama run qwen3:8b` -- melhor modelo local de código para máquinas de 8 GB de VRAM, 5 GB usados, multilíngue.
- Programação (melhor agêntico, 24B): `ollama run devstral-small-2` -- edições em vários arquivos e depuração, 15 GB. Da Mistral AI.
- Programação (melhor denso, 27B): `ollama run qwen3.8:27b` -- 61,7 SWE-bench Pro (segundo a Qwen), 18 GB.
- Programação (agêntico, longa duração): `ollama run laguna-xs-2.1` -- MoE de 33B/3B ativos da Poolside, SWE-bench Verified 70,9%, contexto de 256K, 20 GB. Licença OpenMDW-1.1.
- Programação (escala de fronteira): `ollama run kimi-k2.6:cloud` -- SWE-Bench Pro 58,6 (segundo a Moonshot). O Ollama lista apenas uma tag na nuvem; builds GGUF locais exigem 300+ GB.
- Agentes sempre ativos: `ollama run nemotron-3.5-lightning` -- MoE de 30B com 3B ativos, contexto de 1M, 19–25 GB.
- Agentes e chamada de ferramentas: `ollama run gemma4:e4b` -- chamada de ferramentas + visão nativas, ~6 GB de RAM. Recomendado para agentes locais e saída estruturada.
- Raciocínio e matemática: `ollama run deepseek-r1:7b` -- modelo de cadeia de pensamento, melhor matemática local em 7B.
- Multilíngue (geral): `ollama run qwen3:8b` -- 29+ idiomas nativos, melhor suporte a idiomas não ingleses.
- Tarefas em chinês e japonês: `ollama run qwen3.8:27b` -- tokenização nativa de chinês/japonês, origem Alibaba. Veja o Contexto regional.
- Sem censura / uso geral: `ollama run dolphin3` -- Dolphin 3.0 (Cognitive Computations, baseado no Llama 3.1), sem filtragem de conteúdo embutida.
- Compreensão de imagens: `ollama run gemma4:e4b` -- visão + chamada de ferramentas. Ou `ollama run llama3.2-vision:11b` para visão dedicada.
- Modelos empresariais pequenos: `ollama run granite4.2:8b` -- IBM, Apache 2.0, 5,3 GB, contexto de 128K, multilíngue, código, RAG e ferramentas.
- Rápido e leve: `ollama run gemma2:2b` -- inferência em CPU mais rápida, 1,7 GB de RAM.
- Alta qualidade (16 GB de RAM): `ollama run mistral-small3.1` -- qualidade próxima a 70B com 14 GB de RAM.
- Embeddings: `ollama run nomic-embed-text` -- modelo de embedding de 137M de parâmetros para pipelines de RAG.
- Perguntas e respostas sobre documentos (RAG): `ollama run llama3.2` com o recurso de RAG do Open WebUI -- combinação mais bem suportada.
- Automação residencial: `ollama run phi4-mini` — o Phi-4 Mini (3,8B, ~3 GB de VRAM) atende consultas de voz do Home Assistant em um mini PC sem GPU dedicada. Veja o guia de integração Home Assistant + Ollama →.
Quais modelos foram adicionados ao Ollama mais recentemente?
Estes são os modelos mais novos da biblioteca do Ollama, do mais recente ao mais antigo. Confirme a disponibilidade com `ollama pull <modelo>` antes de montar fluxos de trabalho — modelos novos aparecem em ollama.com/library poucos dias após o lançamento.
Modelo | Lançamento | Ideal para | Comando do Ollama |
|---|---|---|---|
| nemotron-3.5-super | 14 de outubro de 2026 | NVIDIA — visão-linguagem de 120B, código, raciocínio, ferramentas, até 1M de contexto | ollama run nemotron-3.5-super |
| nemotron-3.5-bolt | 14 de outubro de 2026 | NVIDIA — MoE de 74B no total / 9B ativos, código local e ferramentas, 25 GB | ollama run nemotron-3.5-bolt |
| nemotron-3.5-lightning | 2026 | NVIDIA — MoE de 30B, 3B ativos, agentes sempre ativos, contexto de 1M | ollama run nemotron-3.5-lightning |
| glm-5.3 | 2026 | Z.ai — pesos abertos principais para código e agentes de longa duração | ollama run glm-5.3 |
| granite4.2 | 2026 | IBM — Apache 2.0, 3B / 8B / 30B, contexto de 128K | ollama run granite4.2 |
| qwen3.8:27b | agosto de 2026 | Melhor geral em hardware de consumo, 61,7 SWE-bench Pro (segundo a Qwen), 18 GB | ollama run qwen3.8:27b |
| laguna-xs-2.1 | 2 de julho de 2026 | Poolside — código agêntico, MoE 33B/3B ativos, 20 GB, contexto de 256K | ollama run laguna-xs-2.1 |
| kimi-k2.7-code | 2026 | Moonshot AI — focado em código, só tag na nuvem no Ollama | ollama run kimi-k2.7-code:cloud |
| kimi-k2.6 | 20 de abril de 2026 | Código de escala de fronteira (SWE-Bench Pro 58,6), só tag na nuvem no Ollama | ollama run kimi-k2.6:cloud |
| gpt-oss:20b | 2026 | Melhor pequeno / 16 GB, ~o3-mini, raciocínio ajustável | ollama run gpt-oss:20b |
| gemma4:e4b | 2 de abril de 2026 | Visão + chamada de ferramentas (E2B/E4B/12B/26B/31B) | ollama run gemma4:e4b |
| qwen3:30b | 2026 | Equilibrado; qwen3-coder:30b para autocompletar código | ollama run qwen3:30b |
O que é o DeepSeek-R1 e por que ele é diferente?
O DeepSeek-R1 é um modelo de raciocínio -- ao contrário dos modelos de chat comuns, que geram a resposta diretamente, ele gera uma cadeia de pensamento explícita antes da resposta final. Isso melhora bastante o desempenho em matemática, quebra-cabeças lógicos e resolução passo a passo.
O DeepSeek-R1 7B marca 52% no MATH (matemática de competição) contra 28% do Mistral Small no mesmo tamanho. É mais lento que os modelos comuns (mais tokens por resposta), mas bem mais preciso quando o raciocínio importa.
# Baixar e rodar o DeepSeek-R1
ollama run deepseek-r1:7b

# Variantes maiores para mais qualidade
ollama run deepseek-r1:14b   # 10 GB de RAM
ollama run deepseek-r1:32b   # 20 GB de RAM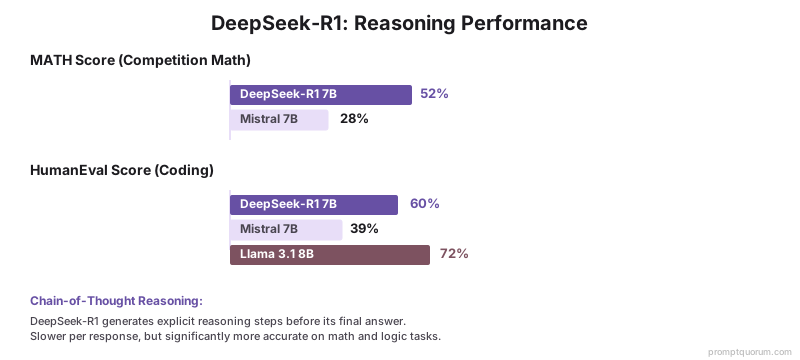
Quais modelos do Ollama aceitam imagens como entrada?
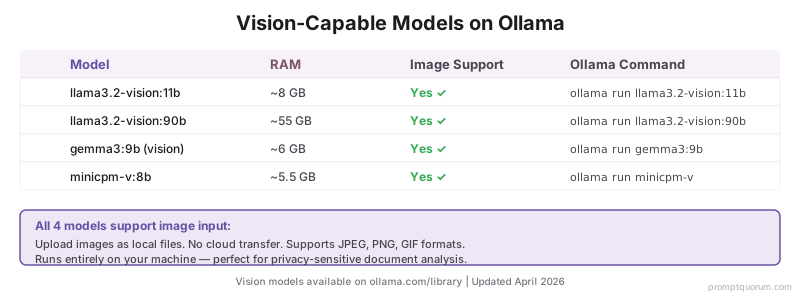
Estes modelos do Ollama aceitam imagens (multimodais): o Gemma 4 suporta visão E chamada de ferramentas — único entre os modelos de visão do Ollama — e roda quase 90% mais rápido no Apple Silicon após a atualização do MLX.
Modelo | RAM | Suporte a imagem | Comando do Ollama |
|---|---|---|---|
| llama3.2-vision:11b | ~8 GB | Sim | ollama run llama3.2-vision:11b |
| llama3.2-vision:90b | ~55 GB | Sim | ollama run llama3.2-vision:90b |
| minicpm-v:8b | ~5,5 GB | Sim | ollama run minicpm-v |
| gemma4:e4b | ~6 GB | Sim + chamada de ferramentas ✓ | ollama run gemma4:e4b |
| qwen3.8:27b | 18 GB | Sim (texto + imagem) | ollama run qwen3.8:27b |
Quais são os 10 principais modelos open source do Ollama?
As contagens de download ainda favorecem o Llama 3.x pela prevalência em tutoriais. Em projetos novos de 2026, prefira Qwen3.8-27B (melhor geral em hardware de consumo), Laguna XS 2.1 ou Devstral Small 2 (programação), gpt-oss:20b e qwen3:30b.
# | Modelo | Ideal para | RAM | Benchmark |
|---|---|---|---|---|
| 1 | Qwen3.8-27B | Melhor geral em hardware de consumo | 18 GB (Q4) | 61,7 SWE-bench Pro |
| 2 | Devstral Small 2 | Programação agêntica (vários arquivos) | 15 GB | 65,8% SWE-bench Verified |
| 3 | gpt-oss:20b | Melhor pequeno / 16 GB, raciocínio ajustável | 14 GB | ~o3-mini |
| 4 | qwen3:30b | Equilibrado; qwen3-coder:30b para código | ~18 GB | forte |
| 5 | Laguna XS 2.1 | Código agêntico de longa duração | 20 GB | 70,9% SWE-bench Verified |
| 6 | deepseek-r1:7b | Raciocínio, matemática | 5 GB | 52% MATH |
| 7 | gemma4:e4b | Visão + chamada de ferramentas (multimodal) | ~6 GB | Pronto para agentes |
| 8 | Llama 4 Scout | Contexto longo de 10M + multimodal, MoE | ~55 GB (Q4) | contexto de 10M |
| 9 | Granite 4.2 | Modelos empresariais pequenos, Apache 2.0 | 2,2–18 GB | contexto de 128K |
| 10 | Llama 3.2 3B | Primeiro modelo, chat geral | 2,5 GB | mais documentado |
Como navegar pela biblioteca de modelos do Ollama?
Há duas formas de trabalhar com modelos do Ollama. Trocar modelos instalados: no app do Ollama para Mac, clique no botão de seleção de modelo na parte inferior do campo de chat para alternar entre qualquer modelo instalado localmente. Encontrar e baixar novos modelos: acesse ollama.com/library para navegar por centenas de modelos selecionados por categoria e use os comandos abaixo para baixar e gerenciar.
# Listar todos os modelos baixados localmente
ollama list

# Buscar um modelo e baixá-lo
ollama pull qwen3.8:27b

# Ver as tags e a especificação de um modelo
ollama show qwen3.8

# Remover um modelo para liberar disco
ollama rm llama3.2:3b
Como as regras regionais de privacidade afetam a escolha do seu modelo Ollama?
UE / RGPD + conformidade de licenças. Para organizações da UE que implantam modelos Ollama em produção, a licença importa tanto quanto o desempenho. Apache 2.0 (totalmente aberta, uso comercial permitido): Mistral Small, Mistral Small 3.1, Qwen3 8B, Qwen3.8-27B, Devstral Small 2, Granite 4.2. Licença Comunitária Meta Llama (uso comercial restrito acima de 700 milhões de usuários ativos mensais): Llama 3.1 8B, Llama 3.2 3B, Llama 3.2 Vision 11B. MIT (uso comercial permitido): DeepSeek-R1 7B e 14B. MIT modificada (uso comercial permitido com cláusula de atribuição): Kimi K2.6. OpenMDW-1.1 (permissiva, uso comercial permitido): Laguna XS 2.1. Sempre confira os termos de licença antes da implantação comercial. Para empresas da UE em setores regulados, modelos da Mistral (França, Apache 2.0) como o Devstral Small 2 são um padrão sensato: origem europeia e licença permissiva. Rodar os modelos totalmente local com o Ollama significa que os prompts não são enviados a servidores externos; isso apoia, mas por si só não cumpre, as obrigações do RGPD (uma tag `:cloud` envia dados ao serviço hospedado do Ollama).
Japão (METI). Para implantações corporativas japonesas com o Ollama, Qwen3 / Qwen3.8 é uma família recomendada: processa texto japonês nativamente, o que ajuda no tempo de inferência e no cache KV. Para fluxos de programação em japonês: o Qwen3.8-27B (61,7 no SWE-bench Pro segundo a Qwen) trata comentários de código em japonês de forma nativa. A documentação de governança de IA do METI costuma pedir a versão exata do modelo. Use `ollama show <modelo>` para obter a especificação completa (parâmetros, quantização e tamanho de contexto) para registros de conformidade.
China. Pelas Medidas da CAC para IA generativa (2023), organizações que oferecem serviços de IA a usuários finais devem registrar os modelos usados. Qwen3 / Qwen3.8 (Alibaba, Apache 2.0) é uma escolha natural para implantações corporativas chinesas com o Ollama: origem chinesa, licença Apache 2.0 e bom desempenho em chinês. O Kimi K2.6 (Moonshot AI, MIT modificada) também é de origem chinesa, mas o Ollama o lista apenas como tag na nuvem e a execução local exige hardware de servidor. Comandos: `ollama run qwen3.8:27b` para a melhor qualidade, `ollama run qwen3:8b` para velocidade. O DeepSeek-R1 (licença MIT) é adequado para raciocínio. Para dados processados localmente com o Ollama, a inferência em si não aciona os requisitos de transferência internacional da PIPL; confira suas próprias obrigações de conformidade.
Quais são os erros comuns ao escolher modelos do Ollama?
Baixar a maior tag do modelo por padrão sem checar a RAM
Rodar `ollama pull llama3.3` sem especificar a tag baixa a variante padrão, normalmente a maior quantização-padrão. Em uma máquina de 8 GB de RAM, baixar o llama3.3 (70B, ~40 GB) falha ou causa uso intenso de swap. Sempre especifique a variante: `ollama pull llama3.2:3b` para máquinas de 8 GB.
Usar um modelo geral quando existe um específico para a tarefa
Para programação, modelos de código incluem suporte a FIM para completar código, o que modelos gerais não têm. Para raciocínio/matemática, `deepseek-r1:7b` marca 52% no MATH contra 28% do `mistral:7b`. Modelos específicos existem na biblioteca por um motivo.
Não verificar se um modelo está disponível antes de montar um fluxo
A biblioteca do Ollama muda com o tempo -- modelos são adicionados e, ocasionalmente, removidos. Antes de montar um pipeline de produção em torno de um modelo, confirme que ele está na biblioteca (`ollama list` localmente ou ollama.com/library). Fixe versões específicas em produção: `ollama pull llama3.1:8b-instruct-q4_K_M`.
Não especificar a quantização em modelos grandes
Rodar `ollama pull` sem sufixo de quantização baixa a variante padrão -- que pode ser maior do que sua VRAM comporta. Para 16 GB de VRAM, baixe a variante Q4_K_M explícita e rode `ollama show <modelo>` depois para confirmar que os requisitos batem com o seu hardware.
Esperar que o DeepSeek-R1 seja tão rápido quanto os modelos de chat comuns
O DeepSeek-R1 gera tokens de raciocínio em cadeia de pensamento antes da resposta final -- por isso supera os modelos comuns em matemática e lógica, mas produz 3-5x mais tokens por resposta. Para chat rápido ou respostas de uma linha, use `llama3.1:8b`. Reserve o DeepSeek-R1 para tarefas em que a precisão importa mais que a velocidade.
Tratar uma tag :cloud como se fosse inferência local
Tags como `kimi-k2.6:cloud` e `kimi-k2.7-code:cloud` enviam seus prompts ao serviço hospedado do Ollama. Se a privacidade é o motivo de usar o Ollama, escolha modelos com tag local (por exemplo, `qwen3.8:27b` ou `devstral-small-2`).
Próximos passos
- Melhores LLMs locais para código — O melhor modelo Ollama especialmente para programação →
- Melhores LLMs só com CPU — Sem GPU? Comece por aqui →
- Guia de hardware LLM local — Seu computador aguenta esses modelos? →
Perguntas frequentes
Qual é a versão mais recente do Ollama?
A versão estável mais recente do Ollama é a v0.40.5, lançada em 14 de outubro de 2026. Em 16 de outubro surgiu uma pré-versão v0.40.6, ainda não marcada como estável. Baixe em ollama.com/download ou atualize com `curl https://ollama.ai/install.sh | sh` no Linux e `brew upgrade ollama` no macOS.
Onde encontro o changelog e as notas de versão do Ollama?
As notas de cada versão ficam em github.com/ollama/ollama/releases, com a data e o changelog de cada tag. As entradas estáveis mais recentes são v0.40.5 (14 de outubro de 2026 -- suporte ao NVIDIA Nemotron 3.5 Super, acesso na nuvem aos modelos de decisão), v0.40.4 (12 de outubro -- modelos de decisão em `ollama run --ask`, carregamento mais rápido) e v0.40.0 (25 de setembro -- MLX por padrão no Apple Silicon).
Como verifico qual versão do Ollama tenho instalada?
Rode `ollama --version` no terminal. Ele imprime uma linha como `ollama version 0.40.5`. Se o número for menor que o da versão atual, atualize com `curl https://ollama.ai/install.sh | sh` (Linux) ou `brew upgrade ollama` (macOS) e rode `ollama --version` de novo para confirmar.
Quando o Ollama foi lançado pela primeira vez?
A primeira versão do Ollama, v0.0.1, foi publicada no GitHub em 8 de julho de 2023, pouco depois da criação do repositório em 26 de junho de 2023. Em outubro de 2026 o projeto havia chegado à v0.40.5. A lista completa está em github.com/ollama/ollama/releases.
Qual é o melhor modelo Ollama em 2026?
Qwen3.8-27B é o melhor em geral em hardware de consumo (61,7 SWE-bench Pro, cabe em 24 GB com Q4). Para programação frontier: Kimi K2.6. Para modelo pequeno/16 GB: gpt-oss:20b. Para contexto longo: Llama 4 Scout.
Qual modelo Ollama é melhor para programação?
Qwen3.8-27B para o melhor desempenho denso (61,7 SWE-bench Pro). Kimi K2.6 para programação frontier (SWE-Bench Pro 58,6%). Devstral Small 24B para fluxos de trabalho agentivos em múltiplos arquivos. Codestral 22B para autocompletar em IDE (FIM).
Os modelos de código aberto no Ollama são realmente gratuitos para uso comercial?
A maioria sim, mas não todos. Llama 3.x (Meta Llama Community Licence) restringe o uso comercial acima de 700M de usuários ativos mensais. Mistral Small, Qwen3 e Gemma 3 usam Apache 2.0 (totalmente compatível com uso comercial). Verifique sempre a licença antes da implantação empresarial.
Quais são os melhores novos modelos do Ollama em 2026?
Lançamentos principais em 2026: Qwen3.8-27B (melhor geral em 24 GB, 61,7 SWE-bench Pro), Kimi K2.6 (programação frontier, MoE), gpt-oss:20b (melhor pequeno/16 GB), Gemma 4 E4B (visão + tool calling) e Llama 4 Scout (contexto 10M, multimodal). Comandos: ollama run qwen3.8:27b, ollama run gpt-oss:20b, ollama run gemma4:e4b, ollama run llama4:scout.
Qual modelo Dolphin devo usar com o Ollama?
Use Dolphin 3.0 (`ollama pull dolphin3`), não o `dolphin-mistral` desatualizado de 2024. Dolphin 3.0 é mantido pela Cognitive Computations, construído sobre a base Llama 3.1, e não aplica filtragem de conteúdo — é o melhor modelo sem censura / uso geral disponível no Ollama.
Qual é o nome oficial da empresa por trás do Ollama?
A empresa é a Ollama Inc., uma startup com financiamento Series B sediada em Palo Alto, Califórnia, fundada em 2023 por Jeffrey Morgan e Michael Chiang.
Quais modelos do Ollama funcionam melhor para tarefas em russo?
Qwen3/Qwen3.8 e Mistral Small 3.1 incluem russo em seu treinamento multilíngue nativo. Qwen3 pontua mais alto em benchmarks não ingleses; Mistral Small 3.1 tem fluência conversacional em russo informalmente mais forte. Nenhum dos dois é de origem russa.
Fontes
- Meta AI. (2025). "Llama 4 Model Card." llama.meta.com -- Especificações oficiais do Llama 4 Scout (17B ativos, 109B no total, MoE) e Maverick.
- DeepSeek AI. (2025). "DeepSeek-R1 Technical Report." arxiv.org/abs/2501.12948 -- Arquitetura de cadeia de pensamento e benchmark MATH (52%) do DeepSeek-R1.
- Equipe Qwen. (2026). Ficha do modelo "Qwen3.8-27B". huggingface.co -- 61,7 no SWE-bench Pro segundo a Qwen, Apache 2.0, contexto de 256K.
- Ollama. (2026). "kimi-k2.6" na biblioteca do Ollama. ollama.com -- apenas uma tag `:cloud` listada.
- Ollama. (2026). "devstral-small-2" na biblioteca do Ollama. ollama.com -- 15 GB, SWE-bench Verified 65,8%, requer Ollama 0.13.3 ou superior.
- Ollama. (2026). "Ollama Model Library." ollama.com/library -- Biblioteca oficial de modelos, contagem de downloads, tags e opções de quantização.
- Poolside. (2026). "Introducing Laguna XS 2.1." poolside.ai -- Modelo MoE agêntico de 33B/3B ativos, SWE-bench Verified 70,9%, licença OpenMDW-1.1.
- Ollama. (2026). "Ollama Releases." github.com/ollama/ollama/releases -- Notas de versão oficiais, v0.40.5 (14 de outubro de 2026).