Melhores LLMs Locais por Nível de VRAM 2026: Ollama, LM Studio e Guia de Hardware
Os LLMs locais são grandes modelos de linguagem que rodam inteiramente no seu próprio computador — sem conexão à Internet, sem taxas de API e sem que nenhum dado saia da sua máquina. Se está a começar, instale o Ollama e rode o Llama 3.2 3B ou o Qwen3 4B com 8 GB de RAM em menos de 10 minutos; os guias abaixo classificam os melhores modelos, GPUs e ferramentas para cada orçamento.
Comece aqui
As perguntas que os leitores fazem primeiro, cada uma com o guia para abrir. Escolha a que combina com você.
Explorar por tema
12 temas, 154 guias. Um clique abre um tema ali mesmo.
Primeiros passos 13 Guias
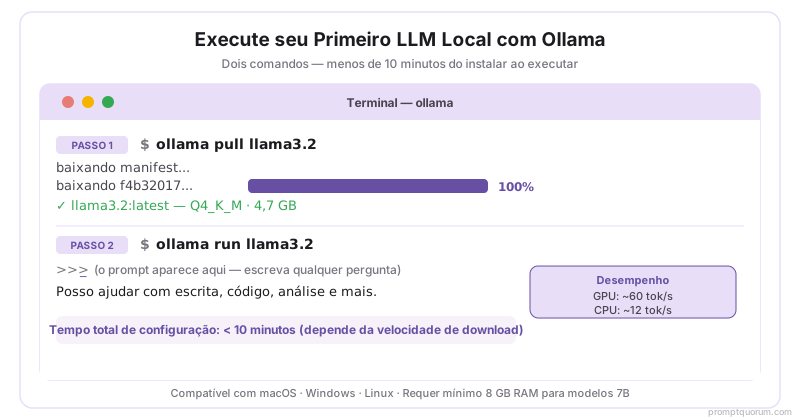
Do zero ao funcionamento em menos de 10 minutos. Guias de instalação por sistema operacional, tutoriais do primeiro modelo e um checklist de configuração com foco em privacidade para iniciantes. O Ollama é instalado com um único comando no macOS, Windows e Linux. Com 8 GB de RAM, comece com o Llama 3.2 3B (Q4, ~2 GB) usando `ollama pull llama3.2:3b`.
Modelos por caso de uso 24 Guias
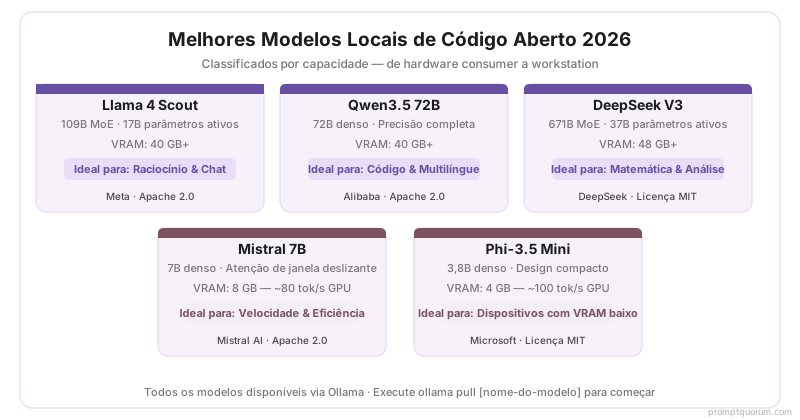
Rankings de modelos, comparativos de benchmarks e vencedores por caso de uso. Os principais modelos executáveis localmente são Llama 4 Scout 17B (melhor geral, arquitetura MoE), Qwen3.8-27B (melhor em código) e Phi-4 14B (melhor com 8 GB VRAM). Todos classificados por MMLU, HumanEval e testes reais de hardware.
Ferramentas e interfaces 27 Guias
O Ollama e o LM Studio executam mais de 200 modelos no macOS, Windows e Linux. O Ollama é CLI-first com uma API REST de produção; o LM Studio oferece uma interface gráfica com navegador de modelos integrado. Os guias cobrem as duas ferramentas, além de vLLM, llama.cpp, Open WebUI e integrações com IDEs.
Hardware e desempenho 14 Guias
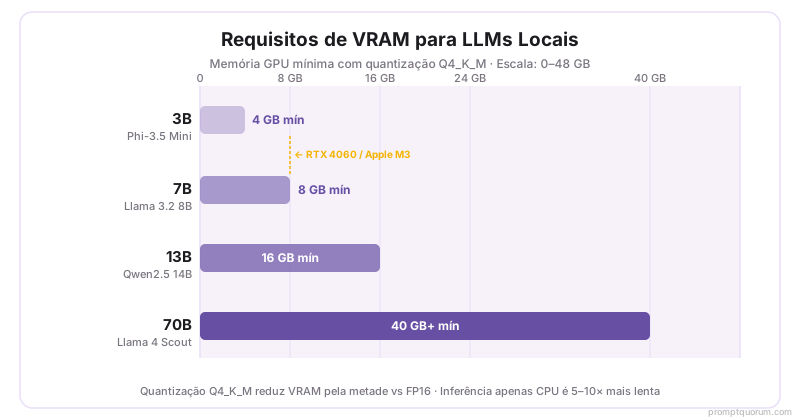
A VRAM é a principal restrição para LLMs locais. Um modelo 7B em Q4_K_M precisa de 4.7 GB; um modelo 70B precisa de 40 GB. Os guias cobrem seleção de GPU (RTX 4070 Ti à RTX 5090), Apple Silicon, builds econômicos e cálculo de VRAM para qualquer modelo.
Técnicas avançadas 13 Guias
Fine-tuning, pipelines RAG, análise profunda de quantização, destilação, fusão de modelos e otimização de prompts para uso em produção. O LoRA reduz os requisitos de VRAM para fine-tuning de 24 GB para 8 GB. O QLoRA reduz ainda mais, para 4 GB. Os fluxos de trabalho RAG locais mantêm os dados sensíveis no próprio ambiente sem perder qualidade de busca.
Enterprise 13 Guias
Configurações multi-GPU, otimização de inferência, frameworks de serviço de modelos (vLLM, TensorRT-LLM), monitoramento e observabilidade, auditorias de custos e conformidade regulatória. Os LLMs locais eliminam a transferência de dados entre fronteiras, atendem ao Artigo 28 do GDPR e reduzem os custos de licenciamento em 40–80% em relação a SaaS.
Guias de compra de GPU 6 Guias
Seleção de GPU por orçamento e caso de uso, custo por token, eficiência energética, design térmico, comparativos do mercado de usados e trade-offs de garantia. A RTX 4090 (~$1600) lida com modelos 70B; a RTX 4080 (~$800) roda 13B–20B; a RTX 4060 (~$300) é o melhor custo-benefício para modelos 7B.
Configurações de hardware 6 Guias
Guias completos de build para implantações em notebook, desktop, workstation e servidor. De configurações com uma única GPU a clusters multinó. Builds econômicos ($500–$1500), intermediários ($1500–$5000) e enterprise ($5000+) com listas exatas de peças e throughput estimado.
Privacidade e negócios 5 Guias
Implantação on-premises para conformidade (GDPR, HIPAA, APPI, CAC). Arquitetura zero-knowledge, configurações air-gapped e registro de acessos. Os LLMs locais eliminam o vendor lock-in de API, reduzem a carga de auditoria de conformidade e protegem os dados proprietários dos provedores SaaS.
Custos e comparativos 8 Guias
Análise de ponto de equilíbrio: local vs cloud vs modelos de assinatura. Custos ocultos de SaaS: taxas de excedente, assentos enterprise, logs de auditoria. O hardware local se paga em 6–18 meses para usuários intensivos. Calculadoras de ROI para diferentes tipos de carga de trabalho.
Apple Silicon 12 Guias
Guias específicos para Mac com Apple Silicon da série M — dimensionamento de memória unificada, comparativos de MLX frente a Ollama e llama.cpp, transcrição com Whisper via Metal, e configurações de Mac Mini/MacBook para inferência local. O Apple Silicon compartilha memória unificada entre CPU e GPU, então um Mac da série M com 32 GB de RAM roda modelos de 30 bilhões de parâmetros sem GPU dedicada. O MLX é o framework de inferência da própria Apple e costuma ser mais rápido que o llama.cpp no mesmo chip.
Empresa e conformidade 13 Guias
Guias de compra de servidores GPU empresariais, conformidade SOC 2 e ISO 27001 para LLMs auto-hospedados, condições de licenciamento comercial, e comparativos diretos de gateways de API, frameworks de fine-tuning, frameworks de agentes, ferramentas de avaliação, plataformas de observabilidade e bancos de dados vetoriais para implantações em produção. Alugar GPUs na nuvem costuma se pagar frente à compra de hardware on-premises em 8-14 meses para cargas de trabalho contínuas.
Respostas práticas
Quatro respostas práticas, calculadas com uma fórmula de memória simples (estimativas, não medições). As tabelas completas estão no fim da página.
Resumindo: 8 GB de RAM bastam para um modelo 7B, todos os dados ficam na sua máquina e não há custo de API depois de ter o hardware.
Atualizado recentemente
As três páginas com a alteração mais recente.
Aprofundar
Os outros universos temáticos, cada um com sua própria cor.
Visão geral em apresentação
A apresentação abaixo cobre os requisitos de hardware (8 GB VRAM para modelos 7B, 40 GB+ para 70B), os principais modelos open-source de 2026, configuração do Ollama em 5 minutos, quantização Q4_K_M, conformidade regional (GDPR, APPI) e pontos principais. Baixe o PDF como cartão de referência rápida de LLMs locais.
Perguntas frequentes
O que é um LLM local?
Um modelo de linguagem grande (por exemplo, Llama 4, Qwen3.5, DeepSeek) que roda no seu próprio hardware em vez de em uma API na cloud. Você obtém privacidade total, capacidade offline, sem limites de uso e zero custos de API após a compra do hardware.
Quanta VRAM eu preciso para um LLM local?
8 GB VRAM rodam modelos 7B com quantização Q4. 16 GB lidam com modelos 13B confortavelmente. 40 GB+ (por exemplo, duas RTX 4090 ou uma A100) são necessários para modelos 70B. A memória unificada do Apple Silicon conta como VRAM.
Qual é a diferença entre Ollama e LM Studio?
O Ollama é uma ferramenta CLI que roda modelos por meio de comandos simples no terminal e expõe uma API compatível com OpenAI em `localhost:11434`. O LM Studio oferece uma GUI desktop, navegador de modelos e interface de chat integrada. Ambos suportam os mesmos modelos.
LLMs locais conseguem competir com modelos na cloud como o GPT-4o?
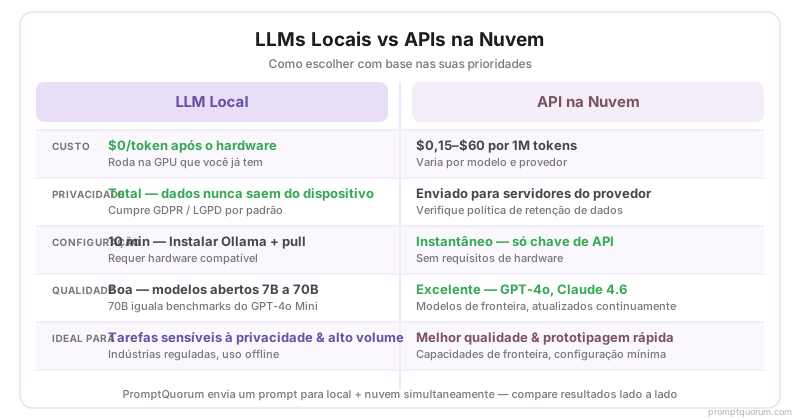
Em tarefas de código e raciocínio, Llama 4 Scout, DeepSeek V3 e Qwen3 pontuam a 5–10% do GPT-4o mini em benchmarks padrão (MMLU, HumanEval). Claude Opus 4.8 e GPT-4o mantêm vantagem em tarefas complexas de várias etapas.
Como faço fine-tuning de um modelo local?
O fine-tuning exige 500+ exemplos de treinamento rotulados, o framework QLoRA (reduz o requisito de VRAM via quantização de 4 bits), 24 GB+ VRAM (ou aluguel de GPU na cloud) e 1–4 horas de tempo de treinamento para um modelo 7B.
Qual é o hardware mínimo para rodar um LLM local em 2026?
Mínimo: 8 GB de RAM e qualquer CPU moderna (roda modelos 3B–7B a 2–5 tokens/s). Recomendado: uma GPU com 8 GB+ VRAM (RTX 3060 ou mais recente) para 20–40 tokens/s em modelos 7B.
Os LLMs locais são gratuitos?
Sim. O Ollama e o LM Studio são gratuitos e de código aberto. Os próprios modelos (Llama, Mistral, Qwen, DeepSeek) estão disponíveis sob licenças open-source sem custo. O único custo é o seu hardware.
Qual é o melhor LLM local para código em 2026?
O Qwen3-Coder 7B é o melhor para autocompletar e revisar código em hardware de consumo (8 GB VRAM). O DeepSeek-Coder V2 Lite é a alternativa mais forte. Para configurações só com CPU, o Phi-3.5 Mini oferece a melhor qualidade de código com menos de 4 GB de RAM.
Posso rodar um LLM local sem GPU?
Sim. Qualquer CPU moderna pode rodar modelos 3B–7B com quantização Q4 usando o Ollama (modo CPU) ou o LM Studio. Velocidade típica de inferência em CPU: 2–8 tokens/s em uma CPU de notebook moderna, comparado a 20–50 tokens/s em uma RTX 4060. 7B Q4 exige ~5 GB de RAM (não VRAM). Para configurações só com CPU, o Phi-3.5 Mini (3.8B) e o Llama 3.2 3B oferecem a melhor relação qualidade-velocidade.
Como atualizo os modelos de LLM local quando novas versões são lançadas?
Ollama: rode `ollama pull <model-name>` novamente — ele baixa apenas as camadas alteradas. LM Studio: abra o navegador de modelos, encontre a versão atualizada e baixe-a. Os arquivos GGUF antigos não são removidos automaticamente — apague-os manualmente em ~/.ollama/models (Ollama) ou ~/Library/Application Support/LM Studio/models (macOS) para liberar espaço em disco. As atualizações de modelos da Meta, Alibaba e Mistral normalmente chegam em 24–48 horas após o lançamento oficial.
Quais são os melhores modelos Ollama em 2026?
Top modelos Ollama de 2026: Llama 4 Scout 17B (melhor geral em 12 GB VRAM, `ollama pull llama4:scout`), Qwen3 8B (melhor código, `ollama pull qwen3:8b`, 5 GB VRAM), Gemma 3 12B (raciocínio forte na RTX 3060, 8 GB VRAM) e DeepSeek-R2 8B (melhor em matemática/lógica, 5 GB VRAM). Rode qualquer modelo com `ollama run <name>` após baixá-lo.
Qual é o melhor LLM local para uma RTX 3060 12 GB VRAM?
A RTX 3060 12 GB VRAM é uma excelente GPU para LLMs locais. Melhores opções: Llama 4 Scout 17B em Q4 (~10 GB VRAM, `ollama pull llama4:scout`), Gemma 3 12B (~8 GB VRAM) ou Qwen3 14B (~9 GB VRAM). Todos rodam a 20–40 tokens/s. Os 12 GB VRAM colocam você acima da RTX 3060 Ti (8 GB) e dão acesso a modelos da classe 13B e 17B MoE em qualidade total.
Ollama vs LM Studio vs Jan.ai: qual devo usar?
Use o Ollama se quiser uma ferramenta CLI com API compatível com OpenAI em localhost:11434 — ideal para desenvolvedores e automação. Use o LM Studio se quiser uma GUI desktop, navegador de modelos e interface de chat — ideal para iniciantes. Use o Jan.ai se quiser um app de chat com foco em privacidade e loja de modelos integrada. Os três suportam os mesmos modelos GGUF. Tempo de configuração: Ollama 2 min, LM Studio 5 min, Jan.ai 5 min.
Quais são as melhores GPUs econômicas para LLMs locais em 2026?
Melhores GPUs econômicas para LLMs locais: RTX 3060 12 GB (~$250 usada) roda modelos 13B a 20–30 tok/s. RTX 4060 8 GB (~$300 nova) roda 7B a 35–45 tok/s. RTX 3080 10 GB (~$350 usada) lida com 13B confortavelmente. Por menos de $200: RTX 2070 8 GB roda modelos 7B a 15–20 tok/s. AMD RX 6700 XT 12 GB (~$200 usada) é comparável à RTX 3060 com ROCm no Linux. Mínimo recomendado: 8 GB VRAM para inferência 7B útil. Os preços no Brasil podem variar bastante devido a impostos de importação.
What is a local LLM?
A local LLM is a large language model that runs entirely on your own hardware — CPU, GPU, or Apple Silicon — without sending data to external servers. You download the model file (typically 2–40 GB) and run it using a tool like Ollama or LM Studio. The most widely used local LLM is Meta Llama 4 Scout 17B, which runs on machines with 10 GB VRAM at 10–80 tokens/sec.
Is a local LLM better than ChatGPT?
For privacy and cost, yes. For raw output quality, no. As of 2026, frontier cloud models (GPT-4o, Claude Opus 4.8) outperform all locally-runnable models on complex reasoning. However, local 70B models (Llama 4 Scout, Qwen3 72B) match or exceed GPT-4o mini on most everyday tasks — at zero per-query cost.
How much RAM do I need to run a local LLM?
Minimum: 8 GB RAM to run a 7B model at Q4 quantization. Recommended: 16 GB for 13B models, 40+ GB for 70B models. Apple Silicon unified memory counts fully toward this — an M3 Mac with 18 GB can run a 13B model well. GPU VRAM is equivalent to RAM for GPU inference.
How do I run a local LLM?
Install Ollama (ollama.com), then run one command: `ollama run llama3.1:8b`. The model downloads automatically and you can start chatting in under 5 minutes. No API key, no account, no internet connection after the initial download.
What is the best free local LLM in 2026?
Meta Llama 4 Scout 17B for general use (Llama Community License, 10 GB VRAM). Qwen3-Coder 32B for coding (92.7% HumanEval, 20 GB VRAM). DeepSeek-R2 8B for reasoning (MIT licence, 5 GB VRAM). All are free, open-weight, and available via `ollama pull`.
Are local LLMs private?
Yes. When running with Ollama or LM Studio, your prompts, documents, and responses never leave your machine. No data is transmitted to any server. This makes local LLMs the recommended choice for GDPR-regulated workflows, legal and medical document processing, and any task involving confidential or personal information.
Pontos principais
- 8 GB de RAM são suficientes para rodar um modelo 7B localmente (Ollama ou LM Studio, configuração em menos de 10 min)
- 40 GB VRAM rodam modelos 70B (Llama 4 Scout, DeepSeek V3) em qualidade total
- A quantização Q4 reduz pela metade os requisitos de VRAM com perda mínima de qualidade — um modelo 7B cabe em 4–5 GB VRAM
- Llama 4 Scout, Qwen3, DeepSeek e Mistral igualam o GPT-4o mini na maioria dos benchmarks de código e raciocínio
- Zero custos de API após a compra do hardware — sem limites de uso, sem vendor lock-in
- Todos os dados permanecem na sua máquina — sem telemetria, sem armazenamento na cloud, pronto para o GDPR
- O fine-tuning com LoRA exige 500+ exemplos rotulados e 24 GB+ VRAM (ou GPU na cloud para treinamento)
- Guia de implantação local do Qwen 2026 — configuração Ollama em um comando para Qwen2.5 7B–72B
- Melhor GPU abaixo de $500 para inferência de LLM — RTX 4060 Ti 16 GB lidera em custo-benefício
- DeepSeek vs Qwen: comparativo local 2026 — benchmark frente a frente
- Alibaba Cloud vs Tencent Cloud GPU 2026 — GPU na cloud para o mercado chinês
- Calculadora de custo de LLM local: construir vs alugar 2026 — calculadora de ROI de 3 anos
Modelos mais recentes adicionados
| Modelo | Comando pull | VRAM | Notas |
|---|---|---|---|
| Llama 4 Scout 17B | ollama pull llama4:scout | 10 GB | Meta. Melhor qualidade geral em 12 GB VRAM |
| Qwen3.8-27B | ollama pull qwen3.8:27b | 24 GB | Alibaba. Melhor opção geral em hardware de consumo |
| Gemma 4 E2B | ollama pull gemma4:e2b | 2 GB | Google. Modelo edge eficiente, roda com GPU de 4 GB ou Raspberry Pi 5 |
| Phi-4 14B | ollama pull phi4 | 8 GB | Microsoft. Melhor raciocínio por GB, roda na RTX 3060 8 GB |
Melhor LLM local por nível de VRAM
Já sabe quanta VRAM sua GPU tem? Encontre seu nível abaixo para o modelo mais adequado — para a fórmula completa, o cálculo de quantização e as exceções MoE, veja o guia completo de VRAM.
| VRAM | Modelo ideal (Q4) | GPUs de exemplo |
|---|---|---|
| 4 GB | Llama 3.2 3B ou Phi-3.5-mini (~2 GB) | RTX 3050 4 GB, GTX 1650 |
| 8 GB | Llama 3.1 8B ou Qwen3 8B (~4-5 GB) | RTX 4060 Ti 8 GB, RTX 3070 |
| 12 GB | Qwen3 14B (~8,4 GB), ou 7-8B em Q5/Q8 para mais qualidade | RTX 3060 12 GB, RTX 4070 |
| 16 GB | Qwen3 14B em Q5/Q8, ou classe 22B (~13 GB) | RTX 4060 Ti 16 GB, RTX 4080 |
| 24 GB | Qwen3.8-27B (~22 GB, melhor opção em hardware de consumo) | RTX 4090, RTX 3090 |
| 32 GB | 22-32B em precisão total, ou 1 placa de setup dual-GPU 70B | RTX 5090 |
| 48 GB | Modelos 70B em Q4 (~35 GB), no limite em Q5 | 2x RTX 4090, RTX 6000 Ada |
O maior LLM que você consegue rodar localmente
O limite é a memória, não o software: em Q4, um modelo precisa de cerca de 0,6 GB por bilhão de parâmetros, mais 1–2 GB de folga. Uma placa de 24 GB roda um modelo da classe 27B; com 48 GB, um modelo 70B.
| Modelo | Quantização | Pesos | Cabe em |
|---|---|---|---|
| Qwen3.8-27B | Q4 | ~22 GB | 24 GB de VRAM |
| 70B (Llama 3.3, Qwen) | Q4 | ~42 GB | 48 GB de VRAM |
| 70B | Q5 | ~50 GB | Mais do que uma única placa de 48 GB |
| 70B | Q8 | ~74 GB | Configuração multi-GPU |
Falta VRAM? Veja como rodar modelos 70B com 24 GB de VRAM e o guia completo de VRAM.
Melhor quantização para 16 GB de VRAM ou RAM
O tamanho quantizado é aproximadamente parâmetros × 0,6 GB em Q4, × 0,7 em Q5 e × 1,05 em Q8, mais 1–2 GB de contexto. Com 16 GB de VRAM, Q5 é um bom padrão para modelos de 12–14B, e um modelo de 22B só cabe em Q4. Com 16 GB de RAM sem GPU, divida o orçamento pela metade: um modelo de 12B em Q4 (cerca de 7,2 GB) é a escolha confortável.
| Tamanho do modelo | Q4 | Q5 | Q8 | Cabe em 16 GB de VRAM |
|---|---|---|---|---|
| 8B | ~4,8 GB | ~5,6 GB | ~8,4 GB | Q4, Q5, Q8 |
| 12B | ~7,2 GB | ~8,4 GB | ~12,6 GB | Q4, Q5, Q8 |
| 14B | ~8,4 GB | ~9,8 GB | ~14,7 GB | Q4, Q5 |
| 22B | ~13,2 GB | ~15,4 GB | ~23,1 GB | Q4 |
Para o equilíbrio de qualidade entre os níveis de bits, veja quantização de LLM explicada.
Melhores modelos para um PC intermediário no LM Studio
Um PC intermediário tem 12–16 GB de VRAM, por exemplo uma RTX 3060 12 GB ou uma RTX 4060 Ti 16 GB. No LM Studio, procure o modelo, escolha o arquivo Q4 se o tamanho dele mais 1–2 GB couber na sua VRAM e suba para Q5 quando sobrar espaço.
| VRAM | Modelo para testar | Tamanho aprox. |
|---|---|---|
| 12 GB | Qwen3 14B em Q4 (ou um modelo da classe 12B) | ~8,4 GB (12B: ~7,2 GB) |
| 16 GB | Qwen3 14B em Q5 | ~9,8 GB |
| 16 GB | Modelo da classe 22B em Q4 | ~13,2 GB |
Instalação: como instalar o LM Studio. Em dúvida sobre qual app usar? Leia Ollama vs LM Studio.
RAG local em um notebook com pouca RAM
O RAG precisa de dois modelos pequenos: um de embeddings (nomic-embed-text, 137M de parâmetros) e um de chat. Sem GPU, o modelo de chat ocupa cerca do dobro do tamanho Q4 em GPU: um modelo de 1B uns 1,2 GB e um de 3B uns 3,6 GB. Um notebook de 2 GB é o mínimo, com quase nenhuma folga para o sistema e o índice; 8 GB é o ponto de partida prático.
| RAM do sistema | Modelo de chat (Q4) | Memória estimada (só CPU) |
|---|---|---|
| 2 GB | Llama 3.2 1B + nomic-embed-text | ~1,2 GB para o modelo de chat, muito apertado |
| 8 GB | Llama 3.2 3B + nomic-embed-text | ~3,6 GB |
| 16 GB | Modelo de 7–8B | ~8,4–9,6 GB |
Os valores são estimativas da fórmula de VRAM, não benchmarks. Configuração completa: guia de RAG local e melhores ferramentas de RAG local.
Ollama vs LM Studio vs Jan.ai: Qual você deve usar?
| Recurso | Ollama | LM Studio | Jan.ai |
|---|---|---|---|
| Interface | Terminal (CLI) | GUI desktop | GUI desktop + chat |
| Endpoint da API | localhost:11434 | localhost:1234 | localhost:1337 |
| Navegador de modelos | Apenas CLI | Integrado | Integrado |
| Ideal para | Desenvolvedores, automação | Iniciantes, usuários de GUI | Chat com foco em privacidade |
| Tempo de configuração | 2 min | 5 min | 5 min |
Conformidade e contexto regional
Brasil / LGPD
Os LLMs locais processam todos os dados no próprio ambiente. A inferência local mantém os dados pessoais dentro da organização, atendendo aos princípios da LGPD (Lei Geral de Proteção de Dados) e reduzindo a superfície de exposição fiscalizada pela ANPD (Autoridade Nacional de Proteção de Dados). O Ollama se vincula ao `localhost` por padrão — sem exposição externa.
EU / GDPR
Os LLMs locais processam todos os dados no próprio ambiente. Combinada com criptografia de disco completo e registro de acessos, a inferência local atende ao Artigo 28 do GDPR (nenhum acordo de operador de dados é necessário se os dados nunca saem da máquina). O Ollama se vincula ao `localhost` por padrão — sem exposição externa.
China / CAC
As Medidas Provisórias da Administração do Ciberespaço da China para Serviços de IA Generativa (2023) exigem o registro de provedores que ofereçam serviços a usuários chineses. Os LLMs locais que rodam inteiramente no próprio ambiente ficam fora da definição de provedor de acesso público da CAC, reduzindo significativamente a carga de conformidade em implantações enterprise.
Baixar cartão de referência de LLMs locais (PDF)
Melhore seus resultados
Está rodando um modelo local? A qualidade da sua saída depende de como você cria o prompt. Aprenda técnicas sistemáticas para obter respostas melhores de qualquer LLM local.
Respostas rápidas, sem leitura longa
Tem uma pergunta específica — quanta VRAM precisa, qual quantização escolher, Ollama ou LM Studio? O Prompt Bites responde mais de 100 dessas perguntas em menos de um minuto cada.
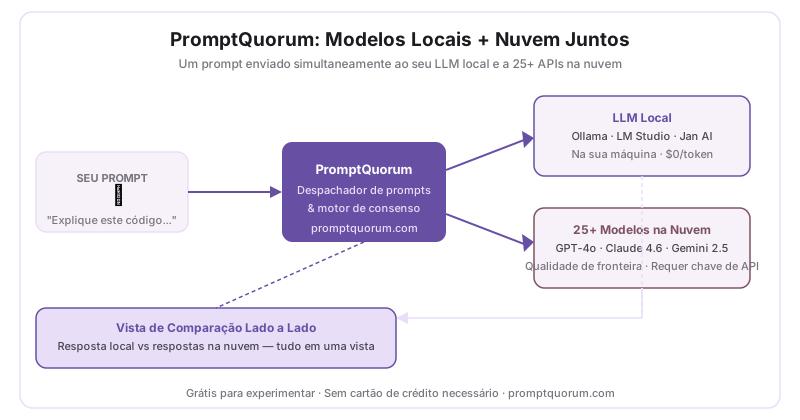
O PromptQuorum se conecta ao seu LLM local (Ollama, LM Studio, Jan AI) e envia seu prompt simultaneamente para mais de 25 modelos na cloud — compare os resultados locais vs cloud em uma única tela.
Experimente o PromptQuorum grátis →