O Que É um Modelo de Raciocínio Local?
Um modelo de raciocínio é um LLM treinado para produzir uma cadeia de pensamento explícita antes da resposta final, o que o torna muito mais forte em matemática, lógica e problemas de múltiplas etapas do que um modelo de chat padrão do mesmo tamanho. Os destilados do DeepSeek-R1 são modelos de raciocínio: eles "pensam em voz alta" dentro da resposta, verificando e revisando etapas antes de se comprometer com uma resposta.
O custo é latência e verbosidade. Um modelo de raciocínio gasta tokens extras trabalhando no problema, então uma única resposta pode levar vários segundos e centenas de tokens de raciocínio visível. Para uma prova matemática ou um quebra-cabeça de lógica, é exatamente isso que você quer; para uma consulta factual rápida, é tempo desperdiçado.
A distinção que confunde as pessoas: o DeepSeek-V3 era um modelo de chat e o DeepSeek-R1 o modelo de raciocínio. Eles compartilham linhagem de arquitetura, mas eram ajustados para trabalhos diferentes, e ambos são hoje da geração anterior: o DeepSeek-V4 oferece os modos Thinking e Non-Thinking em uma única família de modelos. Para resolver problemas passo a passo no seu próprio hardware, os destilados do R1 continuam sendo o caminho prático. Explicamos exatamente o que a destilação mantém e perde em DeepSeek-R1 vs os Destilados.
Atualização: a geração atual da DeepSeek é o DeepSeek-V4 (Flash e Pro), publicado como pesos abertos sob licença MIT (prévia: 24 de abril de 2026). A API da DeepSeek agora serve o V4: os aliases deepseek-chat (geração V3) e deepseek-reasoner (geração R1) foram anunciados como totalmente desativados após 24 de julho de 2026. Os destilados do R1 são lançamentos de pesos abertos independentes, não faziam parte desse aviso e continuam rodando localmente. O V4 em si não é um modelo para GPU de consumo: o V4-Pro tem 1.6T de parâmetros no total (49B ativos) e o V4-Flash original 284B (13B ativos). Mesmo com precisão de 4 bits (parâmetros × 0.5 byte), só os pesos exigem cerca de 140 GB (Flash) a 800 GB (Pro), e as fichas de modelo da DeepSeek não listam nenhum requisito de GPU. Para raciocínio em uma única GPU de consumo, os destilados continuam sendo a escolha prática.
Para uma introdução mais aprofundada sobre como rodar esses modelos, comece com o Guia de Hardware para LLM Local e o Quantização de LLM Explicada, que cobrem a matemática de VRAM em que este guia se baseia.
Um modelo de raciocínio local é um LLM que escreve uma cadeia de pensamento explícita antes de responder, tornando-o mais forte em matemática e lógica do que um modelo de chat do mesmo tamanho.
Pense em um modelo de raciocínio como um estudante que mostra seu trabalho. Ele é mais lento e escreve mais, mas acerta problemas de múltiplas etapas com muito mais frequência do que um modelo que dispara uma resposta.
Os 6 Destilados do DeepSeek-R1 num Relance
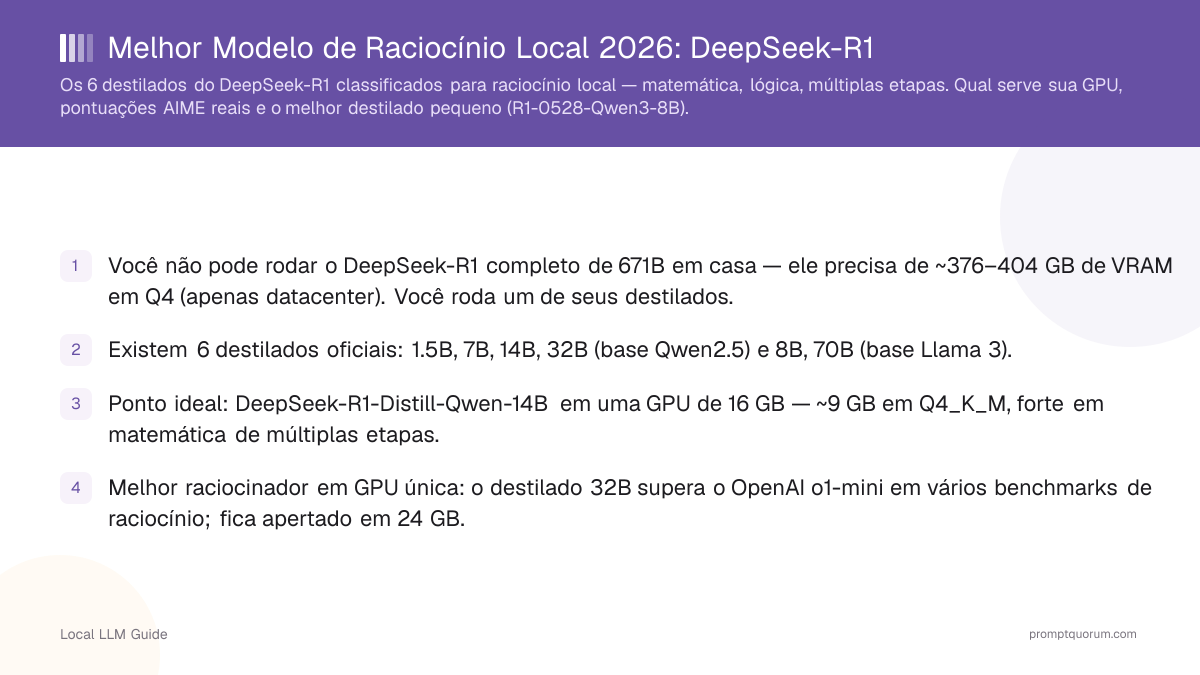
A DeepSeek lançou seis destilados oficiais do R1, cada um criado ao ajustar um modelo base aberto existente com traços de raciocínio do R1 completo de 671B. Quatro usam uma base Qwen2.5 (1.5B, 7B, 14B, 32B) e dois usam uma base Llama 3 (8B, 70B). Os números de VRAM abaixo são para a quantização padrão Q4_K_M do Ollama.
O DeepSeek-R1 tem seis destilados oficiais de 1.5B a 70B, construídos sobre bases Qwen2.5 e Llama 3, com o modelo 14B sendo o melhor equilíbrio para uma GPU de 16 GB.
Destilado | Modelo Base | Tamanho do Arquivo (Q4_K_M) | VRAM Mín. | Melhor Para |
|---|---|---|---|---|
| DeepSeek-R1-Distill-Qwen-1.5B | Qwen2.5 1.5B | ~1.1 GB | 4 GB / CPU | Dispositivos de borda, testes rápidos |
| DeepSeek-R1-Distill-Qwen-7B | Qwen2.5 7B | ~4.7 GB | 8 GB | GPUs de entrada, 55.5% AIME 2024 |
| DeepSeek-R1-Distill-Llama-8B | Llama 3 8B | ~4.9 GB | 8 GB | Fluxos com licença Llama |
| DeepSeek-R1-Distill-Qwen-14B | Qwen2.5 14B | ~9 GB | 16 GB | Melhor equilíbrio geral |
| DeepSeek-R1-Distill-Qwen-32B | Qwen2.5 32B | ~20 GB | 24 GB | Supera o o1-mini, melhor GPU única |
| DeepSeek-R1-Distill-Llama-70B | Llama 3 70B | ~43 GB | Dual-GPU / 48 GB | Destilado mais forte, precisão máxima |
O DeepSeek-R1-Distill-Llama-8B carrega tanto a licença Llama 3 quanto a licença MIT. Os destilados baseados em Qwen herdam o licenciamento Qwen. Sempre verifique a licença para uso comercial. No Ollama, a tag `deepseek-r1:8b` é o DeepSeek-R1-0528-Qwen3-8B (5.2 GB); o destilado Llama 8B é `deepseek-r1:8b-llama-distill-q4_K_M` (4.9 GB).

O Melhor Destilado de Raciocínio Pequeno: DeepSeek-R1-0528-Qwen3-8B
O DeepSeek-R1-0528-Qwen3-8B é um dos modelos de raciocínio pequenos mais fortes que você pode rodar em uma GPU de 8 GB, destilado do R1-0528 atualizado sobre uma base Qwen3 8B. Segundo o benchmark publicado pela DeepSeek, ele liderava os modelos abertos de 8B no AIME 2024 no lançamento e pontuava cerca de 10 pontos percentuais acima do Qwen3 8B base nesse benchmark — um salto significativo para matemática e lógica nesse tamanho.
Escolha-o em vez dos destilados originais 7B e 8B quando você quiser a melhor precisão de modelo pequeno e seu hardware estiver limitado a 8 GB. Ele serve o mesmo nível da RTX 3060 12GB e roda em Q4_K_M em aproximadamente 5 GB. Para a maioria dos usuários de notebook e GPU de entrada que se importam com a qualidade do raciocínio acima da velocidade bruta, este é o modelo para começar.
Se a sua GPU tem 8 GB, o mais novo R1-0528-Qwen3-8B é um dos modelos de raciocínio pequenos mais fortes — ele usa uma base melhor do que os destilados originais e pontua mais alto em matemática de competição.
Destilados do DeepSeek-R1 Classificados por Nível de Hardware
Escolha o nível mais alto que a sua VRAM suporta. Mais parâmetros significa melhor raciocínio, mas só se o modelo couber sem transbordar para a RAM do sistema (o que destrói a velocidade). Use esta classificação para combinar um destilado com a GPU que você tem ou planeja comprar.

8 GB de VRAM → DeepSeek-R1-Distill-Qwen-7B (RTX 3060 12GB)
O destilado 7B é o ponto de entrada para raciocínio local sério. Em Q4_K_M ele tem ~4.7 GB e pontua 55.5% no AIME 2024 — um resultado em matemática de nível de competição publicado pela DeepSeek. A NVIDIA RTX 3060 12GB (~$280) é a escolha de custo-benefício aqui: 12 GB deixam margem para contextos de raciocínio mais longos. Comando: `ollama run deepseek-r1:7b`. Se você quer a melhor precisão de modelo pequeno, troque pelo DeepSeek-R1-0528-Qwen3-8B na mesma placa.
16 GB de VRAM → DeepSeek-R1-Distill-Qwen-14B (RTX 4060 Ti 16GB)
O destilado 14B é o melhor modelo de raciocínio local geral: forte em matemática e lógica de múltiplas etapas, ~9 GB em Q4_K_M, com espaço para contexto em uma placa de 16 GB. A NVIDIA RTX 4060 Ti 16GB (~$420) é a GPU recomendada — 16 GB cabem o modelo e uma janela de raciocínio generosa a 165 W. Este é o nível que a maioria dos leitores deve mirar. Comando: `ollama run deepseek-r1:14b`.
24 GB de VRAM → DeepSeek-R1-Distill-Qwen-32B (RTX 4090)
O destilado 32B é o mais forte dos seis que cabem em uma única GPU de consumo e supera o OpenAI o1-mini em vários benchmarks de raciocínio, segundo os resultados publicados pela DeepSeek. Em Q4_K_M ele tem ~20 GB — apertado mas viável em uma RTX 4090 de 24 GB, deixando espaço limitado para contexto. Se a precisão de raciocínio é a sua prioridade e você tem uma placa de 24 GB, este é o modelo. Comando: `ollama run deepseek-r1:32b`. Para contextos mais longos, desça para uma quantização menor ou para o 14B.
Dual-GPU / 48 GB → DeepSeek-R1-Distill-Llama-70B
O destilado 70B é o mais forte dos seis e entrega a maior precisão de raciocínio, mas com ~43 GB (Q4) ele não cabe em nenhuma placa de consumo única. Rode-o em duas GPUs de 24 GB (por exemplo, 2× RTX 3090 ou 2× RTX 4090) ou em uma placa de workstation de 48 GB. Espere uma taxa de transferência mais lenta do que o 32B, mas as melhores respostas. Comando: `ollama run deepseek-r1:70b`. Só vale a pena se você genuinamente precisa do nível mais alto de raciocínio aberto.
Servidor Sempre Ligado → Minisforum Mini-PC
Se você quer um modelo de raciocínio rodando 24/7 sem uma torre barulhenta, um Minisforum mini-PC com uma GPU integrada ou um gabinete eGPU roda os destilados 7B e 14B como um endpoint silencioso sempre ligado. Ele não vai se equiparar a uma RTX 4090 de desktop no 32B, mas para um servidor de raciocínio doméstico respondendo consultas de matemática e lógica sob demanda, o baixo consumo em repouso e o silêncio são o atrativo. Combine-o com o destilado 7B ou 14B.
Como os Destilados do DeepSeek-R1 Pontuam em Benchmarks de Raciocínio?
Estes são benchmarks de raciocínio — AIME 2024 (matemática de competição), MATH-500 (matemática mista) e GPQA Diamond (perguntas e respostas de ciência de nível de pós-graduação). Eles medem a resolução de problemas passo a passo, não programação. O resultado principal: o destilado 32B supera o OpenAI o1-mini em vários deles, e o destilado 7B registra 55.5% no AIME 2024, conforme publicado pela DeepSeek. Nota: a OpenAI aposentou o o1-mini de sua API no fim de 2025, então as comparações com o o1-mini aqui são a referência de benchmark originalmente publicada para essas destilações, não um confronto direto com um modelo da OpenAI atualmente disponível. Para uma decisão de implantação local, o que importa são as pontuações próprias de AIME 2024 e MATH-500 de cada destilação, acima.
O DeepSeek-R1-Distill-Qwen-32B supera o OpenAI o1-mini em vários benchmarks de raciocínio, e o destilado 7B pontua 55.5% no AIME 2024.
Destilado | AIME 2024 | Nível de Raciocínio | Observações |
|---|---|---|---|
| DeepSeek-R1-Distill-Qwen-7B | 55.5% | Forte para 7B | Melhor raciocinador em GPU de entrada |
| DeepSeek-R1-0528-Qwen3-8B | Líder entre abertos 8B no lançamento | Melhor pequeno | ~+10 pts sobre o Qwen3 8B base |
| DeepSeek-R1-Distill-Qwen-14B | Maior que o 7B | Melhor equilíbrio | Ponto ideal de 16 GB |
| DeepSeek-R1-Distill-Qwen-32B | Melhor em GPU única | Supera o o1-mini | Melhor raciocinador de 24 GB |
| DeepSeek-R1-Distill-Llama-70B | Maior dos seis | Máximo | Precisa de dual-GPU |
Use pontuações exatas onde publicadas (7B = 55.5% AIME 2024) e classificações relativas nos demais casos. Os números de benchmark mudam com a quantização e as configurações de amostragem; trate-os como direcionais dentro de um nível, não absolutos.
Quando Você NÃO Deve Usar um Modelo de Raciocínio?
Evite um modelo de raciocínio quando a tarefa não for uma tarefa de raciocínio — eles são mais lentos, mais verbosos e não mais precisos em recuperação simples ou chat. Use um modelo de chat padrão como o Llama 3.3 em vez disso.
- Evite para consultas factuais rápidas — a cadeia de pensamento visível desperdiça tokens e tempo em respostas que um modelo de chat retorna instantaneamente.
- Evite para conversas abertas — modelos de raciocínio são ajustados para problemas com uma resposta correta, não para diálogo.
- Evite para pura produtividade de programação — para geração de código, vá para o guia de programação DeepSeek vs Qwen; esta página cobre apenas raciocínio.
- Evite quando a latência é crítica — se você precisa de respostas em menos de um segundo, um modelo de chat menor vence.
- Use um modelo de raciocínio quando a tarefa for matemática, lógica, planejamento de múltiplas etapas ou qualquer coisa em que mostrar o trabalho melhore a correção.
Dica Pro de Config: Temperatura 0.6 e Sem System Prompt
Defina a temperatura em 0.6 (a faixa de 0.5–0.7 é segura) e não use system prompt — coloque cada instrução no prompt do usuário. Isso segue as recomendações de uso que a DeepSeek publica para a série R1, que aconselham temperatura de 0.5–0.7 e nenhum system prompt para evitar repetições infinitas e saídas incoerentes.
Na prática: deixe o campo de system prompt do Ollama/LM Studio vazio, anteceda suas instruções à mensagem do usuário e mantenha a temperatura em 0.6. Se você vir o modelo entrar em loop ou se desviar no meio do raciocínio, esta configuração costuma resolver.
Configuração: Início Rápido com Ollama por Nível
Cada destilado instala e roda com um único comando Ollama (todos têm Q4_K_M como padrão). Instale o Ollama primeiro se você ainda não o fez — veja Como Instalar o Ollama. Depois escolha o comando para o seu nível:
ollama run deepseek-r1:1.5b   # edge / CPU
ollama run deepseek-r1:7b     # 8 GB VRAM
ollama run deepseek-r1:8b     # 8 GB VRAM (R1-0528-Qwen3-8B)
ollama run deepseek-r1:14b    # 16 GB VRAM — recommended
ollama run deepseek-r1:32b    # 24 GB VRAM — beats o1-mini
ollama run deepseek-r1:70b    # dual-GPU / 48 GB
Veredito: Qual Destilado do DeepSeek-R1 Você Deve Rodar?
A decisão se resume à sua VRAM e se você prioriza precisão ou velocidade. Aqui está a resposta em uma linha para cada caso.
Escolha o seu destilado
Use um LLM local se:
- •GPU de 16 GB → DeepSeek-R1-Distill-Qwen-14B (melhor geral, a escolha padrão)
- •GPU de 24 GB → DeepSeek-R1-Distill-Qwen-32B (supera o o1-mini, melhor raciocinador em GPU única)
- •GPU de 8 GB → DeepSeek-R1-0528-Qwen3-8B (melhor pequeno) ou o destilado 7B
- •Dual-GPU / 48 GB → DeepSeek-R1-Distill-Llama-70B (precisão máxima)
Use um modelo em nuvem se:
- •Você precisa de raciocínio de fronteira além de qualquer destilado → compare com o GPT-6.1 Sol / Claude / Gemini via PromptQuorum
- •Você não pode dedicar uma GPU → uma API de raciocínio hospedada pode ser mais barata do que comprar hardware
Decisão rápida:
- →Se estiver em dúvida, comece com o 14B em uma placa de 16 GB.
- →Rode na temperatura 0.6 sem system prompt, como a DeepSeek recomenda.
- →Para programação, use um modelo de programação — não um destilado de raciocínio.
Perguntas frequentes
O DeepSeek-R1 ainda é o modelo atual da DeepSeek?
Não. A geração atual da DeepSeek é o DeepSeek-V4 (Flash e Pro). Os aliases de API deepseek-reasoner (geração R1) e deepseek-chat (geração V3) foram anunciados como totalmente desativados após 24 de julho de 2026. Os destilados do R1 de pesos abertos são lançamentos independentes, não faziam parte desse aviso e continuam rodando localmente com o Ollama.
Posso rodar o DeepSeek-R1 completo de 671B localmente?
Não. O DeepSeek-R1 completo é um modelo Mixture-of-Experts de 671B parâmetros (~37B ativos por token) e precisa de aproximadamente 376–404 GB de VRAM em Q4 — apenas hardware de datacenter. Em casa você roda um de seus destilados (1.5B a 70B). Existe uma build Unsloth de 1.58-bit (~131 GB), mas ela roda a cerca de 0.3 tokens/segundo, o que é uma curiosidade em vez de uma configuração utilizável.
Qual destilado do DeepSeek-R1 é o melhor geral?
Para a maioria das pessoas, o DeepSeek-R1-Distill-Qwen-14B em uma GPU de 16 GB é o melhor equilíbrio entre qualidade de raciocínio, velocidade e ajuste de VRAM. Se você tem uma placa de 24 GB, o destilado 32B é mais forte e supera o OpenAI o1-mini em vários benchmarks de raciocínio.
Qual é o melhor modelo de raciocínio pequeno da DeepSeek?
O DeepSeek-R1-0528-Qwen3-8B. Ele é destilado do R1-0528 atualizado sobre uma base Qwen3 8B, liderava os modelos abertos de 8B no AIME 2024 no lançamento (benchmark publicado pela DeepSeek) e pontuava cerca de 10 pontos acima do Qwen3 8B base. Ele serve uma GPU de 8 GB em Q4_K_M.
O DeepSeek-V4 substitui as destilações do R1 como melhor modelo de raciocínio local?
Não. O DeepSeek-V4 (Flash e Pro) é a geração atual da DeepSeek e sai como pesos abertos sob licença MIT, mas é grande demais para uma única GPU de consumo: o V4-Pro tem 1.6T de parâmetros (49B ativos) e o V4-Flash original 284B (13B ativos), então só os pesos exigem cerca de 140–800 GB mesmo com 4 bits. Para raciocínio local em uma única placa, os destilados do R1 desta página continuam sendo a escolha prática; o V4 é para hardware multi-GPU ou de data center, ou para a API hospedada da DeepSeek.
A comparação "supera o OpenAI o1-mini" ainda faz sentido?
Como referência fixa de benchmark, sim: as pontuações publicadas pela DeepSeek não mudaram. Como comparação atual, não: a página de descontinuações da OpenAI informa que o o1-mini foi desativado em 27 de outubro de 2025, e os modelos atuais da OpenAI são a família GPT-6 (Astra, Sol e Luna). Confie nas pontuações de AIME 2024 e MATH-500 de cada destilado; como referência atual da OpenAI, rode o mesmo prompt no GPT-6 Luna, sua camada otimizada em custo.
Quanta VRAM cada destilado precisa?
No padrão Q4_K_M do Ollama: o 7B precisa de ~8 GB (arquivo ~4.7 GB), o 14B precisa de ~16 GB (arquivo ~9 GB), o 32B precisa de ~24 GB (arquivo ~20 GB) e o 70B precisa de dual-GPU ou 48 GB (arquivo ~43 GB). FP16 é aproximadamente 4× o tamanho do Q4_K_M; Q8_0 é aproximadamente 2×.
O DeepSeek-R1 é bom em programação?
Este guia classifica apenas raciocínio (matemática, lógica, múltiplas etapas). Para geração de código, os trade-offs são diferentes — veja nossa comparação dedicada em /pt/power-local-llm/deepseek-vs-qwen-coding-local-2026 em vez de escolher um destilado de raciocínio para produtividade de programação.
Qual é a diferença entre o DeepSeek-V3 e o DeepSeek-R1?
O DeepSeek-V3 (dezembro de 2024) é um modelo de chat ajustado para conversa; o DeepSeek-R1 (janeiro de 2025) é um modelo de raciocínio que produz uma cadeia de pensamento explícita antes de responder. Ambos são hoje da geração anterior: o DeepSeek-V4 reúne os modos Thinking e Non-Thinking em uma única família de modelos. Para matemática e lógica local em uma GPU de consumo, use um destilado do R1.
Por que o meu destilado do DeepSeek-R1 entra em loop ou produz besteira?
Muitas vezes é um problema de configuração. Defina a temperatura em 0.6 (0.5–0.7 está bom) e remova qualquer system prompt — coloque todas as instruções na mensagem do usuário. As recomendações de uso da DeepSeek para o R1 aconselham essa configuração para evitar repetições infinitas e saídas incoerentes.
Como eu instalo um destilado do DeepSeek-R1?
Instale o Ollama, depois rode um comando para o seu nível, por exemplo `ollama run deepseek-r1:14b`. Todos os destilados têm Q4_K_M como padrão. Veja a seção de configuração acima para a lista completa de comandos.
O destilado 8B tem uma licença diferente?
Sim. O DeepSeek-R1-Distill-Llama-8B carrega a licença Llama 3 além da MIT, porque sua base é o Llama 3. Os destilados baseados em Qwen (1.5B, 7B, 14B, 32B) herdam o licenciamento Qwen. Verifique a licença antes do uso comercial.
Devo comprar uma RTX 4060 Ti 16GB ou uma RTX 4090 para raciocínio?
Se o seu orçamento permite a RTX 4090 e você quer rodar o destilado 32B (que supera o o1-mini), compre a 4090. Se você quer o melhor custo-benefício e o destilado 14B atende às suas necessidades, a RTX 4060 Ti 16GB a ~$420 é a compra mais inteligente.
Registro de Atualizações
- Publicado em 2026-06-19. Próxima revisão prevista para 2026-12-19 (nível de frescor semestral).
- Cobre os 6 destilados oficiais do DeepSeek-R1 mais o DeepSeek-R1-0528-Qwen3-8B. Verificado em relação às pontuações AIME 2024 publicadas e aos números de VRAM Q4_K_M de junho de 2026.
- Atualizado em 2026-10-19: indicado no início que o R1 não é mais a geração atual da DeepSeek (a atual é o DeepSeek-V4); corrigida a cifra de hardware do V4 (o V4-Pro tem 1.6T de parâmetros, então seus pesos chegam a centenas de GB, não 48–80 GB); registrado que os aliases de API deepseek-chat e deepseek-reasoner foram anunciados como desativados após 2026-07-24; régua o1-mini marcada como histórica (desativado em 2025-10-27) e referências desatualizadas da OpenAI substituídas pela família GPT-6; corrigidos a nota da tag deepseek-r1:8b e os tamanhos de arquivo do Ollama (32B 20 GB, 70B 43 GB). Próxima revisão prevista: 2027-04-19.