ما هو نموذج الاستدلال المحلي؟
نموذج الاستدلال هو نموذج لغوي مُدرَّب على إنتاج سلسلة تفكير صريحة (chain-of-thought) قبل إجابته النهائية، ما يجعله أقوى بكثير في الرياضيات والمنطق والمشكلات متعددة الخطوات من نموذج محادثة عادي بالحجم نفسه. نماذج DeepSeek-R1 المُقطّرة هي نماذج استدلال: فهي "تفكّر بصوت عالٍ" داخل الإجابة، تتحقّق من الخطوات وتراجعها قبل الالتزام بإجابة.
المقايضة هي زمن الاستجابة والإسهاب. ينفق نموذج الاستدلال tokens إضافية في معالجة المشكلة، لذا قد تستغرق إجابة واحدة عدة ثوانٍ ومئات من tokens الاستدلال المرئي. لإثبات رياضي أو لغز منطقي هذا بالضبط ما تريده؛ أما للبحث السريع عن معلومة فهو وقت مهدور.
الفرق الذي يربك الناس: DeepSeek-V3 كان نموذج محادثة، وDeepSeek-R1 نموذج الاستدلال. يتشاركان أصل المعمارية لكنهما كانا مُضبَطين لمهام مختلفة، وكلاهما اليوم من الجيل السابق؛ إذ يوفّر DeepSeek-V4 وضعي Thinking وNon-Thinking ضمن عائلة نماذج واحدة. ولحل المشكلات خطوةً بخطوة على عتادك الخاص تبقى نماذج R1 المُقطّرة الطريق العملي. نشرح بالضبط ما يحتفظ به التقطير وما يفقده في DeepSeek-R1 مقابل النماذج المُقطّرة.
تحديث: الجيل الحالي من DeepSeek هو DeepSeek-V4 (Flash وPro)، صدر بأوزان مفتوحة بترخيص MIT (النسخة التجريبية: 24 أبريل 2026). تقدّم واجهة DeepSeek البرمجية الآن V4: فقد أُعلن أن الاسمين المستعارين deepseek-chat (جيل V3) وdeepseek-reasoner (جيل R1) سيُوقفان نهائيًا بعد 24 يوليو 2026. نماذج R1 المُقطّرة إصدارات مستقلة بأوزان مفتوحة، ولم تكن ضمن هذا الإعلان، وما زالت تعمل محليًا. أما V4 نفسه فليس نموذجًا لبطاقات الرسوميات الاستهلاكية: يضم V4-Pro إجمالي 1.6T معامل (49B نشط)، ويضم V4-Flash الأصلي 284B (13B نشط)، وحتى بدقة 4 بت (عدد المعاملات × 0.5 بايت) تحتاج الأوزان وحدها إلى نحو 140 جيجابايت (Flash) حتى 800 جيجابايت (Pro)، ولا تذكر بطاقات نماذج DeepSeek أي متطلبات لوحدة GPU. وللاستدلال على بطاقة استهلاكية واحدة تبقى النماذج المُقطّرة الخيار العملي.
للحصول على مقدمة أعمق حول تشغيل هذه النماذج، ابدأ بـ دليل عتاد LLM المحلي وشرح تكميم LLM، اللذين يغطيان حسابات VRAM التي يعتمد عليها هذا الدليل.
نموذج الاستدلال المحلي هو نموذج لغوي يكتب سلسلة تفكير صريحة قبل الإجابة، ما يجعله أقوى في الرياضيات والمنطق من نموذج محادثة بالحجم نفسه.
تخيّل نموذج الاستدلال كطالب يُظهر خطوات حلّه. إنه أبطأ ويكتب أكثر، لكنه يحلّ المشكلات متعددة الخطوات بشكل صحيح أكثر بكثير من نموذج يقذف الإجابة دفعةً واحدة.
نماذج DeepSeek-R1 المُقطّرة الستة في لمحة
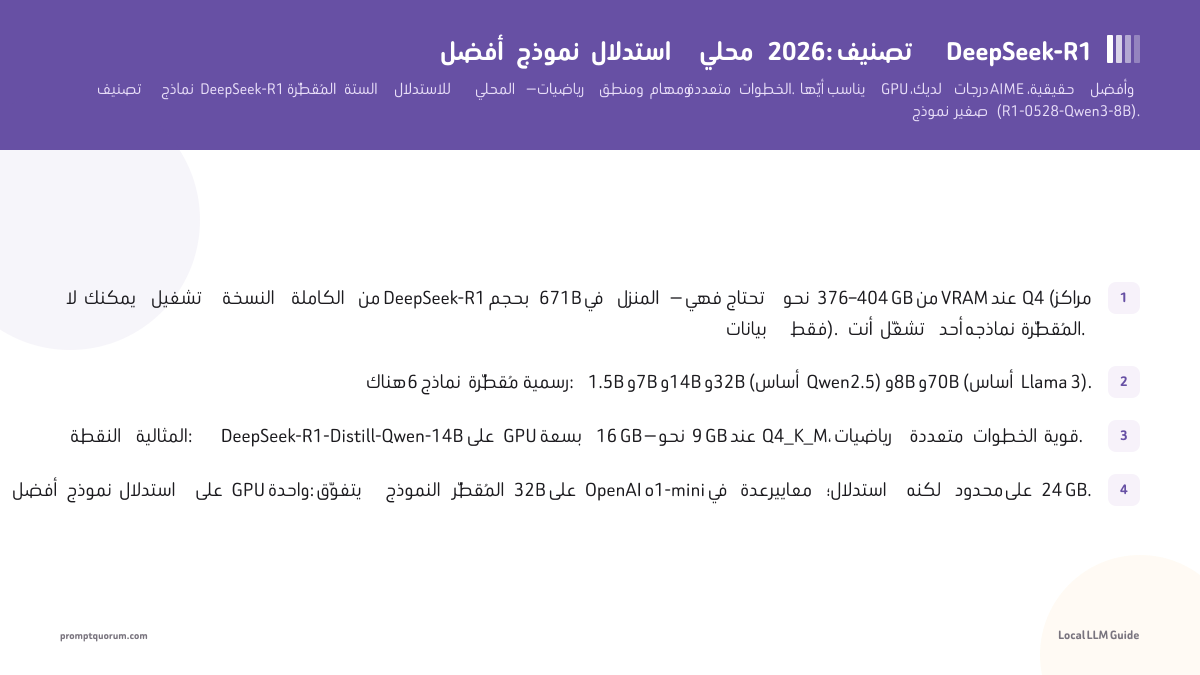
أصدرت DeepSeek ستة نماذج مُقطّرة رسمية من R1، أُنشئ كلٌّ منها بضبط دقيق لنموذج أساس مفتوح موجود على آثار استدلال من النسخة الكاملة 671B من R1. أربعة منها تستخدم أساس Qwen2.5 (1.5B و7B و14B و32B) واثنان يستخدمان أساس Llama 3 (8B و70B). أرقام VRAM أدناه مخصصة لتكميم Ollama الافتراضي Q4_K_M.
لدى DeepSeek-R1 ستة نماذج مُقطّرة رسمية من 1.5B إلى 70B، مبنية على أساسي Qwen2.5 وLlama 3، مع كون النموذج 14B أفضل توازن لـ GPU بسعة 16 GB.
Distill | Base Model | File Size (Q4_K_M) | Min VRAM | Best For |
|---|---|---|---|---|
| DeepSeek-R1-Distill-Qwen-1.5B | Qwen2.5 1.5B | ~1.1 GB | 4 GB / CPU | أجهزة طرفية، اختبارات سريعة |
| DeepSeek-R1-Distill-Qwen-7B | Qwen2.5 7B | ~4.7 GB | 8 GB | بطاقات GPU مبتدئة، 55.5% في AIME 2024 |
| DeepSeek-R1-Distill-Llama-8B | Llama 3 8B | ~4.9 GB | 8 GB | مهام بترخيص Llama |
| DeepSeek-R1-Distill-Qwen-14B | Qwen2.5 14B | ~9 GB | 16 GB | أفضل توازن عام |
| DeepSeek-R1-Distill-Qwen-32B | Qwen2.5 32B | ~20 GB | 24 GB | يتفوّق على o1-mini، أفضل GPU واحدة |
| DeepSeek-R1-Distill-Llama-70B | Llama 3 70B | ~43 GB | Dual-GPU / 48 GB | أقوى نموذج مُقطّر، أقصى دقة |
يحمل DeepSeek-R1-Distill-Llama-8B ترخيص Llama 3 وترخيص MIT معًا. أما النماذج المُقطّرة القائمة على Qwen فترث ترخيص Qwen. تحقّق دائمًا من الترخيص قبل الاستخدام التجاري. في Ollama، الوسم `deepseek-r1:8b` هو DeepSeek-R1-0528-Qwen3-8B (5.2 GB)؛ أما نموذج Llama 8B المُقطّر فهو `deepseek-r1:8b-llama-distill-q4_K_M` (4.9 GB).

أفضل نموذج استدلال صغير مُقطّر: DeepSeek-R1-0528-Qwen3-8B
DeepSeek-R1-0528-Qwen3-8B هو من أقوى نماذج الاستدلال الصغيرة التي يمكنك تشغيلها على GPU بسعة 8 GB، مُقطّر من النسخة المُحدّثة R1-0528 على أساس Qwen3 8B. وفق المعيار الذي نشرته DeepSeek، كان يتصدّر نماذج 8B المفتوحة في AIME 2024 عند إصداره وسجّل نحو 10 نقاط مئوية أعلى من أساس Qwen3 8B في ذلك المعيار — قفزة ذات معنى للرياضيات والمنطق في هذا الحجم.
اخترْه بدلًا من النماذج المُقطّرة الأصلية 7B و8B عندما تريد أفضل دقة لنموذج صغير ويكون عتادك محدودًا عند 8 GB. يناسب فئة RTX 3060 12GB نفسها ويعمل عند Q4_K_M في نحو 5 GB. لمعظم مستخدمي الحواسيب المحمولة وبطاقات GPU المبتدئة الذين يهتمون بجودة الاستدلال أكثر من السرعة الخام، هذا هو النموذج الذي تبدأ به.
إن كان لدى GPU لديك 8 GB، فإن R1-0528-Qwen3-8B الأحدث هو من أقوى نماذج الاستدلال الصغيرة — فهو يستخدم أساسًا أفضل من النماذج المُقطّرة الأصلية ويسجّل درجات أعلى في رياضيات المسابقات.
نماذج DeepSeek-R1 المُقطّرة مُصنّفة حسب فئة العتاد
اختر أعلى فئة يدعمها VRAM لديك. مزيد من المعاملات يعني استدلالًا أفضل، لكن فقط إذا كان النموذج يناسب دون تسرّب إلى ذاكرة النظام (ما يُسقط السرعة). استخدم هذا التصنيف لمطابقة نموذج مُقطّر مع GPU التي تملكها أو تخطّط لشرائها.

8 GB VRAM → DeepSeek-R1-Distill-Qwen-7B (RTX 3060 12GB)
النموذج المُقطّر 7B هو نقطة الدخول للاستدلال المحلي الجاد. عند Q4_K_M يبلغ حجمه نحو 4.7 GB ويسجّل 55.5% في AIME 2024 — وهي نتيجة في رياضيات على مستوى المسابقات نشرتها DeepSeek. تُعدّ NVIDIA RTX 3060 12GB (نحو $280) خيار القيمة هنا: تترك 12 GB هامشًا لسياقات استدلال أطول. الأمر: `ollama run deepseek-r1:7b`. إن أردت أفضل دقة لنموذج صغير، استبدله بـ DeepSeek-R1-0528-Qwen3-8B على البطاقة نفسها.
16 GB VRAM → DeepSeek-R1-Distill-Qwen-14B (RTX 4060 Ti 16GB)
النموذج المُقطّر 14B هو أفضل نموذج استدلال محلي عمومًا: رياضيات ومنطق متعددا الخطوات قويان، نحو 9 GB عند Q4_K_M، مع متّسع للسياق على بطاقة بسعة 16 GB. تُعدّ NVIDIA RTX 4060 Ti 16GB (نحو $420) هي GPU المُوصى بها — تتّسع 16 GB للنموذج ولنافذة استدلال سخية عند 165 W. هذه هي الفئة التي ينبغي أن يستهدفها معظم القرّاء. الأمر: `ollama run deepseek-r1:14b`.
24 GB VRAM → DeepSeek-R1-Distill-Qwen-32B (RTX 4090)
النموذج المُقطّر 32B هو الأقوى بين النماذج الستة التي تناسب GPU استهلاكية واحدة، ويتفوّق على OpenAI o1-mini في عدة معايير استدلال وفق النتائج التي نشرتها DeepSeek. عند Q4_K_M يبلغ حجمه نحو 20 GB — محدود لكنه عملي على RTX 4090 بسعة 24 GB، ما يترك مساحة محدودة للسياق. إن كانت دقة الاستدلال أولويتك ولديك بطاقة بسعة 24 GB، فهذا هو النموذج. الأمر: `ollama run deepseek-r1:32b`. للسياقات الأطول، انتقل إلى تكميم أصغر أو إلى النموذج 14B.
GPU مزدوجة / 48 GB → DeepSeek-R1-Distill-Llama-70B
النموذج المُقطّر 70B هو الأقوى بين الستة ويقدّم أعلى دقة استدلال، لكنه عند نحو 43 GB (Q4) لا يناسب أي بطاقة استهلاكية واحدة. شغّله عبر بطاقتي GPU بسعة 24 GB (مثل 2× RTX 3090 أو 2× RTX 4090) أو على بطاقة محطة عمل بسعة 48 GB. توقّع إنتاجية أبطأ من النموذج 32B لكن مع أفضل الإجابات. الأمر: `ollama run deepseek-r1:70b`. لا يستحق العناء إلا إن كنت تحتاج فعلًا إلى الفئة العليا من الاستدلال المفتوح.
خادم يعمل دائمًا → Minisforum Mini-PC
إن أردت نموذج استدلال يعمل على مدار الساعة دون برج صاخب، فإن حاسوب Minisforum المصغّر بـ GPU مدمجة أو بصندوق eGPU خارجي يشغّل النموذجين المُقطّرين 7B و14B كنقطة نهاية هادئة تعمل دائمًا. لن يضاهي سطح مكتب بـ RTX 4090 على النموذج 32B، لكن لخادم استدلال منزلي يجيب على استفسارات الرياضيات والمنطق عند الطلب، يكون انخفاض طاقة الخمول والهدوء هما عامل الجذب. اقرنه بالنموذج المُقطّر 7B أو 14B.
كيف تسجّل نماذج DeepSeek-R1 المُقطّرة في معايير الاستدلال؟
هذه معايير استدلال — AIME 2024 (رياضيات المسابقات)، وMATH-500 (رياضيات مختلطة)، وGPQA Diamond (أسئلة وأجوبة علمية على مستوى الدراسات العليا). تقيس حل المشكلات خطوةً بخطوة، لا البرمجة. النتيجة البارزة: يتفوّق النموذج المُقطّر 32B على OpenAI o1-mini في عدة من هذه المعايير، ويسجّل النموذج المُقطّر 7B 55.5% في AIME 2024، وهي الدرجة التي نشرتها DeepSeek. ملاحظة: أوقفت OpenAI o1-mini من واجهة API الخاصة بها في أواخر 2025، لذا فإن مقارنات o1-mini هنا هي نقطة المرجع القياسية الأصلية المنشورة لهذه النماذج المقطّرة، وليست مقارنة مباشرة حية مقابل نموذج من OpenAI متاح حاليًا. لقرار النشر المحلي، درجات AIME 2024 وMATH-500 الخاصة بكل نموذج مقطّر أعلاه هي التي تهم.
يتفوّق DeepSeek-R1-Distill-Qwen-32B على OpenAI o1-mini في عدة معايير استدلال، ويسجّل النموذج المُقطّر 7B 55.5% في AIME 2024.
Distill | AIME 2024 | Reasoning Tier | Notes |
|---|---|---|---|
| DeepSeek-R1-Distill-Qwen-7B | 55.5% | قوي بالنسبة لـ 7B | أفضل نموذج استدلال على GPU مبتدئة |
| DeepSeek-R1-0528-Qwen3-8B | متصدّر 8B المفتوحة عند الإصدار | أفضل نموذج صغير | نحو +10 نقاط فوق أساس Qwen3 8B |
| DeepSeek-R1-Distill-Qwen-14B | أعلى من 7B | أفضل توازن | نقطة 16 GB المثالية |
| DeepSeek-R1-Distill-Qwen-32B | الأفضل على GPU واحدة | يتفوّق على o1-mini | أفضل نموذج استدلال على 24 GB |
| DeepSeek-R1-Distill-Llama-70B | الأعلى بين الستة | الأقصى | يحتاج GPU مزدوجة |
استخدم الدرجات الدقيقة حيثما نُشرت (7B = 55.5% في AIME 2024) والتصنيفات النسبية في غير ذلك. تتغيّر أرقام المعايير مع التكميم وإعدادات أخذ العينات؛ تعامل معها كمؤشرات اتجاهية داخل الفئة، لا كقيم مطلقة.
متى لا ينبغي أن تستخدم نموذج استدلال؟
تجنّب نموذج الاستدلال عندما لا تكون المهمة مهمة استدلال — فهو أبطأ وأكثر إسهابًا وليس أدقّ في الاسترجاع البسيط أو المحادثة. استخدم بدلًا منه نموذج محادثة عادي مثل Llama 3.3.
- تجنّبه للبحث السريع عن المعلومات — سلسلة التفكير المرئية تهدر tokens ووقتًا على إجابات يُرجعها نموذج المحادثة فورًا.
- تجنّبه للمحادثة المفتوحة — نماذج الاستدلال مُضبَطة للمشكلات ذات الإجابة الصحيحة، لا للحوار.
- تجنّبه لإنتاجية البرمجة الصرفة — لتوليد الكود، توجّه إلى دليل المقارنة بين DeepSeek وQwen للبرمجة؛ تغطّي هذه الصفحة الاستدلال فقط.
- تجنّبه عندما يكون زمن الاستجابة حرجًا — إن كنت تحتاج استجابات دون الثانية، فنموذج محادثة أصغر يفوز.
- استخدم نموذج استدلال عندما تكون المهمة رياضيات أو منطقًا أو تخطيطًا متعدد الخطوات أو أي شيء يحسّن فيه إظهار الحل صحة الإجابة.
نصيحة احترافية للإعداد: درجة الحرارة 0.6 ودون مُوجّه نظام
اضبط درجة الحرارة على 0.6 (نطاق 0.5–0.7 آمن) ولا تستخدم مُوجّه نظام — ضع كل تعليمة في مُوجّه المستخدم. يتوافق هذا مع توصيات الاستخدام التي نشرتها DeepSeek لسلسلة R1، والتي تنصح بدرجة حرارة بين 0.5 و0.7 وعدم استخدام مُوجّه نظام لتجنّب التكرار اللانهائي والمخرجات غير المتماسكة.
عمليًا: اترك حقل مُوجّه النظام في Ollama/LM Studio فارغًا، وأضف تعليماتك في بداية رسالة المستخدم، وأبقِ درجة الحرارة على 0.6. إن رأيت النموذج يدور أو ينحرف في منتصف الاستدلال، فهذا الإعداد يحلّ المشكلة في كثير من الأحيان.
الإعداد: بدء سريع مع Ollama لكل فئة
يُثبَّت كل نموذج مُقطّر ويعمل بأمر Ollama واحد (الكل افتراضيًا Q4_K_M). ثبّت Ollama أولًا إن لم تكن قد فعلت — راجع كيفية تثبيت Ollama. ثم اختر الأمر المناسب لفئتك:
ollama run deepseek-r1:1.5b   # edge / CPU
ollama run deepseek-r1:7b     # 8 GB VRAM
ollama run deepseek-r1:8b     # 8 GB VRAM (R1-0528-Qwen3-8B)
ollama run deepseek-r1:14b    # 16 GB VRAM — recommended
ollama run deepseek-r1:32b    # 24 GB VRAM — beats o1-mini
ollama run deepseek-r1:70b    # dual-GPU / 48 GB
الحكم: أيّ نموذج DeepSeek-R1 مُقطّر ينبغي أن تشغّل؟
يتلخّص القرار في سعة VRAM لديك وما إذا كنت تعطي الأولوية للدقة أم للسرعة. إليك الإجابة المختصرة لكل حالة.
اختر نموذجك المُقطّر
استخدم LLM محليًا إذا:
- •GPU بسعة 16 GB → DeepSeek-R1-Distill-Qwen-14B (الأفضل عمومًا، الخيار الافتراضي)
- •GPU بسعة 24 GB → DeepSeek-R1-Distill-Qwen-32B (يتفوّق على o1-mini، أفضل نموذج استدلال على GPU واحدة)
- •GPU بسعة 8 GB → DeepSeek-R1-0528-Qwen3-8B (أفضل نموذج صغير) أو النموذج المُقطّر 7B
- •GPU مزدوجة / 48 GB → DeepSeek-R1-Distill-Llama-70B (أقصى دقة)
استخدم نموذجًا سحابيًا إذا:
- •تحتاج استدلالًا رائدًا يتجاوز أي نموذج مُقطّر → قارن مع GPT-6.1 Sol / Claude / Gemini عبر PromptQuorum
- •لا يمكنك تخصيص GPU → قد تكون واجهة استدلال مُستضافة أرخص من شراء العتاد
قرار سريع:
- →إن لم تكن متأكدًا، ابدأ بالنموذج 14B على بطاقة بسعة 16 GB.
- →شغّل عند درجة حرارة 0.6 ودون مُوجّه نظام، كما توصي DeepSeek.
- →للبرمجة، استخدم نموذج برمجة — لا نموذج استدلال مُقطّر.
الأسئلة الشائعة
هل ما زال DeepSeek-R1 هو النموذج الحالي لدى DeepSeek؟
لا. الجيل الحالي من DeepSeek هو DeepSeek-V4 (Flash وPro). وقد أُعلن أن الاسمين المستعارين في الواجهة البرمجية deepseek-reasoner (جيل R1) وdeepseek-chat (جيل V3) سيُوقفان نهائيًا بعد 24 يوليو 2026. أما نماذج R1 المُقطّرة بأوزان مفتوحة فهي إصدارات مستقلة، ولم تكن ضمن هذا الإعلان، وما زالت تعمل محليًا عبر Ollama.
هل يمكنني تشغيل النسخة الكاملة من DeepSeek-R1 بحجم 671B محليًا؟
لا. النسخة الكاملة من DeepSeek-R1 هي نموذج Mixture-of-Experts بحجم 671B معامل (نحو 37B نشطة لكل token) ويحتاج نحو 376–404 GB من VRAM عند Q4 — عتاد مراكز البيانات فقط. في المنزل تشغّل أحد نماذجه المُقطّرة (من 1.5B إلى 70B). توجد نسخة Unsloth بدقة 1.58-bit (نحو 131 GB) لكنها تعمل بنحو 0.3 token في الثانية، وهي طرافة لا إعداد قابل للاستخدام.
أيّ نموذج DeepSeek-R1 مُقطّر هو الأفضل عمومًا؟
لمعظم الناس، DeepSeek-R1-Distill-Qwen-14B على GPU بسعة 16 GB هو أفضل توازن بين جودة الاستدلال والسرعة وملاءمة VRAM. إن كان لديك بطاقة بسعة 24 GB، فالنموذج المُقطّر 32B أقوى ويتفوّق على OpenAI o1-mini في عدة معايير استدلال.
ما هو أفضل نموذج استدلال صغير من DeepSeek؟
DeepSeek-R1-0528-Qwen3-8B. وهو مُقطّر من النسخة المُحدّثة R1-0528 على أساس Qwen3 8B، كان يتصدّر نماذج 8B المفتوحة في AIME 2024 عند إصداره (معيار نشرته DeepSeek)، وسجّل نحو 10 نقاط أعلى من أساس Qwen3 8B. يناسب GPU بسعة 8 GB عند Q4_K_M.
هل يحل DeepSeek-V4 محل النماذج المقطّرة من R1 كأفضل نموذج استدلال محلي؟
لا. DeepSeek-V4 (Flash وPro) هو الجيل الحالي من DeepSeek ويصدر بأوزان مفتوحة بترخيص MIT، لكنه أكبر بكثير من أن يعمل على بطاقة رسوميات استهلاكية واحدة: يضم V4-Pro نحو 1.6T معامل (49B نشط)، ويضم V4-Flash الأصلي 284B (13B نشط)، لذا تحتاج الأوزان وحدها إلى نحو 140–800 جيجابايت حتى بدقة 4 بت. وللاستدلال المحلي على بطاقة واحدة تبقى نماذج R1 المُقطّرة في هذه الصفحة الخيار العملي؛ أما V4 فهو لعتاد متعدد وحدات GPU أو مراكز البيانات، أو لواجهة DeepSeek البرمجية المستضافة.
هل تظل مقارنة "يتفوّق على OpenAI o1-mini" ذات معنى؟
كمرجع قياسي ثابت، نعم — فالدرجات التي نشرتها DeepSeek لم تتغير. أما كمقارنة حالية فلا: تُظهر صفحة الإيقاف التدريجي لدى OpenAI أن o1-mini أُوقف في 27 أكتوبر 2025، ونماذج OpenAI الحالية هي عائلة GPT-6 (Astra وSol وLuna). اعتمد على درجات AIME 2024 وMATH-500 لكل نموذج مقطّر؛ وللحصول على مرجع حديث من OpenAI شغّل المُوجّه نفسه على GPT-6 Luna، وهي الفئة المُحسَّنة للتكلفة.
كم VRAM يحتاج كل نموذج مُقطّر؟
عند Ollama الافتراضي Q4_K_M: يحتاج 7B نحو 8 GB (ملف نحو 4.7 GB)، ويحتاج 14B نحو 16 GB (ملف نحو 9 GB)، ويحتاج 32B نحو 24 GB (ملف نحو 20 GB)، ويحتاج 70B بطاقة مزدوجة أو 48 GB (ملف نحو 43 GB). FP16 يبلغ نحو 4× حجم Q4_K_M؛ وQ8_0 يبلغ نحو 2×.
هل DeepSeek-R1 جيد في البرمجة؟
يصنّف هذا الدليل الاستدلال (الرياضيات والمنطق والمهام متعددة الخطوات) فقط. لتوليد الكود تختلف المقايضات — راجع مقارنتنا المخصصة على /ar/power-local-llm/deepseek-vs-qwen-coding-local-2026 بدلًا من اختيار نموذج استدلال مُقطّر لإنتاجية البرمجة.
ما الفرق بين DeepSeek-V3 وDeepSeek-R1؟
DeepSeek-V3 (ديسمبر 2024) نموذج محادثة مُضبَط للحوار؛ وDeepSeek-R1 (يناير 2025) نموذج استدلال يولّد سلسلة تفكير صريحة قبل الإجابة. وكلاهما اليوم من الجيل السابق: يجمع DeepSeek-V4 وضعي Thinking وNon-Thinking في عائلة نماذج واحدة. وللرياضيات والمنطق محليًا على بطاقة رسوميات استهلاكية استخدم نموذج R1 مُقطّرًا.
لماذا يدور نموذجي DeepSeek-R1 المُقطّر أو يُنتج كلامًا غير مفهوم؟
غالبًا ما تكون مشكلة إعداد. اضبط درجة الحرارة على 0.6 (نطاق 0.5–0.7 جيد) وأزِل أي مُوجّه نظام — ضع كل التعليمات في رسالة المستخدم. وتنصح توصيات الاستخدام التي نشرتها DeepSeek لـ R1 بهذا الإعداد لتجنّب التكرار اللانهائي والمخرجات غير المتماسكة.
كيف أُثبّت نموذج DeepSeek-R1 مُقطّرًا؟
ثبّت Ollama، ثم نفّذ أمرًا واحدًا لفئتك، مثل `ollama run deepseek-r1:14b`. تتبنّى جميع النماذج المُقطّرة Q4_K_M افتراضيًا. راجع قسم الإعداد أعلاه للحصول على قائمة الأوامر الكاملة.
هل للنموذج المُقطّر 8B ترخيص مختلف؟
نعم. يحمل DeepSeek-R1-Distill-Llama-8B ترخيص Llama 3 إضافةً إلى MIT، لأن أساسه هو Llama 3. أما النماذج المُقطّرة القائمة على Qwen (1.5B و7B و14B و32B) فترث ترخيص Qwen. تحقّق من الترخيص قبل الاستخدام التجاري.
هل أشتري RTX 4060 Ti 16GB أم RTX 4090 للاستدلال؟
إن سمحت ميزانيتك بـ RTX 4090 وأردت تشغيل النموذج المُقطّر 32B (الذي يتفوّق على o1-mini)، فاشترِ 4090. وإن أردت أفضل قيمة وكان النموذج 14B يغطّي احتياجاتك، فإن RTX 4060 Ti 16GB بنحو $420 هي الشراء الأذكى.
سجل التحديثات
- نُشر في 2026-06-19. المراجعة التالية مستحقة في 2026-12-19 (فئة فرشنس نصف سنوية).
- يغطّي نماذج DeepSeek-R1 المُقطّرة الرسمية الستة إضافةً إلى DeepSeek-R1-0528-Qwen3-8B. تم التحقق منه مقابل درجات AIME 2024 المنشورة وأرقام VRAM لـ Q4_K_M اعتبارًا من يونيو 2026.
- تحديث في 2026-10-19: بيان في البداية أن R1 لم يعد الجيل الحالي من DeepSeek (الجيل الحالي هو DeepSeek-V4)؛ تصحيح رقم العتاد الخاص بـ V4 (يضم V4-Pro نحو 1.6T معامل، فتبلغ أوزانه مئات الجيجابايت لا 48–80 جيجابايت)؛ الإشارة إلى أنه أُعلن إيقاف الاسمين المستعارين deepseek-chat وdeepseek-reasoner بعد 2026-07-24؛ وسم مقياس o1-mini بأنه تاريخي (أُوقف في 2025-10-27) واستبدال المراجع القديمة لـ OpenAI بعائلة GPT-6؛ تصحيح ملاحظة الوسم deepseek-r1:8b وأحجام ملفات Ollama (32B بحجم 20 GB، و70B بحجم 43 GB). موعد المراجعة التالية: 2027-04-19.