Was ist ein lokales Reasoning-Modell?
Ein Reasoning-Modell ist ein LLM, das darauf trainiert ist, vor seiner endgültigen Antwort eine explizite Gedankenkette (Chain-of-Thought) zu erzeugen, was es bei Mathe, Logik und mehrstufigen Problemen weit stärker macht als ein Standard-Chat-Modell gleicher Größe. DeepSeek-R1-Distills sind Reasoning-Modelle: Sie „denken laut" innerhalb der Antwort, prüfen und überarbeiten Schritte, bevor sie sich auf eine Antwort festlegen.
Der Kompromiss sind Latenz und Wortfülle. Ein Reasoning-Modell verbraucht zusätzliche Tokens, um das Problem durchzuarbeiten, sodass eine einzelne Antwort mehrere Sekunden und Hunderte Tokens sichtbares Reasoning dauern kann. Für einen mathematischen Beweis oder ein Logikrätsel ist genau das gewünscht; für eine schnelle Faktenabfrage ist es verschwendete Zeit.
Die Unterscheidung, über die Menschen stolpern: DeepSeek-V3 war ein Chat-Modell, DeepSeek-R1 das Reasoning-Modell. Sie teilen sich eine Architektur-Abstammung, waren aber für unterschiedliche Aufgaben abgestimmt, und beide gehören inzwischen zur Vorgängergeneration – DeepSeek-V4 bietet Thinking- und Non-Thinking-Modus in einer Modellfamilie. Für schrittweises Problemlösen auf eigener Hardware bleiben die R1-Distills der praktische Weg. Wir erklären genau, was die Distillation behält und verliert, in DeepSeek-R1 vs. die Distills.
Update: Die aktuelle Generation von DeepSeek ist DeepSeek-V4 (Flash und Pro), veröffentlicht als Open Weights unter MIT-Lizenz (Preview: 24. April 2026). Die DeepSeek-API liefert jetzt V4: Die Aliase deepseek-chat (V3-Generation) und deepseek-reasoner (R1-Generation) wurden als nach dem 24. Juli 2026 vollständig abgeschaltet angekündigt. Die R1-Distills sind eigenständige Open-Weight-Releases, waren nicht Teil dieser Ankündigung und laufen weiterhin lokal. V4 selbst ist kein Modell für Consumer-GPUs: V4-Pro hat 1,6T Parameter insgesamt (49B aktiv), das ursprüngliche V4-Flash 284B (13B aktiv). Selbst bei 4-Bit-Präzision (Parameterzahl × 0,5 Byte) benötigen allein die Gewichte grob 140 GB (Flash) bis 800 GB (Pro); die Modellkarten von DeepSeek nennen keine GPU-Anforderung. Für Reasoning auf einer einzelnen Consumer-GPU bleiben die Distills die praktische Wahl.
Für eine tiefergehende Einführung in den Betrieb dieser Modelle beginnen Sie mit dem Hardware-Leitfaden für lokale LLMs und LLM-Quantisierung erklärt, die die VRAM-Rechnung abdecken, auf die sich dieser Leitfaden stützt.
📍 In einem Satz
Ein lokales Reasoning-Modell ist ein LLM, das vor dem Antworten eine explizite Gedankenkette schreibt, was es bei Mathe und Logik stärker macht als ein Chat-Modell gleicher Größe.
💬 In einfachen Worten
Stellen Sie sich ein Reasoning-Modell wie einen Schüler vor, der seinen Rechenweg zeigt. Es ist langsamer und schreibt mehr, aber es löst mehrstufige Probleme weit häufiger korrekt als ein Modell, das eine Antwort einfach herausplatzt.
Die 6 DeepSeek-R1-Distills im Überblick
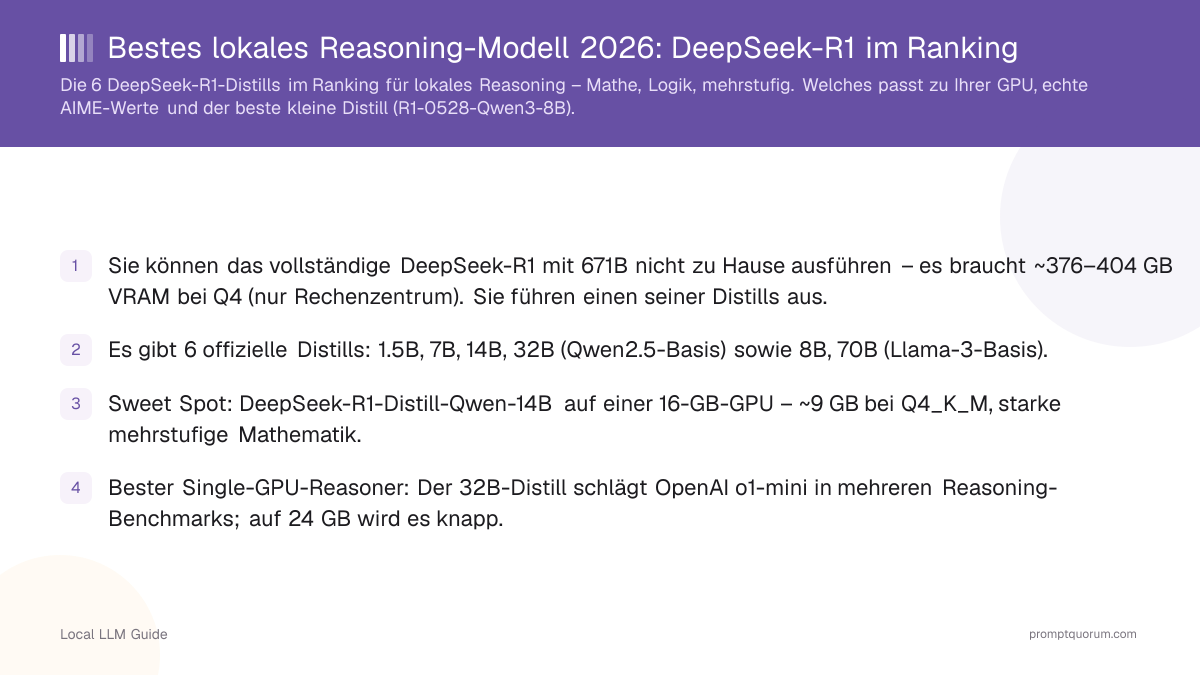
DeepSeek hat sechs offizielle Distills von R1 veröffentlicht, jeder durch Feinabstimmung eines bestehenden offenen Basismodells auf Reasoning-Spuren des vollständigen 671B-R1 erstellt. Vier nutzen eine Qwen2.5-Basis (1.5B, 7B, 14B, 32B) und zwei eine Llama-3-Basis (8B, 70B). Die VRAM-Angaben unten gelten für die Ollama-Standardquantisierung Q4_K_M.
📍 In einem Satz
DeepSeek-R1 hat sechs offizielle Distills von 1.5B bis 70B, aufbauend auf Qwen2.5- und Llama-3-Basen, wobei das 14B-Modell die beste Balance für eine 16-GB-GPU darstellt.
Distill | Basismodell | Dateigröße (Q4_K_M) | Min. VRAM | Am besten für |
|---|---|---|---|---|
| DeepSeek-R1-Distill-Qwen-1.5B | Qwen2.5 1.5B | ~1.1 GB | 4 GB / CPU | Edge-Geräte, schnelle Tests |
| DeepSeek-R1-Distill-Qwen-7B | Qwen2.5 7B | ~4.7 GB | 8 GB | Einstiegs-GPUs, 55.5% AIME 2024 |
| DeepSeek-R1-Distill-Llama-8B | Llama 3 8B | ~4.9 GB | 8 GB | Workflows mit Llama-Lizenz |
| DeepSeek-R1-Distill-Qwen-14B | Qwen2.5 14B | ~9 GB | 16 GB | Beste Gesamtbalance |
| DeepSeek-R1-Distill-Qwen-32B | Qwen2.5 32B | ~20 GB | 24 GB | Schlägt o1-mini, beste Single-GPU |
| DeepSeek-R1-Distill-Llama-70B | Llama 3 70B | ~43 GB | Dual-GPU / 48 GB | Stärkster Distill, max. Genauigkeit |
Der DeepSeek-R1-Distill-Llama-8B trägt sowohl die Llama-3-Lizenz als auch die MIT-Lizenz. Die Qwen-basierten Distills erben die Qwen-Lizenzierung. Prüfen Sie für die kommerzielle Nutzung immer die Lizenz. In Ollama ist der Tag `deepseek-r1:8b` DeepSeek-R1-0528-Qwen3-8B (5,2 GB); der Llama-8B-Distill ist `deepseek-r1:8b-llama-distill-q4_K_M` (4,9 GB).

Der beste kleine Reasoning-Distill: DeepSeek-R1-0528-Qwen3-8B
DeepSeek-R1-0528-Qwen3-8B gehört zu den stärksten kleinen Reasoning-Modellen, die Sie auf einer 8-GB-GPU ausführen können, distilliert vom aktualisierten R1-0528 auf eine Qwen3-8B-Basis. Laut DeepSeeks veröffentlichtem Benchmark lag es zum Release bei AIME 2024 unter den offenen 8B-Modellen vorn und erreichte in diesem Benchmark rund 10 Prozentpunkte mehr als das Basis-Qwen3-8B – ein bedeutsamer Sprung für Mathe und Logik in dieser Größe.
Wählen Sie es gegenüber den ursprünglichen 7B- und 8B-Distills, wenn Sie die beste Genauigkeit für ein kleines Modell wollen und Ihre Hardware bei 8 GB endet. Es passt in dieselbe RTX-3060-12GB-Stufe und läuft bei Q4_K_M in rund 5 GB. Für die meisten Laptop- und Einstiegs-GPU-Nutzer, denen Reasoning-Qualität wichtiger ist als reine Geschwindigkeit, ist dies das Modell für den Einstieg.
💬 In einfachen Worten
Wenn Ihre GPU 8 GB hat, gehört das neuere R1-0528-Qwen3-8B zu den stärksten kleinen Reasoning-Modellen – es nutzt eine bessere Basis als die ursprünglichen Distills und erreicht höhere Werte bei Wettbewerbsmathematik.
DeepSeek-R1-Distills nach Hardware-Stufe geordnet
Wählen Sie die höchste Stufe, die Ihr VRAM unterstützt. Mehr Parameter bedeuten besseres Reasoning, aber nur, wenn das Modell passt, ohne in den System-RAM auszulagern (was die Geschwindigkeit einbrechen lässt). Nutzen Sie dieses Ranking, um einen Distill an die GPU anzupassen, die Sie besitzen oder kaufen möchten.

8 GB VRAM → DeepSeek-R1-Distill-Qwen-7B (RTX 3060 12GB)
Der 7B-Distill ist der Einstiegspunkt für ernsthaftes lokales Reasoning. Bei Q4_K_M ist er ~4.7 GB groß und erreicht 55.5% bei AIME 2024 – ein von DeepSeek veröffentlichtes Ergebnis bei Mathematik auf Wettbewerbsniveau. Die NVIDIA RTX 3060 12GB (~$280) ist hier die Preis-Leistungs-Wahl: 12 GB lassen Spielraum für längere Reasoning-Kontexte. Befehl: `ollama run deepseek-r1:7b`. Wenn Sie die beste Genauigkeit für ein kleines Modell wollen, tauschen Sie auf derselben Karte DeepSeek-R1-0528-Qwen3-8B ein.
16 GB VRAM → DeepSeek-R1-Distill-Qwen-14B (RTX 4060 Ti 16GB)
Der 14B-Distill ist das beste lokale Reasoning-Modell insgesamt: starke mehrstufige Mathematik und Logik, ~9 GB bei Q4_K_M, mit Platz für Kontext auf einer 16-GB-Karte. Die NVIDIA RTX 4060 Ti 16GB (~$420) ist die empfohlene GPU – 16 GB fassen das Modell und ein großzügiges Reasoning-Fenster bei 165 W. Dies ist die Stufe, die die meisten Leser anvisieren sollten. Befehl: `ollama run deepseek-r1:14b`.
24 GB VRAM → DeepSeek-R1-Distill-Qwen-32B (RTX 4090)
Der 32B-Distill ist der stärkste der sechs Distills, der auf eine einzelne Consumer-GPU passt, und schlägt OpenAI o1-mini laut DeepSeeks veröffentlichten Ergebnissen in mehreren Reasoning-Benchmarks. Bei Q4_K_M ist er ~20 GB groß – knapp, aber machbar auf einer 24-GB-RTX-4090, was begrenzten Platz für Kontext lässt. Wenn Reasoning-Genauigkeit Ihre Priorität ist und Sie eine 24-GB-Karte haben, ist dies das Modell. Befehl: `ollama run deepseek-r1:32b`. Für längere Kontexte wechseln Sie auf eine kleinere Quantisierung oder das 14B.
Dual-GPU / 48 GB → DeepSeek-R1-Distill-Llama-70B
Der 70B-Distill ist der stärkste der sechs und liefert die höchste Reasoning-Genauigkeit, aber mit ~43 GB (Q4) passt er auf keine einzelne Consumer-Karte. Führen Sie ihn über zwei 24-GB-GPUs aus (z. B. 2× RTX 3090 oder 2× RTX 4090) oder auf einer 48-GB-Workstation-Karte. Erwarten Sie langsameren Durchsatz als beim 32B, aber die besten Antworten. Befehl: `ollama run deepseek-r1:70b`. Nur lohnenswert, wenn Sie wirklich die Spitzenstufe des offenen Reasonings benötigen.
Always-On-Server → Minisforum Mini-PC
Wenn Sie ein Reasoning-Modell rund um die Uhr ohne lauten Tower laufen lassen möchten, betreibt ein Minisforum Mini-PC mit integrierter GPU oder einem eGPU-Gehäuse die 7B- und 14B-Distills als leisen Always-On-Endpunkt. Er wird beim 32B nicht mit einer Desktop-RTX-4090 mithalten, aber für einen heimischen Reasoning-Server, der Mathe- und Logikanfragen auf Abruf beantwortet, sind die niedrige Leerlaufleistung und die Stille der Reiz. Kombinieren Sie ihn mit dem 7B- oder 14B-Distill.
Wie schneiden die DeepSeek-R1-Distills in Reasoning-Benchmarks ab?
Dies sind Reasoning-Benchmarks – AIME 2024 (Wettbewerbsmathematik), MATH-500 (gemischte Mathematik) und GPQA Diamond (Wissenschaftsfragen auf Hochschulniveau). Sie messen schrittweises Problemlösen, nicht Coding. Das zentrale Ergebnis: Der 32B-Distill schlägt OpenAI o1-mini in mehreren davon, und der 7B-Distill erreicht 55.5% bei AIME 2024, wie von DeepSeek veröffentlicht. Hinweis: OpenAI hat o1-mini Ende 2025 aus der API zurückgezogen, daher sind die o1-mini-Vergleiche hier der ursprünglich veröffentlichte Benchmark-Referenzpunkt für diese Distills, kein aktueller direkter Vergleich mit einem derzeit verfügbaren OpenAI-Modell. Für eine lokale Deployment-Entscheidung zählen die eigenen AIME-2024- und MATH-500-Werte der Distills oben.
📍 In einem Satz
Der DeepSeek-R1-Distill-Qwen-32B schlägt OpenAI o1-mini in mehreren Reasoning-Benchmarks, und der 7B-Distill erreicht 55.5% bei AIME 2024.
Distill | AIME 2024 | Reasoning-Stufe | Anmerkungen |
|---|---|---|---|
| DeepSeek-R1-Distill-Qwen-7B | 55.5% | Stark für 7B | Bester Einstiegs-GPU-Reasoner |
| DeepSeek-R1-0528-Qwen3-8B | Zum Release vorn bei offenen 8B | Bester kleiner | ~+10 Pkt. über Basis-Qwen3-8B |
| DeepSeek-R1-Distill-Qwen-14B | Höher als 7B | Beste Balance | 16-GB-Sweet-Spot |
| DeepSeek-R1-Distill-Qwen-32B | Top Single-GPU | Schlägt o1-mini | Bester 24-GB-Reasoner |
| DeepSeek-R1-Distill-Llama-70B | Höchster der sechs | Maximum | Braucht Dual-GPU |
Verwenden Sie exakte Werte, wo veröffentlicht (7B = 55.5% AIME 2024), und relative Rankings andernorts. Benchmark-Zahlen verschieben sich mit Quantisierung und Sampling-Einstellungen; behandeln Sie sie als richtungsweisend innerhalb einer Stufe, nicht als absolut.
Wann sollten Sie KEIN Reasoning-Modell nutzen?
Vermeiden Sie ein Reasoning-Modell, wenn die Aufgabe keine Reasoning-Aufgabe ist – sie sind langsamer, wortreicher und bei einfacher Abfrage oder Chat nicht genauer. Nutzen Sie stattdessen ein Standard-Chat-Modell wie Llama 3.3.
- Vermeiden Sie es bei schnellen Faktenabfragen – die sichtbare Gedankenkette verschwendet Tokens und Zeit bei Antworten, die ein Chat-Modell sofort liefert.
- Vermeiden Sie es bei offener Konversation – Reasoning-Modelle sind auf Probleme mit einer korrekten Antwort abgestimmt, nicht auf Dialog.
- Vermeiden Sie es für reinen Coding-Durchsatz – für Codegenerierung gehen Sie zum DeepSeek-vs-Qwen-Coding-Leitfaden; diese Seite behandelt ausschließlich Reasoning.
- Vermeiden Sie es, wenn Latenz entscheidend ist – wenn Sie Antworten unter einer Sekunde brauchen, gewinnt ein kleineres Chat-Modell.
- Nutzen Sie ein Reasoning-Modell, wenn die Aufgabe Mathe, Logik, mehrstufige Planung oder alles ist, bei dem das Zeigen des Rechenwegs die Korrektheit verbessert.
Konfigurations-Profitipp: Temperatur 0.6 und kein System-Prompt
Setzen Sie die Temperatur auf 0.6 (der Bereich 0.5–0.7 ist sicher) und verwenden Sie keinen System-Prompt – packen Sie jede Anweisung in den User-Prompt. Das entspricht den veröffentlichten Nutzungsempfehlungen von DeepSeek für die R1-Reihe, die eine Temperatur von 0.5–0.7 und keinen System-Prompt empfehlen, um endlose Wiederholungen und inkohärente Ausgaben zu vermeiden.
In der Praxis: Lassen Sie das System-Prompt-Feld in Ollama/LM Studio leer, stellen Sie Ihre Anweisungen der User-Nachricht voran und halten Sie die Temperatur bei 0.6. Wenn Sie sehen, dass das Modell in eine Schleife gerät oder mitten im Reasoning abdriftet, löst diese Einstellung das Problem häufig.
Einrichtung: Ollama-Schnellstart pro Stufe
Jeder Distill installiert und läuft mit einem einzigen Ollama-Befehl (alle standardmäßig Q4_K_M). Installieren Sie zuerst Ollama, falls noch nicht geschehen – siehe So installieren Sie Ollama. Wählen Sie dann den Befehl für Ihre Stufe:
ollama run deepseek-r1:1.5b   # edge / CPU
ollama run deepseek-r1:7b     # 8 GB VRAM
ollama run deepseek-r1:8b     # 8 GB VRAM (R1-0528-Qwen3-8B)
ollama run deepseek-r1:14b    # 16 GB VRAM — recommended
ollama run deepseek-r1:32b    # 24 GB VRAM — beats o1-mini
ollama run deepseek-r1:70b    # dual-GPU / 48 GB
Fazit: Welchen DeepSeek-R1-Distill sollten Sie ausführen?
Die Entscheidung hängt von Ihrem VRAM ab und davon, ob Sie Genauigkeit oder Geschwindigkeit priorisieren. Hier ist die einzeilige Antwort für jeden Fall.
Wählen Sie Ihren Distill
Lokales LLM nutzen, wenn:
- •16-GB-GPU → DeepSeek-R1-Distill-Qwen-14B (insgesamt am besten, die Standardwahl)
- •24-GB-GPU → DeepSeek-R1-Distill-Qwen-32B (schlägt o1-mini, bester Single-GPU-Reasoner)
- •8-GB-GPU → DeepSeek-R1-0528-Qwen3-8B (bester kleiner) oder der 7B-Distill
- •Dual-GPU / 48 GB → DeepSeek-R1-Distill-Llama-70B (maximale Genauigkeit)
Cloud-Modell nutzen, wenn:
- •Sie benötigen Spitzen-Reasoning jenseits jedes Distills → vergleichen Sie über PromptQuorum gegen GPT-6.1 Sol / Claude / Gemini
- •Sie können keine GPU bereitstellen → eine gehostete Reasoning-API kann günstiger sein als Hardware zu kaufen
Schnelle Entscheidung:
- →Wenn Sie unsicher sind, beginnen Sie mit dem 14B auf einer 16-GB-Karte.
- →Führen Sie es bei Temperatur 0.6 ohne System-Prompt aus, wie von DeepSeek empfohlen.
- →Für Coding nutzen Sie ein Coding-Modell – keinen Reasoning-Distill.
Häufig gestellte Fragen
Ist DeepSeek-R1 noch das aktuelle Modell von DeepSeek?
Nein. Die aktuelle Generation von DeepSeek ist DeepSeek-V4 (Flash und Pro). Die API-Aliase deepseek-reasoner (R1-Generation) und deepseek-chat (V3-Generation) wurden als nach dem 24. Juli 2026 vollständig abgeschaltet angekündigt. Die Open-Weight-R1-Distills sind eigenständige Releases, waren nicht Teil dieser Ankündigung und laufen weiterhin lokal mit Ollama.
Kann ich das vollständige DeepSeek-R1 mit 671B lokal ausführen?
Nein. Das vollständige DeepSeek-R1 ist ein Mixture-of-Experts-Modell mit 671B Parametern (~37B aktiv pro Token) und braucht bei Q4 rund 376–404 GB VRAM – nur Rechenzentrums-Hardware. Zu Hause führen Sie einen seiner Distills aus (1.5B bis 70B). Ein Unsloth-1.58-Bit-Build (~131 GB) existiert, läuft aber mit rund 0.3 Tokens/Sekunde, was eher eine Kuriosität als ein nutzbares Setup ist.
Welcher DeepSeek-R1-Distill ist insgesamt am besten?
Für die meisten Menschen ist DeepSeek-R1-Distill-Qwen-14B auf einer 16-GB-GPU die beste Balance aus Reasoning-Qualität, Geschwindigkeit und VRAM-Passung. Wenn Sie eine 24-GB-Karte haben, ist der 32B-Distill stärker und schlägt OpenAI o1-mini in mehreren Reasoning-Benchmarks.
Was ist das beste kleine DeepSeek-Reasoning-Modell?
DeepSeek-R1-0528-Qwen3-8B. Es ist vom aktualisierten R1-0528 auf eine Qwen3-8B-Basis distilliert, lag laut DeepSeeks veröffentlichtem Benchmark zum Release bei AIME 2024 unter den offenen 8B-Modellen vorn und erreichte etwa 10 Punkte mehr als das Basis-Qwen3-8B. Es passt bei Q4_K_M auf eine 8-GB-GPU.
Ersetzt DeepSeek-V4 die R1-Distills als bestes lokales Reasoning-Modell?
Nein. DeepSeek-V4 (Flash und Pro) ist die aktuelle Generation von DeepSeek und erscheint als Open Weights unter MIT-Lizenz, ist aber für eine einzelne Consumer-GPU viel zu groß: V4-Pro hat 1,6T Parameter (49B aktiv), das ursprüngliche V4-Flash 284B (13B aktiv); allein die Gewichte benötigen selbst bei 4-Bit-Präzision grob 140–800 GB. Für lokales Reasoning auf einer Karte bleiben die R1-Distills auf dieser Seite die praktische Wahl; V4 ist für Multi-GPU- oder Rechenzentrums-Hardware oder für die gehostete DeepSeek-API gedacht.
Ist der Vergleich „schlägt OpenAI o1-mini" noch aussagekräftig?
Als fester Benchmark-Referenzwert ja – die von DeepSeek veröffentlichten Werte sind unverändert. Als aktueller Vergleich nein: Laut Deprecation-Seite von OpenAI wurde o1-mini am 27. Oktober 2025 abgeschaltet, und OpenAIs aktuelle Modelle sind die GPT-6-Familie (Astra, Sol und Luna). Verlassen Sie sich auf die AIME-2024- und MATH-500-Werte der einzelnen Distills; als aktuelle OpenAI-Referenz lassen Sie denselben Prompt auf GPT-6 Luna laufen, der kostenoptimierten Stufe.
Wie viel VRAM braucht jeder Distill?
Beim Ollama-Standard Q4_K_M: 7B braucht ~8 GB (Datei ~4.7 GB), 14B braucht ~16 GB (~9 GB Datei), 32B braucht ~24 GB (~20 GB Datei) und 70B braucht Dual-GPU oder 48 GB (~43 GB Datei). FP16 ist rund 4× so groß wie Q4_K_M; Q8_0 ist rund 2×.
Ist DeepSeek-R1 gut im Coding?
Dieser Leitfaden bewertet ausschließlich Reasoning (Mathe, Logik, mehrstufig). Für Codegenerierung sind die Kompromisse anders – siehe unseren dedizierten Vergleich unter /de/power-local-llm/deepseek-vs-qwen-coding-local-2026, statt einen Reasoning-Distill für Coding-Durchsatz zu wählen.
Was ist der Unterschied zwischen DeepSeek-V3 und DeepSeek-R1?
DeepSeek-V3 (Dezember 2024) ist ein auf Konversation abgestimmtes Chat-Modell; DeepSeek-R1 (Januar 2025) ist ein Reasoning-Modell, das vor der Antwort eine explizite Gedankenkette erzeugt. Beide gehören inzwischen zur Vorgängergeneration: DeepSeek-V4 vereint Thinking- und Non-Thinking-Modus in einer Modellfamilie. Für lokale Mathematik- und Logikaufgaben auf einer Consumer-GPU nutzen Sie einen R1-Distill.
Warum gerät mein DeepSeek-R1-Distill in eine Schleife oder produziert Kauderwelsch?
Häufig ein Konfigurationsproblem. Setzen Sie die Temperatur auf 0.6 (0.5–0.7 ist in Ordnung) und entfernen Sie jeden System-Prompt – packen Sie alle Anweisungen in die User-Nachricht. DeepSeeks Nutzungsempfehlungen für R1 raten zu dieser Konfiguration, um endlose Wiederholungen und inkohärente Ausgaben zu vermeiden.
Wie installiere ich einen DeepSeek-R1-Distill?
Installieren Sie Ollama und führen Sie dann einen Befehl für Ihre Stufe aus, z. B. `ollama run deepseek-r1:14b`. Alle Distills sind standardmäßig Q4_K_M. Die vollständige Befehlsliste finden Sie im Einrichtungsabschnitt oben.
Hat der 8B-Distill eine andere Lizenz?
Ja. DeepSeek-R1-Distill-Llama-8B trägt zusätzlich zu MIT die Llama-3-Lizenz, weil seine Basis Llama 3 ist. Die Qwen-basierten Distills (1.5B, 7B, 14B, 32B) erben die Qwen-Lizenzierung. Prüfen Sie die Lizenz vor der kommerziellen Nutzung.
Sollte ich für Reasoning eine RTX 4060 Ti 16GB oder eine RTX 4090 kaufen?
Wenn Ihr Budget die RTX 4090 zulässt und Sie den 32B-Distill ausführen möchten (der o1-mini schlägt), kaufen Sie die 4090. Wenn Sie das beste Preis-Leistungs-Verhältnis wollen und der 14B-Distill Ihren Bedarf deckt, ist die RTX 4060 Ti 16GB für ~$420 der klügere Kauf.
Update-Log
- Veröffentlicht am 2026-06-19. Nächste Überprüfung fällig am 2026-12-19 (halbjährliche Freshness-Stufe).
- Deckt die 6 offiziellen DeepSeek-R1-Distills plus DeepSeek-R1-0528-Qwen3-8B ab. Verifiziert gegen veröffentlichte AIME-2024-Werte und Q4_K_M-VRAM-Angaben mit Stand Juni 2026.
- Aktualisiert am 2026-10-19: vorangestellt, dass R1 nicht mehr die aktuelle Generation von DeepSeek ist (das ist DeepSeek-V4); V4-Hardwareangabe korrigiert (V4-Pro hat 1,6T Parameter, die Gewichte umfassen daher Hunderte GB, nicht 48–80 GB); vermerkt, dass die API-Aliase deepseek-chat und deepseek-reasoner als nach dem 2026-07-24 abgeschaltet angekündigt wurden; den o1-mini-Maßstab als historisch gekennzeichnet (abgeschaltet am 2025-10-27) und veraltete OpenAI-Verweise durch die GPT-6-Familie ersetzt; Hinweis zum Tag deepseek-r1:8b und Ollama-Dateigrößen korrigiert (32B 20 GB, 70B 43 GB). Nächste Überprüfung fällig am 2027-04-19.