Wichtigste Erkenntnisse
- 7B-Q4-Faustregel: Ein 7B-Modell bei Q4_K_M-Quantisierung braucht etwa 4-5 GB VRAM (oder Arbeitsspeicher bei CPU-Inferenz) -- rund 0,6 GB pro Milliarde Parameter bei 4-Bit. Das ist der schnellste Weg, den Speicherbedarf fuer jedes 7B-Modell abzuschaetzen, ohne die vollstaendige VRAM-Rechnung weiter unten durchzufuehren.
- VRAM-Berechnung: (Modellgroesse in GB) ÷ Quantisierung = benoetigter VRAM. Beispiel: 70B bei Q4 = 70 ÷ 8 = 8,75 GB × Parameter ≈ 39 GB insgesamt.
- 12 GB VRAM (RTX 4070 Ti): Bestes Modell: Llama 3.1 8B Q8 (~9 GB, 80 tok/sec). Auch: Qwen3 8B (~8 GB, bestes mehrsprachig + Coding). Hinweis: Llama 4 Scout (17B aktiv / 109B gesamt MoE) braucht ~55 GB bei Q4 und passt NICHT in 12 GB.
- 16 GB VRAM (RTX 5080 / RTX 5070 Ti): Bestes Modell: Mistral Small 3.1 24B Q4_K_M (~13 GB, 55 tok/sec). Auch: Devstral Small 24B Q4_K_M fuer agentisches Coding. Mistral Small 4 (Maerz 2026) ist der neuere Ein-Modell-Nachfolger, der Reasoning, Vision und Coding vereint.
- 24 GB VRAM (RTX 4090 / RTX 5090): Die meisten 70B-Modelle bei Q4_K_M (~40 GB) passen NICHT. Beste Option: Qwen3.6 27B Q4_K_M (~16 GB, 77,2 % SWE-bench, bester dichter Coder) oder DeepSeek-R1 32B Q4_K_M (~19 GB, 60 tok/sec).
- CPU-only (16 GB Arbeitsspeicher): Llama 3.2 3B Q8 (20 tok/sec) oder Phi-4 Mini Q4_K_M (25 tok/sec). Eine gebrauchte RTX 4060 8 GB (~$280) oder neue RTX 5060 Ti 16 GB (~$585) ist 5-10x schneller.
- MacBook mit 8 GB RAM: nur 3-4B-Modelle ausfuehren — Phi-4 Mini, Llama 3.2 3B oder Gemma 3 4B bei Q4_K_M ueber llama.cpp/Ollama (Metal). 7B ist auf 8 GB grenzwertig; 16 GB ist das komfortable Mac-Minimum.
- Apple M5 Max (128 GB unified): betreibt 70B-Modelle bei Q4_K_M bequem (~12-15 tok/sec) in einem Laptop oder Mac Studio — neben Mac Studio und 128-GB-AMD-Strix-Halo-Systemen, die ebenfalls ein 70B-Modell fassen. Keines davon fasst GLM-5.3 (braucht ~239 GB selbst bei 2-Bit).
- Aktuelle Preise: Die GDDR7-Knappheit hat sich verschaerft statt entspannt -- der RTX-5090-Strassenpreis ist auf $4.300-$5.000+ gestiegen, und die RTX 4090 bleibt eingestellt. Budgetbewusste Kaeufer sollten auch AMDs RX 9070 XT pruefen (16 GB GDDR6, ~$690–740) -- GDDR6 ist der Knappheit weitgehend entgangen, wodurch sie bei aehnlichem VRAM deutlich guenstiger ist als die RTX 5070 Ti. Kaufe aus lieferbaren Angeboten; pruefe vor dem Kauf die Live-Preise.
- llama.cpp-Geschwindigkeitstipp: Setze immer `--n-gpu-layers 99`. Allein das verdoppelt die Geschwindigkeit auf der RTX 4070 Ti von ~40 auf ~85 tok/sec.
- Kurzreferenz: 7B@Q4_K_M = 4-5 GB | 70B@Q4_K_M = 40 GB | GLM-5.3@2-Bit = ~239 GB | RTX 4070 Ti = ~80 tok/s | RTX 4090 = ~150 tok/s | CPU-only 16 GB = 12-28 tok/s
📍 In einem Satz
Die Hardware für lokale LLMs wird durch VRAM bestimmt: 7B-Modelle benötigen 8 GB, 13–14B benötigen 12–16 GB, und 70B-Modelle benötigen 35–48 GB — eine gebrauchte RTX 4060 8 GB (~250 $) ist die beste Einsteiger-GPU 2026.
💬 In einfachen Worten
VRAM ist der dedizierte Speicher auf deiner Grafikkarte. Je größer das KI-Modell, desto mehr VRAM wird benötigt. Faustregel: Teile die Modellgröße in Gigabyte durch den Komprimierungsgrad (Q4 = durch 8 teilen), um den VRAM-Bedarf abzuschätzen.
Lokale LLM Hardware-Anforderungen 2026
Die Mindesthardware, um 2026 ein lokales LLM zu betreiben, ist eine GPU mit 8 GB VRAM — oder ein Apple-Silicon-Mac mit 16 GB Unified Memory — fuer Modelle der 7B-Klasse. Die Anforderungen skalieren dann mit der Modellgroesse: 14B braucht 12 GB, 24B braucht 16 GB, 32B braucht 24 GB und ein 70B-Modell braucht ~40 GB bei Q4_K_M. Der GPU-VRAM ist die harte Grenze: Er entscheidet, welche Modelle ueberhaupt laden. CPU und Arbeitsspeicher beeinflussen Ladezeit und CPU-only-Ausweichgeschwindigkeit, aber nicht, welches Modell auf die GPU passt.
Nutze diese Tabelle als direkte Antwort auf "Welche Hardware brauche ich" — finde deine Modellgroesse oder VRAM-Stufe und springe dann zu den Modellempfehlungen pro Stufe weiter unten.
Modellgroesse | VRAM bei Q4_K_M | GPU-Beispiel (2026) | Bestes Modell | Geschwindigkeit |
|---|---|---|---|---|
| 3-4B | 4-5 GB | Beliebige 8 GB / Mac 8 GB | Phi-4 Mini, Gemma 3 4B | 60-90 tok/s |
| 7-8B | 5-9 GB | RTX 5060 Ti, RTX 4060 (8 GB) | Llama 3.1 8B, Qwen3 8B | 50-80 tok/s |
| 14B | ~9 GB | RTX 5070 (12 GB) | Qwen3 14B | ~80 tok/s |
| 24B | ~14 GB | RTX 5070 Ti / 5080 (16 GB) | Mistral Small 3.1 24B | ~55 tok/s |
| 27-32B | 16-19 GB | RTX 4090 / 5090 (24-32 GB) | Qwen3.6 27B, DeepSeek-R1 32B | 55-60 tok/s |
| 70B | ~40 GB | Dual RTX 5090, A100, Mac M5 Max 128 GB | Llama 3.3 70B | 10-60 tok/s |
•KeyPoint: In einem Satz: Stimme das Modell auf deinen VRAM ab — 8 GB betreibt 7B, 12 GB betreibt 14B, 16 GB betreibt 24B, 24 GB betreibt 32B und nur 40 GB+ betreibt ein 70B-Modell in brauchbarer Q4_K_M-Qualitaet.
•ProTip: Plane Reserve fuer den KV-Cache (Gespraechskontext) ein: rechne 25 % zusaetzlich zu den Modellgewichten fuer 8K-Kontext und bis zu 100 % fuer 32K. Siehe den KV-Cache-Abschnitt weiter unten.
Beste GPUs zum Kauf — Empfehlungen 2026
Die lieferbare Wahl fuer lokale LLMs ist die NVIDIA RTX-50-Serie (Blackwell): 5060 Ti, 5070, 5070 Ti, 5080, 5090. Die RTX-40-Serie (4060, 4070 Ti, 4090) ist eingestellt und wird nun knapp und ueber ihren alten Preisen auf dem Gebrauchtmarkt verkauft. Eine GDDR7-/Speicherknappheit 2026 hat sich bis Juli weiter verschaerft und selbst die 50-Serie-Karten noch staerker ueber die UVP getrieben, behandle daher jede Zahl unten als typischen Strassenpreis und pruefe Live-Angebote vor dem Kauf. Empfehlungen nach Anwendungsfall:
- Fuer 7B-Modelle (Mistral, Phi-4, Llama 3.1) — Budget: RTX 5060 Ti 16 GB (~$585, rund 40 % über der UVP von 429 $) oder eine gebrauchte RTX 4060 8 GB (~$280). Betreibt jedes 7B-Modell bei Q4_K_M (~4-5 GB). Geschwindigkeit: 50–70 tok/sec. Stufe: Budget-Enthusiasten.
- Fuer 14B-Modelle (Qwen3 14B, DeepSeek-R1) — Mainstream: RTX 5070 (12 GB, ~$880). Beste Preis-Leistung als Neukarte. Qwen3 14B Q4_K_M laeuft gut mit Reserve. Geschwindigkeit: 85–110 tok/sec. Stufe: Am beliebtesten.
- Fuer 24-32B-Modelle (Qwen3.6, Mistral Small) — Mittelklasse: RTX 5070 Ti (16 GB, ~$979) oder RTX 5080 (16 GB, ~$1.249). Betreibt Mistral Small 3.1 24B und Devstral Small 24B Q4_K_M. Geschwindigkeit: 110–150 tok/sec. Stufe: Professionelle Entwickler. Budget-Alternative: AMD RX 9070 XT (16 GB GDDR6, ~$690–740) — GDDR6 ist der Knappheit weitgehend entgangen, wodurch sie die RTX 5070 Ti bei aehnlichem VRAM um $150–250 unterbietet, auch wenn ROCm eine schmalere lokale-LLM-Tooling-Unterstuetzung als CUDA bietet.
- Fuer 70B-Modelle (Llama 3.3) — High-End: RTX 5090 (32 GB, ~$2.000 UVP, aber ~$4.300–5.000+ Strasse und weiter steigend) fasst 70B bei Q4_K_M mit leichtem CPU-Offload. Eine gebrauchte RTX 4090 (24 GB, ~$2.300) betreibt 70B nur bei Q2_K. Fuer volles Q4_K_M nutze Dual RTX 5090. Geschwindigkeit: ~200 tok/sec (5090, kleinere Modelle). Stufe: Forschung + Produktion.
- Fuer GLM-5.3 (744B MoE, 40B aktiv) — Extrem: keine einzelne Consumer-GPU reicht aus. Die 2-Bit-dynamische GGUF braucht weiterhin ~239 GB kombinierten VRAM/RAM. Realistische lokale Wege: ein 4×-RTX-3090/4090-Rig mit 192 GB+ Arbeitsspeicher oder ein Mac Studio mit 512 GB (M5 Ultra), beide bei rund 3–9 tok/sec via CPU/GPU-Hybrid-Offload.
- Bestes Preis-Leistungs-Verhaeltnis 2026: eine einzelne RTX 5070 Ti oder 5080 (16 GB) ist der Sweetspot — sie betreibt alles bis 32B bei Q4_K_M ohne die 50-Serie-Preisuebertreibung der 5090.
- Fuer Apple-Nutzer: Mac M5 Max (128 GB Unified Memory, ~$6.000) betreibt 70B bei Q4_K_M mit ~12-15 tok/sec — langsamer als ein Multi-GPU-Desktop, aber leise, energieeffizient und mobil.
GPU | Best For | Price | Speed | Tier |
|---|---|---|---|---|
| RTX 5060 Ti (16 GB) | 7-13B-Modelle | ~$585 | 50–70 tok/s | Budget |
| RTX 5070 (12 GB) | 14B-Modelle | ~$880 | 85–110 tok/s | Mainstream |
| RX 9070 XT (16 GB) | 24-32B-Modelle | ~$690–740 | 90–130 tok/s | Budget-Alternative |
| RTX 5070 Ti / 5080 (16 GB) | 24-32B-Modelle | ~$979–1.249 | 110–150 tok/s | Professional |
| RTX 4090 (24 GB, gebraucht) | 32B, 70B (Q2) | ~$2.300 | 150–180 tok/s | EOL / gebraucht |
| RTX 5090 (32 GB) | 70B (Q4, leichter Offload) | ~$2.000 UVP (~$4.300–5.000+ Strasse) | ~200 tok/s | High-End |
| Dual RTX 5090 | 70B (Q4) voll | ~$8.600–10.000 | 300+ tok/s | Enterprise |
| Mac M5 Max 128GB | 70B (Q4) | ~$6.000 | ~12–15 tok/s (70B) | Pro-Laptop |
| 4× RTX 3090/4090 + 192GB RAM | GLM-5.3 (2-Bit) | ~$6.000–9.000 | 3–9 tok/s | Extreme MoE |
⚠️Warnung: Die Preisgestaltung ist volatil und verschaerft sich weiter. Die GDDR7-Knappheit hat die RTX 5090 auf $4.300–$5.000+ Strassenpreis getrieben — mehr als das Doppelte ihrer UVP von $1.999 — und die eingestellte RTX 4090 kostet gebraucht nun mehr als neu. Die obigen Preise sind typische Strassenwerte — pruefe vor dem Kauf stets die aktuellen Angebote. AMDs GDDR6-basierte RX 9070 XT ist eine bemerkenswerte Ausnahme: Sie ist dem Preisanstieg weitgehend entgangen.
Wie berechnest du die VRAM-Anforderungen?
Die VRAM-Anforderungen haengen von drei Faktoren ab: Modellgroesse (Parameter), Quantisierung (Bits pro Gewicht) und Inferenzmodus. Nutze diese Formel, um festzustellen, ob deine GPU genug Speicher hat. Fuer einen interaktiven Rechner siehe den VRAM-Rechner fuer lokale LLMs.
Formel:
```text VRAM (GB) = (Modellgroesse × Quantisierungsbits) ÷ 8 ```
Quantisierungswerte: FP16 = 16 Bit, Q8_0 = 8 Bit, Q5_K_M = 5 Bit, Q4_K_M = 4 Bit. Der praktische Sweetspot ist Q4_K_M -- es nutzt 4-Bit-Gewichte mit K-Quantisierung, die NVIDIA-GPUs effizienter beschleunigen als das aeltere Q4_0-Format.
Modell | FP16 | Q8_0 | Q5_K_M | Q4_K_M |
|---|---|---|---|---|
| Llama 4 Scout (109B gesamt MoE) | ~218 GB | ~109 GB | ~68 GB | ~55 GB |
| Llama 3.1 8B | 16 GB | 8.5 GB | 5.7 GB | 4.7 GB |
| Qwen 3.6 27B | ~54 GB | ~28 GB | ~19 GB | ~16 GB |
| Qwen3 8B | ~16 GB | ~8.5 GB | ~5.7 GB | ~5 GB |
| Llama 3.3 70B | 140 GB | 70 GB | 48 GB | 40 GB |
| Qwen3 32B | 64 GB | 33 GB | 22 GB | 19 GB |
| Mistral Small 3.1 24B | 48 GB | 25 GB | 17 GB | 14 GB |
| Phi-4 Mini 3.8B | 7.6 GB | 4.1 GB | 2.7 GB | 2.3 GB |
Q4_K_M ist der empfohlene Standard fuer Consumer-Hardware -- 90-95 % der FP16-Qualitaet bei 25-30 % der VRAM-Kosten. Llama 4 Scout nutzt eine MoE-Architektur mit 17B aktiven Parametern von 109B gesamt. Alle 109B Experten muessen in den Speicher geladen werden, daher braucht Scout ~55 GB bei Q4 (passt in 24 GB nur bei 1,78-Bit). MoE reduziert die Rechenlast pro Token, nicht den VRAM-Bedarf.

•KeyPoint: In einem Satz: VRAM ist der dedizierte Speicherpool der GPU -- die eine Zahl, die bestimmt, welche KI-Modelle du lokal und in welcher Qualitaet ausfuehren kannst.
KV-Cache: Die versteckten VRAM-Kosten
Die VRAM-Formel (Modellgroesse × Bits ÷ 8) deckt nur die Modellgewichte ab -- der KV-Cache fuegt erheblichen zusaetzlichen VRAM hinzu, den die meisten Leitfaeden ignorieren.
Der KV-Cache speichert den Attention-Zustand fuer jedes Token in deinem Kontextfenster. Er waechst linear mit der Kontextlaenge und bleibt waehrend der gesamten Sitzung im VRAM.
KV-Cache-VRAM-Formel: `KV-Cache ≈ Layer × Heads × head_dim × 2 × Kontextlaenge × 2 Byte`
Diese Werte gehen von fp16 (2 Byte pro Element) fuer die K- und V-Tensoren aus. Ein quantisierter KV-Cache (z. B. `--cache-type-k q8_0` in llama.cpp) benoetigt etwa die Haelfte des in der Tabelle gezeigten VRAM.
Modell | 4K Kontext | 32K Kontext | 128K Kontext |
|---|---|---|---|
| Llama 3.1 8B | 0.5 GB | 4 GB | 16 GB |
| Llama 3.3 70B | 1.25 GB | 10 GB | 40 GB |
| Qwen3 32B | 1 GB | 8 GB | 32 GB |
•KeyPoint: In einem Satz: Der KV-Cache ist temporaerer VRAM zum Speichern des Gespraechskontexts -- er waechst mit jedem generierten Token und ist getrennt von der Speicherung der Modellgewichte.
⚠️Warnung: Ein Llama 3.1 8B bei Q4_K_M braucht 4,7 GB fuer die Gewichte -- aber fuege ein 32K-Kontextfenster hinzu und der gesamte VRAM steigt auf ~8,7 GB. Auf einer 8-GB-Karte verursacht das OOM-Fehler.
•KeyPoint: Faustregel: Dieser Prozentsatz sinkt, je groesser das Modell wird -- der KV-Cache skaliert mit der Anzahl der Layer, waehrend die Groesse der Modellgewichte mit der Gesamtzahl der Parameter skaliert, und Layer wachsen bei groesseren Modellen langsamer als Parameter. Llama 3.1 8B (32 Layer): Ein 32K-Kontext-Cache betraegt ~4 GB gegenueber ~4,7 GB Q4_K_M-Gewichten (~85 %). Llama 3.3 70B (80 Layer): Ein 32K-Kontext-Cache betraegt ~10 GB gegenueber ~40 GB Q4_K_M-Gewichten (~25 %). Der Ollama-Standardkontext betraegt 2.048 Token. Fuer hoehere Werte: PARAMETER num_ctx 32768 in deinem Modelfile.
Welche GPU-Stufe passt zu deiner Workload?
Liefern NVIDIA-GPUs ueber alle Preisklassen hinweg die hoechsten Token/sec fuer lokale LLM-Inferenz. Die Abschnitte unter jeder Stufe geben konkrete Modellempfehlungen. Fuer einen detaillierten Benchmark-Vergleich siehe den Leitfaden zu den besten GPUs fuer lokale LLMs.
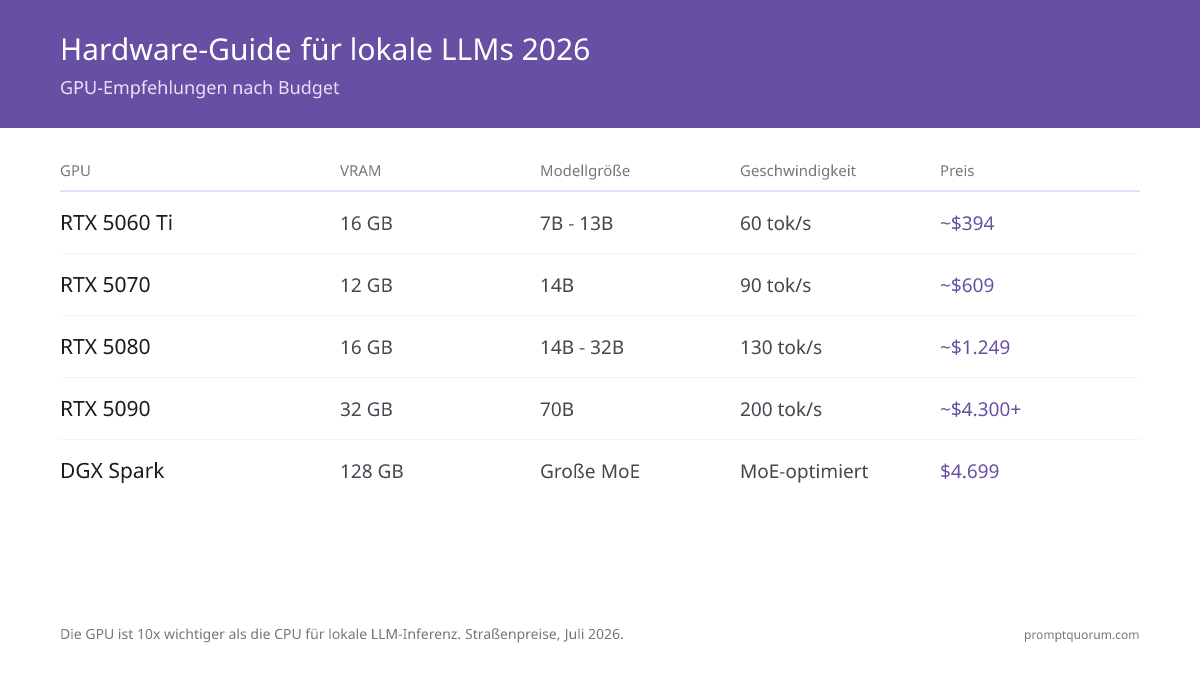
Stufe | GPU | VRAM | Best For | Geschwindigkeit |
|---|---|---|---|---|
| Budget (~$585) | RTX 5060 Ti | 16 GB | 7-13B-Modelle | ~60 tok/s |
| Mainstream (~$880) | RTX 5070 | 12 GB | 7-14B-Modelle | ~90 tok/s |
| Mittel (~$979) | RTX 5070 Ti | 16 GB | 14-32B-Modelle | ~110 tok/s |
| Hoch (~$1.249) | RTX 5080 | 16 GB | 14-32B-Modelle | ~130 tok/s |
| Top (~$4.300–5.000+ Strasse) | RTX 5090 | 32 GB | 70B (Q4, leichter Offload) | ~200 tok/s |
| Server ($7.000+) | RTX 6000 Ada / A100 | 48-80 GB | Multi-User, 70B+ | Produktion |
| Desktop-KI ($4.699) | NVIDIA DGX Spark | 128 GB | Grosse MoE-Modelle (nicht GLM-5.3) | ~3 tok/s (dichtes 70B) |

•KeyPoint: Ist die RTX-50-Serie (Blackwell) die aktuelle Generation und die einzigen NVIDIA-Consumer-Karten, die noch produziert werden — die RTX-40-Serie ist eingestellt. Die RTX 5090 (32 GB) ist die Karte fuer 70B-Arbeit, auch wenn die sich verschaerfende Speicherknappheit die Strassenpreise auf mehr als das Doppelte ihrer UVP von $1.999 getrieben hat.
Beste lokale LLMs nach VRAM-Stufe
Nutze dies als schnelles Nachschlagen nach der VRAM-Stufe deiner GPU:
Alle unten aufgefuehrten Modelle sind Open-Weights — herunterladbar, feinabstimmbar und kostenlos lokal ausfuehrbar. Wenn du zwischen Open-Weights und proprietaeren APIs waehlst, siehe unseren Vergleich Open-Source- vs. proprietaere LLMs fuer Kosten- und Leistungsabwaegungen bei unterschiedlichen Token-Volumina.
Die Hardware bestimmt, welche Modelle du ausfuehren kannst; das Prompt Engineering bestimmt, wie gut sie performen. Ein gut strukturierter Prompt auf einem 7B-Modell uebertrifft oft einen nachlaessigen Prompt auf einem 70B-Modell. Siehe den vollstaendigen Prompt-Engineering-Leitfaden fuer Techniken, die die Ausgabequalitaet bei jeder Parameterzahl maximieren.
- 8 GB VRAM (RTX 5060 Ti, RTX 4060, Intel B580): Llama 3.1 8B Q4_K_M (4.7 GB, ~70 tok/s) -- empfohlen. Qwen3 8B (5 GB, bestes mehrsprachig + Coding). Phi-4 Mini 3.8B (2.3 GB, am schnellsten). Gemma 3 4B (~3 GB, aktuelles kleines Google-Modell, multimodal). Vermeide 13B+-Modelle.
- 12 GB VRAM (RTX 4070 Ti, RTX 5070, Intel B770): Llama 3.1 8B (4.7 GB, schnell mit Reserve). Qwen3 14B Q4_K_M (8.5 GB, besseres Reasoning fuers Budget). Qwen3 8B (5 GB, bestes mehrsprachig + Coding). DeepSeek-R1 8B (5 GB, bestes Reasoning). Vermeide 30B+- und MoE-Modelle wie Llama 4 Scout (~55 GB bei Q4).
- 16 GB VRAM (RTX 4080, RTX 5070 Ti, RTX 5080): Mistral Small 3.1 24B Q4_K_M (14 GB, beste Qualitaet in der Stufe). Devstral Small 24B Q4_K_M (~16 GB) fuer agentisches Coding. Qwen3 14B (9 GB, schnell mit Kontextreserve). Llama 3.3 70B bei Q2_K (17 GB, moeglich, aber verschlechterte Qualitaet).
- 24 GB VRAM (RTX 5090, RTX 4090, Tesla L40): Qwen 3.6 27B Q4_K_M (~16 GB, 77,2 % SWE-bench, bestes dichtes Coding-Modell). DeepSeek-R1 32B Q4_K_M (~19 GB, bestes Reasoning). Qwen3 32B Q5_K_M (~21 GB). Llama 3.3 70B braucht 2x 24-GB-GPUs bei Q4_K_M.
- 32 GB VRAM (RTX 5090): Llama 3.3 70B Q4_K_M (40 GB -- braucht minimalen CPU-Offload fuer die letzten Layer). Qwen3 32B (19 GB, passt vollstaendig mit 13 GB Reserve). Fuer agentisches Coding ist die Kimi-K2-Linie (MoE, 1T gesamt / 32B aktiv, Modified MIT) die Schwergewichtswahl -- Kimi K2.7 Code (Juni 2026) ist die neueste, mit K2.6 als vorheriger allgemeiner Veroeffentlichung; beide brauchen in dieser Stufe Quantisierung und starken Offload. Die RTX 5090 ist die erste einzelne Consumer-GPU, die ein dichtes 70B mit minimalem Offload fasst.
- 48+ GB VRAM (RTX 6000 Ada, A100, DGX Spark): Llama 3.3 70B Q4_K_M (40 GB, passt vollstaendig). Llama 4 Scout (17B aktiv / 109B gesamt MoE, ~55 GB bei Q4 -- beste Wahl fuer langen Kontext 10M-Token / multimodal). Llama 4 Maverick (17B aktiv, 400B gesamt, MoE). Llama 3.3 70B Q8_0 (70 GB -- braucht 80-GB-A100). NVIDIA DGX Spark (128 GB unified) fasst jedes Open-Weight-Modell bis einschliesslich 70B bei Q8_0 mit 58 GB Reserve -- aber nicht die neuesten Frontier-MoE-Modelle: GLM-5.3 (744B gesamt, 40B aktiv) braucht ~239 GB selbst bei aggressiver 2-Bit-Quantisierung, weit ueber dem DGX Spark oder einem einzelnen 128-GB-Mac-Studio.
Interaktiver VRAM-Rechner
Verwenden Sie diesen Rechner, um exakte VRAM-Anforderungen für jede Kombination von Modell, Quantisierung, Kontext und Batch-Größe zu berechnen. Wählen Sie Ihre Konfiguration und sehen Sie, welche GPUs passen.
Popular Models
Base Model
6.50 GB
Context OH
1.50 GB
Batch OH
0.00 GB
System OH
1.00 GB
Total Minimum
9.00 GB
Recommended (with 25% safety margin)
11.25 GB
👉 Look for a GPU with at least 11.25 GB VRAM
Compatible GPUs
RTX 3060 (12 GB)
0.8 GB headroom
RTX 4060 Ti (16 GB)
4.8 GB headroom
RTX 4070 Ti Super (16 GB)
4.8 GB headroom
RTX 4080 Super (16 GB)
4.8 GB headroom
RTX 4090 (24 GB)
12.8 GB headroom
RTX 5090 (32 GB)
20.8 GB headroom
Mac Mini M6 (32 GB) (32 GB)
20.8 GB headroom
Mac Mini M5 Pro (64 GB) (64 GB)
52.8 GB headroom
Mac Studio M5 Max (128 GB) (128 GB)
116.8 GB headroom
Mac Studio M5 Ultra (96 GB+) (96 GB)
84.8 GB headroom
💡 Pro Tips:
- Always use the "with safety margin" figure when buying a GPU
- Q4 gives 90-95% quality with 25% size reduction. Q5 is better if you have room
- Context overhead grows with conversation length. Budget 1-3 GB for typical usage
- Batch size matters for multi-user APIs. Single-user chat can ignore batch overhead
📋 Share this configuration:
Beste lokale LLMs fuer 16 GB VRAM (2026)
Das beste lokale LLM fuer eine GPU mit 16 GB VRAM im Jahr 2026 ist Mistral Small 3.1 24B bei Q4_K_M: Es nutzt ~13 GB, laeuft mit 55 tok/sec und ist das staerkste Allzweckmodell, das mit Kontextreserve passt. 16-GB-Karten (NVIDIA RTX 5080, RTX 5070 Ti, RTX 4080 gebraucht oder eine RTX-4090-Laptop) gehen maximal bis 14-24B-Modelle — ein 70B-Modell braucht ~40 GB und passt nicht.
Fuer agentisches Coding passt Devstral Small 24B Q4_K_M bei ~16 GB; fuer Reasoning ist DeepSeek-R1 14B Q8_0 die Wahl. Das neuere Mistral Small 4 (Maerz 2026) ist ein einzelnes Modell, das Reasoning, Vision und Coding vereint, und der natuerliche Nachfolger als Standard der 16-GB-Klasse. Die Tabelle unten zeigt, was passt und was nicht — die Zeilen "Passt NICHT" sind der haeufigste Fehler, den 16-GB-Besitzer machen.
Modell | Quantisierung | VRAM genutzt | Geschwindigkeit (RTX 4080) | Best For | Passt 16 GB? |
|---|---|---|---|---|---|
| Mistral Small 3.1 24B | Q4_K_M | ~13 GB | 55 tok/sec | Allgemeiner Chat | ✅ Ja |
| Devstral Small 24B | Q4_K_M | ~16 GB | 45 tok/sec | Agentisches Coding | ✅ Knapp |
| Qwen3 14B | Q8_0 | ~15 GB | 45 tok/sec | Coding + Reasoning | ✅ Ja |
| DeepSeek-R1 14B | Q8_0 | ~15 GB | 40 tok/sec | Mathe + Analyse | ✅ Ja |
| Llama 3.1 8B | FP16 | ~16 GB | 70 tok/sec | Schnellste Antworten | ✅ Knapp |
| Llama 3.3 70B | Q4_K_M | ~39 GB | -- | -- | ❌ Nein (braucht 39 GB) |

•ProTip: 🏆 Bestes insgesamt fuer 16 GB: Mistral Small 3.1 24B Q4_K_M bei ~13 GB, 55 tok/sec. Fuer agentisches Coding nutze Devstral Small 24B (Mistral AI, Frankreich) mit 45 tok/sec. Bestes Reasoning: DeepSeek-R1 14B Q8_0 mit 40 tok/sec.
⚠️Warnung: RTX-4090-Laptop-GPUs haben 16 GB VRAM (nicht 24 GB). Sie teilen sich dieselbe Modellobergrenze wie die RTX-4080-Desktop.
•KeyPoint: Wann auf 24 GB aufruesten (RTX-4090-Desktop): nur wenn du 32B+-Modelle bei Q8 brauchst oder zwei Modelle gleichzeitig ohne Neuladen ausfuehren willst.
Welche lokalen LLMs laufen am besten auf 12 GB VRAM?
Auf einer GPU mit 12 GB VRAM (NVIDIA RTX 5070, RTX 4070 Ti oder RTX 3060 12 GB) kannst du 7-8B-Modelle bei Q8 oder 14B bei Q4_K_M ausfuehren. Hinweis: MoE-Modelle wie Llama 4 Scout passen hier NICHT -- obwohl Scout nur 17B Parameter pro Token aktiviert, muessen alle 109B Experten in den Speicher geladen werden, was ~55 GB bei Q4 erfordert.
Llama 3.1 8B bei Q8_0 ist die zuverlaessigste Wahl fuer konservative Setups: 9 GB VRAM, 80 tok/sec und volle Instruction-Following-Qualitaet. Qwen3 14B bei Q4_K_M passt ebenfalls bei ~8,5 GB und liefert deutlich besseres Reasoning als die 8B-Stufe.
Modell | Quantisierung | VRAM genutzt | Geschwindigkeit (RTX 4070 Ti) | Best For | Passt 12 GB? |
|---|---|---|---|---|---|
| Llama 3.1 8B | Q8_0 | ~9 GB | 80 tok/sec | Bestes insgesamt, allgemeiner Chat + Coding | ✅ Ja |
| Qwen3 14B | Q4_K_M | ~8.5 GB | 65 tok/sec | Besseres Reasoning fuers Budget | ✅ Ja |
| Llama 3.2 11B Vision | Q5_K_M | ~8 GB | 65 tok/sec | Bild- + Textaufgaben | ✅ Ja |
| Qwen3 8B | Q8_0 | ~8 GB | 85 tok/sec | Bestes mehrsprachig + Coding | ✅ Ja |
| Mistral Small v0.3 | FP16 | ~14 GB | -- | -- | ❌ Nein (braucht 14 GB bei FP16) |
| Llama 4 Scout (109B gesamt MoE) | Q4_K_M | ~55 GB | -- | -- | ❌ Nein (alle 109B Experten muessen laden) |
•ProTip: 🏆 Bestes insgesamt fuer 12 GB: Llama 3.1 8B Q8_0 bei ~9 GB, 80 tok/sec. Fuer besseres Reasoning auf derselben Karte nutze Qwen3 14B Q4_K_M bei ~8,5 GB. Llama 4 Scout passt nicht -- seine 109B MoE-Experten brauchen ~55 GB bei Q4.
•KeyPoint: RTX 3060 12GB ist der Budget-Einstieg (~$285 gebraucht). Sie betreibt alle 12-GB-Modelle, aber mit ~60-70 tok/sec gegenueber ~80-90 tok/sec auf der RTX 4070 Ti aufgrund der aelteren Speicherarchitektur.
Welche 70B-Modelle passen tatsaechlich in 24 GB VRAM (RTX 4090)?
Die Hardware-Anforderung, um ein 70B-Modell lokal in brauchbarer Q4_K_M-Qualitaet zu betreiben, betraegt ~40 GB VRAM — eine einzelne 24-GB-RTX-4090 reicht also nicht. Deine realen Optionen fuer 70B im Jahr 2026 sind: 2x RTX 5090 (64 GB kombiniert), eine RTX 5090 (32 GB) mit leichtem CPU-Offload, eine Server-GPU mit 48-80 GB (RTX 6000 Ada / A100) oder ein Apple M5 Max / 128-GB-Unified-Memory-System. Das haeufige Missverstaendnis ist, dass "Q4 klein ist" — bei 70B Parametern braucht selbst Q4 ~40 GB.
Auf einer einzelnen 24-GB-Karte ist die bessere Strategie ein 27-32B-Modell, das starke Qualitaet liefert und bequem mit Kontextreserve passt. Qwen3.6 27B bei Q4_K_M ist das beste dichte Coding-Modell (77,2 % SWE-bench); DeepSeek-R1 32B ist die beste Reasoning-Wahl. Eine 24-GB-GPU kann 70B nur bei Q2_K fassen, wo die Qualitaet merklich faellt. Siehe wie man 70B-Modelle auf 24 GB VRAM betreibt fuer Offload- und Dual-GPU-Techniken.
Modell | Quantisierung | VRAM benoetigt | Passt 24 GB? | Geschwindigkeit (RTX 4090) | Anmerkungen |
|---|---|---|---|---|---|
| Qwen 3.6 27B | Q4_K_M | ~16 GB | ✅ Ja | 55 tok/sec | Bestes dichtes Coding-Modell, 77,2 % SWE-bench |
| DeepSeek-R1 32B | Q4_K_M | ~19 GB | ✅ Ja | 60 tok/sec | Bestes Reasoning, starke Gesamtqualitaet |
| Qwen3 32B | Q5_K_M | ~21 GB | ✅ Ja | 55 tok/sec | Hohe Qualitaet, exzellentes Coding + Instruction |
| Qwen3 32B | Q8_0 | ~34 GB | ❌ Nein | -- | Erfordert 48-GB-GPU |
| Llama 3.3 70B | Q2_K | ~24 GB | ⚠️ Gerade so | 30 tok/sec | Passt, aber Q2-Qualitaet ist merklich verschlechtert |
| Llama 3.3 70B | Q4_K_M | ~39 GB | ❌ Nein | -- | Braucht 2x RTX 4090 oder A100 80 GB |

•KeyPoint: 🏆 Bestes fuer RTX 4090 (24 GB): Qwen 3.6 27B Q4_K_M (~16 GB, 77,2 % SWE-bench) als bestes dichtes Coding-Modell. Fuer Reasoning: DeepSeek-R1 32B Q4_K_M (~19 GB, 60 tok/sec). Besser als Llama 3.3 70B Q2_K bei weit weniger VRAM.
⚠️Warnung: Wenn du speziell 70B-Qualitaet bei Q4+ brauchst, ist die RTX 4090 nicht die richtige GPU. Du brauchst 2x RTX 4090 (48 GB kombiniert via Tensor-Parallelismus) oder eine RTX 6000 Ada (48 GB). 70B bei Q2_K auf einer einzelnen 4090 zu betreiben schadet der Ausgabequalitaet merklich.
Welche CPU und welchen RAM brauchst du?
Mit einer dedizierten GPU sind CPU und RAM sekundaere Komponenten. Die GPU erledigt die Matrix-Mathematik; CPU/RAM verwalten die Kontextvorbereitung. Fuer einen vollstaendigen Vergleich der Inferenzgeschwindigkeiten von GPU vs. CPU vs. Apple Silicon siehe den Leitfaden GPU vs. CPU vs. Apple Silicon.
Minimale CPU: 8-Kern-Prozessor (Intel Core i7 14. Gen, AMD Ryzen 7 7700X oder neuer). Aeltere CPUs fuegen 20 %+ Latenz hinzu.
RAM: 16 GB Minimum (mit GPU). Ohne GPU werden 32+ GB empfohlen. RAM begrenzt die Modellgroesse nicht direkt, wenn eine GPU vorhanden ist.
Speicher: 500 GB SSD fuer Modelldateien und Betriebssystem. M.2 NVMe wird bevorzugt (schnelleres Modellladen).
Welche Modelle laufen gut auf 16 GB Arbeitsspeicher ohne GPU?
Ohne GPU kann ein Rechner mit 16 GB Arbeitsspeicher 3B-7B-Modelle mit 8-20 Token/sec ueber CPU-Inferenz ausfuehren. Der Engpass ist die Speicherbandbreite, nicht die RAM-Kapazitaet -- CPUs haben weit niedrigere Bandbreite als GPUs, weshalb die Inferenz 5-10x langsamer ist.
Auf 16 GB Arbeitsspeicher lautet die praktische Regel: Modelldateigroesse + 4 GB Betriebssystem-Overhead ≤ 16 GB. Ein 7B-Modell bei Q4_K_M (4,9 GB) passt, laesst aber wenig Reserve fuer lange Kontexte. Die Tabelle unten zeigt realistische Optionen.
Fuer einen vollstaendigen, geschwindigkeitsoptimierten Modellleitfaden, der CPU-only, 4 GB, 6 GB und 8 GB VRAM-Stufen mit echten Benchmarks abdeckt, siehe Schnellste lokale LLMs fuer schwache PCs.
Modell | Quantisierung | RAM genutzt | Geschwindigkeit (Ryzen 9 7950X) | Best For | Anmerkungen |
|---|---|---|---|---|---|
| Gemma 2 2B | Q8_0 | ~2.7 GB | 28 tok/sec | Am schnellsten, minimaler RAM | Laesst 13 GB frei fuers Betriebssystem |
| Phi-4 Mini 3.8B | Q4_K_M | ~2.5 GB | 25 tok/sec | Coding auf CPU | Bestes Qualitaet-pro-RAM-Verhaeltnis |
| Llama 3.2 3B | Q8_0 | ~3.8 GB | 20 tok/sec | Allgemeiner Chat, wenig RAM | Zuverlaessig, breit unterstuetzt |
| Llama 3.1 8B | Q4_K_M | ~4.9 GB | 12 tok/sec | Beste CPU-Qualitaet | 12 tok/sec ist langsam, aber fuer Batch-Aufgaben brauchbar |
| Llama 3.1 8B | Q8_0 | ~9 GB | 8 tok/sec | Maximale Qualitaet auf CPU | Auf den meisten CPUs zu langsam fuer interaktive Nutzung |

•ProTip: 🏆 Bestes fuer 16 GB RAM, keine GPU: Phi-4 Mini 3.8B Q4_K_M (2,5 GB, 25 tok/sec). Liefert ueberraschend starkes Coding und Reasoning fuer seine Groesse.
•KeyPoint: CPU- vs. GPU-Geschwindigkeit in der Realitaet: Eine gebrauchte NVIDIA RTX 3060 12 GB (~$285) betreibt Llama 3.1 8B mit 70+ tok/sec -- 5-8x schneller als der Ryzen 9 7950X bei CPU-only-Inferenz. Wenn Geschwindigkeit zaehlt, kaufe eine GPU, bevor du RAM ergaenzt.
⚠️Warnung: Ein 7B-Modell auf 16 GB RAM mit CPU-only auszufuehren laesst weniger als 7 GB fuer Betriebssystem und Browser. Bei langen Gespraechskontexten (32k+ Token) waechst die Modelldatei ueber ihre Basisgroesse hinaus und kann RAM-Erschoepfung verursachen. Halte die Kontextgroesse auf 16-GB-CPU-only-Rechnern unter 4096.
Wie viel Speicher brauchst du?
Modelldateien sind gross: ein 7B-Modell bei 4-Bit-Quantisierung umfasst 4-5 GB. Plane den Speicher rund um Anzahl und Groesse der Modelle, die du lokal behalten willst.
- 500 GB SSD: Betriebssystem + 1-2 kleine Modelle (3B, 7B)
- 1 TB SSD: Betriebssystem + 3-5 Modelle (Mix aus 7B und 13B)
- 2 TB SSD: Betriebssystem + 10+ Modelle (verschiedene Groessen)
- 4 TB NVMe RAID: Produktions-Setup, schnelles Modellladen
Welchen Hardware-Build solltest du kaufen?
Einen lokalen LLM-Rechner von Grund auf zu bauen bedeutet, zuerst die GPU zu priorisieren, dann CPU und RAM. Hier sind drei realistische Konfigurationen. Fuer Multi-GPU-Builds siehe den Multi-GPU-Leitfaden fuer lokale LLMs. Fuer Heimautomatisierungs-Setups passen kompakte Mini-PCs oft besser als vollwertige Desktop-Builds — siehe den besten Mini-PC fuer Home Assistant mit lokaler KI →.
Budget | GPU | CPU | RAM | Models | Cost |
|---|---|---|---|---|---|
| $1500 (Einstieg) | RTX 4070 Ti | i7 13700 | 16 GB | 7-13B | Realistisch |
| $2500 (solide) | RTX 4080 | i7 14700K | 32 GB | 13-30B | Empfohlen |
| $4000 (High-End) | 2× RTX 4090 | Ryzen 9 7950X | 128 GB | Beliebig (70B+) | Ueberdimensioniert fuer privat |

Was, wenn du dir die Hardware nicht leisten kannst?
Wenn eine GPU fuer $280–400 ausserhalb deines Budgets liegt oder dein Laptop zu alt ist, um moderne Inferenz-Engines zu unterstuetzen, sind lokale LLMs fuer dich 2026 moeglicherweise nicht kosteneffizient.
Berechne die echten Kosten:
- Lokal: $800–2.000 Hardware im Voraus + Strom + Wartung ueber 2–3 Jahre
- Cloud: $5–50/Monat fuer typische Entwicklernutzung (Llama API oder GPT-5.5 mini)
Fuer Gelegenheitsnutzer (< 100.000 Token/Monat) kosten Cloud-APIs $5–10/Monat und erfordern keine Hardware. Fuer Vielnutzer (> 10M Token/Monat) amortisiert sich lokal in 6–12 Monaten.
Vergleiche die vollstaendigen Kosten- und Leistungsabwaegungen lokal vs. Cloud, um deinen Break-even-Punkt zu finden. Viele Entwickler stellen fest, dass die Cloud fuer ihr tatsaechliches Nutzungsverhalten guenstiger ist.
Du suchst bereits unterhalb der empfohlenen VRAM-Stufen? Siehe Beste lokale KI-App fuer einen schwachen PC, welche Modell- und App-Kombinationen tatsaechlich auf 8 GB oder weniger laufen.
Wie maximierst du die llama.cpp-Geschwindigkeit auf der RTX 4070 Ti?
Mit korrekten Einstellungen erreicht llama.cpp auf einer RTX 4070 Ti 85-95 Token/sec bei Llama 3.1 8B Q4_K_M -- mehr als das Doppelte der Standardgeschwindigkeit ab Werk. Das wirkungsvollste Flag ist `--n-gpu-layers 99`, das alle Modell-Layer auf die GPU auslagert. Ohne es fallen Layer auf die CPU zurueck und erzeugen einen schweren Engpass.
Diese Einstellungen gelten direkt fuer llama.cpp und fuer Ollama (das intern llama.cpp nutzt). Ollama setzt `--n-gpu-layers 99` auf NVIDIA-Hardware automatisch, wenn die Treiber korrekt installiert sind.
- Q4_K_M schlaegt Q4_0 um 15-20 % auf der RTX 4070 Ti. Die K_M-Variante nutzt gemischte Quantisierung, die NVIDIA-Tensor-Cores effizienter beschleunigen. Waehle immer Q4_K_M gegenueber Q4_0, wenn beide verfuegbar sind.
- IQ4_XS ist das kleinste Format (~8 % kleiner als Q4_K_M) mit minimalem Qualitaetsverlust. Nuetzlich, um Qwen3 14B in 12 GB VRAM zu bekommen, wenn Q4_K_M grenzwertig ist.
- Q5_K_M laeuft auf NVIDIA-GPUs nahezu gleich schnell wie Q4_K_M (< 5 % langsamer) und liefert dabei merklich bessere Ausgabequalitaet. Lohnt sich, wenn du 20 % VRAM-Reserve hast.
Flag | What It Does | Impact | Default | Notes |
|---|---|---|---|---|
| --n-gpu-layers 99 | Lagert alle Layer auf die GPU aus | +100-150 % Geschwindigkeit | 0 (nur CPU) | Wichtigstes Flag -- setze dies immer zuerst |
| --threads [cores] | CPU-Threads fuer die Prompt-Verarbeitung | +10-15 % Geschwindigkeit | Alle Threads (inkl. HT) | Nur auf die Anzahl physischer Kerne setzen. Hyperthreading schadet der Inferenz. |
| --ctx-size 2048 | KV-Cache- / Kontextfenstergroesse | Spart 0,5-8 GB VRAM | 4096 | 2048 = ~0,5 GB zusaetzlicher VRAM. 32768 = ~8 GB zusaetzlich. Nur bei Bedarf erhoehen. |
| --n-batch 512 | Batch-Groesse der Prompt-Verarbeitung | +5-10 % Durchsatz | 512 | Guter Standard. Fuer Batch-Workloads auf 1024 erhoehen, falls der VRAM reicht. |
| --flash-attn | Flash-Attention-2-Kernel | -20-30 % VRAM bei langem Kontext | Deaktiviert | Verfuegbar seit llama.cpp b2900. Reduziert VRAM fuer Kontexte > 8k Token. |

•ProTip: Fuehre `ollama ps` aus, um zu bestaetigen, dass dein Modell auf der GPU geladen ist. Wenn die GPU-Auslastung in `nvidia-smi` waehrend der Generierung 0 % zeigt, leiten die Treiber nicht korrekt zu CUDA. Installiere das NVIDIA CUDA Toolkit neu und starte Ollama neu.
•KeyPoint: RTX-4070-Ti-Geschwindigkeitsreferenz: Llama 3.1 8B Q4_K_M = 85-95 tok/sec. Llama 3.3 13B Q4_K_M = 60-70 tok/sec. Qwen3 8B Q8_0 = 90-95 tok/sec. Diese setzen --n-gpu-layers 99 und --ctx-size 2048 voraus.
⚠️Warnung: --ctx-size ueber 8192 auf einer 12-GB-GPU zu erhoehen, verursacht eine Rueckverlagerung der Modell-Layer auf die CPU, wenn der KV-Cache den verbleibenden VRAM erschoepft. Wenn die Geschwindigkeit bei langen Gespraechen ploetzlich faellt, reduziere die Kontextgroesse oder nutze --flash-attn.
Kann Mac-Hardware lokale LLMs ausfuehren?
Apple Silicon (M-Serie) betreibt lokale LLMs effizient mit Unified Memory, der zwischen CPU und GPU geteilt wird. Der Basis-M5 erschien im Oktober 2025; M5 Pro und M5 Max folgten im Maerz 2026. Apple misst bis zu 4x schnellere LLM-Prompt-Verarbeitung (Time-to-First-Token) auf M5 Pro/Max gegenueber der M4-Generation, wobei die Zuwaechse bei der Token-Generierung bescheidener ausfallen.
Der M5 Max mit 128 GB Unified Memory (bis zu 614 GB/s) betreibt 70B-Modelle bei Q4_K_M bequem — etwa 12-15 tok/sec — im Laptop- oder Mac-Studio-Formfaktor. Der M5 Pro (bis zu 64 GB unified, 307 GB/s) bewaeltigt 32B-Modelle mit grosszuegiger Reserve fuer KV-Cache und Multitasking. Beachte, dass der M5 Max den ~239-GB-Bedarf von GLM-5.3 selbst bei 2-Bit noch weit verfehlt -- ein Bereich, in dem Apples Unified-Memory-Obergrenze mehr zaehlt als reine Geschwindigkeit.
Apple hat die Mac-mini- und Mac-Studio-Reihe am 25. August 2026 aufgefrischt, Auslieferung ab 22. September 2026. Der Mac mini kommt jetzt in den Konfigurationen M6 (ab $899, bis zu 32 GB Unified Memory, 170 GB/s) und M5 Pro (ab $1.699, bis zu 64 GB, 307 GB/s). Der Mac Studio steigt auf M5 Max (ab $2.499, bis zu 128 GB) und M5 Ultra (ab $5.499 mit 96 GB, bis zu 256 GB oder 512 GB in der Top-Konfiguration -- das 512-GB-Modell liefert Ende Oktober 2026 aus und duerfte deutlich ueber $10.000 kosten). Der bisherige M4 Mac mini (ab $599) und der M4 Pro Mac mini (bis $2.299, maximal 64 GB) sowie der vorherige Mac Studio M4 Max / M3 Ultra sind jetzt die Vorgaengergeneration.
Fuer die Chips M6 und M5 Ultra gibt es noch keine unabhaengigen Tok/sec-Benchmarks -- Apple hat fuer beide bislang keine von Dritten verifizierten Inferenzwerte veroeffentlicht. Erstmals kann ein einzelner Mac GLM-5.3 (744B MoE, ~239 GB bei 2-Bit) theoretisch im Unified Memory unterbringen: Die Top-Konfiguration des Mac Studio M5 Ultra mit 512 GB uebertrifft diesen Bedarf mit deutlichem Spielraum. Bis reale Benchmarks vorliegen, bleibt ein 4x-RTX-3090/4090-Rig der besser dokumentierte lokale Weg fuer Modelle der GLM-5.3-Klasse.
Auf einem MacBook mit 8 GB RAM bleib bei 3-4B-Modellen. Da der Unified Memory zwischen Betriebssystem und Modell geteilt wird, passen in 8 GB realistisch Phi-4 Mini 3.8B, Llama 3.2 3B oder Gemma 3 4B bei Q4_K_M ueber Ollama oder llama.cpp (beide nutzen automatisch das Metal-GPU-Backend). Ein 7B-Modell ist bei 8 GB grenzwertig und swappt unter Last; 16 GB ist das komfortable Minimum fuer 7-8B-Modelle auf einem Mac.
Mac | GPU Memory | Best For | Limitation |
|---|---|---|---|
| M-Serie 8 GB (Air / Basis) | 8 GB unified | 3-4B-Modelle (Phi-4 Mini, Gemma 3 4B) | 7B grenzwertig; Betriebssystem konkurriert um RAM |
| M3 Pro MacBook Pro 16" | 18 GB unified | 7-8B-Modelle (schnell) | Kann 14B langsam ausfuehren |
| Mac mini M6 (ab $899) | 32 GB unified, 170 GB/s | 8-14B-Modelle | Kein Spielraum fuer 32B+ |
| M5 Pro (MacBook Pro / Mac mini, ab $1.699) | 64 GB unified, 307 GB/s | 32B-Modelle bequem | Llama 4 Scout laeuft gut |
| M5 Max (MacBook Pro / Studio, ab $2.499) | 128 GB unified, bis zu 614 GB/s | 70B-Modelle bei Q4_K_M | ~12-15 tok/sec bei 70B |
| Mac Studio M5 Ultra (ab $5.499) | 96-512 GB unified | 70B+ und grosse MoE-Modelle | 512 GB ab Okt. 2026; noch keine Benchmarks |

Wann solltest du Server- vs. Consumer-Hardware nutzen?
Fuer Produktionseinsatz (24/7-Betrieb, mehrere Nutzer) wird Server-Hardware gegenueber Consumer-GPUs empfohlen. Consumer-Hardware ist fuer Gaming optimiert, nicht fuer dauerhafte Inferenz.
- Consumer (RTX 5090): ~$2.000 UVP (~$4.300–5.000+ Strasse), 32 GB VRAM, Einzelnutzer, anfaellig fuer thermisches Throttling unter Dauerlast.
- Server (RTX 6000 Ada): ~$7.000, 48 GB VRAM, ausgelegt fuer 24/7-Betrieb, bessere Kuehlung, Fehlerkorrektur.
- Empfehlung: Beginne mit einer RTX 5090. Wenn du 70B-Modelle 24/7 fuer mehrere Nutzer betreibst, ruestest du auf Dual A100 oder RTX 6000 Ada auf.

NVIDIA DGX Spark: 128-GB-Desktop-KI-Computer
Der NVIDIA DGX Spark ($4.699 Stand Februar 2026, hoch vom Startpreis $3.999) ist ein kompakter 128-GB-Desktop-KI-Computer, der Llama 3.3 70B bei Q8_0 vollstaendig im Unified Memory halten kann. Apple Mac Studio / MacBook Pro mit 128 GB und AMD-Strix-Halo-128-GB-Systeme koennen dasselbe, er ist also nicht einzigartig — aber er kommt mit NVIDIAs CUDA-Software-Stack.
Gebaut auf dem GB10 Grace Blackwell Superchip, erschien der DGX Spark im Oktober 2025 mit 128 GB LPDDR5x Unified Memory. Hinweis: seine reale Speicherbandbreite betraegt ~273 GB/s, daher ist die Token-Generierung bei dichtem 70B langsam — unabhaengige Tests (LMSYS) massen rund 3 tok/sec bei Llama 70B. Die Schlagzeilen-FP4-Rechenleistung uebersetzt sich nicht in schnelles Single-Stream-Decoding. Der DGX Spark eignet sich am besten fuer grosse Mixture-of-Experts-Modelle (Llama 4 Scout/Maverick, Kimi K2), bei denen nur ein Bruchteil der Parameter pro Token aktiviert -- aber seine 128-GB-Obergrenze ist nicht unbegrenzt: GLM-5.3 (744B gesamt, 40B aktiv, veroeffentlicht im Juni 2026) braucht ~239 GB selbst bei 2-Bit-Quantisierung und passt nicht in einen einzelnen DGX Spark.
Spec | Wert |
|---|---|
| Unified Memory | 128 GB LPDDR5x |
| Llama 3.3 70B bei Q4_K_M | ✅ passt (40 GB) |
| Llama 3.3 70B bei Q8_0 | ✅ passt (70 GB) |
| GLM-5.3 bei 2-Bit (~239 GB) | ❌ passt nicht |
| Inferenzgeschwindigkeit (70B) | ~3 tok/s |
| Preis | $4.699 |
| Betriebssystem | DGX OS (Ubuntu), Ollama vorinstalliert |
| Speicherbandbreite | ~273 GB/s (real) |
| vs. RTX 5090 | 4x mehr Speicher, aber weit niedrigere Bandbreite |
•KeyPoint: Eine dedizierte GPU (RTX 5090 oder Dual 5090) generiert Token bei dichten Modellen viel schneller als der DGX Spark, wegen der weit hoeheren Speicherbandbreite. Waehle den DGX Spark fuer Kapazitaet — sehr grosse MoE-Modelle in einer Box zu halten — nicht fuer Single-Stream-70B-Geschwindigkeit.
Was sind die haeufigsten Hardware-Fehler?
- CPU-only kaufen, wenn eine GPU verfuegbar ist. Eine RTX 4070 Ti fuer $600 uebertrifft eine CPU fuer $2000. Die GPU dominiert die LLM-Geschwindigkeit.
- Den VRAM-Overhead nicht einrechnen. Modelldateigroesse + System-Overhead + Kontext = gesamter genutzter VRAM. Kaufe immer 25 % mehr als die Modellgroesse.
- Annehmen, dass alle 70B-Modelle in 40GB VRAM passen. Sie tun es, gerade so, nur bei Q4-Quantisierung (4-Bit). Q5 erfordert 45+ GB.
- Netzteil und Kuehlung ignorieren. Die RTX 4090 zieht 575W. Es braucht ein 1200W-Netzteil und gute Gehaeuse-Luftstroemung.
- Denken, eine alte GPU funktioniert. Die RTX 2080 ist 10x langsamer als die RTX 4070 Ti. Moderne GPU-Architektur uebertrifft frühere Generationen deutlich.
- Den KV-Cache-VRAM nicht zusaetzlich zu den Modellgewichten einrechnen: Ein 7B-Modell bei Q4_K_M umfasst 4,7 GB Gewichte -- aber mit einem 32K-Kontextfenster fuegt der KV-Cache ~4 GB mehr hinzu, insgesamt ~8,7 GB. Auf einer 8-GB-Karte verursacht das OOM-Fehler. Fuege je nach Kontextlaenge immer 25-100 % zur Modellgroesse hinzu.
- Hardwarekosten als einzige Kosten behandeln: Wenn du dir 16+ GB RAM oder eine dedizierte GPU nicht leisten kannst, kosten Cloud-APIs fuer geringes Volumen weniger ($0,01–0,05 pro 1K Token). Siehe Lokales LLM vs. Cloud: Kostenanalyse fuer die vollstaendige Abwaegung.
Welche regionalen Compliance-Regeln gelten fuer lokale LLM-Hardware?
EU (DSGVO + EU AI Act): LLMs lokal zu betreiben haelt alle Inferenzdaten innerhalb deiner Infrastruktur und beseitigt Bedenken zur grenzueberschreitenden Datenuebermittlung nach DSGVO Artikel 44. Die Pflichten des EU AI Act fuer eigenstaendige Hochrisiko-KI-Systeme (Anhang III) sollten urspruenglich ab dem 2. August 2026 gelten, doch das "Digital Omnibus on AI" — im Mai 2026 vorlaeufig vereinbart und Stand Juni 2026 vor der formellen Annahme — verschiebt dieses Datum auf den 2. Dezember 2027 (mit in regulierten Produkten eingebetteter Hochrisiko-KI verschoben auf den 2. August 2028). Die Transparenzpflichten nach Artikel 50 des AI Act gelten weiterhin nach dem urspruenglichen Zeitplan. Lokale Hardware erfuellt Datenresidenz-Anforderungen standardmaessig.
Japan (APPI): Japans APPI-Novelle von 2022 verschaerfte die Regeln zu Datenpannen-Meldungen und grenzueberschreitenden Uebermittlungen, schreibt aber keine KI-spezifische Datenminimierung vor (sie stuetzt sich auf allgemeine Zweckbindungspflichten). Relevanter fuer KI sind Japans APPI-Reformpaket 2025 und sein erstes KI-Gesetz — das KI-Foerderungsgesetz (in Kraft seit Juni 2025), ein innovationsfreundlicher Rahmen ohne Strafen. On-Premises-LLM-Hardware haelt personenbezogene Daten fuer Dokumentenverarbeitung und Kundensupport-Automatisierung innerhalb deiner Infrastruktur.
China: Die vorlaeufigen Massnahmen der chinesischen Cyberspace Administration of China (CAC) fuer generative KI-Dienste (gueltig ab August 2023) verlangen von Anbietern mit Einfluss auf die oeffentliche Meinung, eine CAC-Sicherheitsbewertung und Algorithmus-Meldung abzuschliessen. Seit dem 1. September 2025 schreibt China zudem die Kennzeichnung KI-generierter Inhalte nach den CAC-Kennzeichnungsmassnahmen und dem nationalen Standard GB 45438-2025 vor. Lokale Hardware mit Open-Weight-Modellen zu betreiben vermeidet API-basierte Compliance-Risiken fuer den internen Unternehmenseinsatz.
Haeufige Fragen zu lokaler LLM-Hardware
Kann ich ein 70B-Modell auf einem Laptop ausfuehren?
Nur mit starker Quantisierung (Q2, 2-Bit) und CPU-Ausweich. Unpraktisch. Laptops eignen sich fuer 7B-Modelle. Fuer 70B nutze einen Desktop mit RTX 4090+.
Ist die RTX 4090 fuer den privaten Gebrauch ueberdimensioniert?
Nicht, wenn du 70B-Modelle oder mehrere Modelle gleichzeitig betreibst. Fuer reinen 7B-Chat reicht die RTX 4070 Ti. Die RTX 4090 ist zukunftssicher, wenn du Flexibilitaet willst.
Soll ich die RTX 5090 kaufen oder auf die RTX 6090 warten?
Die RTX 5090 ist verfuegbar (Anfang 2026). RTX-6000-Ada-Server-GPUs sind ebenfalls solide. Sofern du kein unbegrenztes Budget hast, sind RTX 5090 oder 4090 exzellent.
Wie beeinflusst die Quantisierung die Qualitaet?
FP16 = 100 % Qualitaet (Basislinie), Q8 = 99 %, Q5 = 95 %, Q4 = 90-95 %. Fuer die meisten Aufgaben ist Q4 von FP16 nicht zu unterscheiden.
Kann ich die GPU spaeter aufruesten?
Ja. Beginne jetzt mit der RTX 4070 Ti, ruestest in 2 Jahren bei Bedarf auf die RTX 5090 auf. Die GPU ist die am leichtesten austauschbare Komponente.
Wie viel RAM brauche ich, um ein 7B-Modell lokal auszufuehren?
8 GB RAM ist das absolute Minimum fuer ein 7B-Modell. 16 GB werden fuer bequeme Nutzung neben Browser und Betriebssystem empfohlen. 32 GB geben Reserve fuer groessere Kontextfenster und Multitasking.
Kann ich lokale LLMs auf Apple Silicon (M1/M2/M3/M4/M5) ausfuehren?
Ja. Apple Silicon nutzt Unified Memory, der zwischen CPU und GPU geteilt wird. Der M5 Pro (64 GB, 307 GB/s) betreibt 32B-Modelle gut. Der M5 Max (128 GB, bis zu 614 GB/s) betreibt 70B bei Q4_K_M mit rund 12-15 tok/sec. Auf einem 8-GB-Mac bleib bei 3-4B-Modellen.
Was sind die besten llama.cpp-Modelle fuer ein MacBook mit M3 und 8 GB RAM?
Auf einem MacBook M3 mit 8 GB RAM fuehre 3-4B-Modelle bei Q4_K_M aus: Phi-4 Mini 3.8B, Llama 3.2 3B oder Gemma 3 4B. Nutze Ollama oder llama.cpp — beide nutzen automatisch das Metal-GPU-Backend. Ein 7B-Modell ist grenzwertig und swappt unter Last; halte den Kontext unter 4096 Token. Fuer bequeme 7-8B-Nutzung auf einem Mac ist 16 GB Unified Memory das praktische Minimum.
Welche CPU ist die beste fuer lokale LLMs ohne GPU?
CPUs mit hoher Kernzahl und grossem L3-Cache: AMD Ryzen 9 7950X oder Intel Core i9-14900K. Erwarte 5-15 Token/sec fuer 7B-Modelle. CPU-Inferenz ist 3-5x langsamer als GPU.
Beeinflusst die Speichergeschwindigkeit die Leistung lokaler LLMs?
Ja, beim Modellladen. Eine NVMe-SSD (3-7 GB/s) laedt ein 7B-Modell in 2-5 Sekunden gegenueber 20-60 Sekunden auf einer HDD. Die Inferenzgeschwindigkeit nach dem Laden ist vom Speicher unbeeinflusst.
Kann ich mehrere GPUs nutzen, um groessere Modelle auszufuehren?
Ja, via Tensor-Parallelismus. Zwei RTX 5090 (je 32 GB) liefern 64 GB VRAM, genug fuer ein 70B-Modell bei Q4_K_M. Ollama und llama.cpp unterstuetzen Multi-GPU via --n-gpu-layers, aufgeteilt auf die Karten.
Was sind die besten lokalen LLMs fuer 16 GB VRAM im Jahr 2026?
Mistral Small 3.1 24B Q4_K_M (13 GB, 55 tok/sec) ist das beste insgesamt fuer RTX 5080 / RTX 5070 Ti / RTX-4090-Laptop. Fuer agentisches Coding: Devstral Small 24B Q4_K_M (16 GB, 45 tok/sec). Fuer Reasoning: DeepSeek-R1 14B (15 GB, 40 tok/sec). Das neuere Mistral Small 4 (Maerz 2026) ist der Ein-Modell-Nachfolger. Llama 3.3 70B passt nicht -- es braucht ~40 GB bei Q4_K_M.
Kann eine einzelne RTX 4090 ein 70B-Modell in guter Qualitaet ausfuehren?
Nein -- nicht in Q4_K_M-Qualitaet. Llama 3.3 70B bei Q4_K_M braucht ~39 GB VRAM. Die RTX 4090 hat 24 GB. Du kannst es bei Q2_K (~24 GB) ausfuehren, aber die Qualitaet faellt merklich. Bessere Optionen: Qwen 3.6 27B Q4_K_M (~16 GB, 77,2 % SWE-bench, bestes dichtes Coding) oder DeepSeek-R1 32B Q4_K_M (~19 GB, bestes Reasoning).
Was ist das beste lokale LLM fuer 16 GB Arbeitsspeicher ohne GPU?
Phi-4 Mini 3.8B Q4_K_M (2,5 GB RAM, ~25 tok/sec auf Ryzen 9 7950X) ist die beste Option fuer CPU-only-Inferenz auf 16 GB Arbeitsspeicher. Gemma 2 2B Q8 ist am schnellsten mit ~28 tok/sec. Llama 3.1 8B Q4_K_M (4,9 GB) passt ebenfalls, laeuft aber mit ~12 tok/sec -- langsam fuer interaktive Nutzung.
Was ist die Speicher-Faustregel fuer ein 7B-Modell bei Q4-Quantisierung?
Ein 7B-Modell bei Q4_K_M-Quantisierung braucht etwa 4-5 GB VRAM (oder Arbeitsspeicher bei CPU-only-Inferenz) -- rund 0,6 GB pro Milliarde Parameter bei 4-Bit-Praezision. Das skaliert linear: ein 14B-Modell braucht ~9 GB, ein 32B-Modell braucht ~19 GB und ein 70B-Modell braucht ~40 GB, jeweils bei Q4_K_M.
Welche Hardware brauche ich, um GLM-5.3 lokal zu betreiben?
GLM-5.3 (Z.ai, veroeffentlicht im Juni 2026) ist ein 744-Milliarden-Parameter-MoE-Modell mit 40B aktiv pro Token. Selbst die aggressivste 2-Bit-dynamische GGUF braucht ~239 GB kombinierten VRAM/RAM -- zu gross fuer eine einzelne RTX 5090 (32 GB), einen 128-GB-DGX-Spark oder einen 128-GB-Mac-Studio. Realistische lokale Wege sind ein 4×-RTX-3090/4090-Rig mit 192 GB+ Arbeitsspeicher oder ein Mac Studio mit 512 GB (M5 Ultra), beide bei rund 3-9 Token/sec via CPU/GPU-Hybrid-Offload. Fuer die meisten Nutzer ist GLM-5.3 faktisch nur in der Cloud sinnvoll nutzbar.
Wie viel VRAM braucht man, um 2026 ein lokales LLM zu betreiben?
Der minimale VRAM haengt von der Modellgroesse ab: 7B-Modelle = 8-12 GB, 13B-Modelle = 12-16 GB, 30B-Modelle = 18-24 GB, 70B-Modelle = 24-48 GB je nach Quantisierung (Q4–Q8). Beginne mit 12 GB fuer gute Flexibilitaet; 24 GB VRAM ist der Sweetspot fuer 2026.
Hilft mehr RAM lokalen LLMs ueber den VRAM hinaus?
Der Arbeitsspeicher unterstuetzt Betriebssystem und Multitasking, erhoeht aber nicht die Modellkapazitaet ueber den GPU-VRAM hinaus (bei GPU-beschleunigter Inferenz). Mit einer GPU reichen 16 GB Arbeitsspeicher. Ohne GPU helfen 32+ GB RAM, aber die Inferenzgeschwindigkeit ist 3-5x langsamer als GPU-basiert.
Kann man ein 30B-Parameter-Modell auf einer RTX 5080 vs. Mac Mini M4 Pro ausfuehren?
RTX 5080 (16 GB VRAM): 30B passt bei Q4_K_M (~16 GB) mit 80-120 Token/sec. Mac Mini M4 Pro (36 GB unified): 30B laeuft bei Q8 (28 GB) mit 20-30 Token/sec. Die RTX 5080 ist 4-6x schneller, aber weniger mobil; der Mac ist energieeffizient, aber langsamer.
Was sind die Hardware-Anforderungen, um 2026 ein lokales Coding-LLM zu betreiben?
Fuer gute Coding-Leistung: RTX 4080+ (16 GB VRAM) mit DeepSeek-Coder 33B Q4 oder Mistral Large 24B Q4 fuer Codegenerierung. Minimum: RTX 4070 Ti (12 GB) mit Mistral Small 3.1 24B Q4. CPU: 8+ Kerne. RAM: 16 GB Arbeitsspeicher. 500 GB SSD.
Lohnt sich eine RTX 3060 12GB 2026 noch fuer lokale LLMs?
Die RTX 3060 (12 GB) ist veraltet (Architektur von 2021). Sie bewaeltigt 7B-13B-Modelle bei Q4, liefert aber 40-60 Token/sec. Eine gebrauchte kostet ~$285; eine neue RTX 5070 (~$880) oder RTX 5060 Ti 16 GB (~$585) laeuft 2-3x schneller. Die RTX 3060 lohnt sich nur, um sie als sekundaere GPU fuer Multi-Karten-Setups zu behalten.
Wie viel VRAM braucht man fuer 7B-, 13B- und 30B-Modelle?
7B-Modelle: 8-10 GB bei Q4, 9-11 GB bei Q5, 16 GB bei FP16. 13B-Modelle: 12-14 GB bei Q4, 16-18 GB bei Q5, 26 GB bei FP16. 30B-Modelle: 16-20 GB bei Q4, 22-26 GB bei Q5, 60 GB bei FP16. Q4 ist die empfohlene Quantisierungsstufe fuer 2026er-Hardware.
Was ist die beste GPU-Konfiguration fuer Enterprise-LLM-Deployment 2026?
Fuer Enterprise: 2× RTX 5090 (64 GB VRAM gesamt) fuer Redundanz und Lastverteilung oder A100 (80 GB) fuer Multi-Tenant-Systeme. Die RTX 5090 kostet $2.000 pro Einheit; die A100 $10.000+. Docker-basierte Orchestrierung (vLLM, Ollama Serve) ermoeglicht Multi-Modell-Serving und gleichzeitige Nutzerbedienung.
Unterstuetzt ein RTX-4070-Laptop LLM-Quantisierung?
Ja. RTX-4070-Laptops (8 GB VRAM) unterstuetzen Q4- und Q5-Quantisierung fuer 7-13B-Modelle mit 50-70 Token/sec. Hoeherwertige Laptops mit der RTX-4090-Mobile-GPU (16 GB) bewaeltigen bis zu 24B-Modelle. Quantisierung ist fuer Laptop-Inferenz unerlaesslich—ohne sie passen nur 3-7B-Modelle in 8 GB VRAM.
Quellen
- NVIDIA. (2026). "GeForce GPU Specifications." www.nvidia.com/en-us/geforce/graphics-cards/ -- Offizielle VRAM- und Bandbreitenspezifikationen fuer RTX-40-Serie und RTX-50-Serie-GPUs.
- Apple. (2026). "Apple M5 Chip." www.apple.com/mac/ -- M5 Pro/Max-Spezifikationen, Speicherbandbreite, LLM-Leistungsangaben. M5 ist der erste Mac, der 70B-Modelle bei Q4_K_M bequem betreibt.
- NVIDIA. (2025). "DGX Spark Product Page." www.nvidia.com/en-us/products/workstations/dgx-spark/ -- Offizielle Spezifikationen fuer GB10 Grace Blackwell Superchip und 128 GB Unified Memory.
- Meta AI. (2024). "Llama 3.3 Model Card." llama.meta.com/ -- Offizielle Llama 3.3 70B-Spezifikationen und VRAM-Anforderungen.
- Meta AI. (2025). "Llama 4 Model Card." llama.meta.com/ -- Llama 4 Scout/Maverick MoE-Architektur, VRAM-Anforderungen.
- Z.ai. (2026). "GLM-5.3: Built for Long-Horizon Tasks." huggingface.co/blog/zai-org/glm-52-blog -- Offizielle GLM-5.3-Modellkarte: 744B-gesamt / 40B-aktiv-MoE-Architektur, MIT-Lizenz, Veroeffentlichungsdatum.