Warum DeepSeek-R1 und seine Distills verwechselt werden
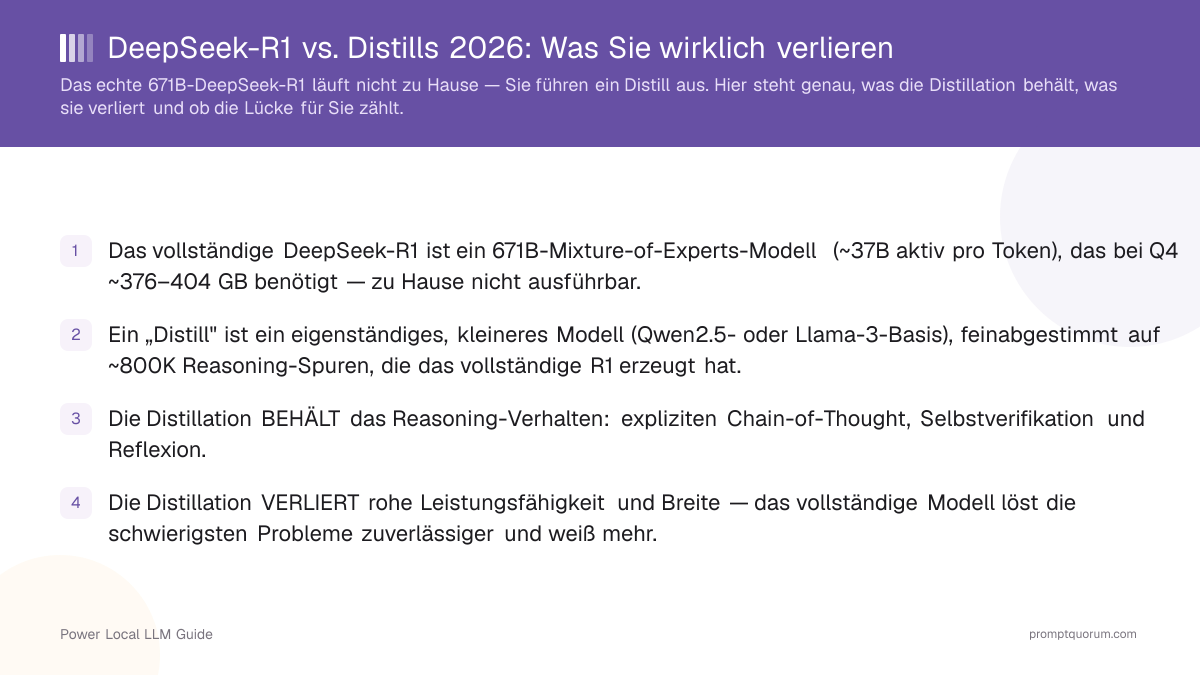
Wenn Sie ollama run deepseek-r1:14b eingeben, führen Sie keine kleinere Version von DeepSeek-R1 aus — Sie führen ein Qwen2.5 14B aus, das gelernt hat, das Reasoning von R1 nachzuahmen. Der Name „DeepSeek-R1-Distill-Qwen-14B" ist präzise, aber leicht falsch zu lesen: Der Teil „DeepSeek-R1" beschreibt, woher das Reasoning stammt, und der Teil „Qwen-14B" ist das tatsächliche Modell, das auf Ihrer GPU läuft.
Das ist wichtig, weil die Erwartungen dem Namen folgen. Man nimmt an, ein Distill sei „R1, nur kleiner und etwas schlechter". Es ist näher an „einem fähigen offenen Modell, das gelernt hat, wie R1 zu denken". Diese Sichtweise sagt das Verhalten voraus, das Sie tatsächlich sehen werden: ausgezeichnete Reasoning-Struktur, gelegentliche Lücken beim rohen Wissen oder bei der Zuverlässigkeit in den schwierigsten Fällen.
Zur Hardware-Realität dahinter, warum das vollständige Modell zu Hause tabu ist, siehe DeepSeek-V3 Lokale Hardware-Anforderungen — V3 ist das Chat-Modell-Geschwister mit demselben 671B-Klassen-Fußabdruck.
Update — DeepSeeks aktuelle Generation ist DeepSeek-V4, nicht R1. V4 (Flash und Pro) ist als offene Gewichte veröffentlicht (V4-Flash: rund 284B Parameter gesamt, 13B aktiv, MIT-Lizenz), gehört aber zur Server-Klasse und ist kein Modell für eine einzelne GPU. Laut DeepSeek-Changelog waren die alten API-Namen deepseek-chat und deepseek-reasoner (die Generationen V3 und R1) zur Abschaltung am 2026-07-24 vorgesehen; die API liefert jetzt die V4-Familie. Ein „gehostetes R1“ meint in diesem Beitrag daher die vollständigen R1-Gewichte bei einem Drittanbieter oder auf einem eigenen Cluster. Die hier behandelten R1-Distillate sind eigenständige Open-Weight-Veröffentlichungen, die von dieser Mitteilung nicht eingestellt wurden und weiterhin lokal laufen — sie sind Modelle der Vorgängergeneration, nicht DeepSeeks neueste Linie.
📍 In einem Satz
Ein DeepSeek-R1-Distill ist ein bestehendes kleines Modell (Qwen2.5 oder Llama 3.1/3.3), das feinabgestimmt wurde, um das Reasoning des vollständigen R1 nachzuahmen — keine verkleinerte Kopie von R1 selbst.
💬 In einfachen Worten
Stellen Sie sich das vollständige R1 als Meistermathematiker vor und ein Distill als begabten Studenten, der die ausgearbeiteten Lösungen des Meisters studiert hat. Der Student argumentiert auf dieselbe Weise, weiß aber nicht alles, was der Meister weiß.
Was ist das vollständige 671B-DeepSeek-R1?
Das vollständige DeepSeek-R1 ist ein Mixture-of-Experts-Modell (MoE) mit 671 Milliarden Parametern, das pro Token rund 37B Parameter aktiviert und bei Q4 etwa 376–404 GB VRAM benötigt — nur Rechenzentrums-Hardware. Es ist das Modell, das das hochwertige Reasoning erzeugt, das die Distills nachahmen lernen.
MoE bedeutet, dass das Modell jedes Token durch eine kleine Teilmenge von „Experten"-Subnetzen leitet, sodass pro Token nur ~37B der 671B-Parameter feuern. Das macht die Inferenz günstiger als bei einem dichten 671B-Modell — aber jeder der 671B-Parameter muss trotzdem im Speicher liegen, weshalb es nicht auf Consumer-Hardware passt.
Von Unsloth gibt es einen dynamischen 1,58-Bit-Build des vollständigen R1 (rund 131 GB), der technisch auf einem Rechner mit mindestens 80 GB kombiniertem VRAM und RAM laufen kann, doch Unsloth selbst nennt Setups mit wenig Speicher „sehr langsam“ und gibt für einen einzelnen Nutzer etwa 14 Token pro Sekunde auf 2x H100 80 GB an. Das ist eine Kuriosität, kein praxistaugliches Heim-Setup. In der Praxis lebt das vollständige R1 in der Cloud und die Distills leben auf Ihrem Rechner.
Wie funktioniert die DeepSeek-R1-Distillation?
DeepSeek erzeugte rund 800.000 Reasoning-Beispiele mit dem vollständigen R1 und stimmte dann bestehende offene Basismodelle — Qwen2.5 (Math-1,5B, Math-7B, 14B, 32B) und Llama 3.x (3.1-8B, 3.3-70B-Instruct) — auf diesen Beispielen fein ab. Die Basismodelle lernen, das schrittweise Reasoning-Muster von R1 zu reproduzieren, ohne jemals die Parameter von R1 zu enthalten.
Dies ist überwachtes Fine-Tuning auf hochwertigen Reasoning-Spuren, kein Reinforcement Learning auf den kleinen Modellen. Die Distills erben die *Form* des Denkens von R1 — wann ein Chain-of-Thought erweitert, wann zurückgegangen, wann verifiziert wird — aufgesetzt auf das, was das Basismodell bereits wusste.
Deshalb ist die Wahl der Basis so wichtig. Ein Distill ist nur so wissensreich wie seine Basis plus die von R1 kopierte Reasoning-Disziplin. Eine schwache Basis mit großartigen Reasoning-Spuren stößt bei der rohen Leistungsfähigkeit dennoch an eine Decke.
📍 In einem Satz
DeepSeek stimmte Qwen2.5- und Llama-3.1/3.3-Basismodelle auf ~800.000 vom vollständigen R1 erzeugten Reasoning-Beispielen fein ab und übertrug so seinen Reasoning-Stil auf kleine Modelle.

Die sechs offiziellen R1-Distills und ihre Basismodelle
DeepSeek hat sechs R1-Distills auf vier Basismodell-Familien veröffentlicht — Qwen2.5-Math, Qwen2.5, Llama 3.1 und Llama 3.3 — und später DeepSeek-R1-0528-Qwen3-8B auf einer Qwen3-Basis ergänzt. Wählen Sie nach Basis und Größe, nicht nach dem „R1“ im Namen.
Distill | Basismodell | AIME 2024 | Ollama-Tag |
|---|---|---|---|
| DeepSeek-R1-Distill-Qwen-1.5B | Qwen2.5-Math-1.5B | 28,9 % | deepseek-r1:1.5b (1,1 GB) |
| DeepSeek-R1-Distill-Qwen-7B | Qwen2.5-Math-7B | 55,5 % | deepseek-r1:7b (4,7 GB) |
| DeepSeek-R1-Distill-Llama-8B | Llama-3.1-8B | 50,4 % | Kein eigener Tag (siehe Hinweis) |
| DeepSeek-R1-Distill-Qwen-14B | Qwen2.5-14B | 69,7 % | deepseek-r1:14b (9,0 GB) |
| DeepSeek-R1-Distill-Qwen-32B | Qwen2.5-32B | 72,6 % | deepseek-r1:32b (20 GB) |
| DeepSeek-R1-Distill-Llama-70B | Llama-3.3-70B-Instruct | 70,0 % | deepseek-r1:70b (43 GB) |
| DeepSeek-R1-0528-Qwen3-8B | Qwen3-8B Base | 86,0 % | deepseek-r1:8b (5,2 GB) |
AIME-2024-pass@1 laut den Hugging-Face-Modellkarten von DeepSeek; der Wert für 0528 stammt aus einer separaten Auswertung, die Abstände zwischen den Zeilen sind daher nur ein Richtwert. Bei AIME 2024 erzielt das 32B einen höheren Wert als das 70B (72,6 % vs. 70,0 %). Alle sechs Distills stehen unter MIT-Lizenz, doch jedes Basismodell behält seine eigene Lizenz (Apache 2.0 für Qwen2.5, Llama-Community-Lizenzen für die Llama-basierten). Der Ollama-Tag deepseek-r1:8b und ein bloßes ollama run deepseek-r1 laden R1-0528-Qwen3-8B — nicht das ursprüngliche Llama-8B-Distill.
Was behält die Distillation?
Die Distillation überträgt zuverlässig die drei Verhaltensweisen, die R1 zu einem starken Reasoner machen: Chain-of-Thought, Selbstverifikation und Reflexion. Diese überleben, weil sie Muster der Token-Generierung sind — und Muster sind genau das, was überwachtes Fine-Tuning gut kopiert.
- Chain-of-Thought: Das Distill schreibt Zwischenschritte vor der endgültigen Antwort aus, der Kern seiner Mathe- und Logikstärke.
- Selbstverifikation: Es prüft seine eigenen Zwischenergebnisse und fängt Fehler mitten im Reasoning ab, nicht erst am Ende.
- Reflexion: Es geht zurück und überdenkt, wenn ein Weg falsch erscheint, statt sich auf den ersten Versuch festzulegen.
- Ergebnis: Laut Modellkarte von DeepSeek erreicht ein 7B-Distill 55,5 % bei AIME 2024.
Was verliert die Distillation?
Die Distillation kann die rohe Leistungsfähigkeit, Wissensbreite oder Zuverlässigkeit des vollständigen 671B-Modells bei den schwierigsten Problemen nicht übertragen — eine kleine Basis hat schlicht weniger Raum, um Informationen zu speichern und zu kombinieren. Je kleiner das Distill, desto größer diese Lücke.
Fähigkeit | Volles 671B R1 | 32B-Distill | 7B-Distill |
|---|---|---|---|
| Reasoning-Struktur (CoT, Reflexion) | Referenz | Sehr nah | Nah |
| Zuverlässigkeit bei schwierigsten Problemen | Höchste | Stark | Mittel |
| Breite des Weltwissens | Höchste | Gut | Begrenzt |
| Lange Probleme mit mehreren Constraints | Beste | Gut | Lässt nach |
| Läuft auf Consumer-Hardware | Nein | Ja (24 GB) | Ja (8 GB) |
Die Einstufungen sind richtungsweisend, nicht benchmark-exakt: Die Lücke ist bei gängigen Reasoning-Aufgaben klein und wächst bei Aufgaben am Rand des Machbaren oder mit breitem Wissensbedarf. Diese Einstufungen sind redaktionelle Einschätzungen von PromptQuorum, keine Messwerte.

Zählt die Lücke für Ihren Anwendungsfall?
Bei den meisten lokalen Reasoning-Aufgaben ist die Lücke klein genug, um sie zu ignorieren; entscheidend wird sie nur bei Problemen am Rand des Machbaren oder bei Aufgaben, die breites Weltwissen erfordern. Entscheiden Sie nach Anwendungsfall, nicht nach der Jagd auf das größte Modell.
Reicht ein Distill aus?
Lokales LLM nutzen, wenn:
- •Schul- und Wettbewerbsmathematik, Logikrätsel, schrittweise Planung → ein Distill genügt vollauf (32B für Reserve, 14B für die meisten Fälle)
- •Privates/Offline-Reasoning, bei dem Daten Ihre Maschine nicht verlassen dürfen → ein lokales Distill hält die Daten auf Ihrer Maschine und passt gut
- •Kostenkontrolle gegenüber einer gehosteten API → ein lokales Distill beseitigt die Kosten pro Token vollständig
Cloud-Modell nutzen, wenn:
- •Forschungsmathematik oder Beweise am Rand des Fachgebiets → das vollständige gehostete R1 ist zuverlässiger
- •Aufgaben, die breites, aktuelles Weltwissen erfordern → ein größeres Modell oder ein suchgestütztes Setup gewinnt
- •Sie brauchen die zuverlässigste Einzelantwort, unabhängig von den Kosten → vergleichen Sie via PromptQuorum mit den Spitzenmodellen
Schnelle Entscheidung:
- →Wenn Sie unsicher sind, führen Sie das 32B-Distill aus und eskalieren Sie nur dann zum gehosteten R1, wenn es sichtbar Mühe hat.
- →Eine größere Basis schlägt am kleinen Ende eine größere Modellgröße — siehe R1-0528-Qwen3-8B unten.
R1-0528-Qwen3-8B: Eine bessere Basis verkleinert die Lücke
DeepSeek-R1-0528-Qwen3-8B zeigt, dass eine stärkere Basis die Distillation-Lücke verkleinert: Auf Qwen3 8B mit Reasoning aus dem aktualisierten R1-0528 aufgebaut, führt es die offenen 8B-Modelle bei AIME 2024 an und liegt etwa 10 Punkte über dem Basis-Qwen3 8B. Dieselbe Größenklasse wie das ursprüngliche 8B-Distill, deutlich besseres Reasoning — weil die Basis besser und die Reasoning-Quelle neuer ist.
Die Lehre für die Wahl eines Distills: Bevorzugen Sie am kleinen Ende das Modell mit der stärkeren, neueren Basis gegenüber einem älteren Distill mit derselben Parameterzahl. Die Leistungsfähigkeit pro Gigabyte steigt durch bessere Basen schneller als durch reine Größe.
Konfig-Tipp: Temperatur 0,6 und kein System-Prompt
Führen Sie jedes DeepSeek-R1-Distill mit Temperatur 0,6 (0,5–0,7 ist sicher) und ohne System-Prompt aus — packen Sie alle Anweisungen in den User-Prompt. Das vermeidet den Fehlermodus aus Wiederholung und Inkohärenz, zu dem die R1-Familie neigt, wenn sie einen System-Prompt oder eine Temperatur nahe 0 oder über ~0,8 erhält.
Wenn Sie ein Distill mit dem vollständigen gehosteten R1 vergleichen und das Distill in Schleifen läuft oder abdriftet, korrigieren Sie die Konfiguration, bevor Sie schließen, das Distill sei schwach — schlechte Sampling-Einstellungen verschleiern seine wahre Qualität.
Ausnahme: DeepSeek-R1-0528-Qwen3-8B akzeptiert einen System-Prompt. Laut Modellkarte ist das erzwungene <think>-Präfix nicht mehr nötig, und die Temperatur 0,6 (top-p 0,95 in DeepSeeks Auswertungen) gilt weiterhin. Die Regel „kein System-Prompt“ betrifft das ursprüngliche R1 und die sechs ursprünglichen Distills.
Häufig gestellte Fragen
Ist ein DeepSeek-R1-Distill dasselbe Modell wie DeepSeek-R1, nur kleiner?
Nein. Ein Distill ist ein anderes Basismodell (Qwen2.5 oder Llama 3.1/3.3), das auf ~800K Beispielen feinabgestimmt wurde, um das Reasoning von R1 nachzuahmen. Es behält den Reasoning-Stil von R1, enthält aber keinen der Parameter von R1.
Was genau behält die Distillation vom vollständigen R1?
Das Reasoning-Verhalten: Chain-of-Thought, Selbstverifikation und Reflexion. Das sind Muster der Token-Generierung, die überwachtes Fine-Tuning zuverlässig überträgt — deshalb erreicht ein 7B-Distill 55,5 % bei AIME 2024.
Was verliert ein Distill gegenüber dem vollständigen 671B-R1?
Rohe Leistungsfähigkeit, Breite des Weltwissens und Zuverlässigkeit bei den schwierigsten Problemen. Je kleiner das Distill, desto größer die Lücke — auch wenn sie bei gängigen Reasoning-Aufgaben klein bleibt.
Warum kann ich das vollständige 671B-DeepSeek-R1 nicht zu Hause ausführen?
Es benötigt bei Q4 ~376–404 GB VRAM, weil alle 671B-Parameter resident sein müssen, obwohl pro Token nur ~37B aktiviert werden. Das ist Rechenzentrums-Hardware. Laut Unsloth gibt es einen dynamischen 1,58-Bit-Build, der auf Consumer-Hardware aber sehr langsam ist — eine Kuriosität, kein praxistaugliches Setup.
Zählt die Lücke im Alltag?
Meist nicht. Für Schul- und Wettbewerbsmathematik, Logik und mehrstufige Planung genügt ein 14B- oder 32B-Distill vollauf. Die Lücke zählt bei Problemen am Rand des Machbaren oder bei Aufgaben, die breites, aktuelles Wissen erfordern.
Welches Distill ist dem vollständigen R1 am nächsten?
Das 70B-Distill ist das größte der sechs und in roher Leistungsfähigkeit am nächsten, benötigt aber Dual-GPU und liegt bei AIME 2024 unter dem 32B (70,0 % vs. 72,6 %). Das 32B ist unter den sechs die stärkste Single-GPU-Option bei AIME 2024, und laut Modellkarte von DeepSeek übertrifft es OpenAI o1-mini in verschiedenen Benchmarks.
Warum ist R1-0528-Qwen3-8B besser als das ursprüngliche 8B-Distill?
Es nutzt eine stärkere Qwen3-8B-Basis und Reasoning aus dem aktualisierten R1-0528, sodass es die offenen 8B-Modelle bei AIME 2024 anführt — etwa 10 Punkte über dem Basis-Qwen3 8B bei gleicher Größe.
Ist DeepSeek-V3 ein Distill von R1?
Nein. DeepSeek-V3 ist ein eigenständiges 671B-MoE-Chat-Modell, kein Reasoning-Modell und kein Distill. R1 ist das Reasoning-Modell; die Distills ahmen R1 nach, nicht V3.
Was ist der Unterschied zwischen DeepSeek-R1 und DeepSeek-R1-Distill?
DeepSeek-R1 ist das 671B-Mixture-of-Experts-Reasoning-Modell; ein DeepSeek-R1-Distill-Modell ist ein kleineres Qwen- oder Llama-Modell, das auf von R1 erzeugten Reasoning-Beispielen feinabgestimmt wurde. Der Name nennt die Quelle (R1) und die Basis (Qwen oder Llama) — und die Basis bestimmt die Wissensgrenze.
Welcher Ollama-Tag entspricht welchem DeepSeek-R1-Distill?
Die Tags 1.5b, 7b, 14b, 32b und 70b entsprechen den jeweiligen Qwen- oder Llama-basierten Distills, 671b ist das vollständige R1. Der Tag 8b — den auch ein bloßes ollama run deepseek-r1 lädt — ist DeepSeek-R1-0528-Qwen3-8B, nicht das ursprüngliche Llama-8B-Distill.
Ist DeepSeek-R1 noch das neueste Modell von DeepSeek?
Nein. DeepSeeks aktuelle Generation ist DeepSeek-V4 (Flash und Pro), veröffentlicht als offene Gewichte. R1 und V3 sind Modelle der Vorgängergeneration; laut Changelog waren die API-Namen deepseek-chat und deepseek-reasoner zur Abschaltung am 2026-07-24 vorgesehen. Die R1-Distillate sind eigenständige Open-Weight-Veröffentlichungen, die diese Mitteilung nicht eingestellt hat, daher laufen sie weiterhin lokal — sie sind lediglich nicht mehr DeepSeeks neueste Linie.
Update-Protokoll
- Veröffentlicht am 19.06.2026. Nächste Überprüfung fällig am 19.06.2027 (jährliche Freshness-Stufe — zeitloser Explainer mit jahresgebundenen Modellfakten).
- Behandelt das vollständige 671B-R1 gegenüber den sechs offiziellen Distills und DeepSeek-R1-0528-Qwen3-8B. Nur reasoning-interner Vergleich; modellübergreifende Coding-Vergleiche stehen im Coding-Leitfaden.
- Aktualisiert am 19.10.2026: Referenztabelle der sechs Distills (Basismodelle, AIME 2024, Ollama-Tags) ergänzt, Liste der Basismodelle korrigiert, klargestellt, dass der Tag deepseek-r1:8b R1-0528-Qwen3-8B ist, und dessen System-Prompt-Ausnahme vermerkt.
- Aktualisiert am 2026-10-19 (Generationsprüfung): DeepSeek-V4 als aktuelle Generation und R1/V3 als Vorgängergeneration kenntlich gemacht, die R1-Distillate als eigenständige, weiterhin lokal nutzbare Open-Weight-Veröffentlichungen eingeordnet und die Llama-3-Basismodell-Angaben zu Llama 3.1/3.3 präzisiert.