Por que as pessoas confundem o DeepSeek-R1 com seus distills
Quando você digita ollama run deepseek-r1:14b, você não está rodando uma versão menor do DeepSeek-R1 — está rodando o Qwen2.5 14B ensinado a imitar o raciocínio do R1. O nome "DeepSeek-R1-Distill-Qwen-14B" é preciso, mas fácil de ler errado: a parte "DeepSeek-R1" descreve de onde veio o raciocínio, e a parte "Qwen-14B" é o modelo de fato rodando na sua GPU.
Isso importa porque as expectativas seguem o nome. As pessoas presumem que um distill é "o R1, só que menor e um pouco pior". Ele está mais perto de "um modelo aberto capaz que aprendeu a pensar como o R1". Esse enquadramento prevê o comportamento que você realmente verá: excelente estrutura de raciocínio, lacunas pontuais em conhecimento bruto ou na confiabilidade dos casos mais difíceis.
Para a realidade de hardware por trás do motivo de o modelo completo ser inviável em casa, veja Requisitos de hardware local do DeepSeek-V3 — o V3 é o modelo de chat irmão com a mesma pegada de classe 671B.
Atualização — a geração atual da DeepSeek é o DeepSeek-V4, não o R1. O V4 (Flash e Pro) é publicado com pesos abertos (V4-Flash: cerca de 284B de parâmetros no total, 13B ativos, licença MIT), mas é de classe servidor, não um modelo para uma única GPU. O changelog da DeepSeek programou para 2026-07-24 a descontinuação dos antigos nomes de API deepseek-chat e deepseek-reasoner (as gerações V3 e R1); a API agora serve a família V4. Por isso, um "R1 hospedado" neste artigo significa os pesos completos do R1 em um provedor terceiro ou no seu próprio cluster. As destilações do R1 tratadas aqui são lançamentos de pesos abertos independentes, que esse aviso não aposentou e que continuam rodando localmente — são modelos da geração anterior, não a linha mais nova da DeepSeek.
📍 Em uma frase
Um distill do DeepSeek-R1 é um modelo pequeno existente (Qwen2.5 ou Llama 3.1/3.3) ajustado para imitar o raciocínio do R1 completo, não uma cópia reduzida do próprio R1.
💬 Em termos simples
Pense no R1 completo como um matemático experiente e em um distill como um aluno brilhante que estudou as soluções resolvidas do mestre. O aluno raciocina da mesma forma, mas não sabe tudo o que o mestre sabe.
O que é o DeepSeek-R1 671B completo?
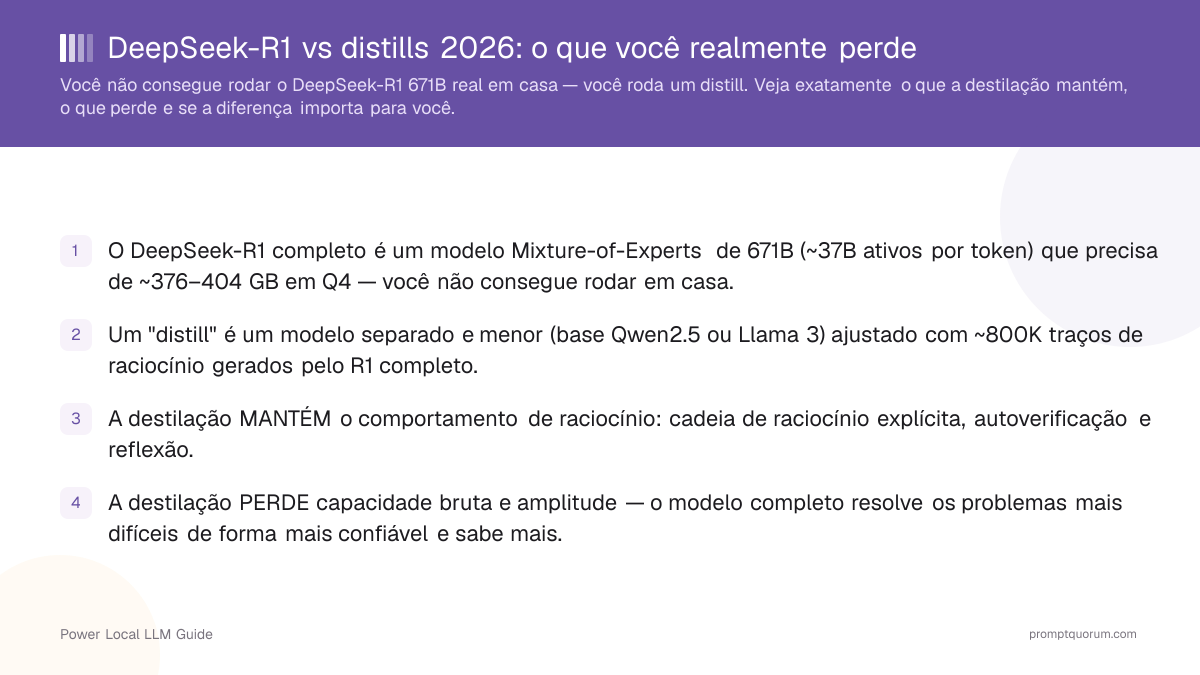
O DeepSeek-R1 completo é um modelo Mixture-of-Experts (MoE) de 671 bilhões de parâmetros que ativa cerca de 37B parâmetros por token e precisa de cerca de 376–404 GB de VRAM em Q4 — só hardware de data center. É o modelo que gera o raciocínio de alta qualidade que os distills aprendem a imitar.
MoE significa que o modelo roteia cada token por um pequeno subconjunto de sub-redes "especialistas", de modo que apenas ~37B dos 671B parâmetros são disparados por token. Isso torna a inferência mais barata do que num modelo denso de 671B — mas cada um dos 671B parâmetros ainda precisa estar residente na memória, e é por isso que ele não cabe em hardware de consumo.
Existe uma versão dinâmica de 1.58 bits do R1 completo, da Unsloth (cerca de 131 GB), que tecnicamente pode rodar em uma máquina com 80 GB ou mais somando VRAM e RAM, mas a própria Unsloth chama de "muito lentas" as configurações com pouca memória e cita cerca de 14 tokens por segundo para um único usuário em 2x H100 80 GB. É uma curiosidade, não um setup doméstico prático. Na prática, o R1 completo mora na nuvem e os distills moram na sua máquina.
Como funciona a destilação do DeepSeek-R1?
A DeepSeek gerou cerca de 800.000 amostras de raciocínio com o R1 completo e então ajustou modelos base abertos existentes — Qwen2.5 (Math-1.5B, Math-7B, 14B, 32B) e Llama 3.x (3.1-8B, 3.3-70B-Instruct) — com essas amostras. Os modelos base aprendem a reproduzir o padrão de raciocínio passo a passo do R1 sem nunca conter os parâmetros do R1.
Isso é ajuste fino supervisionado sobre traços de raciocínio de alta qualidade, não aprendizado por reforço nos modelos pequenos. Os distills herdam a *forma* do pensamento do R1 — quando expandir uma cadeia de raciocínio, quando recuar, quando verificar — sobreposta ao que o modelo base já sabia.
É por isso que a escolha da base importa tanto. Um distill é tão conhecedor quanto a sua base, mais a disciplina de raciocínio copiada do R1. Uma base fraca com ótimos traços de raciocínio ainda esbarra num teto de capacidade bruta.
📍 Em uma frase
A DeepSeek ajustou os modelos base Qwen2.5 e Llama 3.1/3.3 com ~800.000 amostras de raciocínio geradas pelo R1 completo, transferindo seu estilo de raciocínio para modelos pequenos.

Os seis distills oficiais do R1 e seus modelos base
A DeepSeek publicou seis distills do R1 sobre quatro famílias de modelos base — Qwen2.5-Math, Qwen2.5, Llama 3.1 e Llama 3.3 — e depois acrescentou o DeepSeek-R1-0528-Qwen3-8B sobre uma base Qwen3. Escolha pela base e pelo tamanho, não pelo «R1» no nome.
Distill | Modelo base | AIME 2024 | Tag do Ollama |
|---|---|---|---|
| DeepSeek-R1-Distill-Qwen-1.5B | Qwen2.5-Math-1.5B | 28.9% | deepseek-r1:1.5b (1.1 GB) |
| DeepSeek-R1-Distill-Qwen-7B | Qwen2.5-Math-7B | 55.5% | deepseek-r1:7b (4.7 GB) |
| DeepSeek-R1-Distill-Llama-8B | Llama-3.1-8B | 50.4% | Sem tag própria (veja a nota) |
| DeepSeek-R1-Distill-Qwen-14B | Qwen2.5-14B | 69.7% | deepseek-r1:14b (9.0 GB) |
| DeepSeek-R1-Distill-Qwen-32B | Qwen2.5-32B | 72.6% | deepseek-r1:32b (20 GB) |
| DeepSeek-R1-Distill-Llama-70B | Llama-3.3-70B-Instruct | 70.0% | deepseek-r1:70b (43 GB) |
| DeepSeek-R1-0528-Qwen3-8B | Qwen3-8B Base | 86.0% | deepseek-r1:8b (5.2 GB) |
pass@1 do AIME 2024 conforme os cartões de modelo da DeepSeek no Hugging Face; o número do 0528 vem de uma avaliação separada, então leia as diferenças entre linhas como indicativas. O de 32B pontua mais que o de 70B no AIME 2024 (72.6% contra 70.0%). Os seis distills têm licença MIT, mas cada modelo base mantém a sua (Apache 2.0 para o Qwen2.5, licenças comunitárias da Llama para os baseados em Llama). A tag deepseek-r1:8b do Ollama, e um simples ollama run deepseek-r1, baixam o R1-0528-Qwen3-8B — não o distill Llama-8B original.
O que a destilação mantém?
A destilação transfere de forma confiável os três comportamentos que tornam o R1 um raciocinador forte: cadeia de raciocínio, autoverificação e reflexão. Eles sobrevivem porque são padrões de geração de tokens, e padrões são exatamente o que o ajuste fino supervisionado copia bem.
- Cadeia de raciocínio: o distill escreve os passos intermediários antes da resposta final, o núcleo da sua força em matemática e lógica.
- Autoverificação: ele checa os próprios resultados intermediários e pega erros no meio do raciocínio, não só no fim.
- Reflexão: ele recua e reconsidera quando um caminho parece errado, em vez de se prender à primeira tentativa.
- Resultado: segundo a ficha do modelo da DeepSeek, um distill de 7B alcança 55.5% no AIME 2024.
O que a destilação perde?
A destilação não consegue transferir a capacidade bruta, a amplitude de conhecimento ou a confiabilidade do modelo 671B completo nos problemas mais difíceis — uma base pequena simplesmente tem menos espaço para armazenar e combinar informação. Quanto menor o distill, maior essa diferença.
Capacidade | R1 671B completo | Distill 32B | Distill 7B |
|---|---|---|---|
| Estrutura de raciocínio (CoT, reflexão) | Referência | Muito próximo | Próximo |
| Confiabilidade nos problemas mais difíceis | A mais alta | Forte | Moderada |
| Amplitude de conhecimento do mundo | A mais alta | Boa | Limitada |
| Problemas longos com várias restrições | A melhor | Boa | Degrada |
| Roda em hardware de consumo | Não | Sim (24 GB) | Sim (8 GB) |
As classificações são direcionais, não exatas por benchmark: a diferença é pequena em tarefas de raciocínio comuns e cresce em trabalho de dificuldade de fronteira ou de conhecimento amplo. Essas avaliações são julgamentos editoriais da PromptQuorum, não medições.

A diferença importa para o seu caso de uso?
Para a maioria do raciocínio local a diferença é pequena o suficiente para ser ignorada; ela só se torna decisiva em problemas de dificuldade de fronteira ou tarefas que exigem amplo conhecimento do mundo. Decida pelo caso de uso, não correndo atrás do maior modelo.
Um distill é bom o suficiente?
Use um LLM local se:
- •Matemática escolar e de competição, quebra-cabeças de lógica, planejamento passo a passo → um distill basta de sobra (32B para folga, 14B para a maioria)
- •Raciocínio privado/offline em que os dados não podem sair da sua máquina → um distill local mantém os dados na sua máquina e se encaixa bem
- •Controle de custos diante de uma API hospedada → um distill local elimina por completo o custo por token
Use um modelo em nuvem se:
- •Matemática de pesquisa ou provas na fronteira da área → o R1 completo hospedado é mais confiável
- •Tarefas que exigem conhecimento do mundo amplo e atual → um modelo maior ou um setup com busca aumentada vence
- •Você precisa da única resposta mais confiável independentemente do custo → compare com modelos de fronteira via PromptQuorum
Decisão rápida:
- →Na dúvida, rode o distill de 32B e só escale para o R1 hospedado quando ele claramente tiver dificuldade.
- →Uma base maior vence um tamanho maior na ponta pequena — veja o R1-0528-Qwen3-8B abaixo.
R1-0528-Qwen3-8B: uma base melhor reduz a diferença
O DeepSeek-R1-0528-Qwen3-8B mostra que uma base mais forte encolhe a diferença da destilação: construído sobre o Qwen3 8B com raciocínio do R1-0528 atualizado, ele lidera os modelos abertos de 8B no AIME 2024 e pontua cerca de 10 pontos acima do Qwen3 8B base. Mesma classe de tamanho do distill 8B original, com raciocínio materialmente melhor — porque a base é melhor e a fonte de raciocínio é mais nova.
A lição para escolher um distill: na ponta pequena, prefira o modelo com a base mais forte e mais nova em vez de um distill mais antigo com a mesma contagem de parâmetros. A capacidade por gigabyte sobe mais rápido com bases melhores do que com tamanho bruto.
Dica de config: temperatura 0.6 e sem prompt de sistema
Rode cada distill do DeepSeek-R1 em temperatura 0.6 (0.5–0.7 é seguro) sem prompt de sistema — coloque todas as instruções no prompt de usuário. Isso evita o modo de falha de repetição e incoerência ao qual a família R1 é propensa quando recebe um prompt de sistema ou uma temperatura perto de 0 ou acima de ~0.8.
Se você está comparando um distill com o R1 completo hospedado e o distill entra em loop ou desvia, conserte a configuração antes de concluir que o distill é fraco — configurações ruins de amostragem mascaram a sua qualidade real.
Exceção: o DeepSeek-R1-0528-Qwen3-8B aceita prompt de sistema. O cartão do modelo diz que o prefixo <think> forçado não é mais necessário, e a temperatura 0.6 (top-p 0.95 nas avaliações da DeepSeek) continua valendo. A regra de «sem prompt de sistema» vale para o R1 original e os seis distills originais.
Perguntas frequentes
Um distill do DeepSeek-R1 é o mesmo modelo que o DeepSeek-R1, só que menor?
Não. Um distill é um modelo base diferente (Qwen2.5 ou Llama 3.1/3.3) ajustado para imitar o raciocínio do R1 com ~800K amostras. Ele mantém o estilo de raciocínio do R1, mas não contém nenhum dos parâmetros do R1.
O que exatamente a destilação mantém do R1 completo?
O comportamento de raciocínio: cadeia de raciocínio, autoverificação e reflexão. São padrões de geração de tokens que o ajuste fino supervisionado transfere de forma confiável, por isso um distill de 7B chega a 55.5% no AIME 2024.
O que um distill perde em relação ao R1 671B completo?
Capacidade bruta, amplitude de conhecimento do mundo e confiabilidade nos problemas mais difíceis. Quanto menor o distill, maior a diferença — embora ela continue pequena em tarefas de raciocínio comuns.
Por que não consigo rodar o DeepSeek-R1 671B completo em casa?
Ele precisa de ~376–404 GB de VRAM em Q4 porque todos os 671B parâmetros precisam estar residentes mesmo que só ~37B sejam ativados por token. Isso é hardware de data center. Segundo a Unsloth, existe um build dinâmico de 1.58 bits, mas ele é muito lento em hardware de consumo — uma curiosidade, não um setup prático.
A diferença importa para o uso cotidiano?
Normalmente não. Para matemática escolar e de competição, lógica e planejamento em várias etapas, um distill de 14B ou 32B basta de sobra. A diferença importa em problemas de dificuldade de fronteira ou tarefas que exigem conhecimento amplo e atual.
Qual distill é o mais próximo do R1 completo?
O distill de 70B é o maior dos seis e o mais próximo em capacidade bruta, mas precisa de GPU dupla e pontua abaixo do de 32B no AIME 2024 (70.0% contra 72.6%). O de 32B é a opção de GPU única mais forte dos seis no AIME 2024, e a ficha do modelo da DeepSeek informa que ele supera o OpenAI o1-mini em vários benchmarks.
Por que o R1-0528-Qwen3-8B é melhor que o distill 8B original?
Ele usa uma base Qwen3 8B mais forte e raciocínio do R1-0528 atualizado, por isso lidera os modelos abertos de 8B no AIME 2024 — cerca de 10 pontos acima do Qwen3 8B base no mesmo tamanho.
O DeepSeek-V3 é um distill do R1?
Não. O DeepSeek-V3 é um modelo de chat MoE de 671B separado, não um modelo de raciocínio nem um distill. O R1 é o modelo de raciocínio; os distills imitam o R1, não o V3.
Qual é a diferença entre DeepSeek-R1 e DeepSeek-R1-Distill?
O DeepSeek-R1 é o modelo de raciocínio Mixture-of-Experts de 671B; um modelo DeepSeek-R1-Distill é um modelo Qwen ou Llama menor, ajustado com amostras de raciocínio geradas pelo R1. O nome informa a origem (R1) e a base (Qwen ou Llama), e a base define o teto de conhecimento.
Qual tag do Ollama corresponde a qual distill do DeepSeek-R1?
As tags 1.5b, 7b, 14b, 32b e 70b correspondem aos distills baseados em Qwen ou Llama do mesmo tamanho, e 671b é o R1 completo. A tag 8b — que um simples ollama run deepseek-r1 também baixa — é o DeepSeek-R1-0528-Qwen3-8B, não o distill Llama-8B original.
O DeepSeek-R1 ainda é o modelo mais novo da DeepSeek?
Não. A geração atual da DeepSeek é o DeepSeek-V4 (Flash e Pro), publicado com pesos abertos. R1 e V3 são modelos da geração anterior, e o changelog da DeepSeek programou para 2026-07-24 a descontinuação dos nomes de API deepseek-chat e deepseek-reasoner. As destilações do R1 são lançamentos de pesos abertos independentes que esse aviso não aposentou, então continuam rodando localmente; só deixaram de ser a linha mais nova da DeepSeek.
Registro de atualizações
- Publicado em 19/06/2026. Próxima revisão prevista para 19/06/2027 (nível de atualização anual — explicação duradoura com fatos de modelos ancorados ao ano).
- Cobre o R1 671B completo diante dos seis distills oficiais e do DeepSeek-R1-0528-Qwen3-8B. Apenas comparação interna de raciocínio; as comparações de código entre modelos estão no guia de código.
- Atualizado em 19/10/2026: adicionada a tabela de referência dos seis distills (modelos base, AIME 2024, tags do Ollama), corrigida a lista de modelos base, esclarecido que a tag deepseek-r1:8b é o R1-0528-Qwen3-8B e registrada a sua exceção de prompt de sistema.
- Atualizado em 2026-10-19 (verificação de geração): indicado que o DeepSeek-V4 é a geração atual e R1/V3 são da geração anterior, que as destilações do R1 são lançamentos de pesos abertos independentes ainda válidos para rodar localmente, e as referências aos modelos base Llama 3 foram precisadas como Llama 3.1/3.3.