为什么人们会混淆 DeepSeek-R1 和它的蒸馏版
当你输入 ollama run deepseek-r1:14b 时,你运行的并不是 DeepSeek-R1 的较小版本,而是被教会模仿 R1 推理的 Qwen2.5 14B。 名称 “DeepSeek-R1-Distill-Qwen-14B” 很精确但容易误读:“DeepSeek-R1” 部分描述推理来自哪里,而 “Qwen-14B” 部分才是真正运行在你 GPU 上的模型。
这一点很重要,因为预期会跟着名称走。人们以为蒸馏版是 “R1,只是更小、稍差”。它更接近 “一个学会像 R1 一样思考的有能力的开源模型”。这种理解能预测你实际会看到的行为:出色的推理结构,偶尔在原始知识或最难情形可靠性上的缺口。
关于完整模型为何在家无法使用的硬件现实,参见 DeepSeek-V3 本地硬件要求——V3 是同属 671B 级别占用的对话模型兄弟。
更新:DeepSeek 当前一代是 DeepSeek-V4,而不是 R1。 V4(Flash 与 Pro)以开放权重发布(V4-Flash:总参数约 284B,激活参数 13B,MIT 许可证),但属于服务器级,并非单 GPU 模型。DeepSeek 的更新日志已将旧 API 名称 deepseek-chat 与 deepseek-reasoner(V3 与 R1 世代)安排在 2026-07-24 停用,API 现已提供 V4 系列。因此,本文所说的“托管 R1”指第三方托管或自建集群上的完整 R1 权重。本文介绍的 R1 蒸馏模型是独立发布的开放权重模型,该通知并未将其下线,仍可在本地运行——但它们属于上一代模型,并非 DeepSeek 最新一代产品。
📍 简单一句话
DeepSeek-R1 蒸馏版是一个被微调以模仿完整 R1 推理的现有小模型(Qwen2.5 或 Llama 3.1/3.3),而不是 R1 本身的缩小副本。
💬 简单来说
把完整 R1 想象成一位数学大师,把蒸馏版想象成钻研过大师详解的优等生。学生用同样的方式推理,但并不知道大师所知的一切。
什么是完整的 671B DeepSeek-R1?
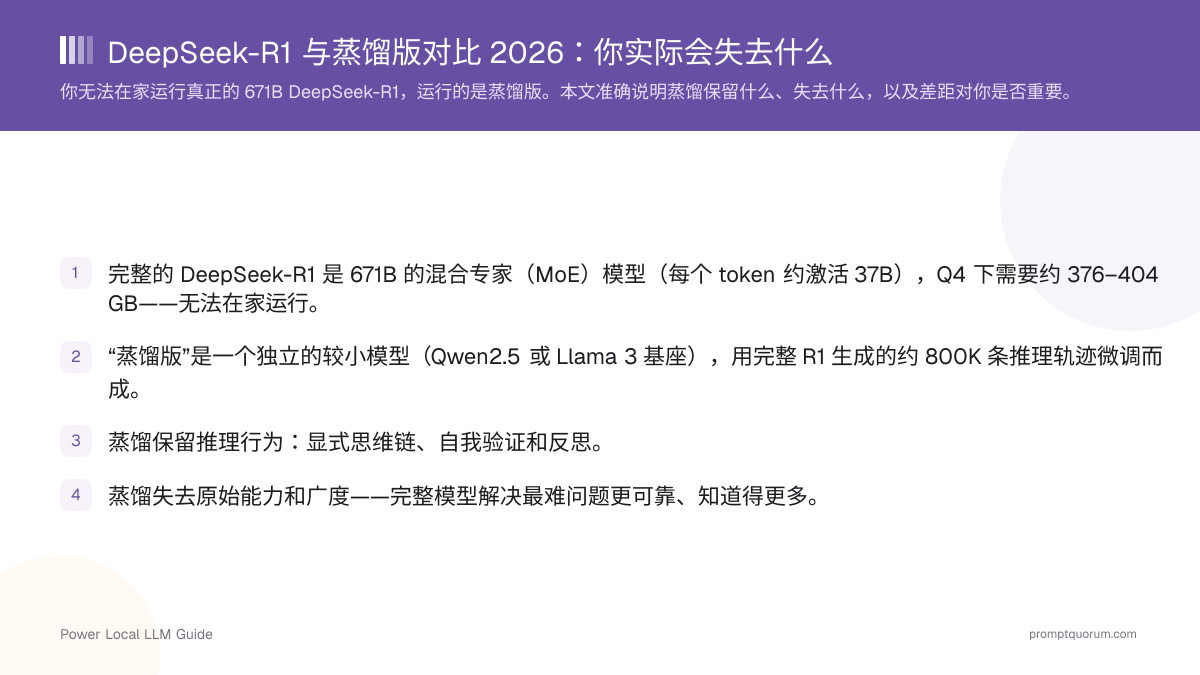
完整的 DeepSeek-R1 是一个 6710 亿参数的混合专家(MoE)模型,每个 token 约激活 37B 参数,Q4 下需要约 376–404 GB 显存——仅限数据中心硬件。 它正是生成那些高质量推理、供蒸馏版学习模仿的模型。
MoE 意味着模型把每个 token 路由到一小部分 “专家” 子网络,因此 671B 参数中每个 token 只有约 37B 被激活。这让推理比稠密的 671B 模型更便宜——但 671B 中的每个参数仍必须常驻内存,这正是它无法装入消费级硬件的原因。
Unsloth 提供了完整 R1 的 1.58 位动态量化版本(约 131 GB),在显存与内存合计至少 80 GB 的机器上技术上可以运行,但 Unsloth 自己的说明称低内存配置“非常慢”,并给出在 2x H100 80 GB 上单用户推理约每秒 14 个 token。它只是个新奇玩意儿,而非实用的家用配置。从实用角度看,完整 R1 在云端,蒸馏版在你的机器上。
DeepSeek-R1 的蒸馏如何运作?
DeepSeek 用完整 R1 生成了约 800,000 条推理样本,然后在这些样本上微调现有的开源基座模型——Qwen2.5(Math-1.5B、Math-7B、14B、32B)和 Llama 3.x(3.1-8B、3.3-70B-Instruct)。 基座模型学会复现 R1 的逐步推理模式,却从不包含 R1 的参数。
这是在高质量推理轨迹上的监督微调,而不是对小模型做强化学习。蒸馏版继承了 R1 思考的*形式*——何时展开思维链、何时回溯、何时验证——叠加在基座模型已有的知识之上。
这就是为什么基座选择如此重要。蒸馏版的知识水平只取决于它的基座,再加上从 R1 复制来的推理纪律。基座弱、即便有优秀的推理轨迹,在原始能力上仍会触及天花板。
📍 简单一句话
DeepSeek 在完整 R1 生成的约 800,000 条推理样本上微调 Qwen2.5 和 Llama 3.1/3.3 基座模型,将其推理风格迁移到小模型上。

六个官方 R1 蒸馏版及其基座模型
DeepSeek 基于四个基座模型系列——Qwen2.5-Math、Qwen2.5、Llama 3.1 和 Llama 3.3——发布了六个 R1 蒸馏版,后来又增加了基于 Qwen3 的 DeepSeek-R1-0528-Qwen3-8B。 请按基座和规模选择,而不是看名字里的“R1”。
蒸馏版 | 基座模型 | AIME 2024 | Ollama 标签 |
|---|---|---|---|
| DeepSeek-R1-Distill-Qwen-1.5B | Qwen2.5-Math-1.5B | 28.9% | deepseek-r1:1.5b (1.1 GB) |
| DeepSeek-R1-Distill-Qwen-7B | Qwen2.5-Math-7B | 55.5% | deepseek-r1:7b (4.7 GB) |
| DeepSeek-R1-Distill-Llama-8B | Llama-3.1-8B | 50.4% | 无专属标签(见备注) |
| DeepSeek-R1-Distill-Qwen-14B | Qwen2.5-14B | 69.7% | deepseek-r1:14b (9.0 GB) |
| DeepSeek-R1-Distill-Qwen-32B | Qwen2.5-32B | 72.6% | deepseek-r1:32b (20 GB) |
| DeepSeek-R1-Distill-Llama-70B | Llama-3.3-70B-Instruct | 70.0% | deepseek-r1:70b (43 GB) |
| DeepSeek-R1-0528-Qwen3-8B | Qwen3-8B Base | 86.0% | deepseek-r1:8b (5.2 GB) |
AIME 2024 pass@1 取自 DeepSeek 的 Hugging Face 模型卡;0528 的数字来自另一套评测,因此行与行之间的差距仅供参考。在 AIME 2024 上 32B 高于 70B(72.6% 对 70.0%)。六个蒸馏版均为 MIT 许可,但各基座模型保留自己的许可(Qwen2.5 为 Apache 2.0,基于 Llama 的蒸馏版适用 Llama 社区许可)。Ollama 的 deepseek-r1:8b 标签以及不带标签的 ollama run deepseek-r1 拉取的是 R1-0528-Qwen3-8B,而不是最初的 Llama-8B 蒸馏版。
蒸馏保留了什么?
蒸馏可靠地迁移了让 R1 成为强推理器的三种行为:思维链、自我验证和反思。 它们之所以得以保留,是因为它们是 token 生成的模式,而模式正是监督微调擅长复制的东西。
- 思维链:蒸馏版在给出最终答案前写出中间步骤,这是其数学和逻辑实力的核心。
- 自我验证:它检查自己的中间结果,在推理过程中而非仅在末尾捕捉错误。
- 反思:当某条路径看起来不对时,它会回溯并重新考虑,而不是固守第一次尝试。
- 结果:据 DeepSeek 的模型卡,7B 蒸馏版在 AIME 2024 上取得 55.5%。
蒸馏失去了什么?
蒸馏无法迁移完整 671B 模型的原始能力、知识广度,或在最难问题上的可靠性——小基座存储和组合信息的空间本就更少。 蒸馏版越小,这一差距越大。
能力 | 完整 671B R1 | 32B 蒸馏版 | 7B 蒸馏版 |
|---|---|---|---|
| 推理结构(CoT、反思) | 基准 | 非常接近 | 接近 |
| 最难问题上的可靠性 | 最高 | 强 | 中等 |
| 世界知识广度 | 最高 | 良好 | 有限 |
| 长且多约束的问题 | 最佳 | 良好 | 会下降 |
| 可在消费级硬件运行 | 否 | 是(24 GB) | 是(8 GB) |
这些排名是方向性的,而非基准精确值:差距在常见推理任务上很小,在前沿难度或需要广博知识的工作上会增大。这些评级是 PromptQuorum 的编辑判断,而非测量值。

差距对你的使用场景重要吗?
对大多数本地推理而言,差距小到可以忽略;只有在前沿难度问题或需要广博世界知识的任务上才会变得关键。 按使用场景决定,而不是一味追求最大的模型。
蒸馏版够用吗?
以下情况使用本地LLM:
- •中小学和竞赛数学、逻辑谜题、逐步规划 → 蒸馏版足够(要余量用 32B,多数情况 14B)
- •数据不能离开你机器的私密/离线推理 → 本地蒸馏版能把数据留在你的机器上,是很合适的选择
- •相对托管 API 的成本控制 → 本地蒸馏版彻底消除按 token 计费的成本
以下情况使用云端模型:
- •处于领域前沿的研究数学或证明 → 完整的托管 R1 更可靠
- •需要广博、最新世界知识的任务 → 更大的模型或搜索增强配置更胜一筹
- •不计成本也要最可靠的单一答案 → 通过 PromptQuorum 与前沿模型对比
快速决策:
- →拿不准就运行 32B 蒸馏版,只有当它明显吃力时才升级到托管 R1。
- →在小模型这一端,更大的基座胜过更大的尺寸——参见下文的 R1-0528-Qwen3-8B。
R1-0528-Qwen3-8B:更好的基座缩小差距
DeepSeek-R1-0528-Qwen3-8B 表明更强的基座会缩小蒸馏差距:它构建于 Qwen3 8B 之上,采用更新版 R1-0528 的推理,在 AIME 2024 上领先开源 8B 模型,比基座 Qwen3 8B 高出约 10 分。 与最初的 8B 蒸馏版同属一个尺寸级别,但推理明显更好——因为基座更好、推理来源更新。
选择蒸馏版的启示:在小模型这一端,宁选基座更强、更新的模型,也不选同等参数量的较旧蒸馏版。每 GB 的能力,靠更好的基座提升得比靠纯尺寸更快。
配置小贴士:温度 0.6,不带系统提示词
每个 DeepSeek-R1 蒸馏版都应在温度 0.6(0.5–0.7 安全)、不带系统提示词的情况下运行——把所有指令放进用户提示词。 这样可以避免 R1 系列在被给定系统提示词、或温度接近 0、或高于约 0.8 时容易出现的重复与不连贯失败模式。
如果你在把蒸馏版和完整托管 R1 对比,而蒸馏版出现循环或跑偏,请先修正配置,再下结论说蒸馏版很弱——糟糕的采样设置会掩盖它真实的质量。
例外:DeepSeek-R1-0528-Qwen3-8B 接受系统提示词。 其模型卡说明不再需要强制的 <think> 前缀,温度 0.6(DeepSeek 评测中 top-p 为 0.95)依然适用。“不带系统提示词”的规则针对原始 R1 和六个原始蒸馏版。
常见问题
DeepSeek-R1 蒸馏版和 DeepSeek-R1 是同一个模型、只是更小吗?
不是。蒸馏版是另一个基座模型(Qwen2.5 或 Llama 3.1/3.3),在约 800K 样本上微调以模仿 R1 的推理。它保留 R1 的推理风格,但不含 R1 的任何参数。
蒸馏究竟从完整 R1 保留了什么?
推理行为:思维链、自我验证和反思。这些是监督微调能可靠迁移的 token 生成模式,这正是 7B 蒸馏版能在 AIME 2024 上达到 55.5% 的原因。
蒸馏版相比完整 671B R1 失去了什么?
原始能力、世界知识广度,以及在最难问题上的可靠性。蒸馏版越小差距越大——不过在常见推理任务上它仍然很小。
为什么我不能在家运行完整的 671B DeepSeek-R1?
它在 Q4 下需要约 376–404 GB 显存,因为即便每个 token 只激活约 37B,全部 671B 参数也必须常驻内存。那是数据中心硬件。据 Unsloth 称,存在 1.58 位动态量化版本,但在消费级硬件上非常慢——只是新奇,不实用。
差距对日常使用重要吗?
通常不重要。对中小学和竞赛数学、逻辑和多步规划,14B 或 32B 蒸馏版足够。差距重要的是前沿难度问题,或需要广博、最新知识的任务。
哪个蒸馏版最接近完整 R1?
70B 蒸馏版是六者中最大、原始能力最接近的,但需要双 GPU,并且在 AIME 2024 上低于 32B(70.0% 对 72.6%)。32B 是六者中在 AIME 2024 上最强的单 GPU 选择,DeepSeek 的模型卡称其在多项基准上优于 OpenAI o1-mini。
为什么 R1-0528-Qwen3-8B 比最初的 8B 蒸馏版更好?
它使用更强的 Qwen3 8B 基座和更新版 R1-0528 的推理,因此在 AIME 2024 上领先开源 8B 模型——在同等尺寸下比基座 Qwen3 8B 高出约 10 分。
DeepSeek-V3 是 R1 的蒸馏版吗?
不是。DeepSeek-V3 是一个独立的 671B MoE 对话模型,既不是推理模型,也不是蒸馏版。R1 才是推理模型;蒸馏版模仿的是 R1,而不是 V3。
DeepSeek-R1 与 DeepSeek-R1-Distill 有什么区别?
DeepSeek-R1 是 671B 的混合专家推理模型;DeepSeek-R1-Distill 模型则是在 R1 生成的推理样本上微调的、更小的 Qwen 或 Llama 模型。名称给出了来源(R1)和基座(Qwen 或 Llama),而基座决定了知识上限。
Ollama 的哪个标签对应哪个 DeepSeek-R1 蒸馏版?
1.5b、7b、14b、32b 和 70b 标签对应相应的 Qwen 或 Llama 基座蒸馏版,671b 是完整 R1。8b 标签(不带标签的 ollama run deepseek-r1 拉取的也是它)是 DeepSeek-R1-0528-Qwen3-8B,而不是最初的 Llama-8B 蒸馏版。
DeepSeek-R1 仍是 DeepSeek 最新的模型吗?
不是。DeepSeek 当前一代是以开放权重发布的 DeepSeek-V4(Flash 与 Pro)。R1 与 V3 属于上一代模型,DeepSeek 的更新日志已将 API 名称 deepseek-chat 与 deepseek-reasoner 安排在 2026-07-24 停用。R1 蒸馏模型是独立发布的开放权重模型,该通知并未将其下线,因此仍可在本地运行,只是不再是 DeepSeek 最新一代产品。
更新日志
- 2026-06-19 发布。下次复查时间 2027-06-19(年度新鲜度档位——含按年份锚定的模型事实的长效解析)。
- 涵盖完整 671B R1 对比六个官方蒸馏版及 DeepSeek-R1-0528-Qwen3-8B。仅做推理内部对比;跨模型的编码对比见编码指南。
- 2026-10-19 更新:新增六个蒸馏版参考表(基座模型、AIME 2024、Ollama 标签),更正基座模型列表,说明 deepseek-r1:8b 标签对应 R1-0528-Qwen3-8B,并注明其系统提示词例外。
- 2026-10-19 更新(世代核查):注明 DeepSeek-V4 为当前一代、R1/V3 属于上一代,R1 蒸馏模型是仍可在本地运行的独立开放权重模型;并将基础模型中的 Llama 3 表述更正为 Llama 3.1/3.3。