DeepSeek-R1 Distill 显存速查表(2026)
按量化等级列出每个 DeepSeek-R1 distill:1.5B 需 4 GB,7B/8B 需 8 GB,14B 需 16 GB,32B 需 24 GB,70B 需双 GPU——均为 Ollama 默认的 Q4_K_M。 Q8_0 大约使显存翻倍;FP16 大约使 Q4_K_M 文件大小翻四倍。这是用来为 distill 匹配显卡、值得收藏的表格。现状: R1 已不再是 DeepSeek 的当前一代(当前一代是 DeepSeek-V4),但这些蒸馏版是独立的开放权重发布,仍可在本地运行。
关键要点
- ✓R1 已不再是 DeepSeek 的当前一代——当前一代是 DeepSeek-V4(Flash 和 Pro,MIT 许可的开放权重)。R1 蒸馏版是独立的开放权重发布,仍可在本地运行。
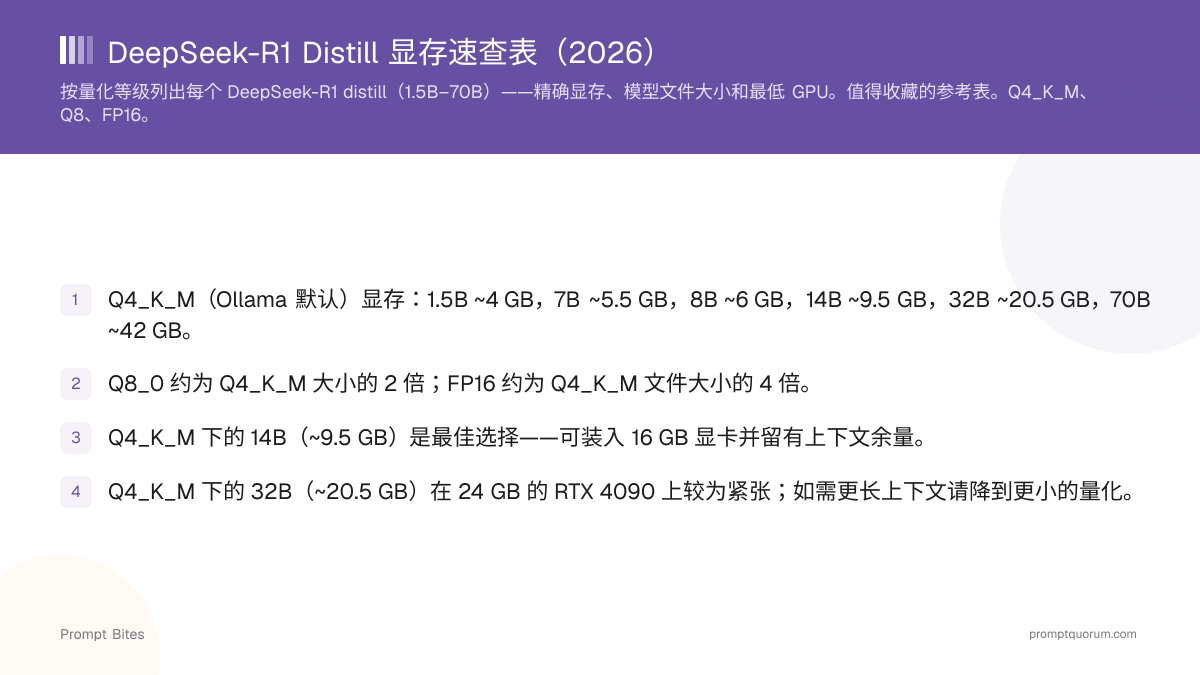
- ✓Q4_K_M(Ollama 默认)显存:1.5B ~1.6 GB,7B ~5.5 GB,8B ~6 GB,14B ~9.5 GB,32B ~20.5 GB,70B ~44 GB。
- ✓Q8_0 约为 Q4_K_M 大小的 2 倍;FP16 约为 Q4_K_M 文件大小的 4 倍。
- ✓Q4_K_M 下的 14B(~9.5 GB)是最佳选择——可装入 16 GB 显卡并留有上下文余量。
- ✓Q4_K_M 下的 32B(~20.5 GB)在 24 GB 的 RTX 4090 上较为紧张;如需更长上下文请降到更小的量化。
- ✓完整的 671B DeepSeek-R1 不在此表中——它在 Q4 下需要 ~376–404 GB(仅限数据中心)。
- ✓这些是 R1 推理 distill,而非 DeepSeek-V3(一款对话模型)。
本页包含指向第三方产品的参考链接。PromptQuorum 未加入任何联盟计划——这些是不产生佣金的普通链接。点击链接和后续步骤由您自行承担责任。这些链接不代表 PromptQuorum 的任何认可或验证。
快速回答
在 Q4_K_M(Ollama 默认)下:1.5B ≈ 1.6 GB,7B ≈ 5.5 GB,8B ≈ 6 GB,14B ≈ 9.5 GB,32B ≈ 20.5 GB,70B ≈ 44 GB。Q8_0 约为 Q4_K_M 大小的 2 倍,FP16 约为 4 倍,因此 FP16 的 32B 需要 80 GB 级别的配置。
- ▸1.5B:文件 ~1.1 GB,Q4_K_M 下 ~4 GB 显存(或 CPU)
- ▸7B:文件 ~4.7 GB,~5.5 GB 显存 — RTX 3060 12GB
- ▸14B:文件 ~9 GB,~9.5 GB 显存 — RTX 4060 Ti 16GB
- ▸32B:文件 ~20 GB,~20.5 GB 显存 — RTX 4090 24GB(紧张)
- ▸70B:文件 ~43 GB,~44 GB 显存 — 双 GPU 或 48 GB
- ▸规则:Q8_0 ≈ 2× Q4_K_M;FP16 ≈ 4× Q4_K_M
按量化等级的 DeepSeek-R1 Distill 显存
显存数值在原始文件大小之上,包含了用于上下文和 KV 缓存的少量余量。Q4_K_M 是 Ollama 默认值,也是推理任务中被广泛采用的大小与质量平衡。仅当你有富余显存并希望获得边际质量提升时才使用 Q8_0;FP16 在本地很少值得使用。
| Distill | Q4_K_M (显存) | Q8_0 (显存) | FP16 (显存) | 最低 GPU (Q4_K_M) |
|---|---|---|---|---|
| 1.5B | ~1.6 GB | ~2.5 GB | ~4.2 GB | 任意 4 GB GPU / CPU |
| 7B (Qwen2.5) | ~5.5 GB | ~8.7 GB | ~15.6 GB | RTX 3060 12GB |
| 8B (Llama 3) | ~6 GB | ~9 GB | ~16.6 GB | RTX 3060 12GB |
| 14B (Qwen2.5) | ~9.5 GB | ~17 GB | ~31 GB | RTX 4060 Ti 16GB |
| 32B (Qwen2.5) | ~20.5 GB | ~36 GB | ~67 GB | RTX 4090 24GB(紧张) |
| 70B (Llama 3) | ~44 GB | ~76 GB | ~142 GB | 双 GPU / 48 GB |
应该选择哪种量化?
**几乎所有情况都用 Q4_K_M**——它是 Ollama 默认值,在保持高推理质量的同时让每 GB 容纳最多的模型。除非有特定理由,否则就选它。
**仅在有富余显存时使用 Q8_0**——它使占用大约翻倍,换来的质量提升微乎其微,通常对推理答案影响很小。在 24 GB 显卡上运行 14B 时值得,其他情况意义不大。
**本地请跳过 FP16**——它约为 Q4_K_M 大小的 4 倍,会把 32B 推到 80 GB 级别的硬件上,相比 Q8_0 在大多数本地环境中实际的推理收益很小。
16 GB 显卡上的 14B:哪种量化装得下
**在 16 GB GPU 上,请用 Q4_K_M、Q5_K_M 或 Q6_K 运行 14B,而不是 Q8_0。** Ollama 的 Q4_K_M 文件为 9.0 GB,可为上下文留出约 6 GB;Q5_K_M(~10.5 GB)和 Q6_K(~12.1 GB)在中等上下文窗口下同样装得下。
**Q8_0 装不下得很宽裕。** Ollama 的 Q8_0 文件为 16 GB,在加上 KV 缓存之前就占满整张显卡,因此部分模型会溢出到速度较慢的系统内存。
**Ollama 只为 distill 提供 Q4_K_M、Q8_0 和 FP16 标签。** 如需 Q5_K_M 或 Q6_K,请从 Hugging Face 获取 GGUF 文件:`ollama run hf.co/
**RTX 4070 Laptop 的显存是 8 GB,而不是 16 GB。** 请用 Q4_K_M 运行 7B 或 8B distill(文件 4.7–4.9 GB)。14B(9 GB)会部分卸载到系统内存,速度明显变慢。
**`deepseek-r1:8b` 标签并不是 Llama distill。** 它在 Ollama 标签列表中的 5.2 GB 大小对应基于 Qwen3-8B 的 R1-0528 版本,而不是 4.9 GB 的 Llama distill;表中的 Llama 3 distill 是 `deepseek-r1:8b-llama-distill-q4_K_M`。
V3 与 R1:不要混淆
**DeepSeek-V3 是对话模型;DeepSeek-R1(以及这些 distill)是推理模型。** 此表仅针对 R1 推理系列。如果你要找的是 V3,它是一款 671B MoE 对话模型,同样无法在消费级硬件上运行——参见 [DeepSeek-V3 硬件速览](/zh/prompt-bites/deepseek-v3-local-hardware-requirements)。
**更新:** DeepSeek 当前一代是 DeepSeek-V4(Flash 和 Pro),以 MIT 许可的开放权重发布(预览版:2026 年 4 月 24 日)。DeepSeek 的 API 现在提供 V4:deepseek-chat(V3 世代)和 deepseek-reasoner(R1 世代)别名已宣布在 2026 年 7 月 24 日之后完全停用。R1 蒸馏版是独立的开放权重发布,不在该通知范围内,仍可在本地运行。V4 本身并不是消费级 GPU 模型:V4-Pro 总参数 1.6T(激活 49B),最初的 V4-Flash 为 284B(激活 13B),即使按 4 位精度(参数量 × 0.5 字节)计算,仅权重就大约需要 140 GB(Flash)到 800 GB(Pro),而且 DeepSeek 的模型卡未列出 GPU 要求。若要在单张消费级 GPU 上做推理,蒸馏版仍是务实之选。
相关指南
- ▸适合你 GPU 的最佳 DeepSeek Distill — 为你的显卡匹配 distill,并附 Ollama 命令和预期 tok/s
- ▸2026 最佳本地推理模型:DeepSeek-R1 排名 — 含基准测试的完整排名指南
- ▸DeepSeek-V3 本地硬件要求 — V3 对话模型的对应版本
常见问题
DeepSeek-R1 仍是 DeepSeek 的当前模型吗?▾
DeepSeek-R1-Distill-Qwen-32B 的显存是多少?▾
Q8_0 相比 Q4_K_M 增加多少?▾
我能在单块 GPU 上运行 70B distill 吗?▾
完整的 DeepSeek-R1 在此表中吗?▾
量化后的 DeepSeek-R1 14B 需要多少显存?▾
我能用 16 GB 显存运行 DeepSeek-R1 14B 吗?▾
哪个 DeepSeek-R1 distill 适合 RTX 4070 Laptop(8 GB)?▾
想了解完整详情?
阅读完整指南 →相关 Prompt Bites