Tabla de VRAM de DeepSeek-R1 Distill (2026)
Cada distill de DeepSeek-R1, por cuantización: 1.5B cabe en 4 GB, 7B/8B en 8 GB, 14B en 16 GB, 32B en 24 GB y 70B necesita doble GPU, todo con el Q4_K_M predeterminado de Ollama. Q8_0 duplica aproximadamente la VRAM; FP16 cuadruplica aproximadamente el tamaño del archivo Q4_K_M. Esta es la tabla para guardar y emparejar un distill con una tarjeta. Situación: R1 ya no es la generación actual de DeepSeek (lo es DeepSeek-V4), pero estos destilados son lanzamientos de pesos abiertos independientes que siguen ejecutándose en local.
Conclusiones clave
- ✓R1 ya no es la generación actual de DeepSeek: lo es DeepSeek-V4 (Flash y Pro, pesos abiertos con licencia MIT). Los destilados de R1 son lanzamientos de pesos abiertos independientes y siguen ejecutándose en local.
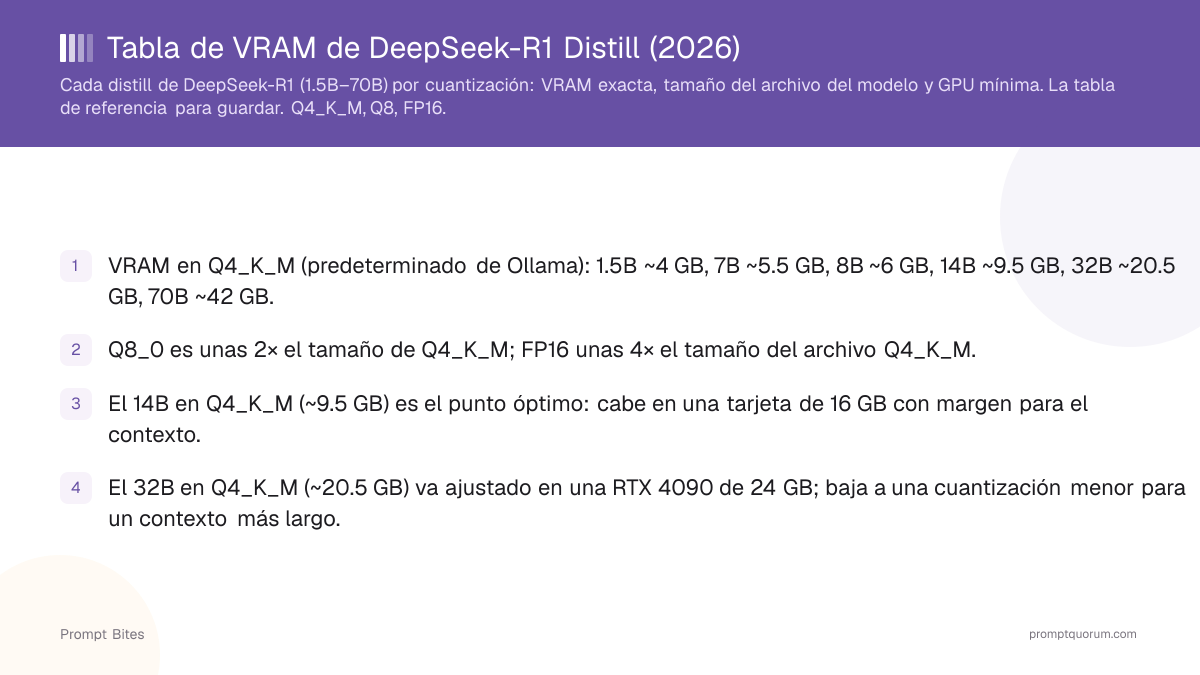
- ✓VRAM en Q4_K_M (predeterminado de Ollama): 1.5B ~1.6 GB, 7B ~5.5 GB, 8B ~6 GB, 14B ~9.5 GB, 32B ~20.5 GB, 70B ~44 GB.
- ✓Q8_0 es unas 2× el tamaño de Q4_K_M; FP16 unas 4× el tamaño del archivo Q4_K_M.
- ✓El 14B en Q4_K_M (~9.5 GB) es el punto óptimo: cabe en una tarjeta de 16 GB con margen para el contexto.
- ✓El 32B en Q4_K_M (~20.5 GB) va ajustado en una RTX 4090 de 24 GB; baja a una cuantización menor para un contexto más largo.
- ✓El DeepSeek-R1 completo de 671B no está en esta tabla: necesita ~376–404 GB en Q4 (solo centros de datos).
- ✓Estos son distills de razonamiento R1, no DeepSeek-V3 (un modelo de chat).
Esta página contiene enlaces de referencia a productos de terceros. PromptQuorum no participa en ningún programa de afiliados — son enlaces simples que no generan comisión. Hacer clic en los enlaces y los pasos siguientes son de tu entera responsabilidad. Estos enlaces no representan ningún respaldo ni verificación por parte de PromptQuorum.
Respuesta rápida
En Q4_K_M (predeterminado de Ollama): 1.5B ≈ 1.6 GB, 7B ≈ 5.5 GB, 8B ≈ 6 GB, 14B ≈ 9.5 GB, 32B ≈ 20.5 GB, 70B ≈ 44 GB. Q8_0 es unas 2× el tamaño de Q4_K_M y FP16 unas 4×, por lo que el 32B en FP16 necesita una configuración de clase 80 GB.
- ▸1.5B: archivo ~1.1 GB, ~4 GB de VRAM (o CPU) en Q4_K_M
- ▸7B: archivo ~4.7 GB, ~5.5 GB de VRAM — RTX 3060 12GB
- ▸14B: archivo ~9 GB, ~9.5 GB de VRAM — RTX 4060 Ti 16GB
- ▸32B: archivo ~20 GB, ~20.5 GB de VRAM — RTX 4090 24GB (ajustado)
- ▸70B: archivo ~43 GB, ~44 GB de VRAM — doble GPU o 48 GB
- ▸Regla: Q8_0 ≈ 2× Q4_K_M; FP16 ≈ 4× Q4_K_M
VRAM de DeepSeek-R1 Distill por cuantización
Las cifras de VRAM incluyen un pequeño margen para el contexto y la caché KV además del tamaño bruto del archivo. Q4_K_M es el predeterminado de Ollama y un equilibrio entre tamaño y calidad muy utilizado para el razonamiento. Usa Q8_0 solo si tienes VRAM de sobra y quieres una mejora marginal de calidad; FP16 rara vez vale la pena en local.
| Distill | Q4_K_M (VRAM) | Q8_0 (VRAM) | FP16 (VRAM) | GPU mínima (Q4_K_M) |
|---|---|---|---|---|
| 1.5B | ~1.6 GB | ~2.5 GB | ~4.2 GB | Cualquier GPU de 4 GB / CPU |
| 7B (Qwen2.5) | ~5.5 GB | ~8.7 GB | ~15.6 GB | RTX 3060 12GB |
| 8B (Llama 3) | ~6 GB | ~9 GB | ~16.6 GB | RTX 3060 12GB |
| 14B (Qwen2.5) | ~9.5 GB | ~17 GB | ~31 GB | RTX 4060 Ti 16GB |
| 32B (Qwen2.5) | ~20.5 GB | ~36 GB | ~67 GB | RTX 4090 24GB (ajustado) |
| 70B (Llama 3) | ~44 GB | ~76 GB | ~142 GB | Doble GPU / 48 GB |
¿Qué cuantización deberías elegir?
**Usa Q4_K_M para casi todo**: es el predeterminado de Ollama y mantiene alta la calidad de razonamiento mientras alberga la mayor cantidad de modelos por GB. Elígelo a menos que tengas una razón concreta para no hacerlo.
**Usa Q8_0 solo con VRAM de sobra**: duplica aproximadamente el consumo a cambio de una mejora de calidad marginal que normalmente cambia poco una respuesta de razonamiento. Vale la pena en una tarjeta de 24 GB con el 14B, poco más.
**Evita FP16 en local**: con unas 4× el tamaño de Q4_K_M, empuja el 32B a hardware de clase 80 GB con poco beneficio práctico de razonamiento frente a Q8_0 en la mayoría de configuraciones locales.
El 14B en una tarjeta de 16 GB: qué cuantización cabe
**En una GPU de 16 GB, ejecuta el 14B en Q4_K_M, Q5_K_M o Q6_K, no en Q8_0.** El archivo Q4_K_M de Ollama pesa 9.0 GB y deja ~6 GB para el contexto; Q5_K_M (~10.5 GB) y Q6_K (~12.1 GB) también caben con una ventana de contexto moderada.
**Q8_0 no cabe con comodidad.** El archivo Q8_0 de Ollama pesa 16 GB, es decir, toda la tarjeta antes de la caché KV, así que parte del modelo se desborda a la RAM del sistema, más lenta.
**Ollama solo ofrece las etiquetas Q4_K_M, Q8_0 y FP16 para los distills.** Para Q5_K_M o Q6_K, descarga un archivo GGUF de Hugging Face: `ollama run hf.co/
**Una RTX 4070 Laptop tiene 8 GB de VRAM, no 16 GB.** Usa el distill de 7B u 8B en Q4_K_M (archivos de 4.7–4.9 GB). El 14B (9 GB) se descarga en parte a la RAM del sistema y se vuelve mucho más lento.
**La etiqueta `deepseek-r1:8b` no es el distill de Llama.** Su tamaño de 5.2 GB en la lista de etiquetas de Ollama coincide con la versión R1-0528 basada en Qwen3-8B, no con el distill de Llama de 4.9 GB; el distill de Llama 3 de la tabla es `deepseek-r1:8b-llama-distill-q4_K_M`.
V3 vs R1: no los confundas
**DeepSeek-V3 es un modelo de chat; DeepSeek-R1 (y estos distills) son modelos de razonamiento.** Esta tabla es solo para la familia de razonamiento R1. Si buscas V3, es un modelo de chat MoE de 671B que tampoco puede ejecutarse en hardware de consumo; consulta el [resumen de hardware de DeepSeek-V3](/es/prompt-bites/deepseek-v3-local-hardware-requirements).
**Actualización:** la generación actual de DeepSeek es DeepSeek-V4 (Flash y Pro), publicada como pesos abiertos con licencia MIT (versión preliminar: 24 de abril de 2026). La API de DeepSeek ya sirve V4: los alias deepseek-chat (generación V3) y deepseek-reasoner (generación R1) se anunciaron como totalmente retirados después del 24 de julio de 2026. Los destilados de R1 son lanzamientos de pesos abiertos independientes, no formaban parte de ese aviso y siguen ejecutándose en local. V4 no es un modelo para GPU de consumo: V4-Pro tiene 1.6T de parámetros en total (49B activos) y el V4-Flash original 284B (13B activos). Incluso con precisión de 4 bits (parámetros × 0.5 bytes), solo los pesos requieren unos 140 GB (Flash) a 800 GB (Pro), y las fichas de modelo de DeepSeek no indican ningún requisito de GPU. Para razonamiento en una sola GPU de consumo, los destilados siguen siendo la opción práctica.
Guías relacionadas
- ▸El mejor distill de DeepSeek para tu GPU — empareja tu tarjeta con un distill, más el comando de Ollama y los tok/s esperados
- ▸Mejor modelo de razonamiento local 2026: DeepSeek-R1 clasificado — la guía completa con clasificación y benchmarks
- ▸Requisitos de hardware local de DeepSeek-V3 — la contraparte del modelo de chat V3
Preguntas frecuentes
¿Sigue siendo DeepSeek-R1 el modelo actual de DeepSeek?▾
¿Cuánta VRAM necesita DeepSeek-R1-Distill-Qwen-32B?▾
¿Cuánto añade Q8_0 sobre Q4_K_M?▾
¿Puedo ejecutar el distill de 70B en una sola GPU?▾
¿Está el DeepSeek-R1 completo en esta tabla?▾
¿Cuánta VRAM necesita DeepSeek-R1 14B cuantizado?▾
¿Puedo ejecutar DeepSeek-R1 14B con 16 GB de VRAM?▾
¿Qué distill de DeepSeek-R1 cabe en una RTX 4070 Laptop (8 GB)?▾
¿Quieres el desglose completo?
Leer la guía completa →Prompt Bites relacionados