Aide-mémoire VRAM DeepSeek-R1 Distill (2026)
Chaque distillation DeepSeek-R1, par quantification : 1.5B tient dans 4 GB, 7B/8B dans 8 GB, 14B dans 16 GB, 32B dans 24 GB, et 70B nécessite deux GPU — le tout au format Q4_K_M par défaut d'Ollama. Q8_0 double environ la VRAM ; FP16 quadruple environ la taille du fichier Q4_K_M. C'est le tableau à garder pour associer une distillation à une carte. Situation : R1 n'est plus la génération actuelle de DeepSeek (c'est DeepSeek-V4), mais ces distillés sont des publications open-weight distinctes qui tournent toujours en local.
Points clés
- ✓R1 n'est plus la génération actuelle de DeepSeek : c'est DeepSeek-V4 (Flash et Pro, poids ouverts sous licence MIT). Les distillés R1 sont des publications open-weight distinctes et tournent toujours en local.
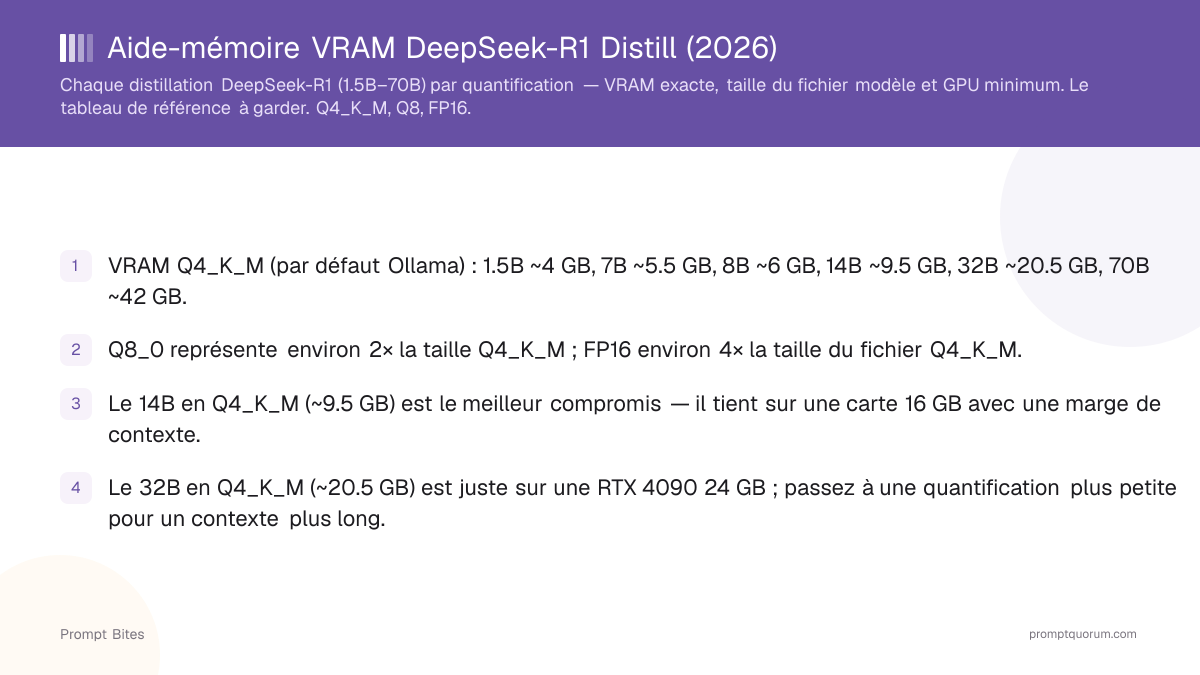
- ✓VRAM Q4_K_M (par défaut Ollama) : 1.5B ~1.6 GB, 7B ~5.5 GB, 8B ~6 GB, 14B ~9.5 GB, 32B ~20.5 GB, 70B ~44 GB.
- ✓Q8_0 représente environ 2× la taille Q4_K_M ; FP16 environ 4× la taille du fichier Q4_K_M.
- ✓Le 14B en Q4_K_M (~9.5 GB) est le meilleur compromis — il tient sur une carte 16 GB avec une marge de contexte.
- ✓Le 32B en Q4_K_M (~20.5 GB) est juste sur une RTX 4090 24 GB ; passez à une quantification plus petite pour un contexte plus long.
- ✓Le DeepSeek-R1 complet 671B ne figure pas dans ce tableau — il nécessite ~376–404 GB en Q4 (centre de données uniquement).
- ✓Ce sont des distillations de raisonnement R1, pas DeepSeek-V3 (un modèle de chat).
Cette page contient des liens de référence vers des produits tiers. PromptQuorum n'est inscrit à aucun programme d'affiliation — ce sont de simples liens qui ne génèrent aucune commission. Cliquer sur les liens et vos prochaines étapes relèvent entièrement de votre responsabilité. Ces liens ne représentent aucune approbation ou vérification par PromptQuorum.
Réponse rapide
En Q4_K_M (par défaut Ollama) : 1.5B ≈ 1.6 GB, 7B ≈ 5.5 GB, 8B ≈ 6 GB, 14B ≈ 9.5 GB, 32B ≈ 20.5 GB, 70B ≈ 44 GB. Q8_0 représente environ 2× la taille Q4_K_M et FP16 environ 4×, donc le 32B en FP16 nécessite une configuration de classe 80 GB.
- ▸1.5B : fichier ~1.1 GB, ~4 GB VRAM (ou CPU) en Q4_K_M
- ▸7B : fichier ~4.7 GB, ~5.5 GB VRAM — RTX 3060 12GB
- ▸14B : fichier ~9 GB, ~9.5 GB VRAM — RTX 4060 Ti 16GB
- ▸32B : fichier ~20 GB, ~20.5 GB VRAM — RTX 4090 24GB (juste)
- ▸70B : fichier ~43 GB, ~44 GB VRAM — deux GPU ou 48 GB
- ▸Règle : Q8_0 ≈ 2× Q4_K_M ; FP16 ≈ 4× Q4_K_M
VRAM des distillations DeepSeek-R1 par quantification
Les chiffres de VRAM incluent une petite marge pour le contexte et le cache KV en plus de la taille brute du fichier. Q4_K_M est le format par défaut d'Ollama et un compromis taille-qualité très répandu pour le raisonnement. Utilisez Q8_0 uniquement si vous avez de la VRAM disponible et souhaitez un gain de qualité marginal ; FP16 vaut rarement la peine en local.
| Distillation | Q4_K_M (VRAM) | Q8_0 (VRAM) | FP16 (VRAM) | GPU minimum (Q4_K_M) |
|---|---|---|---|---|
| 1.5B | ~1.6 GB | ~2.5 GB | ~4.2 GB | Tout GPU 4 GB / CPU |
| 7B (Qwen2.5) | ~5.5 GB | ~8.7 GB | ~15.6 GB | RTX 3060 12GB |
| 8B (Llama 3) | ~6 GB | ~9 GB | ~16.6 GB | RTX 3060 12GB |
| 14B (Qwen2.5) | ~9.5 GB | ~17 GB | ~31 GB | RTX 4060 Ti 16GB |
| 32B (Qwen2.5) | ~20.5 GB | ~36 GB | ~67 GB | RTX 4090 24GB (juste) |
| 70B (Llama 3) | ~44 GB | ~76 GB | ~142 GB | Deux GPU / 48 GB |
Quelle quantification choisir ?
**Utilisez Q4_K_M pour presque tout** — c'est le format par défaut d'Ollama et il maintient une qualité de raisonnement élevée tout en logeant le plus de modèles par GB. Choisissez-le sauf raison précise contraire.
**Utilisez Q8_0 uniquement avec de la VRAM disponible** — il double environ l'empreinte pour un gain de qualité marginal qui change généralement peu une réponse de raisonnement. Pertinent sur une carte 24 GB avec le 14B, guère ailleurs.
**Évitez FP16 en local** — à environ 4× la taille Q4_K_M, il pousse le 32B vers du matériel de classe 80 GB pour un avantage pratique de raisonnement limité par rapport à Q8_0 dans la plupart des configurations locales.
Le 14B sur une carte de 16 GB : quelle quant convient
**Sur un GPU de 16 GB, utilisez le 14B en Q4_K_M, Q5_K_M ou Q6_K — pas en Q8_0.** Le fichier Ollama Q4_K_M fait 9.0 GB et laisse ~6 GB pour le contexte ; Q5_K_M (~10.5 GB) et Q6_K (~12.1 GB) tiennent aussi avec une fenêtre de contexte modérée.
**Q8_0 ne tient pas confortablement.** Le fichier Ollama Q8_0 fait 16 GB — toute la carte avant même le cache KV — donc une partie du modèle déborde dans la RAM système, plus lente.
**Ollama ne propose que les tags Q4_K_M, Q8_0 et FP16 pour les distillations.** Pour Q5_K_M ou Q6_K, récupérez un fichier GGUF depuis Hugging Face : `ollama run hf.co/
**Une RTX 4070 Laptop a 8 GB de VRAM, pas 16 GB.** Utilisez la distillation 7B ou 8B en Q4_K_M (fichiers de 4.7–4.9 GB). Le 14B (9 GB) déborde en partie dans la RAM système et ralentit fortement.
**Le tag `deepseek-r1:8b` n'est pas la distillation Llama.** Sa taille de 5.2 GB dans la liste des tags Ollama correspond à la version R1-0528 basée sur Qwen3-8B, et non à la distillation Llama de 4.9 GB ; la distillation Llama 3 du tableau s'obtient avec `deepseek-r1:8b-llama-distill-q4_K_M`.
V3 vs R1 : ne les confondez pas
**DeepSeek-V3 est un modèle de chat ; DeepSeek-R1 (et ces distillations) sont des modèles de raisonnement.** Ce tableau concerne uniquement la famille de raisonnement R1. Si vous cherchez V3, c'est un modèle de chat MoE 671B qui n'est pas non plus exécutable par le grand public — voir le [bite matériel DeepSeek-V3](/fr/prompt-bites/deepseek-v3-local-hardware-requirements).
**Mise à jour :** la génération actuelle de DeepSeek est DeepSeek-V4 (Flash et Pro), publiée en poids ouverts sous licence MIT (préversion : 24 avril 2026). L'API de DeepSeek sert désormais V4 : les alias deepseek-chat (génération V3) et deepseek-reasoner (génération R1) ont été annoncés comme totalement retirés après le 24 juillet 2026. Les distillés R1 sont des publications open-weight distinctes, ne faisaient pas partie de cet avis et tournent toujours en local. V4 n'est pas un modèle pour GPU grand public : V4-Pro compte 1.6T de paramètres au total (49B actifs) et le V4-Flash d'origine 284B (13B actifs). Même en précision 4 bits (nombre de paramètres × 0.5 octet), les seuls poids demandent environ 140 Go (Flash) à 800 Go (Pro), et les fiches de modèle de DeepSeek n'indiquent aucune exigence GPU. Pour du raisonnement sur un seul GPU grand public, les distillés restent le choix pratique.
Guides associés
- ▸Meilleure distillation DeepSeek pour votre GPU — associez votre carte à une distillation, avec la commande Ollama et les tok/s attendus
- ▸Meilleur modèle de raisonnement local 2026 : classement DeepSeek-R1 — le guide de classement complet avec benchmarks
- ▸Exigences matérielles locales DeepSeek-V3 — l'équivalent du modèle de chat V3
Questions fréquentes
DeepSeek-R1 est-il toujours le modèle actuel de DeepSeek ?▾
Quelle est la VRAM pour DeepSeek-R1-Distill-Qwen-32B ?▾
Combien Q8_0 ajoute-t-il par rapport à Q4_K_M ?▾
Puis-je exécuter la distillation 70B sur un seul GPU ?▾
Le DeepSeek-R1 complet figure-t-il dans ce tableau ?▾
Combien de VRAM faut-il pour DeepSeek-R1 14B quantifié ?▾
Puis-je exécuter DeepSeek-R1 14B avec 16 GB de VRAM ?▾
Quelle distillation DeepSeek-R1 convient à une RTX 4070 Laptop (8 GB) ?▾
Vous voulez les détails complets ?
Lire le guide complet →Prompt Bites associés