DeepSeek-R1 Distill VRAM 早見表(2026年版)
DeepSeek-R1の各Distillを量子化別に:1.5Bは4 GB、7B/8Bは8 GB、14Bは16 GB、32Bは24 GB、70BはデュアルGPUが必要 — すべてOllamaデフォルトのQ4_K_Mでの数値です。 Q8_0はVRAMを約2倍にし、FP16はQ4_K_Mのファイルサイズを約4倍にします。これはDistillをカードに合わせるためのブックマーク用の表です。現状: R1はDeepSeekの最新世代ではなくなりました(最新はDeepSeek-V4)。ただしこれらの蒸留モデルは独立したオープンウェイトのリリースであり、引き続きローカルで動作します。
重要なポイント
- ✓R1はDeepSeekの最新世代ではなくなりました。現在の世代はDeepSeek-V4(FlashおよびPro、MITライセンスのオープンウェイト)です。R1の蒸留モデルは独立したオープンウェイトのリリースであり、引き続きローカルで動作します。
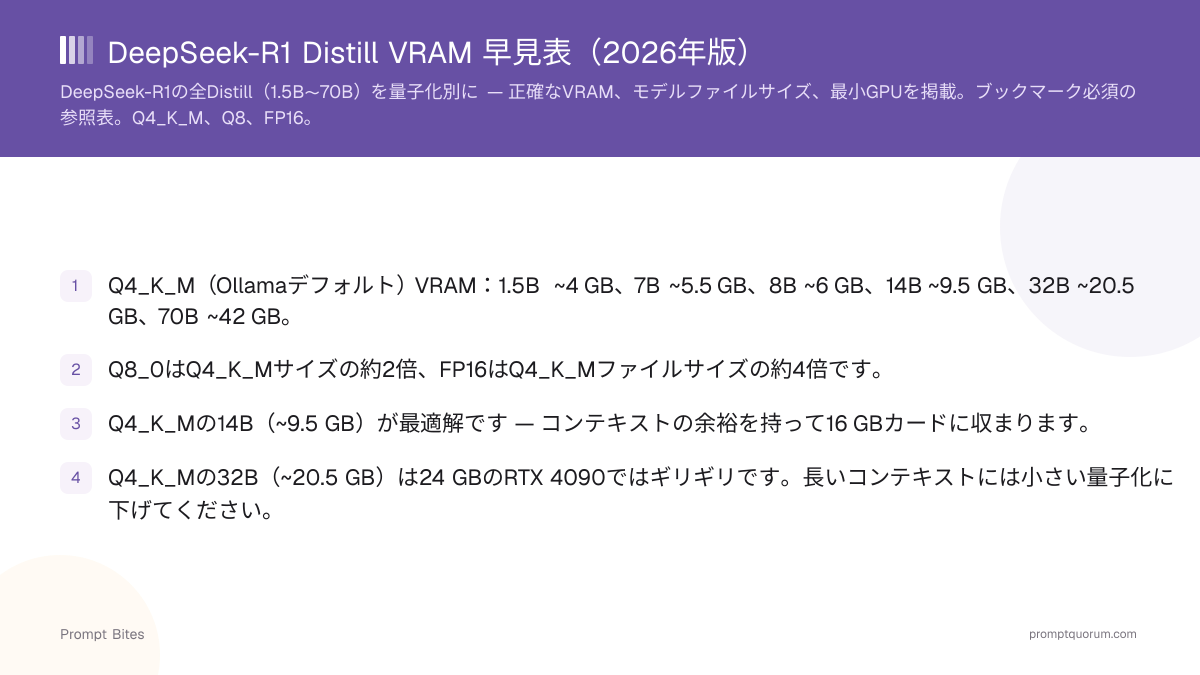
- ✓Q4_K_M(Ollamaデフォルト)VRAM:1.5B ~1.6 GB、7B ~5.5 GB、8B ~6 GB、14B ~9.5 GB、32B ~20.5 GB、70B ~44 GB。
- ✓Q8_0はQ4_K_Mサイズの約2倍、FP16はQ4_K_Mファイルサイズの約4倍です。
- ✓Q4_K_Mの14B(~9.5 GB)が最適解です — コンテキストの余裕を持って16 GBカードに収まります。
- ✓Q4_K_Mの32B(~20.5 GB)は24 GBのRTX 4090ではギリギリです。長いコンテキストには小さい量子化に下げてください。
- ✓フルの671B DeepSeek-R1はこの表に含まれません — Q4で~376–404 GBが必要(データセンター専用)。
- ✓これらはR1推論Distillであり、DeepSeek-V3(チャットモデル)ではありません。
このページには参考用の第三者製品へのリンクが含まれています。PromptQuorumはいかなるアフィリエイトプログラムにも参加しておらず、これらはコミッションを得ない単なる参照リンクです。リンクのクリックと次のステップはご自身の責任です。これらのリンクはPromptQuorumによる推奨や検証を表すものではありません。
クイック回答
Q4_K_M(Ollamaデフォルト)の場合:1.5B ≈ 1.6 GB、7B ≈ 5.5 GB、8B ≈ 6 GB、14B ≈ 9.5 GB、32B ≈ 20.5 GB、70B ≈ 44 GB。Q8_0はQ4_K_Mサイズの約2倍、FP16は約4倍なので、FP16の32Bには80 GBクラスの構成が必要です。
- ▸1.5B:ファイル~1.1 GB、Q4_K_Mで~4 GB VRAM(またはCPU)
- ▸7B:ファイル~4.7 GB、~5.5 GB VRAM — RTX 3060 12GB
- ▸14B:ファイル~9 GB、~9.5 GB VRAM — RTX 4060 Ti 16GB
- ▸32B:ファイル~20 GB、~20.5 GB VRAM — RTX 4090 24GB(ギリギリ)
- ▸70B:ファイル~43 GB、~44 GB VRAM — デュアルGPUまたは48 GB
- ▸ルール:Q8_0 ≈ 2× Q4_K_M、FP16 ≈ 4× Q4_K_M
量子化別 DeepSeek-R1 Distill VRAM
VRAMの数値には、生のファイルサイズに加えてコンテキストとKVキャッシュ用の小さな余裕が含まれています。Q4_K_MはOllamaのデフォルトで、推論におけるサイズと品質のバランスとして広く使われています。VRAMに余裕があり、わずかな品質向上を求める場合のみQ8_0を使用してください。FP16はローカルでは価値があることはほとんどありません。
| Distill | Q4_K_M (VRAM) | Q8_0 (VRAM) | FP16 (VRAM) | 最小GPU (Q4_K_M) |
|---|---|---|---|---|
| 1.5B | ~1.6 GB | ~2.5 GB | ~4.2 GB | 任意の4 GB GPU / CPU |
| 7B (Qwen2.5) | ~5.5 GB | ~8.7 GB | ~15.6 GB | RTX 3060 12GB |
| 8B (Llama 3) | ~6 GB | ~9 GB | ~16.6 GB | RTX 3060 12GB |
| 14B (Qwen2.5) | ~9.5 GB | ~17 GB | ~31 GB | RTX 4060 Ti 16GB |
| 32B (Qwen2.5) | ~20.5 GB | ~36 GB | ~67 GB | RTX 4090 24GB(ギリギリ) |
| 70B (Llama 3) | ~44 GB | ~76 GB | ~142 GB | デュアルGPU / 48 GB |
どの量子化を選ぶべきか?
**ほぼすべてにQ4_K_Mを使用してください** — Ollamaのデフォルトで、GBあたり最も多くのモデルを収めながら推論品質を高く保ちます。特別な理由がない限りこれを選んでください。
**Q8_0はVRAMに余裕がある場合のみ使用してください** — フットプリントを約2倍にしますが、品質向上はわずかで、推論の回答への影響は通常小さいです。24 GBカードで14Bを動かす場合には価値がありますが、それ以外ではほぼ不要です。
**ローカルではFP16を避けてください** — Q4_K_Mサイズの約4倍で、32Bを80 GBクラスのハードウェアに押し上げますが、Q8_0に対する実用的な推論上の利点は、ほとんどのローカル環境では小さいです。
16 GBカードで14B:収まる量子化はどれか
**16 GBのGPUでは、14BはQ8_0ではなくQ4_K_M、Q5_K_M、Q6_Kで実行してください。** OllamaのQ4_K_Mファイルは9.0 GBで、コンテキスト用に約6 GBが残ります。Q5_K_M(~10.5 GB)とQ6_K(~12.1 GB)も、中程度のコンテキスト長なら収まります。
**Q8_0は余裕を持って収まりません。** OllamaのQ8_0ファイルは16 GBで、KVキャッシュを加える前にカード全体を使い切るため、モデルの一部が低速なシステムRAMに溢れます。
**OllamaがDistillに提供するタグはQ4_K_M、Q8_0、FP16のみです。** Q5_K_MやQ6_Kが必要な場合は、Hugging FaceからGGUFファイルを取得します:`ollama run hf.co/
**RTX 4070 LaptopのVRAMは16 GBではなく8 GBです。** 7Bまたは8B DistillをQ4_K_M(ファイル4.7〜4.9 GB)で使ってください。14B(9 GB)は一部がシステムRAMにオフロードされ、大幅に遅くなります。
**`deepseek-r1:8b`タグはLlama Distillではありません。** Ollamaのタグ一覧での5.2 GBというサイズは、4.9 GBのLlama DistillではなくQwen3-8Bベースのr1-0528ビルドに一致します。表のLlama 3 Distillは`deepseek-r1:8b-llama-distill-q4_K_M`です。
V3とR1:混同しないでください
**DeepSeek-V3はチャットモデルで、DeepSeek-R1(およびこれらのDistill)は推論モデルです。** この表はR1推論ファミリー専用です。V3をお探しの場合、それは671B MoEチャットモデルで、これも一般消費者向けハードウェアでは動作しません — [DeepSeek V3ハードウェアbite](/ja/prompt-bites/deepseek-v3-local-hardware-requirements)をご覧ください。
**更新:** DeepSeekの現在の世代はDeepSeek-V4(FlashおよびPro)で、MITライセンスのオープンウェイトとして公開されています(プレビュー版は2026年4月24日)。DeepSeekのAPIは現在V4を提供しており、deepseek-chat(V3世代)とdeepseek-reasoner(R1世代)のエイリアスは2026年7月24日以降に完全に廃止されると告知されました。R1の蒸留モデルは独立したオープンウェイトのリリースで、この告知の対象ではなく、引き続きローカルで動作します。V4自体はコンシューマーGPU向けのモデルではありません。V4-Proは総パラメータ1.6T(アクティブ49B)、当初のV4-Flashは284B(アクティブ13B)で、4ビット精度(パラメータ数×0.5バイト)でも重みだけでおよそ140 GB(Flash)から800 GB(Pro)が必要です。DeepSeekのモデルカードにGPU要件の記載はありません。コンシューマーGPU1枚での推論には、引き続き蒸留モデルが現実的な選択肢です。
関連ガイド
- ▸あなたのGPUに最適なDeepSeek Distill — カードをDistillに合わせ、Ollamaコマンドと想定tok/sも掲載
- ▸2026年版 最適なローカル推論モデル:DeepSeek-R1ランキング — ベンチマーク付きの完全なランキングガイド
- ▸DeepSeek-V3 ローカルハードウェア要件 — V3チャットモデルの対応版
よくある質問
DeepSeek-R1は今もDeepSeekの最新モデルですか?▾
DeepSeek-R1-Distill-Qwen-32BのVRAMはどれくらいですか?▾
Q8_0はQ4_K_Mに対してどれくらい増えますか?▾
70B Distillを1台のGPUで実行できますか?▾
フルのDeepSeek-R1はこの表にありますか?▾
量子化したDeepSeek-R1 14BのVRAMはどれくらい必要ですか?▾
16 GBのVRAMでDeepSeek-R1 14Bを実行できますか?▾
RTX 4070 Laptop(8 GB)で動くDeepSeek-R1 Distillはどれですか?▾
詳しく読みたいですか?
コンプリートガイドを読む →関連する Prompt Bites