DeepSeek-R1 Distill GPU別おすすめ早見表(2026)
GPUとDeepSeek-R1 distillを1行で対応づけ:RTX 3060 12GBは7B、RTX 4060 Ti 16GBは14B、RTX 4090は32B(DeepSeek公表の結果ではo1-miniを上回る)、デュアルGPUは70Bを実行できます。 8 GBカードではDeepSeek-R1-0528-Qwen3-8B(リリース時点で最も強力な小型推論distillの1つ)を実行します。すべてのコマンドはデフォルトでQ4_K_Mを使用します。現状: R1はDeepSeekの最新世代ではなくなりました(最新はDeepSeek-V4)。ただしこれらの蒸留モデルは独立したオープンウェイトのリリースであり、引き続きローカルで動作します。o1-miniとの比較は過去のものです。OpenAIは2025年10月27日にo1-miniを提供終了しました。
重要なポイント
- ✓R1はDeepSeekの最新世代ではなくなりました。現在の世代はDeepSeek-V4(FlashおよびPro、MITライセンスのオープンウェイト)です。R1の蒸留モデルは独立したオープンウェイトのリリースであり、引き続きローカルで動作します。
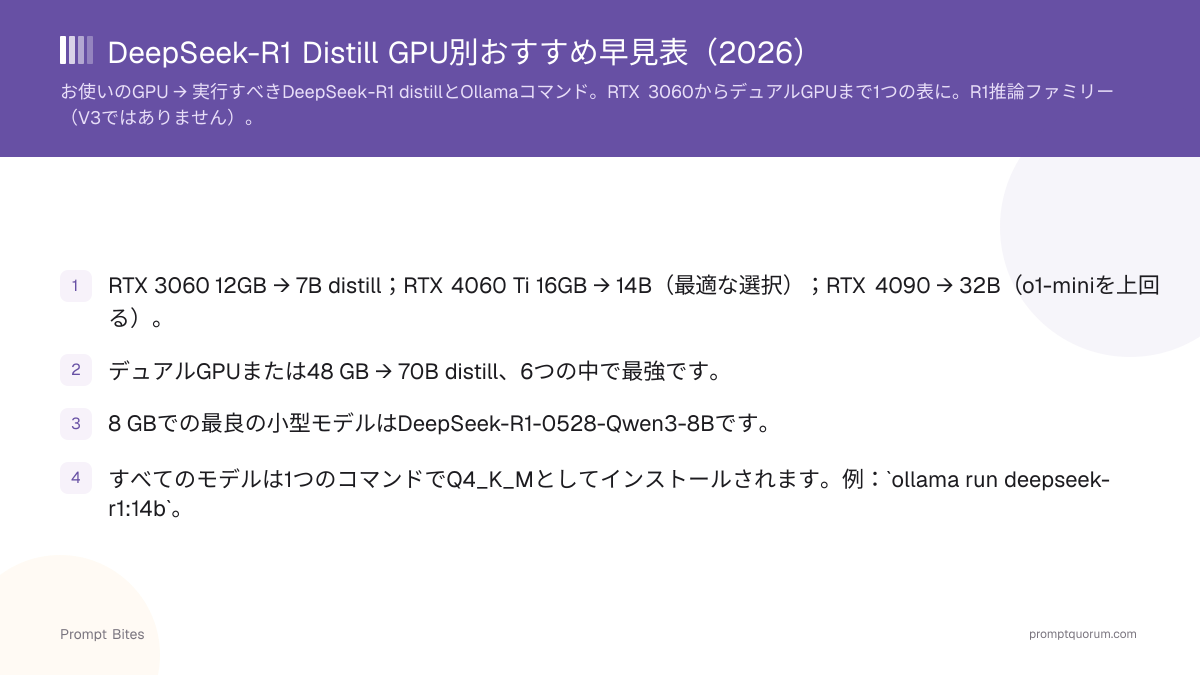
- ✓RTX 3060 12GB → 7B distill;RTX 4060 Ti 16GB → 14B(最適な選択);RTX 4090 → 32B(o1-miniを上回る)。
- ✓デュアルGPUまたは48 GB → 70B distill、6つの中で最強です。
- ✓8 GBでの最良の小型モデルはDeepSeek-R1-0528-Qwen3-8Bです。
- ✓すべてのモデルは1つのコマンドでQ4_K_Mとしてインストールされます。例:`ollama run deepseek-r1:14b`。
- ✓DeepSeekの推奨どおり、終わりのない繰り返しを避けるため、temperatureを0.6に設定し、system promptは使用しないでください。
- ✓これはR1推論ファミリーであり、チャットモデルであるDeepSeek-V3ではありません。
このページには参考用の第三者製品へのリンクが含まれています。PromptQuorumはいかなるアフィリエイトプログラムにも参加しておらず、これらはコミッションを得ない単なる参照リンクです。リンクのクリックと次のステップはご自身の責任です。これらのリンクはPromptQuorumによる推奨や検証を表すものではありません。
クイック回答
カードを確認してください:RTX 3060 12GB → 7B、RTX 4070 12GB → 8B(14Bは短いコンテキストのみ)、RTX 4060 Ti 16GB / 4070 Ti Super / 4080 → 14B、RTX 4090 → 32B、デュアルGPU/48 GB → 70B。32Bは重みだけで約20 GB必要なため、12 GBまたは16 GBのカードには収まりません。8 GBでの最良の小型モデルはDeepSeek-R1-0528-Qwen3-8B(`ollama run deepseek-r1:8b`)です。いずれも1つのOllamaコマンドでQ4_K_Mとして実行できます。
- ▸RTX 3060 12GB → deepseek-r1:7b — 約30–40 tok/s
- ▸RTX 4060 Ti 16GB → deepseek-r1:14b — 約25–35 tok/s(推奨)
- ▸RTX 4070 12GB → deepseek-r1:8b(14Bは短いコンテキストのみ) — 約30–40 tok/s
- ▸RTX 4070 Ti Super / 4080 16GB → deepseek-r1:14b — 約40–50 tok/s(32Bは収まらない)
- ▸RTX 4090 24GB → deepseek-r1:32b — 約30–40 tok/s、o1-miniを上回る
- ▸デュアルGPU / 48 GB → deepseek-r1:70b — 約12–18 tok/s
- ▸8 GBカード、最良の小型 → DeepSeek-R1-0528-Qwen3-8B
GPU → DeepSeek-R1 Distill → Ollamaコマンド
このセクションでは、最初の列でお使いのGPUを見つけ、横に読み進めてください。tok/sの数値はQ4_K_M推論ワークロードの大まかな目安であり、PromptQuorumによる実測値ではなく、コンテキスト長、サンプリング設定、ハードウェアによって変動します。2つのモデルが収まる場合、大きい方が推論に優れ、小さい方が高速です。
| GPU (VRAM) | 最適なDistill | Ollamaコマンド | 予想tok/s |
|---|---|---|---|
| RTX 3060 12GB(8 GBクラス) | DeepSeek-R1-Distill-Qwen-7B | ollama run deepseek-r1:7b | ~30–40 |
| 8 GB、最良の小型 | DeepSeek-R1-0528-Qwen3-8B | ollama run deepseek-r1:8b | ~30–40 |
| RTX 4060 Ti 16GB | DeepSeek-R1-Distill-Qwen-14B | ollama run deepseek-r1:14b | ~25–35 |
| RTX 4070 12GB | 8B、または14B(短いコンテキスト) | ollama run deepseek-r1:8b | ~30–40 |
| RTX 4070 Ti Super / 4080 16GB | 14B(32Bは収まらない) | ollama run deepseek-r1:14b | ~40–50 |
| RTX 4090 24GB | DeepSeek-R1-Distill-Qwen-32B | ollama run deepseek-r1:32b | ~30–40 |
| デュアルGPU / 48 GB | DeepSeek-R1-Distill-Llama-70B | ollama run deepseek-r1:70b | ~12–18 |
この表を3ステップで使う方法
4行です:(1) GPUとそのVRAMを確認し、(2) Ollamaをインストールして対応するコマンドを実行し、(3) `ollama ps`でモデルがすべてGPU上にあることを確認し、(4) temperatureを0.6に設定してシステムプロンプトを空にします。モデルが遅すぎる場合は1段階下げ、VRAMに余裕があれば1段階上げるとreasoningが向上します。
V3とR1:この表はR1専用です
**DeepSeek-R1はこれらのコマンドがインストールする推論ファミリーであり、DeepSeek-V3は別個のチャットモデルです。** これらのdistillにV3のような体験を期待しないでください。数学と論理の段階的な推論を示すよう調整されています。さらにV3は671B MoEであり、コンシューマー向けハードウェアでは実行できません。[DeepSeek V3ハードウェアバイト](/ja/prompt-bites/deepseek-v3-local-hardware-requirements)を参照してください。
**更新:** DeepSeekの現在の世代はDeepSeek-V4(FlashおよびPro)で、MITライセンスのオープンウェイトとして公開されています(プレビュー版は2026年4月24日)。DeepSeekのAPIは現在V4を提供しており、deepseek-chat(V3世代)とdeepseek-reasoner(R1世代)のエイリアスは2026年7月24日以降に完全に廃止されると告知されました。R1の蒸留モデルは独立したオープンウェイトのリリースで、この告知の対象ではなく、引き続きローカルで動作します。V4自体はコンシューマーGPU向けのモデルではありません。V4-Proは総パラメータ1.6T(アクティブ49B)、当初のV4-Flashは284B(アクティブ13B)で、4ビット精度(パラメータ数×0.5バイト)でも重みだけでおよそ140 GB(Flash)から800 GB(Pro)が必要です。DeepSeekのモデルカードにGPU要件の記載はありません。コンシューマーGPU1枚での推論には、引き続き蒸留モデルが現実的な選択肢です。
関連ガイド
- ▸DeepSeek-R1 Distill VRAM早見表 — quant別(Q4_K_M、Q8、FP16)の各distillとVRAMおよび最小GPU
- ▸最良のローカル推論モデル2026:DeepSeek-R1ランキング — ベンチマークとティアを含む完全ランキングガイド
- ▸DeepSeek-V3 ローカルハードウェア要件 — V3チャットモデルの対応版
よくある質問
DeepSeek-R1は今もDeepSeekの最新モデルですか?▾
RTX 4090ではどのDeepSeek distillが動きますか?▾
16 GBのVRAMに収まるDeepSeek-R1 distillは?▾
RTX 4070でdeepseek-r1:32bは動きますか?▾
8 GB GPUに最適なDeepSeek distillは?▾
distillが遅いのはなぜですか?▾
量子化を選ぶ必要はありますか?▾
詳しく読みたいですか?
コンプリートガイドを読む →関連する Prompt Bites