أفضل نموذج DeepSeek مقطّر لكرت الشاشة لديك (2026)
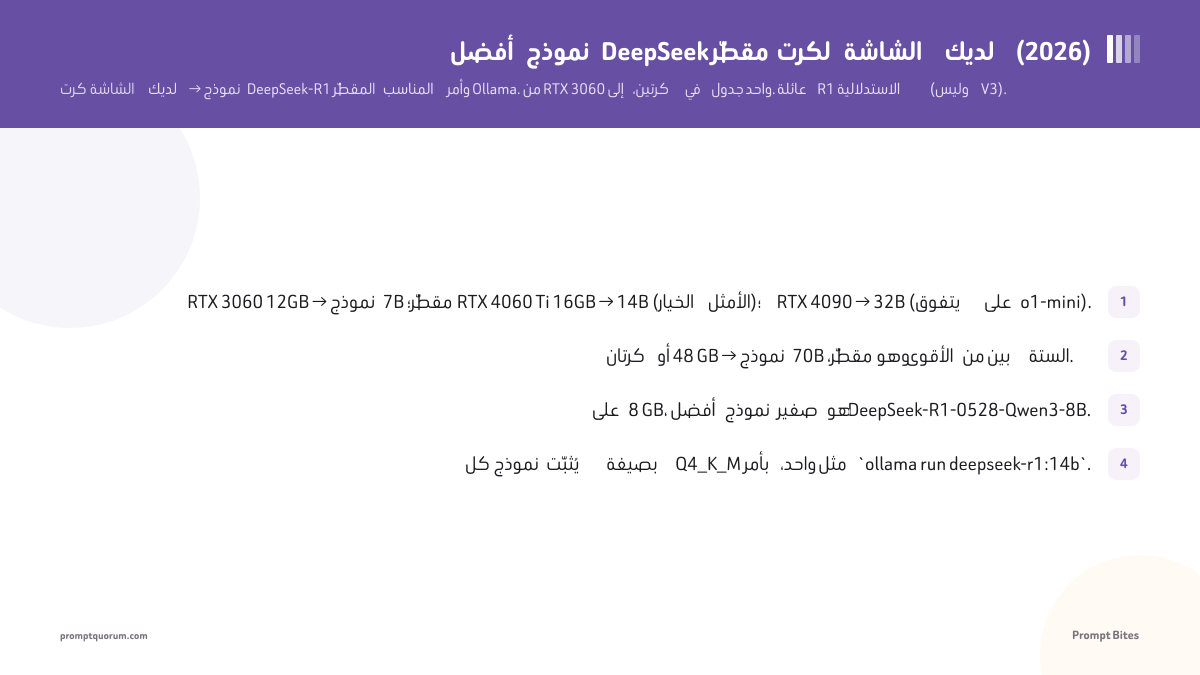
طابِق كرت الشاشة لديك مع نموذج DeepSeek-R1 مقطّر في سطر واحد: RTX 3060 12GB يشغّل 7B، وRTX 4060 Ti 16GB يشغّل 14B، وRTX 4090 يشغّل 32B (يتفوق على o1-mini وفق النتائج التي نشرتها DeepSeek)، والكرتان يشغّلان 70B. على كرت بسعة 8 GB، شغّل DeepSeek-R1-0528-Qwen3-8B — من أقوى نماذج الاستدلال الصغيرة المقطّرة عند إصداره. كل الأوامر تستخدم Q4_K_M افتراضيًا. الوضع الحالي: لم يعد R1 الجيل الحالي من DeepSeek (الجيل الحالي هو DeepSeek-V4)، لكن هذه النماذج المُقطّرة إصدارات مستقلة بأوزان مفتوحة ما زالت تعمل محليًا. مقارنة o1-mini تاريخية: أوقفت OpenAI نموذج o1-mini في 27 أكتوبر 2025.
النقاط الرئيسية
- ✓لم يعد R1 الجيل الحالي من DeepSeek؛ الجيل الحالي هو DeepSeek-V4 (Flash وPro، بأوزان مفتوحة بترخيص MIT). نماذج R1 المُقطّرة إصدارات مستقلة بأوزان مفتوحة وما زالت تعمل محليًا.
- ✓RTX 3060 12GB → نموذج 7B مقطّر؛ RTX 4060 Ti 16GB → 14B (الخيار الأمثل)؛ RTX 4090 → 32B (يتفوق على o1-mini).
- ✓كرتان أو 48 GB → نموذج 70B مقطّر، وهو الأقوى من بين الستة.
- ✓على 8 GB، أفضل نموذج صغير هو DeepSeek-R1-0528-Qwen3-8B.
- ✓كل نموذج يُثبَّت بصيغة Q4_K_M بأمر واحد، مثل `ollama run deepseek-r1:14b`.
- ✓اضبط درجة الحرارة على 0.6 ولا تستخدم system prompt، كما توصي DeepSeek، لتجنّب التكرار اللانهائي.
- ✓هذه عائلة R1 الاستدلالية — وليست DeepSeek-V3 وهو نموذج محادثة.
تحتوي هذه الصفحة على روابط مرجعية لمنتجات طرف ثالث. لا يشارك PromptQuorum في أي برنامج تابع — هذه روابط عادية لا تدر أي عمولة. النقر على الروابط والخطوات التالية تقع على عاتقك بالكامل. لا تمثل هذه الروابط أي تأييد أو تحقق من قِبَل PromptQuorum.
إجابة سريعة
حدّد كرتك: RTX 3060 12GB → 7B، وRTX 4070 12GB → 8B (14B مع سياق قصير فقط)، وRTX 4060 Ti 16GB / 4070 Ti Super / 4080 → 14B، وRTX 4090 → 32B، وكرتان/48 GB → 70B. يحتاج 32B إلى ~20 GB للأوزان وحدها، فلا يتسع في كروت 12 أو 16 GB. لأفضل نموذج صغير على 8 GB، شغّل DeepSeek-R1-0528-Qwen3-8B (`ollama run deepseek-r1:8b`). كل نموذج يعمل بأمر Ollama واحد بصيغة Q4_K_M.
- ▸RTX 3060 12GB → deepseek-r1:7b — ~30–40 tok/s
- ▸RTX 4060 Ti 16GB → deepseek-r1:14b — ~25–35 tok/s (موصى به)
- ▸RTX 4070 12GB → deepseek-r1:8b (14B مع سياق قصير فقط) — ~30–40 tok/s
- ▸RTX 4070 Ti Super / 4080 16GB → deepseek-r1:14b — ~40–50 tok/s (لا يتسع 32B)
- ▸RTX 4090 24GB → deepseek-r1:32b — ~30–40 tok/s، يتفوق على o1-mini
- ▸كرتان / 48 GB → deepseek-r1:70b — ~12–18 tok/s
- ▸كرت 8 GB، أفضل نموذج صغير → DeepSeek-R1-0528-Qwen3-8B
كرت الشاشة → نموذج DeepSeek-R1 مقطّر → أمر Ollama
حدّد كرت الشاشة الذي تمتلكه في العمود الأول واقرأ عبر الصف. أرقام tok/s تقديرات إرشادية تقريبية لأحمال الاستدلال بصيغة Q4_K_M، وليست قياسات أجرتها PromptQuorum، وتتغير حسب طول السياق وإعدادات أخذ العينات والعتاد. عندما يتسع نموذجان، فالأكبر يستدل بشكل أفضل والأصغر أسرع.
| GPU (VRAM) | أفضل نموذج مقطّر | أمر Ollama | tok/s المتوقع |
|---|---|---|---|
| RTX 3060 12GB (فئة 8 GB) | DeepSeek-R1-Distill-Qwen-7B | ollama run deepseek-r1:7b | ~30–40 |
| 8 GB، أفضل صغير | DeepSeek-R1-0528-Qwen3-8B | ollama run deepseek-r1:8b | ~30–40 |
| RTX 4060 Ti 16GB | DeepSeek-R1-Distill-Qwen-14B | ollama run deepseek-r1:14b | ~25–35 |
| RTX 4070 12GB | 8B، أو 14B (سياق قصير) | ollama run deepseek-r1:8b | ~30–40 |
| RTX 4070 Ti Super / 4080 16GB | 14B (لا يتسع 32B) | ollama run deepseek-r1:14b | ~40–50 |
| RTX 4090 24GB | DeepSeek-R1-Distill-Qwen-32B | ollama run deepseek-r1:32b | ~30–40 |
| كرتان / 48 GB | DeepSeek-R1-Distill-Llama-70B | ollama run deepseek-r1:70b | ~12–18 |
كيفية استخدام هذا الجدول في 3 خطوات
أربعة أسطر: (1) حدّد كرت الشاشة لديك وسعة VRAM، (2) ثبّت Ollama وشغّل الأمر المطابق، (3) تأكد عبر `ollama ps` أن النموذج بالكامل على GPU، (4) اضبط درجة الحرارة على 0.6 وامسح system prompt. إذا كان النموذج بطيئًا جدًا، انزل مستوى واحدًا؛ وإذا كان لديك VRAM إضافي، اصعد مستوى واحدًا لاستدلال أفضل.
V3 مقابل R1: هذا الجدول لـ R1 فقط
**DeepSeek-R1 هي العائلة الاستدلالية التي تثبّتها هذه الأوامر؛ أما DeepSeek-V3 فهو نموذج محادثة منفصل.** لا تتوقع تجربة V3 من هذه النماذج المقطّرة — فهي مضبوطة لإظهار الاستدلال خطوة بخطوة في الرياضيات والمنطق. كما أن V3 هو نموذج MoE بحجم 671B ولا يمكن تشغيله على عتاد المستهلك؛ راجع [بطاقة عتاد DeepSeek-V3](/ar/prompt-bites/deepseek-v3-local-hardware-requirements).
**تحديث:** الجيل الحالي من DeepSeek هو DeepSeek-V4 (Flash وPro)، صدر بأوزان مفتوحة بترخيص MIT (النسخة التجريبية: 24 أبريل 2026). تقدّم واجهة DeepSeek البرمجية الآن V4: فقد أُعلن أن الاسمين المستعارين deepseek-chat (جيل V3) وdeepseek-reasoner (جيل R1) سيُوقفان نهائيًا بعد 24 يوليو 2026. نماذج R1 المُقطّرة إصدارات مستقلة بأوزان مفتوحة، ولم تكن ضمن هذا الإعلان، وما زالت تعمل محليًا. أما V4 نفسه فليس نموذجًا لبطاقات الرسوميات الاستهلاكية: يضم V4-Pro إجمالي 1.6T معامل (49B نشط)، ويضم V4-Flash الأصلي 284B (13B نشط)، وحتى بدقة 4 بت (عدد المعاملات × 0.5 بايت) تحتاج الأوزان وحدها إلى نحو 140 جيجابايت (Flash) حتى 800 جيجابايت (Pro)، ولا تذكر بطاقات نماذج DeepSeek أي متطلبات لوحدة GPU. وللاستدلال على بطاقة استهلاكية واحدة تبقى النماذج المُقطّرة الخيار العملي.
أدلة ذات صلة
- ▸جدول VRAM لنماذج DeepSeek-R1 المقطّرة — كل نموذج مقطّر حسب الكمّنة (Q4_K_M، Q8، FP16) مع VRAM والحد الأدنى من كرت الشاشة
- ▸أفضل نموذج استدلال محلي 2026: تصنيف DeepSeek-R1 — الدليل المصنّف الكامل مع المعايير والفئات
- ▸متطلبات العتاد المحلي لـ DeepSeek-V3 — نظير نموذج المحادثة V3
الأسئلة الشائعة
هل ما زال DeepSeek-R1 هو النموذج الحالي لدى DeepSeek؟▾
أي نموذج DeepSeek مقطّر يعمل على RTX 4090؟▾
أي نموذج DeepSeek-R1 مقطّر يتسع في 16 GB من VRAM؟▾
هل يستطيع RTX 4070 تشغيل deepseek-r1:32b؟▾
ما أفضل نموذج DeepSeek مقطّر لكرت بسعة 8 GB؟▾
لماذا النموذج المقطّر لدي بطيء؟▾
هل عليّ اختيار الكمّنة؟▾
هل تريد الشرح الكامل؟
اقرأ الدليل الكامل →لقطات سريعة ذات صلة