أفضل LLM محلي حسب مستوى VRAM 2026: Ollama وLM Studio ودليل الأجهزة
النماذج اللغوية LLM المحلية هي نماذج لغوية كبيرة تعمل بالكامل على جهازك الخاص — بلا اتصال إنترنت، وبلا رسوم API، وبلا خروج أي بيانات من جهازك. إذا كنت مبتدئًا، ثبّت Ollama وشغّل Llama 3.2 3B أو Qwen3.5 4B بذاكرة 8 GB RAM في أقل من 10 دقائق؛ الأدلة أدناه تصنّف أفضل النماذج وبطاقات GPU والأدوات لكل ميزانية.
ابدأ هنا
الأسئلة التي يطرحها القرّاء أولًا، ومع كل سؤال الدليل المناسب لفتحه. اختر ما يناسبك.
استكشف حسب الموضوع
12 مواضيع، 154 دليلًا. نقرة واحدة تفتح الموضوع في مكانه.
البدء 13 دليل
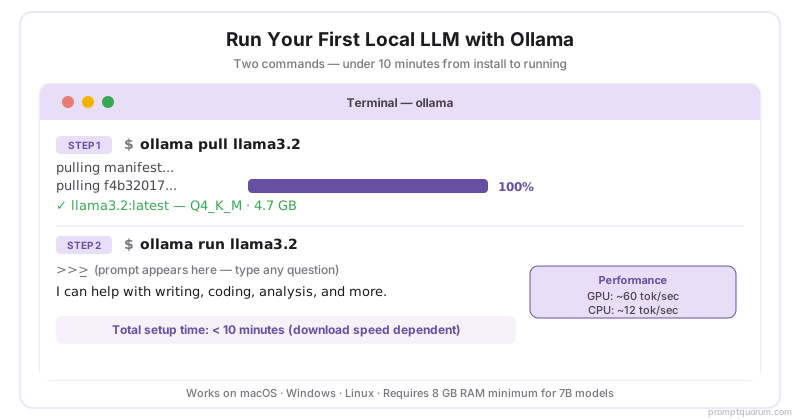
من الصفر إلى التشغيل في أقل من 10 دقائق. أدلة تثبيت خاصة بكل نظام تشغيل، وشروحات لأول نموذج، وقائمة تحقق إعداد تراعي الخصوصية للمبتدئين. يُثبَّت Ollama بأمر واحد على macOS وWindows وLinux. لذاكرة 8 GB RAM، ابدأ بـLlama 3.2 3B (Q4، ~2 GB) عبر الأمر `ollama pull llama3.2:3b`.
النماذج حسب حالة الاستخدام 24 دليل
تصنيفات النماذج، ومقارنات معايير الأداء، وتوصيات بحسب فئة الذاكرة. الخيارات الحالية: Qwen3.8-27B لبطاقات 24 GB، وGemma 4 12B لذاكرة 12 GB، وgpt-oss-20b لذاكرة 16 GB، وQwen3 8B أو Qwen3.5 4B لأجهزة 8 GB، وPhi-4 Mini لأنظمة CPU فقط. نتائج المعايير تعلنها الشركات المطوّرة ما لم يُذكر أنها مقيسة.
الأدوات والواجهات 27 دليل
يشغّل Ollama وLM Studio نماذج مفتوحة كثيرة على macOS وWindows وLinux. يعتمد Ollama على سطر الأوامر مع واجهة REST API، بينما يوفّر LM Studio واجهة رسومية مع متصفّح نماذج مدمج. تغطي الأدلة الأداتين إضافةً إلى vLLM وllama.cpp وOpen WebUI وتكاملات بيئات التطوير.
الأجهزة والأداء 14 دليل
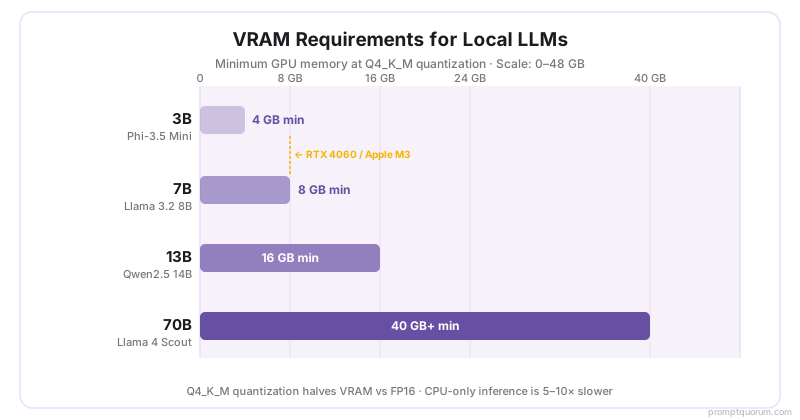
تُعدّ VRAM القيد الأساسي للنماذج المحلية. يحتاج نموذج 7B بتكميم Q4_K_M إلى نحو 4-5 GB، ويحتاج نموذج 70B إلى نحو 42 GB. تغطي الأدلة اختيار GPU (من RTX 4070 Ti إلى RTX 5090)، وApple Silicon، والتجميعات الاقتصادية، وحساب VRAM لأي نموذج.
تقنيات متقدمة 13 دليل
الضبط الدقيق، وخطوط RAG، وتحليلات عميقة للتكميم، والتقطير، ودمج النماذج، وتحسين المطالبات للاستخدام الإنتاجي. يخفّض LoRA وQLoRA متطلبات ذاكرة الضبط الدقيق كثيرًا مقارنةً بالضبط الدقيق الكامل. تُبقي مسارات RAG المحلية البيانات الحساسة داخل المنشأة مع الحفاظ على جودة البحث.
Enterprise 13 دليل
إعدادات متعددة GPU، وتحسين الاستدلال، وأطر تقديم النماذج (vLLM وTensorRT-LLM)، والمراقبة، وتدقيق التكاليف، والامتثال التنظيمي. يتيح التشغيل المحلي تجنّب إرسال البيانات إلى واجهة API تابعة لطرف ثالث، وقد يخفّض تكاليف الترخيص مقارنة بـSaaS بحسب الاستخدام؛ أما الامتثال فيظل متوقفًا على إعدادك بالكامل.
أدلة شراء GPU 6 دليل
اختيار GPU بحسب الميزانية وحالة الاستخدام، وتكلفة كل توكن، وكفاءة الطاقة، والتصميم الحراري، ومقارنات سوق المستعمل، ومفاضلات الضمان. تناسب بطاقة بذاكرة 24 GB مثل RTX 4090 نماذج فئة 27B، ويحتاج نموذج 70B إلى نحو 48 GB. تغيّرت الأسعار مع نقص الذاكرة في 2026، لذا يذكر كل دليل الأرقام الحالية.
إعدادات الأجهزة 6 دليل
أدلة بناء كاملة لأجهزة الحاسوب المحمولة وأجهزة سطح المكتب ومحطات العمل والخوادم. من إعداد بطاقة GPU واحدة إلى عناقيد متعددة العقد. تشكيلات بميزانية محدودة (500$-1500$)، ومتوسطة (1500$-5000$)، ومؤسسية (5000$+)، مع قوائم قطع دقيقة وإنتاجية متوقعة.
الخصوصية والأعمال 5 دليل
النشر المحلي لأعمال الخصوصية والامتثال (GDPR وHIPAA وAPPI وCAC). بيئات معزولة عن الشبكة وسجلّ للوصول. تتجنّب النماذج المحلية الارتباط بمزوّد API واحد، وقد تقلّص نطاق تدقيق الامتثال، وتُبقي البيانات الخاصة بعيدًا عن خوادم الأطراف الثالثة؛ أما الامتثال نفسه فيتوقف على إعدادك بالكامل.
التكلفة والمقارنات 8 دليل
تحليل نقطة التعادل: المحلي مقابل السحابي مقابل الاشتراكات. تكاليف SaaS الخفية: رسوم تجاوز الحد، ومقاعد المؤسسات، وسجلات التدقيق. يتوقف استرداد تكلفة الجهاز المحلي أساسًا على ساعات الاستخدام الشهرية؛ وتتيح لك الحاسبات إدخال أرقامك الخاصة.
Apple Silicon 12 دليل
أدلة خاصة بأجهزة Mac التي تعمل بمعالجات Apple Silicon من سلسلة M — تحديد حجم الذاكرة الموحّدة، ومقارنات أداء MLX مقابل Ollama وllama.cpp، وتفريغ الصوت عبر Whisper باستخدام Metal، وتشكيلات Mac mini وMacBook للاستدلال المحلي. يشارك Apple Silicon الذاكرة الموحّدة بين CPU وGPU، لذا يمكن لجهاز Mac من سلسلة M بذاكرة 32 GB تشغيل نماذج بحجم 30 مليار معلمة دون حاجة إلى GPU منفصلة. MLX هو إطار عمل الاستدلال الخاص بشركة Apple، وعادة ما يكون أسرع من llama.cpp على الشريحة نفسها.
المؤسسات والامتثال 13 دليل
أدلة شراء خوادم GPU للمؤسسات، والامتثال لمعياري SOC 2 وISO 27001 للنماذج المستضافة ذاتيًا، وشروط التراخيص التجارية، ومقارنات مباشرة بين بوابات API، وأطر الضبط الدقيق، وأطر الوكلاء، وأدوات التقييم، ومنصات قابلية الرصد، وقواعد البيانات المتجهية للنشر الإنتاجي. يتوقف الأرخص بين استئجار GPU سحابية وشراء أجهزة داخل المنشأة أساسًا على مدى استمرارية عبء العمل.
إجابات عملية
أربع إجابات عملية محسوبة بمعادلة ذاكرة بسيطة (تقديرات وليست قياسات). الجداول الكاملة في أسفل الصفحة.
باختصار: تكفي ذاكرة RAM بحجم 8 GB لتشغيل نموذج 7B، وتبقى كل بياناتك على جهازك، ولا توجد تكاليف API بعد شراء الأجهزة.
آخر التحديثات
الصفحات الثلاث الأحدث تغييرًا.
تعمّق أكثر
عوالم المواضيع الأخرى، لكل منها لونه الخاص.
نظرة عامة في عرض تقديمي
تغطي الشرائح أدناه متطلبات الأجهزة (8 GB VRAM لنماذج 7B، نحو 42 GB لنموذج 70B)، وأفضل النماذج مفتوحة المصدر لعام 2026، وإعداد Ollama خلال 5 دقائق، وتكميم Q4_K_M، والامتثال الإقليمي (GDPR، APPI)، وأهم النقاط. نزّل ملف PDF كبطاقة مرجعية سريعة للنماذج المحلية.
الأسئلة الشائعة
ما هو النموذج اللغوي المحلي؟
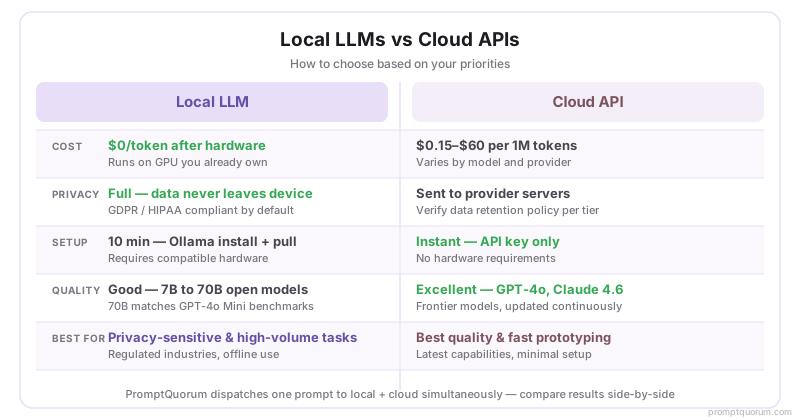
نموذج لغوي كبير (مثل Qwen3.8 وGemma 4 وgpt-oss وDeepSeek) يعمل على جهازك الخاص بدلًا من واجهة API سحابية. تبقى مطالباتك وملفاتك على جهازك، ويعمل دون اتصال، وبلا حدود استخدام، وبلا أي تكلفة لكل توكن بعد شراء الجهاز.
كم VRAM أحتاج للنموذج اللغوي المحلي؟
تشغّل 8 GB VRAM نماذج 7-8B بتكميم Q4 (نحو 5 GB للأوزان). وتتعامل 16 GB مع نماذج 13-14B بسهولة. ويحتاج نموذج 70B إلى نحو 42 GB لأوزانه بتكميم Q4، لذا فإن إعدادًا بذاكرة 48 GB (مثل بطاقتَي RTX 4090) هو الحد الأدنى العملي. الذاكرة الموحّدة في Apple Silicon تُحتسب كـVRAM.
ما الفرق بين Ollama وLM Studio؟
Ollama أداة CLI تشغّل النماذج عبر أوامر طرفية بسيطة وتوفّر واجهة API متوافقة مع OpenAI على `localhost:11434`. أما LM Studio فتقدّم واجهة رسومية لسطح المكتب، ومتصفّح نماذج، وواجهة محادثة مدمجة. كلاهما يدعم نفس النماذج.
هل تضاهي النماذج المحلية نماذج سحابية مثل GPT وClaude؟
تتولى النماذج مفتوحة الأوزان مثل Qwen3.8-27B وGemma 4 مهام البرمجة والكتابة والتلخيص اليومية على بطاقة GPU واحدة بذاكرة 24 GB. وتحتفظ النماذج السحابية الرائدة بأفضلية في الاستدلال المعقّد متعدد الخطوات. تختلف نتائج المعايير التي تعلنها الشركات باختلاف الاختبار، فجرّب مطالباتك الخاصة قبل أن تقرّر.
كيف أُجري الضبط الدقيق لنموذج محلي؟
يتطلّب الضبط الدقيق 500+ مثال تدريب موسوم، وإطار QLoRA (يخفّض متطلبات VRAM عبر تكميم 4-بت)، و24 GB+ VRAM على الأقل (أو استئجار GPU سحابية)، وساعة إلى 4 ساعات وقت تدريب لنموذج 7B.
ما الحد الأدنى من الأجهزة لتشغيل نموذج لغوي محلي في 2026؟
الحد الأدنى: 8 GB RAM وأي معالج CPU حديث (يشغّل نماذج 3B-7B بسرعة نحو 2-5 توكن/ثانية). الموصى به: بطاقة GPU بذاكرة 8 GB+ VRAM فأكثر (RTX 3060 أو أحدث) لسرعة نحو 15-40 توكن/ثانية على نماذج 7-8B.
هل النماذج اللغوية المحلية مجانية للاستخدام؟
نعم في معظمه. Ollama مفتوح المصدر، أما LM Studio فمجاني الاستخدام لكنه مغلق المصدر. ويمكن تنزيل معظم النماذج مفتوحة الأوزان (Qwen وGemma وgpt-oss وMistral وDeepSeek) مجانًا، لكن التراخيص تختلف، ويستخدم Llama رخصة مجتمعية، فراجع الشروط قبل أي استخدام تجاري. التكلفة الرئيسية هي جهازك.
ما أفضل نموذج لغوي محلي للبرمجة في 2026؟
يُعدّ Qwen3.8 27B الاختيار الأول لبطاقة GPU بذاكرة 24 GB (18 GB، سياق 256K). ويناسب Devstral Small 2 (24B، 15 GB) الأجهزة بذاكرة 16 GB، ويناسب Qwen3 8B أجهزة 8 GB. ويظل Codestral 22B خيارًا شائعًا للإكمال التلقائي في بيئة التطوير، ويُعدّ Phi-4 Mini الخيار العملي لأنظمة CPU فقط. نتائج المعايير تعلنها الشركات المطوّرة؛ راجع دليل البرمجة للتفاصيل.
هل يمكنني تشغيل نموذج محلي دون بطاقة GPU؟
نعم. يستطيع أي معالج CPU حديث تشغيل نماذج 3B-7B بتكميم Q4 عبر Ollama (وضع CPU) أو LM Studio. السرعة المعتادة نحو 2-8 توكن/ثانية لنماذج 7B على معالج حاسوب محمول، وأسرع لنماذج 3-4B، مقابل 20-50 توكن/ثانية على RTX 4060. يحتاج 7B Q4 إلى نحو 5 GB RAM (وليس VRAM). لأنظمة CPU فقط، يقدّم Phi-4 Mini (3.8B) وLlama 3.2 3B أفضل نسبة جودة إلى سرعة.
كيف أُحدّث نماذج LLM المحلية عند صدور إصدارات جديدة؟
Ollama: شغّل `ollama pull <model-name>` مجددًا — يُنزَّل فقط الطبقات المتغيّرة. LM Studio: افتح متصفّح النماذج، وابحث عن الإصدار المحدَّث، ونزّله. لا تُحذف ملفات GGUF القديمة تلقائيًا — احذفها يدويًا من `~/.ollama/models` (Ollama) أو `~/Library/Application Support/LM Studio/models` (macOS) لتحرير مساحة القرص. وتظهر النماذج الجديدة عادةً في مكتبة Ollama خلال أيام من الإصدار الرسمي.
ما أفضل نماذج Ollama في 2026؟
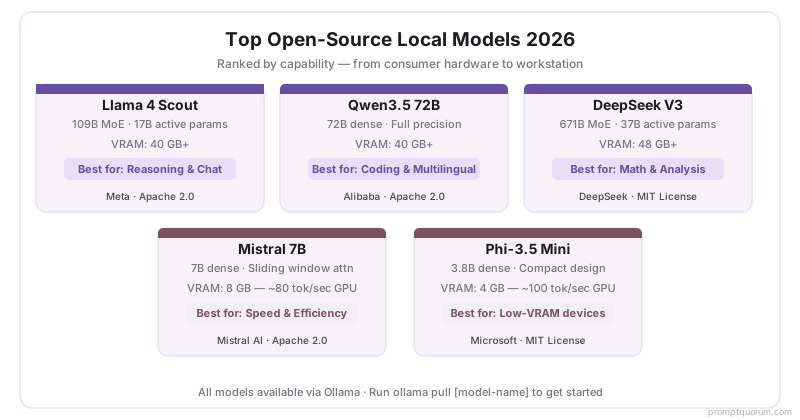
أبرز الخيارات في مكتبة Ollama: Qwen3.8-27B (اختيارنا لبطاقة 24 GB، `ollama pull qwen3.8:27b`، 18 GB)، وgpt-oss:20b (نموذج صغير، فئة 16 GB)، وGemma 4 (رؤية واستدعاء أدوات، من E2B إلى 31B؛ ويبلغ حجم `ollama pull gemma4:12b` نحو 8 GB)، وQwen3 8B (`ollama pull qwen3:8b`، نحو 5 GB) لأجهزة 8 GB، ونماذج DeepSeek-R1 المقطّرة للاستدلال خطوة بخطوة. شغّل أي نموذج بالأمر `ollama run <name>` بعد سحبه.
ما أفضل نموذج محلي لبطاقة RTX 3060 بذاكرة 12 GB VRAM؟
تُعدّ RTX 3060 بذاكرة 12 GB بطاقة GPU جيدة للنماذج المحلية. أنسب الخيارات: Qwen3 14B (نحو 9 GB، 9-12 توكن/ثانية)، وGemma 4 12B (نحو 8 GB، 11-14 توكن/ثانية)، وQwen3 8B (16-20 توكن/ثانية)، أو DeepSeek-R1 7B (10-12 توكن/ثانية). أما Llama 4 Scout فلا يتسع: فهو يحتاج إلى نحو 67 GB. كما تضعك ذاكرة 12 GB VRAM فوق RTX 3060 Ti (8 GB)، وتتيح لك تشغيل نماذج فئة 13-14B بجودة كاملة.
Ollama مقابل LM Studio مقابل Jan.ai: أيها أستخدم؟
استخدم Ollama إن أردت أداة CLI بواجهة API متوافقة مع OpenAI على `localhost:11434` — الأنسب للمطورين والأتمتة. استخدم LM Studio إن أردت واجهة رسومية لسطح المكتب، ومتصفّح نماذج مدمج، وواجهة محادثة — الأنسب للمبتدئين. استخدم Jan.ai إن أردت تطبيق محادثة يركّز على الخصوصية مع متجر نماذج مدمج. الثلاثة تدعم نفس نماذج GGUF. وقت الإعداد: Ollama دقيقتان، LM Studio 5 دقائق، Jan.ai 5 دقائق.
ما أفضل بطاقات GPU الاقتصادية للنماذج المحلية في 2026؟
بحسب دليلنا للبطاقات الاقتصادية: تُعدّ RTX 3060 12 GB المستعملة (نحو 270-300$، أسعار الولايات المتحدة) أرخص بطاقة تستحق الشراء؛ فهي تشغّل Qwen3 14B بسرعة 9-12 توكن/ثانية وQwen3 8B بسرعة 16-20 توكن/ثانية. ومن البطاقات الجديدة RTX 5060 Ti 16 GB (نحو 570-600$) وIntel Arc B580 12 GB (نحو 250-290$). ارتفعت الأسعار في 2026 بسبب نقص الذاكرة، فراجع الدليل لمعرفة الأرقام الحالية. الحد الأدنى الموصى به: 8 GB VRAM لاستدلال 7B مفيد.
هل النموذج اللغوي المحلي أفضل من ChatGPT؟
من ناحية الخصوصية والتكلفة، نعم. ومن ناحية جودة المخرجات الخام في أصعب المهام، لا في الغالب: فما زالت النماذج السحابية الرائدة تتفوّق على النماذج القابلة للتشغيل محليًا في الاستدلال المعقّد. أما في المهام اليومية، فإن نموذجًا محليًا من فئة 27B على بطاقة GPU بذاكرة 24 GB بديل قدير بتكلفة صفر لكل استعلام.
كم ذاكرة RAM أحتاج لتشغيل نموذج لغوي محلي؟
الحد الأدنى: 8 GB RAM لتشغيل نموذج 7B بتكميم Q4. الموصى به: 16 GB لنماذج 13B، ونحو 48 GB لنماذج 70B (نحو 42 GB لأوزان Q4 مع هامش إضافي). تُحتسب الذاكرة الموحّدة في Apple Silicon بالكامل ضمن هذا — جهاز M3 Mac بذاكرة 18 GB يشغّل نموذج 13B بشكل جيد. ذاكرة VRAM تعادل ذاكرة RAM في استدلال GPU.
كيف أشغّل نموذجًا لغويًا محليًا؟
ثبّت Ollama (ollama.com)، ثم شغّل أمرًا واحدًا: `ollama run llama3.1:8b`. يُنزَّل النموذج تلقائيًا وتستطيع بدء المحادثة خلال أقل من 5 دقائق. بلا مفتاح API، وبلا حساب، وبلا حاجة لاتصال إنترنت بعد التنزيل الأولي.
ما أفضل نموذج لغوي محلي مجاني حاليًا؟
لبطاقة GPU بذاكرة 24 GB: Qwen3.8-27B (18 GB، `ollama pull qwen3.8:27b`). لذاكرة 16 GB: gpt-oss:20b أو Gemma 4 12B. لذاكرة 8 GB: Qwen3 8B. لأنظمة CPU فقط: Phi-4 Mini. كلها مفتوحة الأوزان ويمكن تنزيلها مجانًا عبر `ollama pull`؛ راجع كل رخصة قبل الاستخدام التجاري.
هل النماذج اللغوية المحلية تحافظ على الخصوصية؟
نعم، فيما يخص الاستدلال. عند التشغيل عبر Ollama أو LM Studio، تُعالَج مطالباتك ومستنداتك وردودك على جهازك ولا تُرسَل إلى خادم مزوّد النموذج. أما فحوص التحديث والتتبّع الاختياري فمسألة منفصلة، فراجع إعدادات كل تطبيق. المعالجة المحلية مناسبة للمعلومات السرية والشخصية وتُسهّل العمل على GDPR، لكن الامتثال القانوني يتوقف على إعدادك بالكامل.
أهم النقاط
- 8 GB RAM كافية لتشغيل نموذج 7B محليًا (Ollama أو LM Studio، إعداد أقل من 10 دقائق)
- تشغّل 48 GB VRAM نموذج 70B بتكميم Q4 (نحو 42 GB للأوزان)؛ أما Llama 4 Scout (MoE بحجم 109B) فيحتاج نحو 67 GB
- يخفّض تكميم Q4 استهلاك الذاكرة إلى نحو ربع FP16 مع خسارة صغيرة في الجودة — نموذج 7B يعمل بذاكرة 4-5 GB VRAM
- تغطي النماذج مفتوحة الأوزان مثل Qwen3.8 وGemma 4 وgpt-oss معظم مهام البرمجة والكتابة اليومية؛ وتبقى النماذج السحابية الرائدة في المقدمة في المهام متعددة الخطوات الأصعب
- تكلفة API صفر بعد شراء الجهاز — بلا حدود استخدام، وبلا ارتباط بمزوّد واحد
- تبقى مطالباتك وملفاتك على جهازك دون تخزين سحابي — راجع إعداد التتبّع في كل تطبيق؛ والمعالجة المحلية تُسهّل العمل على GDPR لكنها لا تحلّ محله
- الضبط الدقيق بـLoRA يحتاج 500+ مثال موسوم و24 GB+ VRAM على الأقل (أو GPU سحابي للتدريب)
- دليل نشر Qwen المحلي 2026 — إعداد Ollama بأمر واحد لـQwen 3.6 27B وQwen3 8B، مع مستويي Coder وVL
- أفضل GPU بأقل من 500$ لاستدلال LLM — يتصدّر Intel Arc B580 بذاكرة 12 GB، وتأتي RTX 3060 12 GB المستعملة بديلًا لمستخدمي CUDA
- DeepSeek مقابل Qwen: مقارنة محلية 2026 — مقارنة مباشرة بمعايير الأداء
- Alibaba Cloud GPU مقابل Tencent Cloud GPU للذكاء الاصطناعي 2026 — بطاقات سحابية للسوق الصيني
- حاسبة تكلفة LLM المحلي: بناء أم إيجار 2026 — حاسبة عائد استثمار لـ3 سنوات
أحدث النماذج المضافة
| النموذج | أمر السحب | حجم التنزيل | ملاحظات |
|---|---|---|---|
| Qwen3.8-27B | ollama pull qwen3.8:27b | 18 GB | من Alibaba. سياق 256K، إدخال نصوص وصور؛ اختيارنا لبطاقات 24 GB |
| Gemma 4 12B | ollama pull gemma4:12b | 8 GB | من Google. سياق 256K، رؤية واستدعاء أدوات؛ يناسب بطاقة GPU بذاكرة 12 GB |
| gpt-oss 20B | ollama pull gpt-oss:20b | 14 GB | من OpenAI. سياق 128K، أوزان مفتوحة؛ يناسب بطاقة GPU بذاكرة 16 GB |
| Qwen3.5 4B | ollama pull qwen3.5:4b | 4 GB | من Alibaba. إدخال نصوص وصور؛ اختيارنا للنماذج الصغيرة على أجهزة 8 GB |
أفضل LLM محلي حسب مستوى VRAM
هل تعرف بالفعل سعة VRAM في GPU؟ ابحث عن مستواك أدناه لأفضل نموذج مناسب — للمعادلة الكاملة وحساب التكميم واستثناءات نماذج MoE، راجع دليل VRAM الكامل.
| VRAM | أفضل نموذج (Q4) | أمثلة GPU |
|---|---|---|
| 4 GB | Llama 3.2 3B أو Phi-4 Mini (~2–2.5 GB) | RTX 3050 4GB, GTX 1650 |
| 8 GB | Llama 3.1 8B أو Qwen3 8B (~4-5 GB) | RTX 4060 Ti 8GB, RTX 3070 |
| 12 GB | Qwen3 14B (~8.4 GB)، أو 7-8B بجودة Q5/Q8 لأداء أعلى | RTX 3060 12GB, RTX 4070 |
| 16 GB | Qwen3 14B بجودة Q5/Q8، أو فئة 22B (~13 GB) | RTX 4060 Ti 16GB, RTX 4080 |
| 24 GB | Qwen3.8-27B (~18 GB، خيارنا الأول لبطاقات 24 GB) | RTX 4090, RTX 3090 |
| 32 GB | 22-32B بدقة كاملة، أو بطاقة واحدة في نظام مزدوج GPU لـ70B | RTX 5090 |
| 48 GB | نماذج 70B بتكميم Q4 (~42 GB)؛ لا يتسع Q5 (~50 GB) | 2x RTX 4090, RTX 6000 Ada |
أكبر LLM يمكنك تشغيله محليًا
الذاكرة هي التي تحدد الحد الأقصى، لا البرنامج: عند Q4 يحتاج النموذج إلى نحو 0.6 GB لكل مليار معامل، إضافةً إلى 1–2 GB هامش أمان. بطاقة بسعة 24 GB تشغّل نموذجًا من فئة 27B، وسعة 48 GB تشغّل نموذج 70B.
| النموذج | التكميم | حجم الأوزان | يناسب |
|---|---|---|---|
| Qwen3.8-27B | Q4 | ~18 GB | 24 GB VRAM |
| 70B (Llama 3.3, Qwen) | Q4 | ~42 GB | 48 GB VRAM |
| 70B | Q5 | ~50 GB | أكثر من بطاقة واحدة بسعة 48 GB |
| 70B | Q8 | ~74 GB | إعداد متعدد GPU |
ذاكرة VRAM غير كافية؟ راجع تشغيل نماذج 70B على 24 GB VRAM ودليل VRAM الكامل.
أفضل تكميم لذاكرة 16 GB VRAM أو RAM
الحجم بعد التكميم تقريبًا: عدد المعاملات × 0.6 GB عند Q4، و×0.7 عند Q5، و×1.05 عند Q8، مع إضافة 1–2 GB للسياق. على 16 GB VRAM يُعد Q5 خيارًا افتراضيًا جيدًا لنماذج 12–14B، ولا يتسع نموذج 22B إلا عند Q4. وإذا كانت لديك 16 GB RAM بلا GPU فاعتبر الميزانية نصفها: نموذج 12B عند Q4 (نحو 7.2 GB) هو الخيار المريح.
| حجم النموذج | Q4 | Q5 | Q8 | هل يناسب 16 GB VRAM؟ |
|---|---|---|---|---|
| 8B | ~4.8 GB | ~5.6 GB | ~8.4 GB | Q4 وQ5 وQ8 |
| 12B | ~7.2 GB | ~8.4 GB | ~12.6 GB | Q4 وQ5 وQ8 |
| 14B | ~8.4 GB | ~9.8 GB | ~14.7 GB | Q4 وQ5 |
| 22B | ~13.2 GB | ~15.4 GB | ~23.1 GB | Q4 فقط |
لمقارنة الجودة بين مستويات البت، راجع شرح تكميم LLM.
أفضل النماذج لحاسوب متوسط الفئة في LM Studio
الحاسوب متوسط الفئة هو ما يملك 12–16 GB VRAM، مثل RTX 3060 12 GB أو RTX 4060 Ti 16 GB. في LM Studio ابحث عن النموذج، واختر ملف Q4 إذا كان حجمه مضافًا إليه 1–2 GB يتسع في ذاكرة VRAM، ثم ارتقِ إلى Q5 عند توفر مساحة.
| VRAM | نموذج للتجربة | الحجم التقريبي |
|---|---|---|
| 12 GB | Qwen3 14B عند Q4 (أو نموذج من فئة 12B) | ~8.4 GB (12B: ~7.2 GB) |
| 16 GB | Qwen3 14B عند Q5 | ~9.8 GB |
| 16 GB | نموذج من فئة 22B عند Q4 | ~13.2 GB |
الإعداد: كيفية تثبيت LM Studio. لست متأكدًا من التطبيق المناسب؟ اقرأ Ollama مقابل LM Studio.
RAG محلي على حاسوب محمول بذاكرة قليلة
يحتاج RAG إلى نموذجين صغيرين: نموذج تضمين (nomic-embed-text بـ 137M معامل) ونموذج محادثة. على جهاز بلا GPU يحتاج نموذج المحادثة إلى ضعف حجمه عند Q4 على GPU تقريبًا: نموذج 1B نحو 1.2 GB ونموذج 3B نحو 3.6 GB. الحاسوب بذاكرة 2 GB هو الحد الأدنى، ولا يترك هامشًا يُذكر للنظام والفهرس، ونقطة البداية العملية هي 8 GB.
| ذاكرة النظام RAM | نموذج المحادثة (Q4) | الذاكرة (CPU فقط) |
|---|---|---|
| 2 GB | Llama 3.2 1B + nomic-embed-text | ~1.2 GB لنموذج المحادثة، ضيق جدًا |
| 8 GB | Llama 3.2 3B + nomic-embed-text | ~3.6 GB |
| 16 GB | نموذج 7–8B | ~8.4–9.6 GB |
الأرقام تقديرات من معادلة VRAM وليست قياسات أداء. الإعداد الكامل: دليل RAG المحلي وأفضل أدوات RAG المحلية.
Ollama مقابل LM Studio مقابل Jan.ai: أيهما تختار؟
| الميزة | Ollama | LM Studio | Jan.ai |
|---|---|---|---|
| الواجهة | طرفية (CLI) | واجهة سطح مكتب | واجهة سطح مكتب + محادثة |
| نقطة نهاية API | localhost:11434 | localhost:1234 | localhost:1337 |
| متصفح النماذج | CLI فقط | مدمج | مدمج |
| الأنسب لـ | المطورون، الأتمتة | المبتدئون، مستخدمو GUI | محادثة تراعي الخصوصية |
| وقت الإعداد | دقيقتان | 5 دقائق | 5 دقائق |
الامتثال والسياق الإقليمي
الخليج / PDPL
تعالج النماذج اللغوية المحلية البيانات داخل منشأتك. ومع تشفير القرص الكامل وسجلّ الوصول، يُبقي الاستدلال المحلي البيانات الشخصية داخل أنظمتك. وإذا لم يكن بوسع أي طرف ثالث الوصول إلى البيانات، فلا حاجة إلى اتفاقية معالجة بموجب المادة 28 من GDPR في خطوة الاستدلال؛ أما التزاماتك الأخرى (الأساس القانوني، والأمن، وسجلّ أنشطة المعالجة) فتبقى سارية. يرتبط Ollama افتراضيًا بـ`localhost` فقط، فلا يتعرّض للشبكة الخارجية.
الاتحاد الأوروبي / GDPR
يقيّد قانون حماية المعلومات الشخصية في اليابان (APPI) نقل البيانات الشخصية عبر الحدود. وتشغيل النموذج محليًا يتجنّب هذا النقل في خطوة الاستدلال. وتشجّع إرشادات الحوكمة للذكاء الاصطناعي الصادرة عن وزارة الاقتصاد والتجارة والصناعة اليابانية (METI) عام 2024 الذكاء الاصطناعي الحافظ للخصوصية، والنشر المحلي ينسجم مع هذا التوجّه.
الصين / CAC
تُلزم «التدابير المؤقتة لخدمات الذكاء الاصطناعي التوليدي» الصادرة عن إدارة الفضاء السيبراني في الصين (CAC، 2023) مقدّمي خدمات الذكاء الاصطناعي التوليدي الموجّهة للجمهور بالتسجيل. أما النموذج الذي يعمل داخل منشأتك فقط للاستخدام الداخلي فلا يُعدّ عادةً خدمة موجّهة للجمهور، لكن تطبيق القواعد يتوقف على حالة الاستخدام — استشر مختصًا قانونيًا قبل الاعتماد على ذلك.
تنزيل بطاقة مرجعية للنماذج المحلية (PDF)
حسّن نتائجك
هل تشغّل نموذجًا محليًا؟ جودة المخرجات تعتمد على طريقة صياغة مطالبتك. تعلّم تقنيات منهجية للحصول على إجابات أفضل من أي LLM محلي.
إجابات سريعة، بلا قراءة طويلة
لديك سؤال محدد — كم VRAM تحتاج، أي تكميم تختار، Ollama أم LM Studio؟ يجيب Prompt Bites عن أكثر من 100 سؤال من هذا النوع في أقل من دقيقة لكل واحد.
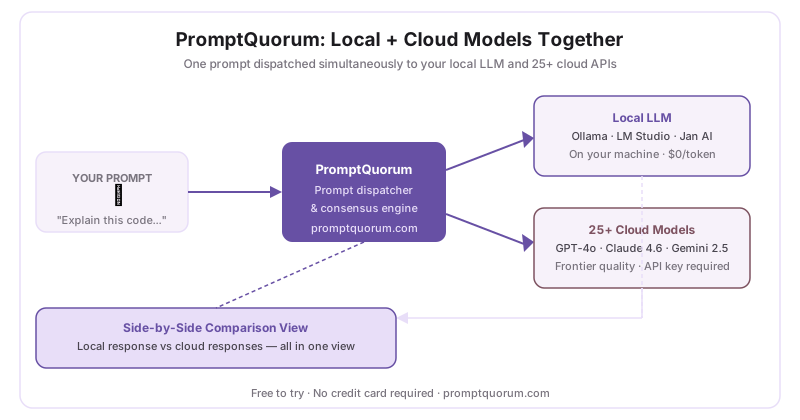
PromptQuorum يتصل بنموذجك اللغوي المحلي (Ollama، LM Studio، Jan AI) ويرسل مطالبتك إلى أكثر من 25 نموذجًا سحابيًا في وقت واحد — قارن نتائج المحلي والسحابي في شاشة واحدة.
جرّب PromptQuorum مجانًا ←