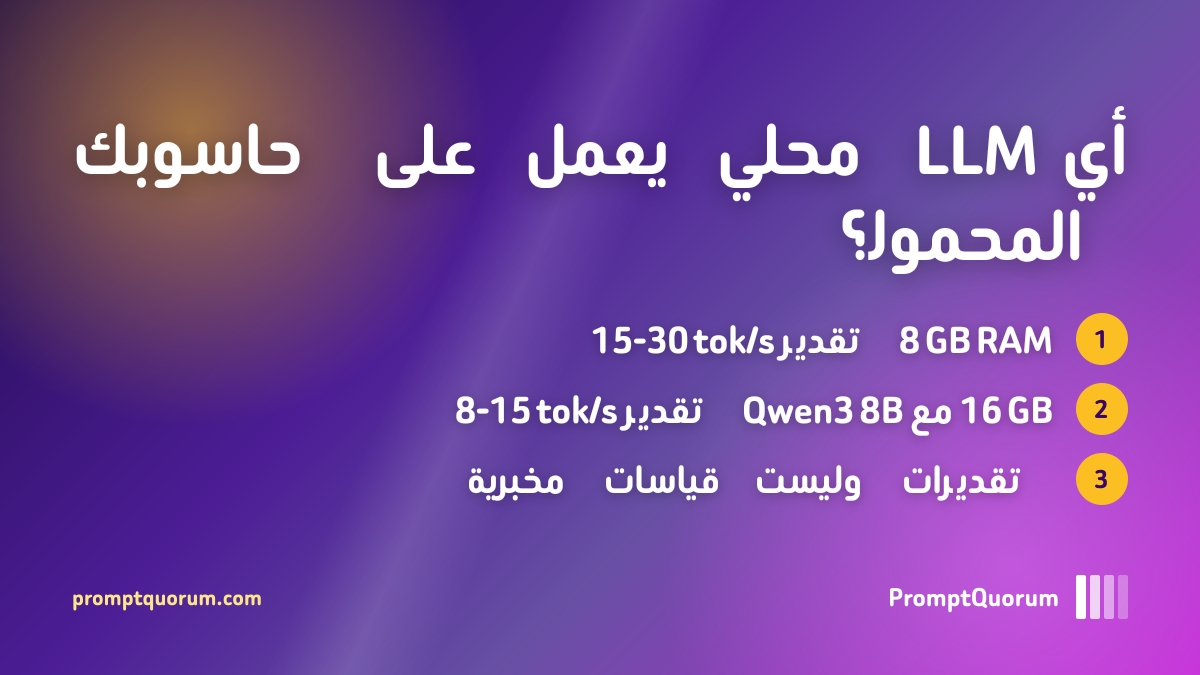
إجابة سريعة: أي LLM محلي يعمل على حاسوبك المحمول (8GB، 16GB، Apple Silicon)؟
يمكنك تشغيل LLM محلي على حاسوب محمول بذاكرة RAM بحجم 8 GB: نموذج 3B–4B بتكميم Q4_K_M يعمل بسرعة تقديرية 15–30 tok/s على ذاكرة ثنائية القناة. يطابق الجدول عتادك مع النموذج المناسب. السرعات تقديرات من PromptQuorum مشتقة من عرض نطاق الذاكرة (tok/s ≈ عرض النطاق ÷ حجم ملف النموذج)، وليست قياسات مخبرية.
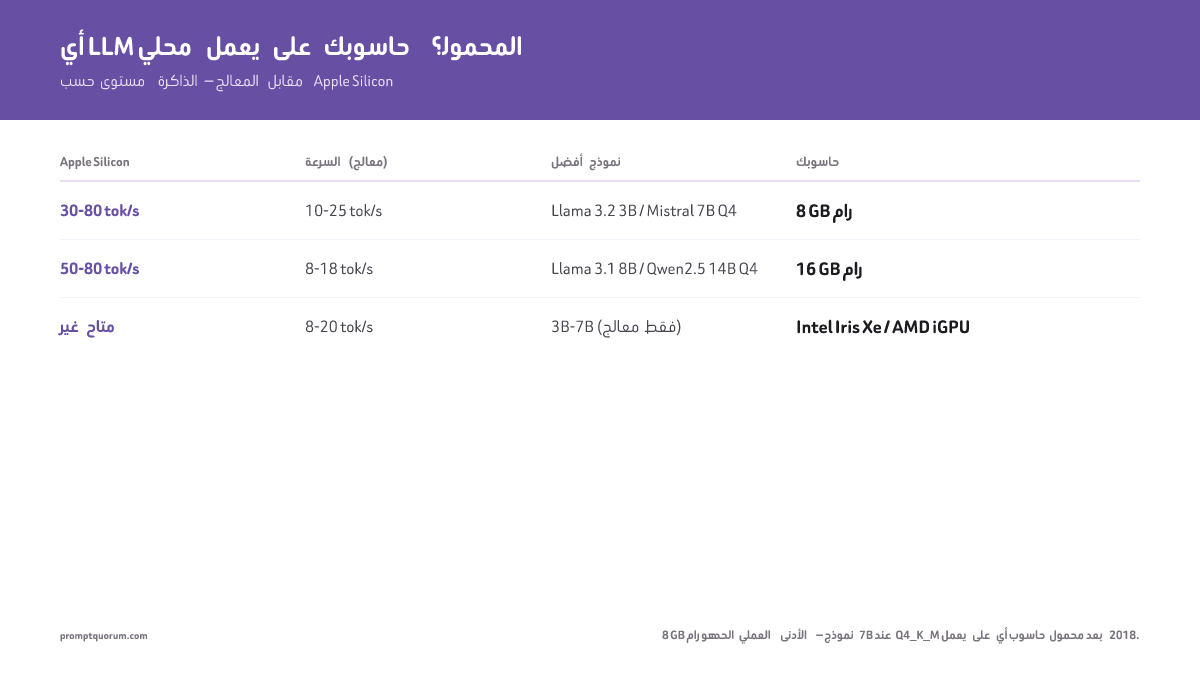
حاسوبك المحمول | أفضل نموذج | tok/s تقديري | افتراض العتاد |
|---|---|---|---|
| 8 GB RAM، CPU فقط | Llama 3.2 3B / Phi-4-mini, Q4_K_M | 15–30 | ذاكرة ثنائية القناة DDR4/DDR5 |
| 16 GB RAM، CPU فقط | Qwen3 8B / Llama 3.1 8B, Q4_K_M | 8–15 | ذاكرة ثنائية القناة DDR4/DDR5 |
| Apple M3، 16 GB | Qwen3 8B, Q4_K_M | 13–17 | ذاكرة موحّدة 100 GB/s |
| Apple M5، 16 GB | Qwen3 8B, Q4_K_M | 21–26 | ذاكرة موحّدة 153 GB/s |
| Intel Iris Xe / AMD iGPU | Llama 3.2 3B / Phi-4-mini, Q4_K_M | 15–30 | تشارك ذاكرة النظام؛ تحقق عبر ollama ps |
في جملة واحدة
يمكن تشغيل LLM محلي على حاسوب محمول باستخدام النماذج المكمَّمة: يقلّص Q4_K_M الملف إلى نحو 31% من حجم FP16 (4.58 GiB بدلاً من 14.96 GiB لنموذج Llama 3.1 8B) مع خسارة صغيرة في الجودة.
بعبارات بسيطة
تشغيل LLM محلياً يعني تشغيل روبوت المحادثة على حاسوبك المحمول بدلاً من خوادم مزوّد الخدمة: خصوصية أعلى وإمكانية الاستخدام دون اتصال، لكنه أبطأ من الخدمة السحابية.
متى تشغّل LLM على حاسوب محمول؟
- ✅ استخدم نماذج LLM المحلية إذا: كنت تحتاج إلى بقاء البيانات على الجهاز، أو تعمل دون اتصال، أو لا تريد تكلفة API لكل رمز
- ❌ لا تستخدمها إذا: كنت تحتاج إلى أقوى جودة استدلال، أو إلى سياق طويل جداً (أكثر من 100K رمز، لأن KV cache ينمو مع السياق)، أو إلى معالجة دفعات سريعة — راجع قيود LLM المحلية
هل يمكن تشغيل LLM محلي على حاسوب محمول؟
نعم -- مع اختيار حجم النموذج المناسب. الحاسوب المحمول بذاكرة 8 GB يشغّل نموذج 3B–4B بتكميم Q4_K_M بسرعة تقديرية 15–30 tok/s على ذاكرة ثنائية القناة (Llama 3.2 3B: 18–30، Phi-4-mini: 15–25). وحاسوب Apple Silicon بذاكرة 16 GB يشغّل نموذج 8B بسرعة تقديرية 13–26 tok/s بحسب الشريحة. هذا أبطأ من معظم واجهات API السحابية، لكنه سريع بما يكفي لمتابعة القراءة أثناء التوليد.
السقف العملي على حاسوب محمول بذاكرة 8 GB هو نموذج 3B–4B؛ أما ملفات 7B–8B (بحجم 4.4–5.2 GB) فتترك مساحة ضيقة لنظام التشغيل والمتصفح. ونموذج 14B بتكميم Q4_K_M (Qwen3 14B: ملف بحجم 9.3 GB) يتسع في جهاز بذاكرة 16 GB فقط مع سياق قصير وإغلاق التطبيقات الأخرى.
السرعات هنا تقديرات من PromptQuorum مشتقة من عرض نطاق الذاكرة، وليست قياسات مخبرية. للفئات الأقل من 8 GB وللقاعدة الكاملة لعرض النطاق راجع أسرع نماذج LLM المحلية للحواسيب منخفضة المواصفات؛ وللحواسيب المحمولة بلا GPU راجع أفضل نماذج LLM المحلية على CPU فقط 2026.
هل يمكن تشغيل RAG (الاسترجاع) على حاسوب محمول؟
نعم -- يعمل RAG على حاسوب محمول، لأن القيد الحاسم يظل نموذج المحادثة وليس طبقة الاسترجاع. تتكون حزمة RAG على الحاسوب المحمول من ثلاثة أجزاء: نموذج تضمين صغير، ومخزن متجهات محلي، ونموذج المحادثة.
نموذج التضمين صغير: حجم nomic-embed-text هو 274 MB على Ollama (نافذة سياق 2K)، لذا فهو يضيف ضغطاً طفيفاً على RAM. على حاسوب بذاكرة 8 GB يمكنك تشغيل نموذج محادثة 3B مع نموذج تضمين؛ وعلى 16 GB يتوفر هامش لنموذج محادثة 8B إلى جانب الاسترجاع.
ذاكرة 2 GB تكفي فقط للإعدادات الصغيرة جداً. نموذج Qwen3 0.6B (523 MB) مع nomic-embed-text يبلغ نحو 0.8 GB من الملفات ويتسع حين تكون 2 GB خالية فعلاً. وفي الحاسوب المحمول المعتاد يستهلك نظام التشغيل 2–3 GB، والتبديل إلى القرص يبطّئ التوليد بشدة، لذا اعتبر 8 GB الحد الأدنى العملي.
ما إعداد الحاسوب المحمول المناسب لحالة استخدامك؟
- للمبتدئين — ذاكرة 8 GB ونماذج 3B–4B وCPU فقط. توقّع سرعة تقديرية 15–30 tok/s. كافية للمحادثة والتلخيص والبرمجة البسيطة.
- للمطورين — ذاكرة 16 GB ونماذج 8B–9B وGPU اختياري. يمكن تعدد المهام دون إغلاق التطبيقات الأخرى (تقديري 8–15 tok/s على CPU).
- للمستخدمين المتقدمين — Apple Silicon بشريحة Pro أو Max، أو حاسوب محمول بـ GPU وذاكرة VRAM لا تقل عن 8 GB، ونماذج 8B–14B. التقديرات لنموذج Qwen3 8B: 41–53 tok/s على M5 Pro (307 GB/s) و34–44 tok/s على GPU الحاسوب المحمول RTX 4060 (نحو 256 GB/s).
من يستطيع تشغيل LLM محلي على حاسوب محمول؟
- المبتدئون ← LM Studio + نموذج 3B
- المستوى المتوسط ← Ollama + نموذج 8B
- المستخدمون المتقدمون ← نموذج 14B مع ضبط التكميم
- ❌ لا تستخدم حاسوباً محمولاً إذا: كنت تحتاج إلى واجهات API فورية (استخدم خادم vLLM)، أو تعالج مجموعات بيانات كبيرة (استخدم وحدات GPU سحابية)
ما حجم نموذج LLM المحلي الذي تحتاجه؟
أحجام الملفات هي تنزيلات Ollama التي جرى التحقق منها على ollama.com بتاريخ 2026-10-23، بتكميم من فئة Q4_K_M (أصغر بنحو 70% من FP16). الحد الأدنى من RAM هو حجم الملف مضافاً إليه نحو 0.5 GB؛ واترك 2–4 GB إضافية لنظام التشغيل والمتصفح:
النموذج | الملف (Ollama) | أدنى RAM | tok/s تقديري | أفضل استخدام |
|---|---|---|---|---|
| Llama 3.2 3B | 2.0 GB | 2.5–3 GB | 18–30 | مهام أساسية ومحادثة وتلخيص |
| Phi-4-mini 3.8B | 2.5 GB | 3 GB | 15–25 | استدلال وبرمجة على ذاكرة 8 GB |
| Qwen3 8B | 5.2 GB | 6 GB | 8–15 | استخدام عام ولغات متعددة وبرمجة |
| Qwen3 14B | 9.3 GB | 10 GB | 4–8 | مهام أصعب على 16 GB بسياق قصير |
هذه تقديرات من PromptQuorum وليست قياسات مخبرية، لحاسوب محمول بذاكرة DDR4-3200 إلى DDR5-5600 ثنائية القناة (51.2–89.6 GB/s)؛ والذاكرة أحادية القناة تخفّضها إلى النصف. مثال Q4_K_M: حجم Llama 3.1 8B هو 14.96 GiB بصيغة FP16 و4.58 GiB بتكميم Q4_K_M (وفق README الخاص بـ quantize في llama.cpp)، أي أصغر بنحو 69%. ← حاسبة VRAM
حاسوب محمول بذاكرة 8 GB مقابل 16 GB: ما الفرق العملي؟
السيناريو | 8 GB RAM | 16 GB RAM |
|---|---|---|
| أقصى حجم للنموذج | 3B–4B براحة؛ 7B–8B (ملفات 4.4–5.2 GB) بضيق | 8B–9B براحة؛ 14B (9.3 GB) بسياق قصير |
| النموذج مع متصفح مفتوح | 3B–4B (بضيق) | 8B–9B براحة |
| أول نموذج موصى به | llama3.2:3b أو phi4-mini | qwen3:8b أو llama3.1:8b |
| التطبيقات المتزامنة | أغلق المتصفح قبل تحميل نموذج 8B | تعدد مهام عادي مع نموذج 8B |
أي نماذج LLM محلية تعمل بأفضل شكل على حاسوب محمول؟
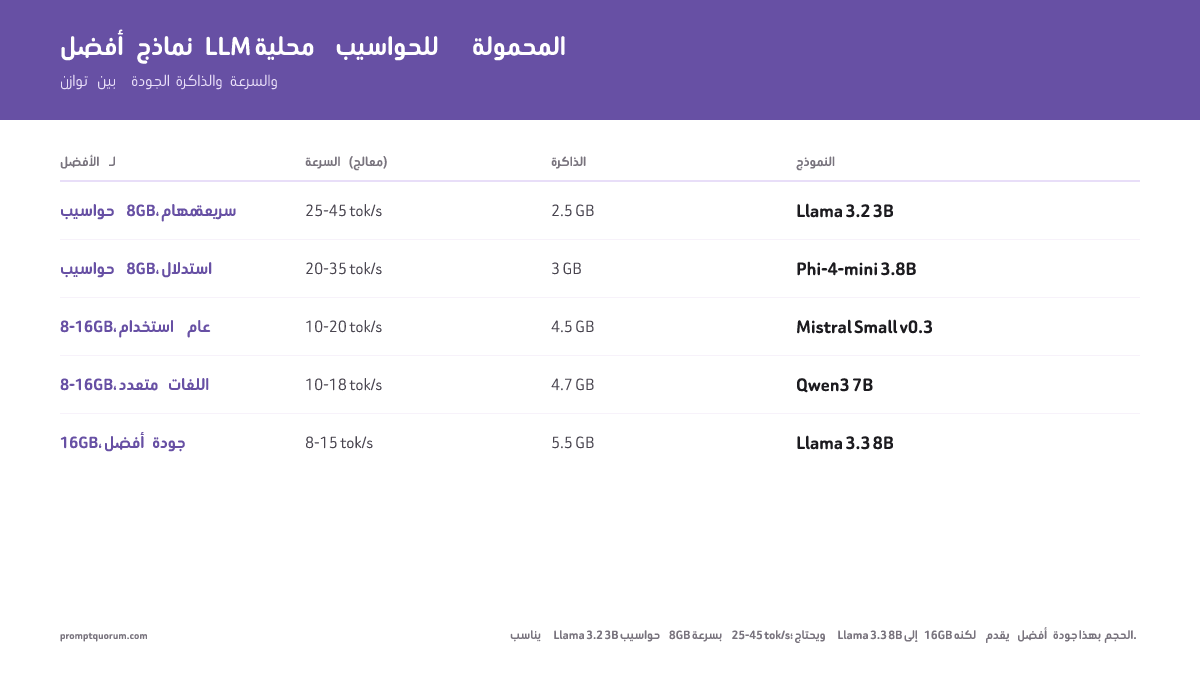
هذه النماذج تناسب حدود الحواسيب المحمولة: الملفات الصغيرة تعطي رموزاً أكثر في الثانية من عرض نطاق الذاكرة نفسه. السرعات تقديرات من PromptQuorum لحاسوب محمول بذاكرة DDR4-3200 إلى DDR5-5600 ثنائية القناة (51.2–89.6 GB/s)، مشتقة من سقف عرض النطاق (عرض النطاق ÷ حجم ملف Ollama)، وليست قياسات مخبرية؛ والذاكرة أحادية القناة تخفّضها إلى النصف. أحجام الملفات هي تنزيلات Ollama التي جرى التحقق منها بتاريخ 2026-10-23. لمتطلبات VRAM عبر النماذج وإعدادات الحواسيب المحمولة راجع دليل متطلبات VRAM ←. ثبّت Ollama لتشغيل أي منها بأمر واحد. بلا GPU؟ راجع أفضل نماذج LLM المحلية على CPU فقط 2026. هذه نماذج مفتوحة الأوزان (open-weights)؛ راجع بطاقة كل نموذج لمعرفة ترخيصه.
النموذج | الملف (Ollama) | أدنى RAM | tok/s تقديري | الأنسب لـ |
|---|---|---|---|---|
| Llama 3.2 3B | 2.0 GB | 2.5–3 GB | 18–30 | حواسيب 8 GB، مهام سريعة |
| Phi-4-mini 3.8B | 2.5 GB | 3 GB | 15–25 | حواسيب 8 GB، استدلال وبرمجة |
| Qwen3 8B | 5.2 GB | 6 GB | 8–15 | حواسيب 16 GB، لغات متعددة وبرمجة |
| Llama 3.1 8B | 4.9 GB | 5.5 GB | 8–14 | حواسيب 16 GB، استخدام عام |
| Qwen3.5 9B | 6.6 GB | 7–8 GB | 6–12 | حواسيب 16 GB، عائلة أحدث، إدخال صور |
بأي إعداد LLM محلي تبدأ على حاسوب محمول؟
عتاد الحاسوب المحمول يحدّ من حجم النموذج، لكن المطالبات الواضحة والمنظمة قد تحسّن مخرجات النماذج الأصغر. راجع دليل هندسة المطالبات لأساليب تناسب النماذج الأصغر.
- 🥇 بداية بسيطة عبر سطر الأوامر: Ollama — أمر واحد لكل نموذج ودعم واسع للنماذج
- 🥈 الأسهل للمبتدئين: LM Studio — واجهة رسومية دون حاجة إلى الطرفية
- 🥉 ذاكرة RAM منخفضة (8 GB): Llama 3.2 3B (Q4_K_M)
- ⚡ جودة أعلى على 16 GB: Qwen3 8B (Q4_K_M، أو Q5_K_M إذا سمحت السرعة)
- 💡 إذا كنت غير متأكد: ابدأ بـ Ollama مع Llama 3.2 3B Q4_K_M
Apple Silicon مقابل الحاسوب المحمول بنظام Windows: أيهما أفضل لـ LLM المحلي؟
حواسيب MacBook بشرائح Apple Silicon خيار قوي لـ LLM المحلي لأن الذاكرة الموحّدة تمنح GPU وصولاً بعرض نطاق عالٍ إلى كامل مجمع الذاكرة. تحدد السرعةَ عرضُ نطاق الذاكرة: تعلن Apple عن 100 GB/s لـ M3 و153 GB/s لـ M5 و307 GB/s لـ M5 Pro و460 أو 614 GB/s لـ M5 Max (بحسب عدد أنوية GPU). ويوفر MacBook Pro بشريحتي M5 Pro وM5 Max، المعلن عنه في 3 مارس 2026، ذاكرة موحّدة تصل إلى 64 GB و128 GB.
قد يكون الحاسوب المحمول بنظام Windows وبـ GPU منفصل من NVIDIA أسرع عندما يتسع النموذج في VRAM. يحتوي GPU الحاسوب المحمول RTX 4060 على 8 GB من GDDR6 بناقل 128 بت (NVIDIA)؛ وبسرعة 16 Gbps (مواصفة من جهة خارجية) يعادل ذلك نحو 256 GB/s، فيكون السقف النظري لنموذج Qwen3 8B (5.2 GB) قرابة 49 tok/s. والمقابل هو ارتفاع استهلاك الطاقة والحرارة.
الحواسيب المحمولة بنظام Windows التي تعتمد على رسوميات Intel Iris Xe أو AMD Radeon المدمجة فقط يحدّها عرض نطاق ذاكرة النظام. وتذكر وثائق Ollama أن دعم Vulkan لـ GPU مفعّل افتراضياً عند تثبيت الواجهة الخلفية، ولا تدرج رسوميات Intel المدمجة في جدول الدعم، لذا تحقق من عمود PROCESSOR في `ollama ps`. ويشارك iGPU الذاكرة نفسها، لذلك تكون المكاسب متواضعة عادةً.
أفضل النماذج للرسوميات المدمجة (Intel Iris Xe / AMD Radeon): مع ذاكرة 16 GB، اختر نموذج 3B–4B بتكميم Q4_K_M للسرعة (Llama 3.2 3B، تقديري 18–30 tok/s على ذاكرة ثنائية القناة) أو Qwen3 8B للجودة (تقديري 8–15 tok/s). وفضّل نموذجاً يبقى ضمن RAM بهامش مريح. لإعداد خطوة بخطوة للأجهزة منخفضة المواصفات راجع أسرع نماذج LLM المحلية للحواسيب منخفضة المواصفات.
طريقة الجدول: كل تقدير يساوي نحو 70–90% من السقف (عرض النطاق ÷ ملف Qwen3 8B بحجم 5.2 GB). وهي تقديرات من PromptQuorum وليست قياسات مخبرية.
نوع الحاسوب المحمول | عرض نطاق الذاكرة | tok/s تقديري لـ Qwen3 8B | أقصى نموذج عملي |
|---|---|---|---|
| Apple M3، 16 GB | 100 GB/s | 13–17 | ~9B (14B بضيق) |
| Apple M5، 16 GB | 153 GB/s | 21–26 | ~9B (14B بضيق) |
| Apple M5 Pro | 307 GB/s | 41–53 | محدود بالذاكرة (حتى 64 GB) |
| Apple M5 Max | 460–614 GB/s | 62–106 | محدود بالذاكرة (حتى 128 GB) |
| حاسوب محمول بـ RTX 4060 (ذاكرة VRAM بحجم 8 GB) | ~256 GB/s | 34–44 | ~8B داخل VRAM |
| حاسوب محمول بذاكرة DDR5-5600 ثنائية القناة | 89.6 GB/s | 12–15 | ~9B (ذاكرة 16 GB) |
| حاسوب محمول بذاكرة DDR4-3200 أحادية القناة | 25.6 GB/s | 3–4 | يُنصح بـ 3B–4B |
هل يكفي الحاسوب المحمول لتشغيل LLM محلي مقارنة بالمكتبي؟
تشغّل الحواسيب المحمولة نماذج 3B–14B بفعالية، لكن الحواسيب المكتبية تستطيع الذهاب أبعد بفضل التبريد الأفضل ووحدات GPU المخصصة ذات عرض نطاق الذاكرة الأعلى بكثير. يمتلك RTX 4090 المكتبي ذاكرة VRAM بحجم 24 GB وعرض نطاق 1,008 GB/s (NVIDIA)، وهو يكفي لاحتواء ملفات نماذج حتى نحو 20 GB داخل VRAM، مثل Gemma 4 31B (19–20 GB على Ollama). أما نموذج 70B بتكميم Q4 فملفه 43 GB على Ollama (llama3.3:70b)، ولا يتسع في 24 GB ويجب تقسيمه مع ذاكرة النظام الأبطأ بكثير.
استخدم الحاسوب المحمول للتنقل والتجربة. واستخدم المكتبي للنماذج الكبيرة (14B فأكثر) وأحمال العمل المستمرة أو الاستدلال في بيئة الإنتاج. هل تختار بين المنصتين؟ راجع دليل شراء الحاسوب المحمول أم المكتبي لـ LLM المحلي لتفصيل كامل للتكلفة والأداء.
كيف تتعامل مع الخنق الحراري على حاسوب محمول؟
يحدث الخنق الحراري عندما يبلغ CPU أو GPU حده الحراري فيخفّض سرعته ليبرد. الاستدلال المحلي حمل مستمر، لذلك قد يتباطأ الحاسوب المحمول النحيف بعد مدة؛ ويتوقف مقدار ذلك وموعده على تصميم التبريد. تحقق من سرعتك خلال 10 دقائق عبر `ollama run <model> --verbose`.
- استخدم حامل حاسوب يتيح مرور الهواء -- رفع الحاسوب يحسّن تدفق هواء العادم وقد يؤخر الخنق.
- جرّب وضع طاقة أقل -- توليد الرموز يحدّه عرض نطاق الذاكرة لا سرعة المعالج، لذا قد تقلل خطة طاقة متوازنة أو منخفضة (في macOS: وضع الطاقة المنخفضة) الحرارة بخسارة سرعة أقل مما تتوقع؛ اختبرها على جهازك.
- قلّل طول التوليد والسياق -- قسّم المهام الطويلة إلى مطالبات أقصر وتجنّب إعادة توليد الاستجابات الطويلة جداً.
- استخدم Q4_K_M بدلاً من Q8_0 -- الملف أصغر بنحو 1.7 مرة (4.58 مقابل 7.95 GiB لنموذج Llama 3.1 8B)، فيقرأ كل رمز بيانات أقل من الذاكرة وتبقى الشريحة تحت الحمل مدة أقصر.
كم تستهلك من البطارية عند تشغيل LLM محلي؟
استنزاف البطارية أثناء الاستدلال المحلي كبير لأن CPU أو GPU يعمل بحمل عالٍ طوال التوليد. مدة التشغيل بالساعات تساوي تقريباً سعة البطارية بالواط-ساعة مقسومة على متوسط استهلاك الطاقة: بطارية 60 Wh عند 20 W تدوم نحو 3 ساعات، وعند 30 W نحو ساعتين. هذه حسابات توضيحية وليست قياسات؛ فاستهلاك الطاقة الفعلي يختلف بحسب الحاسوب والنموذج ووضع الطاقة.
عمر البطارية المعلن لا يصف الاستدلال. فرقم Apple البالغ حتى 16 ساعة من تصفح الويب اللاسلكي لـ MacBook Pro مقاس 14 بوصة بشريحة M5 (بطارية 72.4 Wh) يخص الاستخدام الخفيف، لا التوليد المستمر.
في الجلسات الطويلة وصّل الشاحن. وللاستخدام الموفّر للبطارية اختر نموذجاً أصغر (ملف 3B أقل من نصف حجم ملف 8B، فتنتهي كل استجابة أسرع) وقلّص السياق.
أي مستوى تكميم تستخدم على حاسوب محمول؟
التكميم يقلل دقة النموذج لخفض حاجته إلى RAM وعرض النطاق. وفي الحواسيب المحمولة يُعد Q4_K_M الخيار الافتراضي المعتاد. الأحجام أدناه لنموذج Llama 3.1 8B من README الخاص بـ quantize في llama.cpp (14.96 GiB بصيغة FP16)؛ وتتدرج النماذج الأخرى بصورة مماثلة:
التكميم | الحجم مقابل FP16 | خسارة الجودة | حالة الاستخدام |
|---|---|---|---|
| Q2_K | ~20% (2.95 GiB) | عالية -- تدهور ملحوظ | فقط عندما لا يتسع غيره |
| Q3_K_S | ~23% (3.41 GiB) | متوسطة | إدخال نموذج أكبر في RAM |
| Q4_K_M | ~31% (4.58 GiB) | منخفضة -- الخيار الافتراضي الشائع | معظم الحواسيب المحمولة، توازن جيد |
| Q5_K_M | ~36% (5.33 GiB) | صغيرة | حواسيب 16 GB إذا سمحت السرعة |
| Q8_0 | ~53% (7.95 GiB) | صغيرة جداً | ذاكرة RAM فائضة والسرعة غير حاسمة |
أي قوانين خصوصية تنطبق عند تشغيل LLM محلي على حاسوب محمول؟
الاتحاد الأوروبي (GDPR): عندما يعمل النموذج على حاسوبك المحمول، لا يلزم أن تغادر المطالبات والمستندات الجهاز، مما قد يتجنب إرسال بيانات شخصية إلى معالِج من طرف ثالث. وانطباق GDPR أو قانون الذكاء الاصطناعي الأوروبي أو التزامات أخرى يتوقف على من ينشر النظام ولأي غرض؛ هذا الدليل ليس استشارة قانونية، والامتثال يعتمد على إعدادك بالكامل لا على مكان تشغيل الاستدلال.
ألمانيا: بالنسبة للشركات الألمانية، قد يبسّط إبقاء المستندات على الجهاز أسئلة حماية البيانات، لكن تحديد ما إذا كان الإعداد المحلي يفي بالتزاماتك (مثلاً لبيانات العملاء السرية) يتم حالةً بحالة؛ استشر مسؤول حماية البيانات لديك.
اليابان (APPI): ينظم قانون حماية المعلومات الشخصية في اليابان نقل البيانات الشخصية إلى الخارج. وتشغيل الاستدلال على الحاسوب المحمول يتجنب إرسال المطالبات إلى API في الخارج، مما قد يبسّط مسألة النقل؛ لكنه لا يغني عن تقييم قانوني.
الولايات المتحدة: لا يوجد قانون اتحادي واحد لبيانات الذكاء الاصطناعي؛ بل تنطبق قواعد قطاعية مثل HIPAA (الرعاية الصحية) وFERPA (التعليم) وقوانين الخصوصية في الولايات بحسب الاستخدام. وإبقاء البيانات على جهاز محلي قد يقلل عدد الأطراف الثالثة التي تتعامل معها، لكنك تظل مسؤولاً عن تأمين الجهاز والبيانات.
أسئلة شائعة حول تشغيل LLM محلي على الحواسيب المحمولة
ما أفضل نماذج Ollama لحاسوب بـ Intel Iris Xe وذاكرة 16 GB؟
في حاسوب محمول برسوميات Intel Iris Xe وذاكرة 16 GB، يحدّ السرعةَ عرضُ نطاق ذاكرة النظام. واستخدام Ollama لـ iGPU من عدمه يتوقف على دعم برنامج التشغيل والواجهة الخلفية (تحقق من عمود PROCESSOR في `ollama ps`)، ويشارك iGPU الذاكرة نفسها، لذلك تكون المكاسب متواضعة عادةً. اختر نموذج 3B–4B بتكميم Q4_K_M للسرعة: Llama 3.2 3B (تقديري 18–30 tok/s على ذاكرة ثنائية القناة) عبر `ollama run llama3.2:3b`، أو Qwen3 8B (تقديري 8–15 tok/s) عبر `ollama run qwen3:8b` لجودة أعلى. السرعات تقديرات من PromptQuorum وليست قياسات مخبرية.
هل يمكن تشغيل RAG محلياً على حاسوب محمول؟
نعم. تتكون حزمة RAG على الحاسوب المحمول من نموذج تضمين صغير ومخزن متجهات محلي ونموذج المحادثة. نموذج التضمين صغير (حجم nomic-embed-text هو 274 MB على Ollama)، لذا يظل نموذج المحادثة هو القيد الحاسم في RAM: الحاسوب بذاكرة 8 GB يشغّل نموذج محادثة 3B مع الاسترجاع، وذاكرة 16 GB تترك مجالاً لنموذج 8B. راجع قسم RAG على حاسوب محمول أعلاه لتفصيل RAM.
ما أفضل LLM محلي على CPU فقط لحاسوب محمول؟
من بين النماذج المقارَنة في دليل CPU فقط، يُعد Phi-4 Mini (3.8B، ملف بحجم 2.5 GB) أفضل خيار شامل بسرعة تقديرية 15–25 tok/s على ذاكرة ثنائية القناة، ويُعد Llama 3.2 3B (ملف بحجم 2.0 GB) أصغر ملف بسرعة تقديرية 18–30 tok/s، وكلاهما بتكميم Q4_K_M. للمقارنة الكاملة وأوامر Ollama راجع أفضل نماذج LLM المحلية على CPU فقط 2026.
هل يضر تشغيل LLM محلي بحاسوبي المحمول مع الوقت؟
لا يُتوقع ضرر فوري على حاسوب محمول سليم: الشرائح تخفّض سرعتها عند ارتفاع حرارتها، لذا يبطّئ الاستدلال المستمر الجهازَ ولا يتلفه. ومع ذلك تمثل الحرارة المستمرة تآكلاً للمراوح والبطارية مع الوقت، فاستخدم حاملاً أو قاعدة تبريد، وأبقِ فتحات التهوية مفتوحة، وخذ فترات راحة. واتبع إرشادات الشركة المصنّعة بشأن الحرارة والعناية بالبطارية.
هل يمكن تشغيل LLM محلي على حاسوب محمول بذاكرة 4 GB؟
بصعوبة. يتسع نموذج صغير مثل Qwen3 1.7B (ملف بحجم 1.4 GB) أو Llama 3.2 1B (ملف بحجم 1.3 GB)، لكن نظام التشغيل يحتاج إلى 2–3 GB، لذا في جهاز بذاكرة 4 GB إجمالاً يُرجَّح أن تصل إلى التبديل (swap) الذي يبطّئ التوليد بشدة. الحد الأدنى العملي لتجربة مريحة هو 8 GB. راجع أسرع نماذج LLM المحلية للحواسيب منخفضة المواصفات.
هل يحتاج حاسوبي المحمول إلى GPU مخصص لتشغيل LLM محلي؟
لا. يعمل Ollama وLM Studio وGPT4All على CPU فقط. يسرّع GPU ذو عرض نطاق الذاكرة العالي التوليد، لكن نماذج 3B–4B قابلة للاستخدام على CPU بسرعة تقديرية 15–30 tok/s على ذاكرة ثنائية القناة. راجع أفضل نماذج LLM المحلية للمبتدئين لتوصيات نماذج مناسبة لـ CPU.
ما أسرع LLM محلي يمكنني تشغيله على MacBook بذاكرة 8 GB؟
من بين النماذج في هذا الدليل، يُعد Llama 3.2 3B بتكميم Q4_K_M (ملف بحجم 2.0 GB) أسرع خيار عملي على MacBook بذاكرة 8 GB. على M2 أو M3 (كلاهما 100 GB/s بحسب Apple) يبلغ سقف عرض النطاق نحو 50 tok/s، وتقدير PromptQuorum هو 35–45 tok/s. أما ملف 8B (بحجم 5.2 GB) فضيق على 8 GB لأن macOS وتطبيقاتك تحتاج إلى ذاكرة أيضاً.
كيف أقلل الخنق الحراري في الحاسوب المحمول أثناء استدلال LLM؟
أربع خطوات: (1) ارفع الحاسوب على حامل يتيح مرور الهواء، (2) جرّب وضع طاقة متوازناً أو منخفضاً، لأن التوليد يحدّه عرض نطاق الذاكرة أكثر من سرعة المعالج، (3) قلّل طول التوليد والسياق، (4) استخدم Q4_K_M بدلاً من Q8_0 ليقرأ كل رمز بيانات أقل. تحقق من سرعتك خلال 10 دقائق عبر `ollama run <model> --verbose`.
هل يمكن تشغيل LLM محلي على Chromebook؟
فقط على أجهزة Chromebook التي فُعِّل فيها Linux (Crostini)، ومع نماذج صغيرة فقط. معظم أجهزة Chromebook تملك ذاكرة 4–8 GB وعرض نطاق ذاكرة متواضعاً، لذا فإن نموذج 1B–3B بتكميم Q4_K_M هو السقف الواقعي وستكون السرعة منخفضة. أجهزة Chromebook التي لا تدعم Linux لا تستطيع تشغيل Ollama.
هل Apple Silicon أفضل من GPU الحاسوب المحمول من NVIDIA لتشغيل LLM محلي؟
يتوقف ذلك على الذاكرة. تتبع السرعةُ عرضَ نطاق الذاكرة وسعتها: MacBook بذاكرة 16 GB وشريحة M5 (153 GB/s) له سقف نحو 29 tok/s لنموذج Qwen3 8B، بينما GPU الحاسوب المحمول RTX 4060 (نحو 256 GB/s، وذاكرة VRAM بحجم 8 GB) له سقف نحو 49 tok/s لكنه لا يحتوي إلا النماذج التي تتسع في 8 GB. وشريحة M5 Pro (307 GB/s) أو M5 Max (460–614 GB/s) بذاكرة أكبر تحتوي نماذج أكبر في ذاكرة سريعة. ويختلف استهلاك الطاقة بحسب الطراز، فتحقق من حاسوبك.
ماذا يحدث إذا كان النموذج أكبر من ذاكرة RAM في حاسوبي المحمول؟
يبدأ نظام التشغيل بالتبديل إلى القرص، أو يفشل تحميل النموذج، وقد يتباطأ التوليد إلى حد الزحف بينما تعمل المراوح بقوة. الحل هو نموذج أصغر، أو مستوى تكميم أدنى (Q4_K_M بدلاً من Q8_0)، أو سياق أقصر (`OLLAMA_CONTEXT_LENGTH`، والقيمة الافتراضية 4096).
كم تدوم البطارية عند تشغيل LLM محلي على حاسوب محمول؟
مدة التشغيل تساوي تقريباً سعة البطارية بالواط-ساعة (Wh) مقسومة على متوسط استهلاك الطاقة بالواط (W). بطارية 60 Wh عند 20 W تدوم نحو 3 ساعات، وعند 30 W نحو ساعتين (حساب توضيحي وليس قياساً). يختلف الاستهلاك الفعلي بحسب الحاسوب والنموذج ووضع الطاقة. وللاستخدام طوال اليوم، وصّل الشاحن.
هل أحتاج إلى اتصال بالإنترنت لتشغيل LLM محلي على حاسوب محمول؟
لا. بعد تنزيل النموذج (وهو يتطلب الإنترنت)، يعمل الاستدلال دون اتصال بالكامل. يعمل النموذج بالكامل على CPU أو GPU الحاسوب المحمول. وهذا يجعل نماذج LLM المحلية مفيدة في السفر والبيئات المؤمَّنة أو المواقع ذات الاتصال غير الموثوق.
هل يمكنني تشغيل LLM محلي على ذاكرة RAM بحجم 8 GB؟
نعم. الحاسوب المحمول بذاكرة 8 GB يشغّل نموذج 3B–4B بتكميم Q4_K_M (ملفات 2.0–2.5 GB) بسرعة تقديرية 15–30 tok/s على ذاكرة ثنائية القناة، أو بسرعة تقديرية 28–45 tok/s على Apple M2 أو M3. أما نماذج 7B–8B (ملفات 4.4–5.2 GB) فضيقة على 8 GB.
ما أسرع حاسوب محمول لتشغيل LLM محلي؟
المواصفتان الأهم لـ LLM المحلي هما عرض نطاق الذاكرة وسعة ذاكرة كافية. تعلن Apple عن 307 GB/s لـ M5 Pro (حتى 64 GB) و460 أو 614 GB/s لـ M5 Max (حتى 128 GB)؛ وتقديرات PromptQuorum لنموذج Qwen3 8B هي 41–53 tok/s على M5 Pro و62–106 tok/s على M5 Max. وفي Windows، فإن الحاسوب المحمول بـ GPU من NVIDIA يحتوي النموذج في VRAM له سقف مرتفع، مثلاً نحو 256 GB/s لـ GPU الحاسوب المحمول RTX 4060 بذاكرة 8 GB.
ما مدى بطء LLM المحلي على CPU؟
السرعة لا تتجاوز عرض نطاق الذاكرة ÷ حجم ملف النموذج. على ذاكرة DDR4/DDR5 ثنائية القناة يعمل نموذج 3B–4B بتكميم Q4_K_M بسرعة تقديرية 15–30 tok/s، ونموذج Qwen3 8B بسرعة تقديرية 8–15 tok/s؛ والذاكرة أحادية القناة تخفّض ذلك إلى النصف. هذا بطيء بما يكفي لمتابعة القراءة لكنه سريع بما يكفي للمحادثة والتلخيص. وتصل Apple Silicon إلى سرعة تقديرية 13–26 tok/s لنموذج Qwen3 8B (من M3 إلى M5) لأن الذاكرة الموحّدة ذات عرض نطاق أكبر.
المصادر
- المواصفات التقنية لـ Apple MacBook Pro -- عرض نطاق الذاكرة لـ M5 (153 GB/s) وM5 Pro (307 GB/s) وM5 Max (460 و614 GB/s)، وعمر البطارية المعلن. apple.com/macbook-pro/specs
- المواصفات التقنية لـ Apple MacBook Air (مقاس 15 بوصة، M3، 2024) -- عرض نطاق ذاكرة M3 البالغ 100 GB/s. support.apple.com
- غرفة أخبار Apple: M2 -- عرض نطاق الذاكرة الموحّدة 100 GB/s. apple.com/newsroom
- غرفة أخبار Apple: MacBook Pro بشريحتي M5 Pro وM5 Max (3 مارس 2026) -- ذاكرة موحّدة تصل إلى 64 GB و128 GB. apple.com/newsroom
- مقارنة GeForce للحواسيب المحمولة من NVIDIA -- GPU الحاسوب المحمول RTX 4060: ذاكرة GDDR6 بحجم 8 GB وناقل 128 بت. nvidia.com
- Notebookcheck: RTX 4060 Laptop GPU -- سرعة ذاكرة 16 Gbps (من جهة خارجية؛ أساس رقم ~256 GB/s). notebookcheck.net
- مواصفات NVIDIA GeForce RTX 4090 -- ذاكرة VRAM بحجم 24 GB وعرض نطاق 1,008 GB/s. nvidia.com
- مكتبة Ollama -- أحجام الملفات جرى التحقق منها بتاريخ 2026-10-23: llama3.2، phi4-mini، qwen3، qwen3.5، llama3.1، llama3.3، gemma4.
- الأسئلة الشائعة لـ Ollama -- طول السياق الافتراضي 4096، وOLLAMA_CONTEXT_LENGTH، ونوع KV cache، وkeep-alive، و`ollama ps`. docs.ollama.com/faq
- وثائق GPU في Ollama -- Metal على Apple Silicon وVulkan ووحدات GPU المدعومة. docs.ollama.com/gpu
- README الخاص بـ quantize في llama.cpp -- أحجام الملفات حسب نوع التكميم لنموذج Llama 3.1 8B. github.com/ggml-org/llama.cpp
- إطار Apple MLX -- تسريع GPU على حواسيب Mac بشرائح Apple Silicon. github.com/ml-explore/mlx
- LM Studio -- متطلبات النظام وتوافق GPU وإعداد الاستدلال المحلي. lmstudio.ai
ما الأخطاء الشائعة عند تشغيل LLM محلي على الحواسيب المحمولة؟
- تشغيل نموذج أكبر من RAM المتاحة ← يبدأ النظام بالتبديل إلى القرص ويتباطأ التوليد بشدة؛ اختر نموذجاً أصغر أو تكميماً أدنى.
- تجاهل الخنق الحراري ← قد تنخفض السرعة المستدامة عندما تبلغ الشريحة حدها الحراري؛ تحقق من سرعتك بعد 10 دقائق عبر `ollama run <model> --verbose`.
- استخدام Q8_0 بدلاً من Q4_K_M ← الملف أكبر بنحو 1.7 مرة (7.95 مقابل 4.58 GiB لنموذج Llama 3.1 8B)، فيحتاج إلى RAM أكثر ويولّد أبطأ على حاسوب محمول محدود عرض النطاق، مقابل مكسب صغير في الجودة.
- التشغيل بشريحة RAM واحدة ← الذاكرة أحادية القناة تخفّض ذروة عرض النطاق وسقف السرعة إلى النصف؛ استخدم شريحتين متطابقتين حيث يسمح الحاسوب بذلك.
- ترك GPU offload معطلاً في LM Studio ← يعمل النموذج على CPU بدلاً من GPU؛ ارفع إعداد GPU offload عندما يتسع النموذج في ذاكرة GPU.
- إبقاء نافذة السياق الافتراضية ← القيمة الافتراضية في Ollama هي 4096 رمزاً، فتُقتطع المستندات متعددة الصفحات؛ ارفعها عبر `OLLAMA_CONTEXT_LENGTH=8192` أو `/set parameter num_ctx 8192` وتوقّع استهلاك ذاكرة أكبر.