빠른 답변: 내 노트북(8GB, 16GB, Apple Silicon)에서는 어떤 로컬 LLM이 실행될까요?
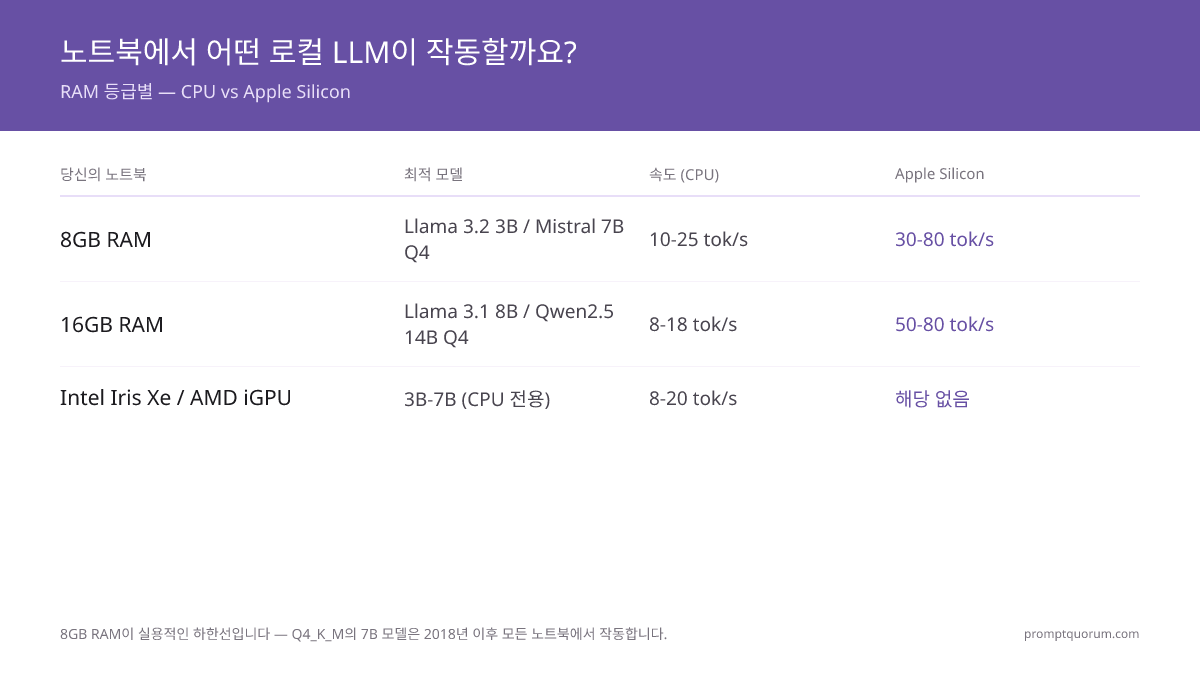
RAM 8 GB 노트북에서도 로컬 LLM을 실행할 수 있습니다. Q4_K_M 3B–4B 모델은 듀얼 채널 RAM에서 추정 15–30 tok/s로 동작합니다. 아래 표는 하드웨어에 맞는 모델을 보여 줍니다. 속도는 메모리 대역폭에서 산출한 PromptQuorum의 추정치(tok/s ≈ 대역폭 ÷ 모델 파일 크기)이며 실험실 측정값이 아닙니다.
내 노트북 | 추천 모델 | 추정 tok/s | 하드웨어 가정 |
|---|---|---|---|
| RAM 8 GB, CPU만 사용 | Llama 3.2 3B / Phi-4-mini, Q4_K_M | 15–30 | 듀얼 채널 DDR4/DDR5 |
| RAM 16 GB, CPU만 사용 | Qwen3 8B / Llama 3.1 8B, Q4_K_M | 8–15 | 듀얼 채널 DDR4/DDR5 |
| Apple M3, 16 GB | Qwen3 8B, Q4_K_M | 13–17 | 통합 메모리 100 GB/s |
| Apple M5, 16 GB | Qwen3 8B, Q4_K_M | 21–26 | 통합 메모리 153 GB/s |
| Intel Iris Xe / AMD iGPU | Llama 3.2 3B / Phi-4-mini, Q4_K_M | 15–30 | 시스템 RAM 공유, ollama ps로 확인 |
한 문장 요약
로컬 LLM은 양자화된 모델을 사용해 노트북에서 실행할 수 있습니다. Q4_K_M은 품질 손실을 조금 감수하는 대신 파일을 FP16 크기의 약 31%로 줄입니다(Llama 3.1 8B 기준 14.96 GiB에서 4.58 GiB로 감소).
쉽게 말하면
LLM을 로컬에서 실행한다는 것은 챗봇을 제공업체의 서버가 아니라 내 노트북에서 돌린다는 뜻입니다. 개인정보를 지키고 오프라인에서도 쓸 수 있지만, 클라우드 서비스보다는 느립니다.
노트북에서 LLM을 실행하는 것이 적합한 경우는 언제인가요?
- ✅ 로컬 LLM이 적합한 경우: 데이터가 기기 안에 머물러야 할 때, 오프라인으로 작업할 때, 토큰당 API 비용을 원하지 않을 때
- ❌ 적합하지 않은 경우: 가장 강력한 추론 품질이 필요할 때, 매우 긴 컨텍스트(100K+ 토큰, 컨텍스트가 길어지면 KV 캐시도 커지기 때문)가 필요할 때, 빠른 배치 처리가 필요할 때 — 로컬 LLM의 한계를 참고하십시오
노트북에서 로컬 LLM을 실행할 수 있나요?
네, 모델 크기만 알맞게 고르면 됩니다. RAM 8 GB 노트북은 Q4_K_M 3B–4B 모델을 듀얼 채널 RAM에서 추정 15–30 tok/s로 실행합니다(Llama 3.2 3B: 18–30, Phi-4-mini: 15–25). 16 GB Apple Silicon 노트북은 칩에 따라 8B 모델을 추정 13–26 tok/s로 실행합니다. 대부분의 클라우드 API보다는 느리지만 읽으면서 따라가기에는 충분히 빠릅니다.
8 GB 노트북의 현실적인 상한은 3B–4B 모델입니다. 7B–8B 파일(4.4–5.2 GB)은 운영체제와 브라우저를 위한 여유가 거의 남지 않습니다. Q4_K_M 14B 모델(Qwen3 14B: 파일 9.3 GB)은 컨텍스트를 짧게 하고 다른 앱을 닫은 경우에만 16 GB 기기에 들어갑니다.
여기의 속도는 메모리 대역폭에서 산출한 PromptQuorum의 추정치이며 실험실 측정값이 아닙니다. 8 GB 미만 구간과 전체 대역폭 법칙은 저사양 PC용 가장 빠른 로컬 LLM을, GPU가 없는 노트북은 CPU 전용 최고의 로컬 LLM 2026을 참고하십시오.
노트북에서 RAG(검색 증강 생성)를 실행할 수 있나요?
네, RAG는 노트북에서 실행됩니다. 실제 제약은 검색 계층이 아니라 여전히 채팅 모델이기 때문입니다. 노트북 RAG 구성은 작은 임베딩 모델, 로컬 벡터 저장소, 채팅 모델의 세 부분입니다.
임베딩 모델은 작습니다. nomic-embed-text는 Ollama에서 274 MB(컨텍스트 창 2K)여서 RAM 부담이 거의 없습니다. 8 GB 노트북에서는 3B 채팅 모델과 임베딩 모델을 함께 실행할 수 있고, 16 GB에서는 8B 채팅 모델과 검색을 함께 돌릴 여유가 있습니다.
RAM 2 GB는 아주 작은 구성에서만 동작합니다. Qwen3 0.6B(523 MB)와 nomic-embed-text를 합치면 파일이 약 0.8 GB이므로, 실제로 2 GB가 비어 있다면 들어갑니다. 일반적인 노트북에서는 운영체제가 2–3 GB를 쓰고 디스크 스왑이 발생하면 생성 속도가 크게 떨어지므로, 현실적인 최소 사양은 8 GB로 잡으십시오.
내 용도에는 어떤 노트북 구성이 필요한가요?
- 입문자 — RAM 8 GB, 3B–4B 모델, CPU만 사용. 추정 15–30 tok/s입니다. 채팅, 요약, 간단한 코딩에 충분합니다.
- 개발자 — RAM 16 GB, 8B–9B 모델, GPU는 선택. 다른 앱을 닫지 않고도 멀티태스킹이 가능합니다(CPU에서 추정 8–15 tok/s).
- 고급 사용자 — Pro 또는 Max 칩의 Apple Silicon, 또는 VRAM 8 GB 이상의 노트북 GPU, 8B–14B 모델. Qwen3 8B 추정치는 M5 Pro(307 GB/s)에서 41–53 tok/s, RTX 4060 노트북 GPU(약 256 GB/s)에서 34–44 tok/s입니다.
노트북에서 로컬 LLM을 실행할 수 있는 사람은 누구인가요?
어떤 크기의 로컬 LLM 모델이 필요한가요?
파일 크기는 2026-10-23에 ollama.com에서 확인한 Ollama 다운로드 크기이며, Q4_K_M급 양자화(FP16보다 약 70% 작음) 기준입니다. 최소 RAM은 파일 크기에 오버헤드 약 0.5 GB를 더한 값이며, 운영체제와 브라우저를 위해 2–4 GB를 더 남겨 두십시오.
모델 | 파일(Ollama) | 최소 RAM | 추정 tok/s | 추천 용도 |
|---|---|---|---|---|
| Llama 3.2 3B | 2.0 GB | 2.5–3 GB | 18–30 | 기본 작업, 채팅, 요약 |
| Phi-4-mini 3.8B | 2.5 GB | 3 GB | 15–25 | 8 GB에서의 추론과 코딩 |
| Qwen3 8B | 5.2 GB | 6 GB | 8–15 | 일반 용도, 다국어, 코딩 |
| Qwen3 14B | 9.3 GB | 10 GB | 4–8 | 16 GB에서 더 어려운 작업, 짧은 컨텍스트 |
추정치는 실험실 측정값이 아닌 PromptQuorum의 추정이며, 듀얼 채널 DDR4-3200~DDR5-5600(51.2–89.6 GB/s) 노트북을 기준으로 합니다. 싱글 채널 RAM에서는 절반이 됩니다. Q4_K_M 예시: Llama 3.1 8B는 FP16에서 14.96 GiB, Q4_K_M에서 4.58 GiB(llama.cpp quantize README)로 약 69% 작습니다. → VRAM 계산기
RAM 8 GB와 16 GB 노트북의 실질적인 차이는 무엇인가요?
시나리오 | 8 GB RAM | 16 GB RAM |
|---|---|---|
| 최대 모델 크기 | 3B–4B는 여유 있음, 7B–8B(파일 4.4–5.2 GB)는 빠듯함 | 8B–9B는 여유 있음, 14B(9.3 GB)는 짧은 컨텍스트에서 가능 |
| 브라우저를 연 상태의 모델 | 3B–4B(빠듯함) | 8B–9B도 여유 있음 |
| 처음 쓰기 좋은 모델 | llama3.2:3b 또는 phi4-mini | qwen3:8b 또는 llama3.1:8b |
| 동시에 실행하는 앱 | 8B 모델을 불러오기 전에 브라우저를 닫으십시오 | 8B 모델에서도 일반적인 멀티태스킹 가능 |
노트북에서 가장 잘 돌아가는 로컬 LLM 모델은 무엇인가요?
노트북의 한계에는 파일이 작은 모델이 맞습니다. 같은 메모리 대역폭에서 파일이 작을수록 초당 토큰 수가 늘기 때문입니다. 속도는 듀얼 채널 DDR4-3200~DDR5-5600(51.2–89.6 GB/s) 노트북을 기준으로, 대역폭 상한(대역폭 ÷ Ollama 파일 크기)에서 산출한 PromptQuorum의 추정치이며 실험실 측정값이 아닙니다. 싱글 채널 RAM에서는 절반이 됩니다. 파일 크기는 2026-10-23에 확인한 Ollama 다운로드 크기입니다. 모델과 노트북 구성별 VRAM 요구량은 VRAM 요구량 가이드 →를 참고하십시오. Ollama를 설치하면 이 모델들을 명령어 하나로 실행할 수 있습니다. GPU가 없다면 CPU 전용 최고의 로컬 LLM 2026을 참고하십시오. 이 모델들은 open-weights 모델이므로 라이선스는 각 모델 카드에서 확인하십시오.
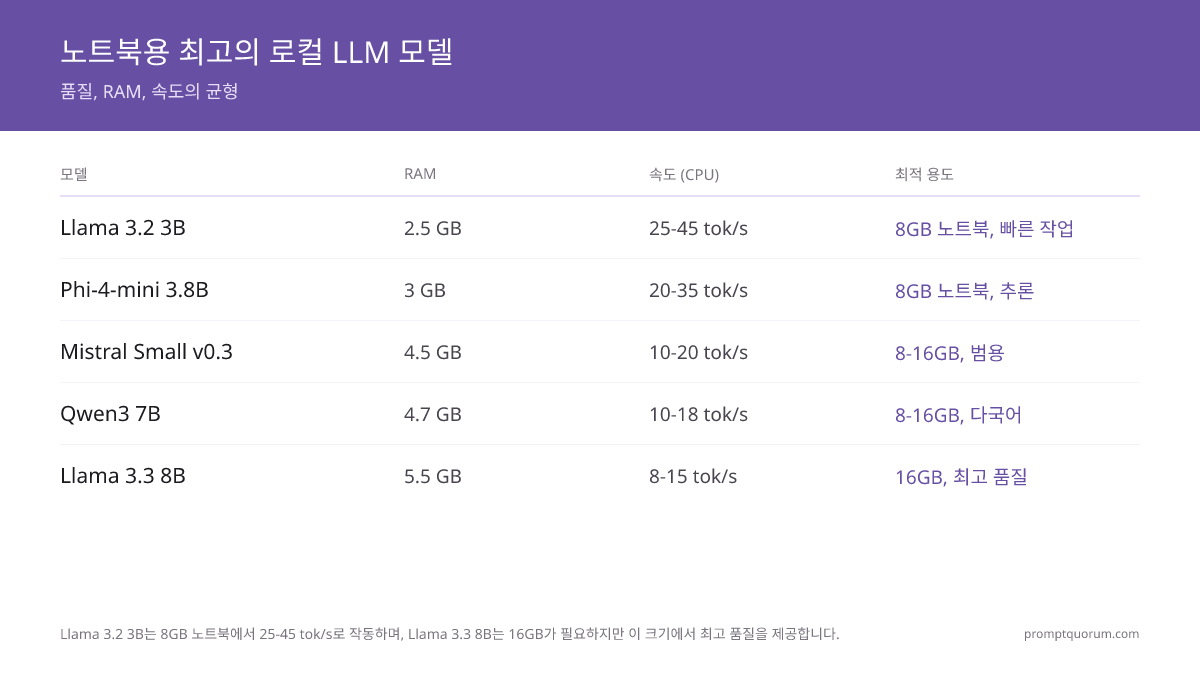
모델 | 파일(Ollama) | 최소 RAM | 추정 tok/s | 추천 대상 |
|---|---|---|---|---|
| Llama 3.2 3B | 2.0 GB | 2.5–3 GB | 18–30 | 8 GB 노트북, 빠른 작업 |
| Phi-4-mini 3.8B | 2.5 GB | 3 GB | 15–25 | 8 GB 노트북, 추론과 코딩 |
| Qwen3 8B | 5.2 GB | 6 GB | 8–15 | 16 GB 노트북, 다국어, 코딩 |
| Llama 3.1 8B | 4.9 GB | 5.5 GB | 8–14 | 16 GB 노트북, 일반 용도 |
| Qwen3.5 9B | 6.6 GB | 7–8 GB | 6–12 | 16 GB 노트북, 최신 모델군, 이미지 입력 |
노트북에서는 어떤 로컬 LLM 구성으로 시작해야 하나요?
노트북 하드웨어는 모델 크기를 제한하지만, 명확하고 구조화된 프롬프트는 작은 모델의 출력 품질을 높일 수 있습니다. 작은 모델에 맞는 기법은 프롬프트 엔지니어링 가이드를 참고하십시오.
Apple Silicon과 Windows 노트북 중 로컬 LLM에는 무엇이 더 나은가요?
Apple Silicon MacBook은 통합 메모리 덕분에 GPU가 전체 메모리 풀에 높은 대역폭으로 접근할 수 있어 로컬 LLM에 유력한 선택입니다. 속도는 메모리 대역폭이 좌우합니다. Apple은 M3를 100 GB/s, M5를 153 GB/s, M5 Pro를 307 GB/s, M5 Max를 460 또는 614 GB/s(GPU 코어 수에 따라 다름)로 공개하고 있습니다. 2026년 3월 3일에 발표된 M5 Pro와 M5 Max MacBook Pro는 각각 최대 64 GB와 128 GB의 통합 메모리를 제공합니다.
외장 NVIDIA GPU를 탑재한 Windows 노트북은 모델이 VRAM에 들어가면 더 빠를 수 있습니다. RTX 4060 노트북 GPU는 128비트 버스에 GDDR6 8 GB를 탑재하며(NVIDIA), 16 Gbps(제3자 사양)에서 약 256 GB/s이므로 Qwen3 8B(5.2 GB)의 상한은 약 49 tok/s입니다. 대신 전력 소비와 발열이 더 큽니다.
Intel Iris Xe나 AMD Radeon 내장 그래픽만 있는 Windows 노트북은 시스템 RAM 대역폭에 제한됩니다. Ollama 문서에 따르면 Vulkan GPU 지원은 백엔드가 설치되어 있으면 기본으로 활성화되며, 지원 표에는 Intel 내장 그래픽이 나와 있지 않으므로 `ollama ps`의 PROCESSOR 열을 확인하십시오. iGPU는 같은 RAM을 공유하므로 개선 폭은 대체로 크지 않습니다.
내장 그래픽(Intel Iris Xe / AMD Radeon)에 가장 잘 맞는 모델: RAM 16 GB라면 속도를 위해 Q4_K_M 3B–4B 모델(Llama 3.2 3B, 듀얼 채널 RAM에서 추정 18–30 tok/s)을, 품질을 위해 Qwen3 8B(추정 8–15 tok/s)를 고르십시오. RAM 안에 여유 있게 들어가는 모델을 우선하십시오. 저사양 환경의 단계별 설정은 저사양 PC용 가장 빠른 로컬 LLM을 참고하십시오.
표 산출 방법: 각 추정치는 상한(대역폭 ÷ 5.2 GB인 Qwen3 8B 파일 크기)의 대략 70–90%입니다. PromptQuorum의 추정치이며 실험실 측정값이 아닙니다.
노트북 유형 | 메모리 대역폭 | Qwen3 8B 추정 tok/s | 현실적 최대 모델 |
|---|---|---|---|
| Apple M3, 16 GB | 100 GB/s | 13–17 | ~9B (14B는 빠듯함) |
| Apple M5, 16 GB | 153 GB/s | 21–26 | ~9B (14B는 빠듯함) |
| Apple M5 Pro | 307 GB/s | 41–53 | 메모리에 따라 제한(최대 64 GB) |
| Apple M5 Max | 460–614 GB/s | 62–106 | 메모리에 따라 제한(최대 128 GB) |
| RTX 4060 노트북 (VRAM 8 GB) | ~256 GB/s | 34–44 | VRAM 내 ~8B |
| 듀얼 채널 DDR5-5600 노트북 | 89.6 GB/s | 12–15 | ~9B (RAM 16 GB) |
| 싱글 채널 DDR4-3200 노트북 | 25.6 GB/s | 3–4 | 3B–4B 권장 |
로컬 LLM에는 데스크톱 대신 노트북으로도 충분한가요?
노트북은 3B–14B 모델을 효과적으로 실행하지만, 데스크톱은 더 나은 냉각과 훨씬 높은 메모리 대역폭의 전용 GPU 덕분에 더 멀리 갈 수 있습니다. 데스크톱 RTX 4090은 VRAM 24 GB와 1,008 GB/s의 대역폭(NVIDIA)을 갖추고 있어 Gemma 4 31B(Ollama에서 19–20 GB)처럼 약 20 GB까지의 모델 파일을 VRAM에 올릴 수 있습니다. Q4 70B 모델은 Ollama에서 파일 크기가 43 GB(llama3.3:70b)로 24 GB에 들어가지 않으며, 훨씬 느린 시스템 RAM으로 나누어 올려야 합니다.
휴대성과 실험에는 노트북을 쓰십시오. 큰 모델(14B 이상), 지속적인 워크로드, 프로덕션 추론에는 데스크톱을 쓰십시오. 플랫폼을 고르는 중이라면 비용과 성능을 자세히 비교한 로컬 LLM용 노트북 대 데스크톱 구매 가이드를 참고하십시오.
노트북의 열 쓰로틀링은 어떻게 다루나요?
열 쓰로틀링은 CPU나 GPU가 온도 한계에 도달해 식히기 위해 클럭을 낮추는 현상입니다. 로컬 추론은 지속적인 부하이므로 얇은 노트북은 시간이 지나면 느려질 수 있으며, 그 정도와 시점은 냉각 설계에 따라 다릅니다. `ollama run <model> --verbose`로 10분 동안의 속도를 직접 확인해 보십시오.
- 통풍 공간이 있는 노트북 거치대를 사용하십시오 — 노트북을 들어 올리면 배기 공기 흐름이 좋아져 쓰로틀링을 늦출 수 있습니다.
- 낮은 전원 모드를 사용해 보십시오 — 토큰 생성은 클럭 속도보다 메모리 대역폭에 좌우되므로, 균형 또는 절전 전원 계획(macOS에서는 저전력 모드)은 발열을 줄이면서 속도 손실은 예상보다 작을 수 있습니다. 내 기기에서 직접 시험해 보십시오.
- 생성 길이와 컨텍스트를 제한하십시오 — 긴 작업은 더 짧은 프롬프트로 나누고, 매우 긴 응답을 다시 생성하는 일은 피하십시오.
- Q8_0 대신 Q4_K_M을 사용하십시오 — 파일이 약 1.7배 작아(Llama 3.1 8B 기준 4.58 GiB 대 7.95 GiB) 토큰마다 메모리에서 읽는 데이터가 줄고 칩에 부하가 걸리는 시간도 짧아집니다.
로컬 LLM을 실행하면 배터리를 얼마나 쓰나요?
로컬 추론 중 배터리 소모는 상당합니다. 생성하는 내내 CPU나 GPU가 높은 부하로 동작하기 때문입니다. 동작 시간(시간)은 대략 배터리 용량(Wh)을 평균 소비 전력(W)으로 나눈 값입니다. 60 Wh 배터리는 20 W에서 약 3시간, 30 W에서 약 2시간 지속됩니다. 이는 설명을 위한 계산 예시이며 측정값이 아닙니다. 실제 소비 전력은 노트북, 모델, 전원 모드에 따라 다릅니다.
공식 배터리 사용 시간은 추론 상황을 설명하지 않습니다. M5가 탑재된 14인치 MacBook Pro(배터리 72.4 Wh)에 대해 Apple이 밝힌 무선 웹 브라우징 최대 16시간은 가벼운 사용 기준이며, 지속적인 생성 기준이 아닙니다.
장시간 사용할 때는 전원을 연결하십시오. 배터리를 아끼려면 더 작은 모델(3B 파일은 8B 파일의 절반보다 작으므로 응답이 더 빨리 끝납니다)을 고르고 컨텍스트를 줄이십시오.
노트북에서는 어떤 양자화 수준을 써야 하나요?
양자화는 모델 정밀도를 낮춰 RAM과 대역폭 요구량을 줄입니다. 노트북에서는 Q4_K_M이 일반적인 기본값입니다. 아래 크기는 llama.cpp quantize README의 Llama 3.1 8B 기준(FP16에서 14.96 GiB)이며, 다른 모델도 비슷한 비율로 달라집니다.
양자화 | FP16 대비 크기 | 품질 손실 | 사용 사례 |
|---|---|---|---|
| Q2_K | ~20% (2.95 GiB) | 높음 — 눈에 띄는 품질 저하 | 다른 방법이 모두 맞지 않을 때만 |
| Q3_K_S | ~23% (3.41 GiB) | 중간 | 더 큰 모델을 RAM에 맞춰 넣을 때 |
| Q4_K_M | ~31% (4.58 GiB) | 낮음 — 일반적인 기본값 | 대부분의 노트북, 균형이 좋음 |
| Q5_K_M | ~36% (5.33 GiB) | 작음 | 속도에 여유가 있는 16 GB 노트북 |
| Q8_0 | ~53% (7.95 GiB) | 매우 작음 | RAM에 여유가 있고 속도가 중요하지 않을 때 |
노트북에서 로컬 LLM을 실행할 때 어떤 개인정보 보호법이 적용되나요?
유럽연합(GDPR): 모델이 내 노트북에서 실행되면 프롬프트와 문서가 기기 밖으로 나가지 않아도 되므로, 개인정보를 제3자 처리자에게 보내는 일을 피할 수 있습니다. GDPR, EU AI Act 등의 의무가 적용되는지는 시스템을 누가 어떤 목적으로 운영하는지에 따라 달라집니다. 이 가이드는 법률 자문이 아니며, 규정 준수는 추론이 실행되는 위치가 아니라 전체 구성에 달려 있습니다.
독일: 독일 기업의 경우 문서를 기기 안에 두면 데이터 보호 문제가 단순해질 수 있지만, 로컬 구성이 의무(예: 기밀 고객 데이터)를 충족하는지는 사안별로 판단됩니다. 데이터 보호 책임자와 상의하십시오.
일본(APPI): 일본의 개인정보보호법(Act on the Protection of Personal Information)은 개인 데이터의 해외 이전을 규율합니다. 노트북에서 추론을 실행하면 프롬프트를 해외 API로 보내지 않아도 되므로 이전 문제가 단순해질 수 있지만, 법적 검토를 대신하지는 않습니다.
미국: 단일 연방 AI 데이터 법은 없으며, 용도에 따라 HIPAA(의료), FERPA(교육) 같은 분야별 규정과 주별 개인정보 보호법이 적용됩니다. 데이터를 로컬 기기에 두면 데이터를 다루는 제3자의 수를 줄일 수 있지만, 기기와 데이터를 안전하게 보호할 책임은 여전히 사용자에게 있습니다.
노트북에서 로컬 LLM을 실행할 때 자주 묻는 질문
RAM 16 GB의 Intel Iris Xe 노트북에 가장 좋은 Ollama 모델은 무엇인가요?
Intel Iris Xe 그래픽과 RAM 16 GB를 갖춘 노트북에서는 시스템 RAM 대역폭이 속도를 제한합니다. Ollama가 iGPU를 사용하는지는 드라이버와 백엔드 지원에 달려 있으며(`ollama ps`의 PROCESSOR 열 확인), iGPU는 같은 RAM을 공유하므로 개선 폭은 대체로 크지 않습니다. 속도를 위해서는 Q4_K_M 3B–4B 모델을 고르십시오. `ollama run llama3.2:3b`로 Llama 3.2 3B(듀얼 채널 RAM에서 추정 18–30 tok/s)를, 더 높은 품질을 원하면 `ollama run qwen3:8b`로 Qwen3 8B(추정 8–15 tok/s)를 실행합니다. 속도는 PromptQuorum의 추정치이며 실험실 측정값이 아닙니다.
노트북에서 RAG를 로컬로 실행할 수 있나요?
네. 노트북 RAG 구성은 작은 임베딩 모델, 로컬 벡터 저장소, 채팅 모델로 이루어집니다. 임베딩 모델은 작아서(nomic-embed-text는 Ollama에서 274 MB) RAM의 실제 제약은 계속 채팅 모델입니다. 8 GB 노트북은 3B 채팅 모델과 검색을 함께 실행하고, 16 GB에서는 8B 모델을 올릴 여유가 있습니다. RAM 구성은 위의 노트북에서의 RAG 섹션을 참고하십시오.
노트북에 가장 좋은 CPU 전용 로컬 LLM은 무엇인가요?
CPU 전용 가이드에서 비교한 모델 중에서는 Phi-4 Mini(3.8B, 파일 2.5 GB)가 듀얼 채널 RAM에서 추정 15–25 tok/s로 가장 균형 잡힌 선택이고, Llama 3.2 3B(파일 2.0 GB)는 추정 18–30 tok/s로 파일이 가장 작습니다. 둘 다 Q4_K_M 기준입니다. 전체 비교와 Ollama 명령어는 CPU 전용 최고의 로컬 LLM 2026을 참고하십시오.
로컬 LLM을 실행하면 시간이 지나면서 노트북이 손상되나요?
정상적인 노트북에서는 즉각적인 손상이 예상되지 않습니다. 칩은 뜨거워지면 클럭을 낮추므로 지속적인 추론은 기기를 손상시키기보다 느리게 만듭니다. 다만 지속적인 열은 시간이 지나면서 팬과 배터리를 마모시키므로, 거치대나 쿨링 패드를 쓰고 통풍구를 막지 말며 중간에 쉬어 주십시오. 발열과 배터리 관리는 제조사의 안내를 따르십시오.
RAM 4 GB 노트북에서 로컬 LLM을 실행할 수 있나요?
겨우 가능합니다. Qwen3 1.7B(파일 1.4 GB)나 Llama 3.2 1B(파일 1.3 GB) 같은 작은 모델은 들어가지만, 운영체제가 2–3 GB를 쓰기 때문에 전체 4 GB에서는 스왑이 발생할 가능성이 높고 생성 속도가 크게 떨어집니다. 쾌적하게 쓰려면 현실적인 최소 사양은 8 GB입니다. 저사양 PC용 가장 빠른 로컬 LLM을 참고하십시오.
로컬 LLM을 실행하려면 노트북에 전용 GPU가 필요한가요?
아니요. Ollama, LM Studio, GPT4All은 CPU만으로도 실행됩니다. 메모리 대역폭이 높은 GPU는 생성 속도를 높여 주지만, 3B–4B 모델은 듀얼 채널 RAM의 CPU에서 추정 15–30 tok/s로 충분히 쓸 수 있습니다. CPU에 적합한 모델 추천은 입문자를 위한 최고의 로컬 LLM 모델을 참고하십시오.
RAM 8 GB MacBook에서 실행할 수 있는 가장 빠른 로컬 LLM은 무엇인가요?
이 가이드의 모델 중에서는 Q4_K_M Llama 3.2 3B(파일 2.0 GB)가 8 GB MacBook에서 가장 빠른 현실적인 선택입니다. M2나 M3(Apple 공개 기준 둘 다 100 GB/s)에서 대역폭 상한은 약 50 tok/s이고 PromptQuorum의 추정치는 35–45 tok/s입니다. 8B 파일(5.2 GB)은 macOS와 다른 앱도 메모리를 쓰기 때문에 8 GB에서는 빠듯합니다.
LLM 추론 중 노트북의 열 쓰로틀링을 어떻게 줄일 수 있나요?
네 가지 방법이 있습니다. (1) 통풍 공간이 있는 거치대에 노트북을 올립니다. (2) 생성은 클럭 속도보다 메모리 대역폭에 좌우되므로 균형 또는 절전 전원 모드를 시도합니다. (3) 생성 길이와 컨텍스트를 제한합니다. (4) 토큰마다 읽는 데이터가 줄도록 Q8_0 대신 Q4_K_M을 사용합니다. `ollama run <model> --verbose`로 10분 동안의 속도를 확인하십시오.
Chromebook에서 로컬 LLM을 실행할 수 있나요?
Linux(Crostini)를 사용할 수 있는 Chromebook에서, 그것도 작은 모델만 가능합니다. 대부분의 Chromebook은 RAM이 4–8 GB이고 메모리 대역폭도 낮아 Q4_K_M 1B–3B 모델이 현실적인 상한이며 속도도 낮습니다. Linux를 지원하지 않는 Chromebook에서는 Ollama를 실행할 수 없습니다.
로컬 LLM에는 Apple Silicon이 NVIDIA 노트북 GPU보다 나은가요?
메모리에 따라 다릅니다. 속도는 메모리 대역폭과 용량을 따릅니다. M5가 탑재된 16 GB MacBook(153 GB/s)은 Qwen3 8B 상한이 약 29 tok/s이고, RTX 4060 노트북 GPU(약 256 GB/s, VRAM 8 GB)는 상한이 약 49 tok/s이지만 8 GB에 들어가는 모델만 올릴 수 있습니다. 메모리가 더 큰 M5 Pro(307 GB/s)나 M5 Max(460–614 GB/s)는 더 큰 모델을 빠른 메모리에 올릴 수 있습니다. 소비 전력은 모델마다 다르므로 내 노트북에서 확인하십시오.
모델이 노트북 RAM에 비해 너무 크면 어떻게 되나요?
운영체제가 디스크로 스왑을 시작하거나 모델 로드에 실패하며, 팬이 세게 돌면서 생성 속도가 극도로 느려질 수 있습니다. 해결책은 더 작은 모델, 더 낮은 양자화 수준(Q8_0 대신 Q4_K_M), 또는 더 짧은 컨텍스트(`OLLAMA_CONTEXT_LENGTH`, 기본값 4096)입니다.
노트북에서 로컬 LLM을 실행하면 배터리는 얼마나 지속되나요?
동작 시간은 대략 배터리 용량(Wh)을 평균 소비 전력(W)으로 나눈 값입니다. 60 Wh 배터리는 20 W에서 약 3시간, 30 W에서 약 2시간 지속됩니다(설명을 위한 계산 예시이며 측정값이 아닙니다). 실제 소비 전력은 노트북, 모델, 전원 모드에 따라 다릅니다. 하루 종일 쓰려면 전원을 연결하십시오.
노트북에서 로컬 LLM을 실행하려면 인터넷 연결이 필요한가요?
아니요. 모델을 내려받을 때(인터넷 필요)를 제외하면 추론은 완전히 오프라인으로 동작합니다. 모델은 전적으로 노트북의 CPU나 GPU에서 실행됩니다. 그래서 출장, 보안이 중요한 환경, 연결이 불안정한 곳에서도 로컬 LLM을 쓸 수 있습니다.
RAM 8 GB에서 로컬 LLM을 실행할 수 있나요?
네. RAM 8 GB 노트북은 Q4_K_M 3B–4B 모델(파일 2.0–2.5 GB)을 듀얼 채널 RAM에서 추정 15–30 tok/s로, Apple M2나 M3에서는 추정 28–45 tok/s로 실행합니다. 7B–8B 모델(파일 4.4–5.2 GB)은 8 GB에서 빠듯합니다.
로컬 LLM에 가장 빠른 노트북은 무엇인가요?
로컬 LLM에서 핵심 사양은 메모리 대역폭과 충분한 메모리입니다. Apple은 M5 Pro를 307 GB/s(최대 64 GB), M5 Max를 460 또는 614 GB/s(최대 128 GB)로 공개하고 있으며, Qwen3 8B에 대한 PromptQuorum 추정치는 M5 Pro에서 41–53 tok/s, M5 Max에서 62–106 tok/s입니다. Windows에서는 모델을 VRAM에 올릴 수 있는 NVIDIA GPU 탑재 노트북의 상한이 높으며, 예를 들어 VRAM 8 GB의 RTX 4060 노트북 GPU는 약 256 GB/s입니다.
CPU에서 로컬 LLM은 얼마나 느린가요?
속도는 최대 메모리 대역폭 ÷ 모델 파일 크기입니다. 듀얼 채널 DDR4/DDR5에서 Q4_K_M 3B–4B 모델은 추정 15–30 tok/s, Qwen3 8B는 추정 8–15 tok/s이며, 싱글 채널 RAM에서는 절반이 됩니다. 읽으면서 따라가기에는 느리지만 채팅과 요약에는 충분히 빠릅니다. Apple Silicon은 통합 메모리의 대역폭이 더 넓어 Qwen3 8B에서 추정 13–26 tok/s(M3~M5)에 이릅니다.
출처
- Apple MacBook Pro 기술 사양 — M5(153 GB/s), M5 Pro(307 GB/s), M5 Max(460 및 614 GB/s)의 메모리 대역폭과 공식 배터리 사용 시간. apple.com/macbook-pro/specs
- Apple MacBook Air(15인치, M3, 2024) 기술 사양 — M3 메모리 대역폭 100 GB/s. support.apple.com
- Apple Newsroom: M2 — 통합 메모리 대역폭 100 GB/s. apple.com/newsroom
- Apple Newsroom: M5 Pro와 M5 Max를 탑재한 MacBook Pro(2026년 3월 3일) — 최대 64 GB 및 128 GB 통합 메모리. apple.com/newsroom
- NVIDIA GeForce 노트북 비교 — RTX 4060 노트북 GPU: GDDR6 8 GB, 128비트 버스. nvidia.com
- Notebookcheck: RTX 4060 Laptop GPU — 메모리 속도 16 Gbps(제3자 자료, 약 256 GB/s 수치의 근거). notebookcheck.net
- NVIDIA GeForce RTX 4090 사양 — VRAM 24 GB, 1,008 GB/s. nvidia.com
- Ollama 라이브러리 — 파일 크기 2026-10-23 확인: llama3.2, phi4-mini, qwen3, qwen3.5, llama3.1, llama3.3, gemma4.
- Ollama FAQ — 기본 컨텍스트 길이 4096, OLLAMA_CONTEXT_LENGTH, KV 캐시 유형, keep-alive, `ollama ps`. docs.ollama.com/faq
- Ollama GPU 문서 — Apple Silicon의 Metal, Vulkan, 지원 GPU. docs.ollama.com/gpu
- llama.cpp quantize README — Llama 3.1 8B의 양자화 유형별 파일 크기. github.com/ggml-org/llama.cpp
- Apple MLX Framework — Apple Silicon Mac의 GPU 가속. github.com/ml-explore/mlx
- LM Studio — 시스템 요구 사항, GPU 호환성, 로컬 추론 설정. lmstudio.ai
노트북에서 로컬 LLM을 실행할 때 흔한 실수는 무엇인가요?
- 사용 가능한 RAM보다 큰 모델 실행 → 시스템이 디스크로 스왑하면서 생성 속도가 크게 떨어집니다. 더 작은 모델이나 더 낮은 양자화를 고르십시오.
- 열 쓰로틀링 무시 → 칩이 온도 한계에 도달하면 지속 속도가 떨어질 수 있습니다. `ollama run <model> --verbose`로 10분 후의 속도를 확인하십시오.
- Q4_K_M 대신 Q8_0 사용 → 파일이 약 1.7배 커서(Llama 3.1 8B 기준 7.95 GiB 대 4.58 GiB) RAM이 더 필요하고, 대역폭이 제한된 노트북에서는 생성이 더 느려지는 데 비해 품질 향상은 작습니다.
- RAM 모듈 하나로 실행 → 싱글 채널 메모리는 최대 대역폭과 속도 상한을 절반으로 줄입니다. 노트북이 허용하면 동일한 모듈 두 개를 사용하십시오.
- LM Studio에서 GPU 오프로드 끄기 → 모델이 GPU 대신 CPU에서 실행됩니다. 모델이 GPU 메모리에 들어간다면 GPU 오프로드 설정을 높이십시오.
- 기본 컨텍스트 창 유지 → Ollama의 기본값은 4096 토큰이라 여러 페이지짜리 문서는 잘립니다. `OLLAMA_CONTEXT_LENGTH=8192` 또는 `/set parameter num_ctx 8192`로 늘릴 수 있으며, 그만큼 메모리를 더 씁니다.