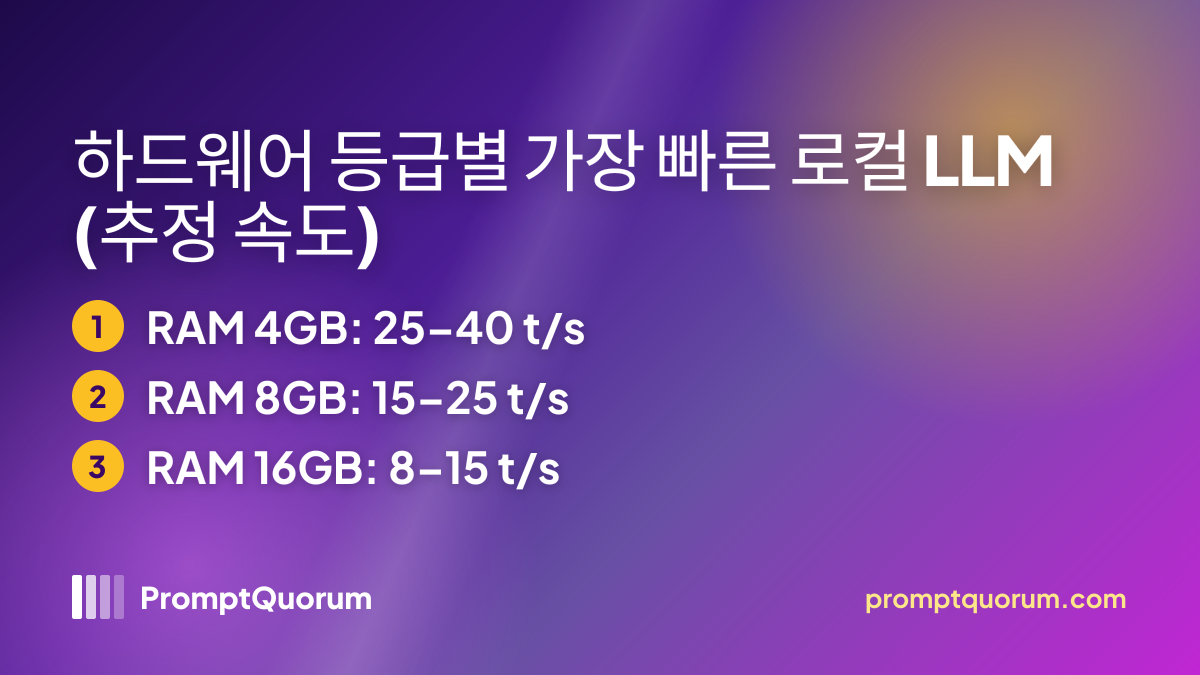
하드웨어에 맞는 가장 빠른 모델은 무엇입니까?
하드웨어에 맞는 모델을 선택하세요 — 잘못된 선택은 4–10배의 속도 손실을 초래합니다. 아래 티어는 별도 표기가 없는 한 모두 CPU 전용입니다. 속도는 듀얼 채널 RAM 기준 PromptQuorum의 추정값이며 실험실 측정값이 아닙니다. 싱글 채널 RAM이나 구형 DDR4 노트북에서는 더 낮게 나옵니다.
하드웨어 | 권장 모델 | Ollama 명령어 | 예상 속도 |
|---|---|---|---|
| RAM 4 GB, CPU 전용 | Qwen3 1.7B Q4_K_M | ollama run qwen3:1.7b | 초당 25–40 토큰 |
| RAM 8 GB, CPU 전용 | Phi-4-mini 3.8B Q4_K_M | ollama run phi4-mini | 초당 15–25 토큰 |
| RAM 8 GB + Intel Iris iGPU | Qwen3 4B Q4_K_M | ollama run qwen3:4b | 초당 12–20 토큰 |
| RAM 16 GB, CPU 전용 | Qwen3 8B Q4_K_M | ollama run qwen3:8b | 초당 8–15 토큰 |
| RAM 16 GB + iGPU | Llama 3.2 3B Q4_K_M | ollama run llama3.2:3b | 초당 20–35 토큰 |
어떤 모델을 사용해야 합니까?
상황에 맞는 모델을 선택하세요 — 이것이 가장 중요한 결정입니다:
- RAM 8 GB 노트북 (독립 GPU 없음): Phi-4-mini (3.8B) Q4_K_M — 초당 15–25 토큰, 코딩과 추론 처리. `ollama run phi4-mini`
- RAM 4 GB, 매우 오래된 PC: Qwen3 1.7B Q4_K_M — 초당 25–40 토큰, 최소 RAM에서 가장 빠른 응답. `ollama run qwen3:1.7b`
- RAM 16 GB, GPU 없음: Qwen3 8B Q4_K_M — 초당 8–15 토큰, 우수한 품질. `ollama run qwen3:8b`
- RAM 8 GB + Intel Iris iGPU: Qwen3 4B — Ollama가 iGPU를 사용하는 경우 추정 초당 12–20 토큰 (`ollama ps`를 실행해 PROCESSOR 열을 확인하십시오). `ollama run qwen3:4b`
- 긴 컨텍스트가 필요한 경우: Qwen3 4B (Ollama에서 256K 컨텍스트) 또는 Llama 3.2 3B (128K). Qwen3 1.7B와 8B는 40K로 표기되어 있습니다.
- 더 새로운 세대, 가장 작은 파일: Qwen3.5 0.8B (Ollama 기준 1.2 GB)는 Qwen3 1.7B (1.4 GB)보다 작아서 같은 CPU에서 품질은 낮지만 더 빠르게 동작할 것입니다. Qwen3.5 2B (2.7 GB)와 4B (3.3 GB)는 Phi-4-mini (2.5 GB)와 Qwen3 4B (2.5 GB)보다 파일이 크므로 더 느릴 것으로 예상됩니다. `ollama run qwen3.5:0.8b`. PromptQuorum은 이 가이드의 하드웨어에서 Qwen3.5의 속도를 측정하지 않았습니다.
- RAM 8 GB에서 시도해 볼 가치가 있음: Gemma 4 E2B (Google, 2026년 4월 출시). 유효 파라미터는 약 2.3B이지만 임베딩 테이블 때문에 Ollama 다운로드가 4.6 GB부터 시작하므로 1.5–2 GB 모델이 아닙니다. `ollama run gemma4:e2b`. 메모리 유형별 추정 속도는 CPU 전용 모델 가이드를 참고하십시오.
- RAM 티어별 권장 사항 및 발열 관리는 노트북에서 로컬 LLM 실행하는 방법을 참조하십시오.
하드웨어에 맞는 로컬 LLM은 무엇입니까?
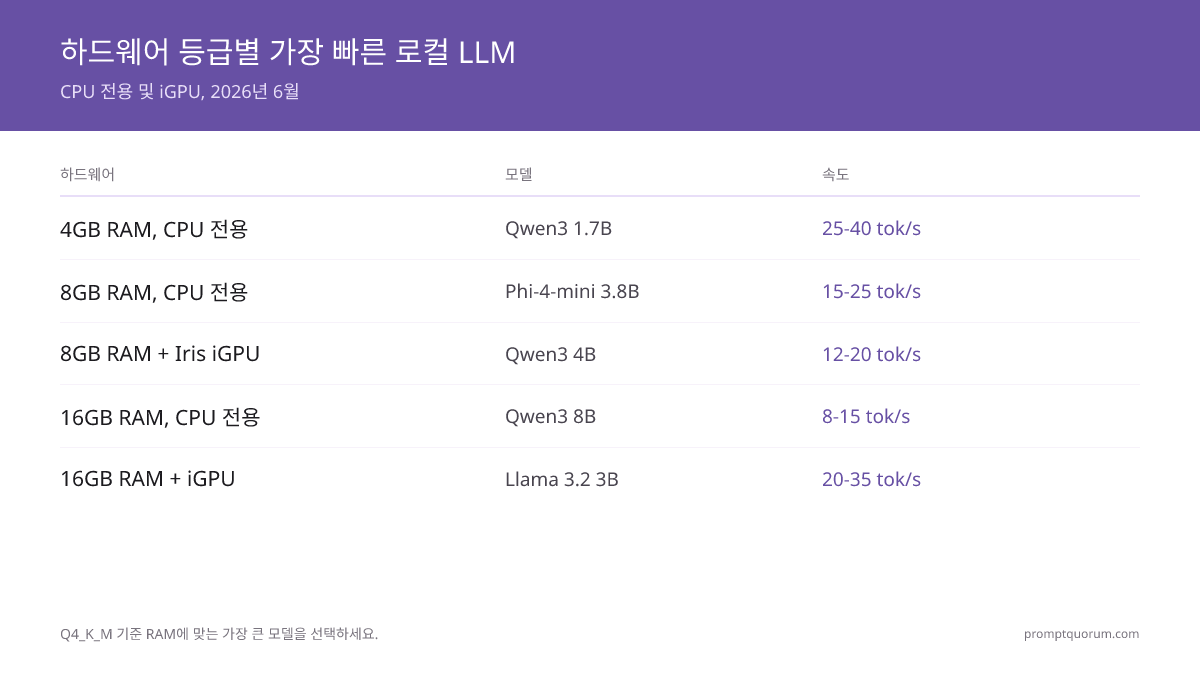
아래 티어는 모두 CPU 전용 또는 iGPU입니다. Q4_K_M으로 RAM에 맞으면서 운영체제와 컨텍스트를 위한 여유 공간이 남는 가장 큰 모델을 선택하십시오. 속도는 추정값입니다.
하드웨어 | 모델 | 양자화 | 속도 | 경험 |
|---|---|---|---|---|
| RAM 4 GB, CPU 전용 | Qwen3 1.7B | Q4_K_M | 초당 25–40 토큰 | 빠름, 사용 가능한 품질 |
| RAM 8 GB, CPU 전용 | Phi-4-mini 3.8B | Q4_K_M | 초당 15–25 토큰 | 코딩 + 추론 |
| RAM 8 GB + iGPU Iris | Qwen3 4B | Q4_K_M | 초당 12–20 토큰 | iGPU가 사용되는 경우 |
| RAM 16 GB, CPU 전용 | Qwen3 8B | Q4_K_M | 초당 8–15 토큰 | 우수한 품질 |
| RAM 16 GB + iGPU | Llama 3.2 3B | Q4_K_M | 초당 20–35 토큰 | iGPU가 사용되는 경우 |
저사양 하드웨어에서 GPU와 CPU 중 어느 것이 더 빠릅니까?
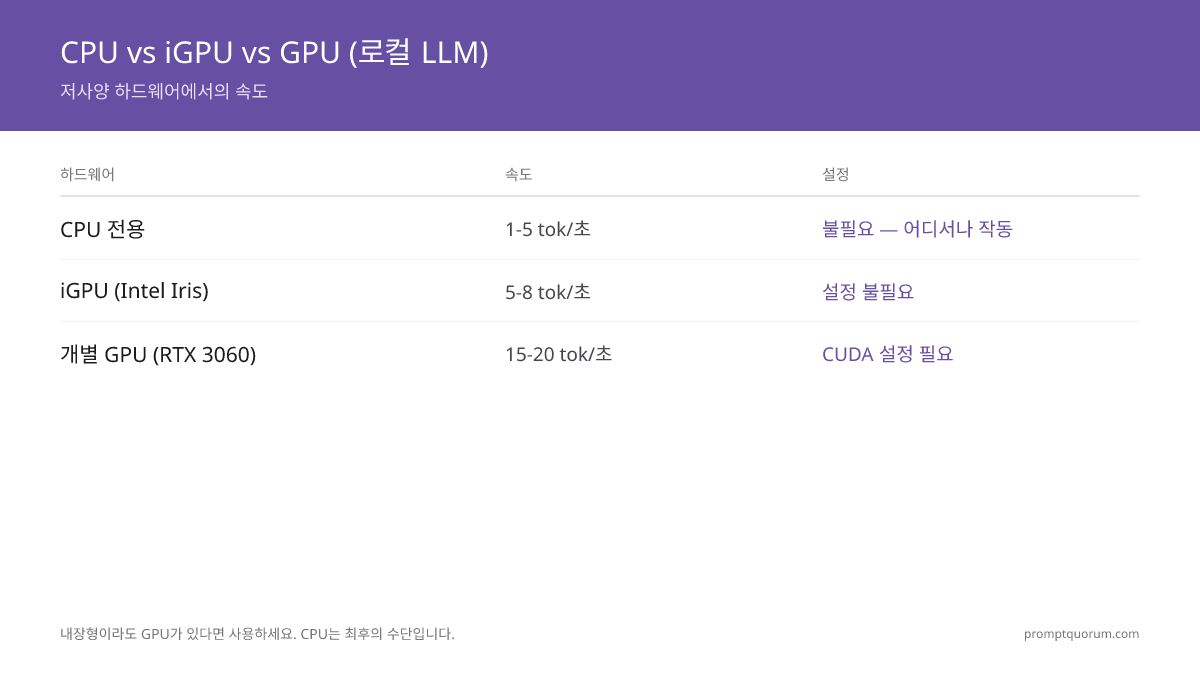
독립 GPU: 같은 모델 기준 일반적으로 CPU 전용보다 5–10배 빠릅니다. VRAM의 메모리 대역폭이 시스템 RAM보다 훨씬 크기 때문입니다. 중고 RTX 4060 8 GB (가격 변동)는 흔한 예산형 업그레이드입니다. 비용 효율적인 옵션은 예산 GPU 가이드를 참조하십시오.
iGPU (내장형): CPU와 시스템 RAM을 공유하므로 주된 한계인 메모리 대역폭이 그대로입니다. 향상 폭은 대체로 크지 않으며 드라이버 지원에 따라 달라집니다. Ollama 문서에 따르면 Windows와 Linux에서 Vulkan GPU 지원은 백엔드가 설치되어 있으면 기본으로 활성화되고, AMD Ryzen AI iGPU는 ROCm 항목에 나열되어 있지만, Intel 내장 GPU는 지원 표에 나열되어 있지 않습니다. `ollama ps`를 확인하십시오: PROCESSOR 열에 모델이 CPU, GPU 또는 분할 중 어디에서 실행되는지 표시됩니다.
CPU 전용: 드라이버 설정 없이 모든 PC에서 실행됩니다. 속도는 대략 메모리 대역폭 ÷ 모델 파일 크기이며, 그래서 CPU 클럭 속도보다 듀얼 채널 RAM과 작은 Q4_K_M 파일이 더 중요합니다.
규칙: 독립 GPU가 있다면 사용하십시오. 그렇지 않다면 같은 프롬프트를 iGPU를 켠 상태와 끈 상태로 실행해 보고 (`OLLAMA_VULKAN=0`은 Vulkan GPU를 끕니다) 더 빠른 쪽을 유지하십시오.
저사양 PC에서 소형 모델이 더 빠른 이유
모델 크기가 속도를 직접 결정합니다. 1B–3B 모델은 시스템 RAM에 완전히 적합하여 CPU 또는 GPU가 데이터를 연속적으로 스트리밍할 수 있습니다. 대형 모델은 메모리 스왑이 필요합니다 — RAM과 디스크 사이에서 데이터를 이동시키는 작업으로, 생성 속도가 크게 느려집니다 (병목 현상은 계산이 아닌 디스크 I/O입니다).
위의 하드웨어 결정 표는 이 원칙을 반영합니다: 파일이 가장 작은 모델이 가장 높은 속도를 내는 반면, 13B 이상 모델은 스왑이 지배적이어서 저사양 하드웨어에서는 실용적이지 않습니다.
- 1B–3B 모델: RAM 4–8 GB에 적합 → 가장 빠른 생성 → 허용 가능한 품질
- 7B 모델: 8 GB 시스템에서 경계선 → 메모리 압박으로 인해 느림 → 높은 품질
- 13B 이상 모델: RAM 16 GB 이상 필요 또는 과도한 스왑 → 저사양 PC에서 대화형 사용에 너무 느림
저사양 PC에서 로컬 LLM은 얼마나 빠릅니까?
CPU 전용 시스템에서는 다음과 같은 추정 범위를 기대할 수 있습니다:
- 3B 모델 → 초당 15–40 토큰 (구형 CPU: 10–15, 최신 듀얼 채널 DDR5 시스템: 30–40)
- 7B–8B 모델 → 초당 8–15 토큰 (듀얼 채널 RAM에서 Q4_K_M; 싱글 채널 RAM에서는 더 낮음)
- 나눗셈 한 번으로 내 PC의 속도를 추정하십시오. 토큰 하나를 생성할 때마다 모델 전체를 RAM에서 한 번 읽어야 하므로, 초당 토큰 수는 메모리 대역폭 ÷ 모델 파일 크기를 넘을 수 없습니다. 최대 대역폭 = 전송 속도(MT/s) × 8바이트 × 채널 수.
- 계산 예시 (예측이 아닌 상한값): 듀얼 채널 DDR4-3200은 3200 × 8 × 2 = 51.2 GB/s이며, 2.5 GB인 Phi-4-mini 파일로 나누면 최대 약 초당 20 토큰입니다. 듀얼 채널 DDR5-5600은 89.6 GB/s로, 같은 파일에서 최대 약 초당 36 토큰입니다. 싱글 채널 DDR4-3200 노트북은 25.6 GB/s로 최대 약 초당 10 토큰입니다. 실제 속도는 상한값보다 낮습니다.
- Intel N100 미니 PC는 메모리 채널이 하나입니다 (Intel 사양: DDR4-3200, DDR5-4800 또는 LPDDR5-4800). DDR4-3200에서 1.4 GB인 Qwen3 1.7B 파일의 상한은 약 초당 18 토큰이고, DDR5-4800에서는 약 초당 27 토큰입니다. N100은 이 가이드의 듀얼 채널 범위보다 낮게 나올 것으로 예상하십시오.
- 이는 클라우드 챗봇보다 느리지만 대화형 사용에는 충분합니다. 초당 25 토큰의 3B 모델은 500 토큰 응답을 20초에 생성합니다 — 코드 검토, 요약, 창작 글쓰기와 같은 비시간 중요 작업에는 허용 가능합니다.
양자화는 저사양 PC의 속도에 어떤 영향을 미칩니까?
Q4 (4비트): 표준 선택. 16비트 파일 크기의 약 4분의 1이며 대부분의 작업에서 품질 손실이 작습니다. 모든 양자화 수준과 작동 방식에 대한 자세한 내용은 전체 가이드를 참조하십시오.
Q3 (3비트): Q4보다 파일이 작지만 품질 손실은 더 큽니다. Q4가 RAM에 맞지 않을 때 채팅용으로 허용 가능.
Q2 (2비트): 가장 작은 파일이지만 품질 손실이 가장 큽니다. 위험함; Q4와 Q3가 메모리 부족을 일으킬 때만 사용.
속도 영향: CPU 디코딩은 메모리 대역폭에 의해 제한되므로, 파일이 작을수록 거의 같은 비율로 더 빠르게 생성됩니다. Q3와 Q2 파일은 Q4보다 빠르지만, 이렇게 작은 모델에서는 품질 저하가 대체로 그만한 가치가 없습니다.
전략: 먼저 모델 크기를 정한 다음 Q4_K_M을 사용하십시오. Q4_K_M의 소형 모델이 Q2로 압축한 대형 모델보다 대체로 더 낫습니다. 후자는 정확도가 떨어지면서도 여전히 더 많은 RAM이 필요합니다.
빠른 모델은 속도를 위해 품질을 희생합니다 — 하지만 temperature와 top-p를 조정하면 품질 손실을 많이 회복할 수 있습니다. 빠른 모델에서 낮은 temperature (0.1–0.3)는 기본 설정보다 더 일관된 출력을 생성합니다. 정확한 설정은 temperature 및 top-p 설명을 참조하십시오.

CPU 전용 추론 속도를 높이는 방법은 무엇입니까?
- 두 메모리 채널 모두 채우기: 같은 RAM 모듈 두 개를 꽂으면 모듈 하나일 때보다 최대 메모리 대역폭이 두 배가 되며, 이는 CPU 전용 PC에서 가장 큰 단일 속도 향상입니다. 모듈이 하나뿐인 노트북과 미니 PC는 상한의 절반 속도로 동작합니다.
- 컨텍스트 창 줄이기: KV 캐시는 컨텍스트 길이에 따라 커집니다. `OLLAMA_CONTEXT_LENGTH=2048`을 설정하거나 (Ollama 기본값은 4096) `ollama run` 안에서 `/set parameter num_ctx 2048`을 사용하십시오.
- KV 캐시 양자화: `OLLAMA_FLASH_ATTENTION=1`과 `OLLAMA_KV_CACHE_TYPE=q8_0`을 함께 사용하면 f16 기본값에 비해 KV 캐시 메모리가 대략 절반으로 줄어, RAM 4 GB와 8 GB 머신에서 가장 큰 도움이 됩니다.
- 모델을 로드된 상태로 유지: Ollama는 기본적으로 5분 후 모델을 언로드합니다. `OLLAMA_KEEP_ALIVE=30m`을 설정하면 세션마다 파일을 다시 불러오지 않아도 됩니다.
- 메모리를 많이 쓰는 앱 닫기: 탭이 많은 브라우저는 모델을 스왑으로 밀어내어 생성 속도를 몇 배나 느리게 만듭니다.
- iGPU 테스트: 모델이 로드된 상태에서 `ollama ps`를 실행하십시오. PROCESSOR가 100% CPU로 표시되면 GPU 실행과 비교해 보고, iGPU가 불안정하면 `OLLAMA_VULKAN=0`을 설정하십시오.
RAM 2 GB에서 로컬 RAG를 실행할 수 있습니까?
예, 작은 문서 집합이라면 가능합니다. 답변용 Qwen3 0.6B (Ollama 기준 523 MB)와 검색용 임베딩 모델 nomic-embed-text (274 MB)는 모델 파일 합계 약 0.8 GB가 필요합니다. 가벼운 Linux 설치, 오래된 넷북, 다른 앱을 닫은 PC처럼 RAM 2 GB가 실제로 비어 있을 때 들어맞습니다. 깊은 추론이 아니라 문서에서 가져온 간단한 답변을 기대하십시오.
- 채팅 모델: `ollama pull qwen3:0.6b` (523 MB, Ollama 기준 40K 컨텍스트). 여유 RAM이 조금 더 있다면 `qwen3.5:0.8b` (1.2 GB)가 더 새로운 소형 옵션입니다.
- 임베딩 모델: `ollama pull nomic-embed-text` (274 MB, 2K 컨텍스트 창). 각 청크가 2K 창에 들어가도록 문서를 수백 토큰 단위의 청크로 나누십시오.
- 적은 수의 청크만 검색: 가장 일치하는 상위 2–3개 청크만 채팅 모델에 전달하십시오. 청크가 하나 늘 때마다 컨텍스트가 길어지고 KV 캐시가 커집니다.
- 컨텍스트를 짧게 유지: `OLLAMA_CONTEXT_LENGTH=2048`을 설정하여 KV 캐시를 작게 유지하십시오.
- 답변 확인: 0.6B 모델은 검색된 구절에서 사실 하나를 뽑아내는 데는 능숙하지만 여러 단계의 추론에는 약하므로, 중요한 답변은 원문 구절과 대조하십시오.
- RAM 2 GB가 너무 빠듯할 때: RAM 4 GB에서는 Qwen3 1.7B (1.4 GB)로, RAM 8 GB에서는 Phi-4-mini로 올리고 같은 임베딩 모델을 유지하십시오.
이 모델들은 얼마나 빠릅니까? 추정 속도
하드웨어 등급별 추정 속도이며 실험실 측정값이 아닙니다. 이 범위는 PromptQuorum 자체 추정치로, 각 등급의 메모리 대역폭 상한에서 도출했으며 Ollama 기본 설정과 Q4_K_M 파일 기준입니다. 정상적으로 설치된 환경의 상한으로 보십시오. 실제 초당 토큰 수는 `ollama run <model> --verbose` 출력에 표시됩니다:
- Intel N100 미니 PC (싱글 채널 RAM, RAM 4 GB 티어) + Qwen3 1.7B Q4_K_M: DDR4-3200에서 최대 약 초당 18 토큰, DDR5-4800에서 약 초당 27 토큰 (대역폭 상한). `ollama run qwen3:1.7b`
- 최신 듀얼 채널 i5/Ryzen 5 (RAM 4 GB 티어) + Qwen3 1.7B Q4_K_M: 추정 초당 25–40 토큰. `ollama run qwen3:1.7b`
- Core i5-1235U급 노트북 (RAM 8 GB) + Phi-4-mini Q4_K_M: LPDDR5에서 추정 초당 15–22 토큰, DDR4 노트북은 더 낮게 나옵니다. `ollama run phi4-mini`
- Ryzen 5 5600G급 데스크톱 (RAM 8 GB) + Qwen3 4B Q4_K_M: 추정 초당 15–20 토큰 (듀얼 채널 DDR4-3200의 상한은 약 20)이며, iGPU도 같은 RAM 대역폭을 공유하므로 이보다 높게 기대하지 마십시오.
- Intel Iris Xe급 노트북 (RAM 8 GB) + Qwen3 4B Q4_K_M: 추정 초당 12–18 토큰. `ollama run qwen3:4b`
- Ryzen 7 7700X급 데스크톱 (RAM 16 GB, 듀얼 채널 DDR5) + Qwen3 8B Q4_K_M: 추정 초당 8–13 토큰. `ollama run qwen3:8b`
- Iris Xe급 노트북 (RAM 16 GB) + Llama 3.2 3B Q4_K_M: 추정 초당 20–30 토큰. `ollama run llama3.2:3b`
로컬 LLM에서 실제로 "빠르다"는 것은 무엇입니까?
작업에 따라 속도 체감이 다릅니다 — 이것을 기준으로 사용하십시오:
모델이 초당 15 토큰 미만으로 실행되면 새 하드웨어를 구매하기 전에 모델 크기를 줄이거나 (7B → 3B) 양자화 수준을 낮추십시오 (Q5 → Q4).
- 초당 10 토큰 미만 → 고장난 것처럼 느껴집니다. 눈에 띄는 멈춤과 함께 단어가 하나씩 나타납니다. 대화형 채팅에는 사용 불가.
- 초당 15–25 토큰 → 허용 가능. 대부분의 사용자에게 읽기 가능한 속도. Q&A, 요약, 코딩 도움에 적합.
- 초당 30 토큰 이상 → 원활함. 실제 어시스턴트처럼 느껴집니다. 모든 대화형 작업에 편안합니다.
- 초당 60 토큰 이상 → 즉각적. 읽는 것보다 빠릅니다. 실시간 자동 완성 및 빠른 반복에 이상적.

저사양 PC에서 피해야 할 것들
- 13B 이상 모델을 실행하지 마십시오 — RAM 한계를 초과합니다. Q4에서 13B 모델은 파일만으로도 대략 8 GB가 필요하여, 운영체제까지 계산하면 8 GB PC가 담을 수 있는 범위를 넘습니다. RAM 16 GB에서는 8B 이하, RAM 8 GB에서는 4B 이하로 유지하십시오.
- Q8 양자화를 피하십시오 — 최소한의 품질 향상에 비해 더 느립니다. Q8은 Q4의 파일 크기를 대략 두 배로 만들며, 대역폭이 제한된 CPU에서는 파일이 클수록 초당 토큰 수가 줄어듭니다. 4 GB 시스템에서 Q8은 비실용적이며, 8 GB 시스템에서도 Q4가 최적입니다. Q4가 메모리 부족을 일으킬 때만 Q3가 고려할 가치 있는 트레이드오프입니다.
- 실시간 자동 완성 성능을 기대하지 마십시오. CPU에서 초당 3 토큰으로 50 토큰을 생성하는 데 약 17초가 걸립니다. 대화형 자동 완성에는 훨씬 높은 속도가 필요합니다. 저사양 CPU의 로컬 LLM은 배치 채팅, 초안 작성, 검토에는 적합하지만 실시간 자동 완성이나 타이핑 중 코드 생성에는 적합하지 않습니다.
- CPU 전용 추론을 프로덕션 챗봇에 사용하지 마십시오. 내부 도구, 프로토타입, 오프라인 배치 작업에는 허용 가능합니다. 저사양 CPU는 한 번에 한 명의 사용자에게 낮은 속도로 응답하는 반면, 호스팅 API는 많은 사용자로 확장됩니다. 속도가 중요한 상황이 아닌 개인정보 보호가 중요하거나 오프라인 시나리오에서 로컬 추론을 사용하십시오.
일반적인 실수
- 실수: RAM 모듈 하나만 사용. 문제: 메모리 채널이 하나면 최대 대역폭이 절반이 되어 같은 모델이 대략 절반의 속도로 생성됩니다. 해결책: 더 빠른 CPU를 구매하기 전에 같은 모듈 두 개를 설치하십시오(또는 듀얼 채널 미니 PC를 구매하십시오).
- 실수: CPU 모델만으로 속도를 판단. 문제: 느린 싱글 채널 DDR4의 최신 CPU는 듀얼 채널 DDR5의 구형 CPU보다 느릴 수 있습니다. 토큰 생성은 메모리 대역폭에 의해 제한되기 때문입니다. 해결책: RAM 속도와 채널 수를 비교한 다음 `ollama run <model> --verbose`에서 실제 수치를 확인하십시오.
- 실수: 7B를 4GB에 넣기 위해 Q2로 양자화. 문제: Q2 양자화는 추론 중 KV 캐시 오버헤드로 인한 메모리 부족 충돌을 자주 일으키며 출력 품질도 급격히 떨어집니다. 해결책: 대신 Q4의 3B 모델을 사용하십시오.
- 실수: 컨텍스트 창을 크게 방치. 문제: 긴 컨텍스트는 KV 캐시를 키워 소형 머신을 스왑으로 밀어 넣습니다. 해결책: 긴 문서가 필요하지 않다면 `OLLAMA_CONTEXT_LENGTH=2048`을 설정하십시오.
- 실수: 모델에 잘못된 Ollama 슬러그 사용. 문제: `ollama run phi`는 Phi-4-mini가 아닌 Phi-2를 불러옵니다. 해결책: 현재의 Phi 소형 모델에는 `ollama run phi4-mini`를 사용하십시오. 정확한 모델 태그는 항상 ollama.com/library를 확인하십시오.
저사양 PC의 로컬 LLM: 지역별 상황
한국: 개인정보보호법(PIPA) 및 데이터 3법 개정에 따라, 로컬 하드웨어에서 오프라인으로 추론하면 추론 데이터가 기기를 떠나지 않으므로 국외 이전과 관련한 검토 부담을 줄이는 기술적으로 간단한 방법이 될 수 있습니다. 이 가이드는 법률 자문이 아닙니다. 금융, 의료 등 규제 산업의 중소기업이 내부 문서 처리에 로컬 LLM을 검토할 때, 저사양 CPU에서도 오프라인으로 시도해 볼 수 있습니다. 전체적인 규정 준수는 추론 아키텍처만이 아니라 전체 운영 환경에 달려 있습니다.
EU / GDPR: 저사양 하드웨어에서 로컬로 실행: 오프라인으로 실행하면 추론 데이터가 기기를 떠나지 않습니다 — 많은 중소기업과 프리랜서에게 GDPR 제44조 이전 위험을 피하는 기술적으로 간단한 방법입니다. EU AI 법이나 그 밖의 의무가 사용 사례에 적용되는지는 시스템을 누가 어떤 목적으로 배포하는지에 따라 달라지며, 이 가이드는 법률 자문이 아닙니다. 전체적인 데이터 보호 규정 준수는 추론 아키텍처만이 아니라 전체 운영 환경에 달려 있습니다.
일본: 일본 METI의 기업용 AI 가이드라인은 데이터의 책임 있는 취급을 강조합니다. 저사양 하드웨어에서의 CPU 추론은 느리지만 프롬프트가 기기 안에 머뭅니다 — 모델을 내려받은 뒤에는 추론 자체에 API 호출이 필요하지 않습니다. 위에서 제시한 CPU 속도 범위에서 Qwen3로 일본어 작업을 할 경우, 비시간 중요 문서 요약에는 문장당 몇 초 정도면 충분합니다.
저사양 PC에서 로컬 LLM 실행에 관한 자주 묻는 질문
로컬 LLM 실행을 위한 저사양 PC의 기준은 무엇입니까?
로컬 LLM을 위한 저사양 PC는 독립 GPU가 없는 CPU 전용 머신으로, 시스템 RAM이 4–16 GB인 경우입니다. 여기에는 Intel Iris 또는 AMD Radeon 내장 그래픽이 있는 대부분의 노트북, 독립 GPU가 없는 구형 데스크톱, Intel N100과 같은 미니 PC가 포함됩니다. 핵심 제약은 CPU 클럭 속도가 아니라 모델 가중치를 위한 시스템 RAM입니다.
GPU 없이 7B급 모델을 실행할 수 있습니까?
예 — Qwen3 8B (Q4_K_M)는 RAM 16 GB, CPU 전용에서 추정 초당 8–15 토큰으로 동작합니다 (듀얼 채널 Ryzen 7 7700X급 데스크톱 기준 추정값). 더 작은 옵션보다 느리지만 품질은 눈에 띄게 좋습니다. RAM 8 GB인 경우 대신 Phi-4-mini (3.8B)를 사용하세요 — 8B 모델은 Q4_K_M에서 8 GB 시스템이 안정적으로 보장하지 못하는 여유 공간이 필요합니다.
CPU 추론을 챗봇에 사용할 수 있습니까?
적절한 모델 크기를 선택하면 대화형 용도로도 사용할 수 있습니다. Phi-4-mini (초당 15–25 토큰, RAM 8 GB)와 Qwen3 1.7B (초당 25–40 토큰, RAM 4 GB) 모두 실시간 채팅에 충분히 빠릅니다. CPU상의 7B급 모델(초당 8–15 토큰)은 실시간 대화보다는 초안 작성, 요약, 오프라인 검토 같은 배치 작업에 더 적합합니다.
CPU 전용 하드웨어에서는 Phi-4-mini와 Qwen3 1.7B 중 어느 것을 사용해야 합니까?
RAM 8 GB가 있다면 Phi-4-mini (3.8B)를 사용하세요 — 초당 15–25 토큰으로 코딩과 추론을 처리합니다. RAM 4 GB뿐이거나 가능한 가장 빠른 응답(초당 25–40 토큰)을 원한다면 Qwen3 1.7B를 사용하세요 — 단, 복잡한 작업에서는 품질이 다소 희생됩니다.
GPU가 있는지 어떻게 확인합니까?
독립 NVIDIA GPU의 경우 터미널에서 `nvidia-smi`를 실행하십시오. "command not found"가 반환되면 `lspci` (Linux) 또는 장치 관리자 (Windows)에서 Intel Iris Xe 또는 AMD Radeon iGPU를 확인하십시오 — Ollama가 사용할 수 있는지는 드라이버와 백엔드 지원 여부에 따라 다르므로 `ollama ps`로 확인하십시오.
양자화는 추론 속도에 어떤 영향을 미칩니까?
양자화는 주로 계산이 아닌 메모리 대역폭 요구 사항을 줄입니다. Q2 (2비트) 파일은 Q4 (4비트) 파일보다 작아서 CPU가 토큰당 더 적은 바이트를 읽으므로, 대체로 파일 크기에 비례해 더 빠르게 생성합니다. 하지만 Q2는 출력 품질 손실이 훨씬 큽니다. 실용적 규칙: 이 가이드의 모든 티어에서 기본값은 Q4_K_M이며, RAM에 맞지 않을 때만 Q3로 낮추십시오.
Q2 미만의 양자화를 사용할 수 있습니까?
기술적으로 가능하지만 (llama.cpp에는 1비트 IQ1 형식이 있습니다), 그 크기에서는 출력 품질이 무너집니다. 이 가이드의 RAM 4GB 티어를 포함해 어떠한 실용적인 사용 사례에도 권장하지 않습니다 — 대신 더 작은 모델을 Q4_K_M으로 선택하십시오.
CPU + iGPU 하이브리드 추론이 지원됩니까?
경우에 따라 가능합니다. Ollama는 지원되는 GPU 백엔드를 찾으면 모델을 CPU와 GPU로 나눌 수 있으며, `ollama ps`의 PROCESSOR 열에 분할 상태가 표시됩니다. iGPU는 CPU와 시스템 RAM을 공유하므로 주된 속도 한계인 메모리 대역폭이 늘어나지 않습니다. Intel Iris Xe iGPU가 있는 RAM 8GB 시스템에서 iGPU가 사용되면 Qwen3 4B는 추정 초당 12–20 토큰입니다. CPU 전용과 비교하려면 `OLLAMA_VULKAN=0`으로 테스트하십시오.
저사양 PC를 위한 가장 빠른 로컬 LLM은 무엇입니까?
Qwen3 1.7B (Q4_K_M)가 이 가이드의 티어별 추천 모델 중 가장 빠릅니다 (Qwen3 0.6B 같은 더 작은 모델은 더 빠르지만 품질이 크게 낮습니다) — 최신 i5/Ryzen 5, RAM 4 GB, GPU 없이 추정 초당 25–40 토큰. 비슷한 속도에서 더 나은 품질을 원한다면 Phi-4-mini (3.8B)가 RAM 8 GB에서 초당 15–25 토큰으로 동작하며 코딩과 추론을 훨씬 잘 처리합니다.
RAM 4 GB에서 로컬 LLM을 실행할 수 있습니까?
예 — Qwen3 1.7B (Q4_K_M)가 RAM 4 GB, CPU 전용에 권장되는 모델이며, 최신 i5/Ryzen 5에서 초당 25–40 토큰에 도달합니다. 이 가이드의 티어별 추천 모델 중 가장 빠르며 OS를 위한 여유 공간을 남기고 맞습니다.
속도를 위해 GPU가 필요합니까?
아니요 — 이 가이드의 모든 모델은 CPU 전용으로 실행됩니다. Intel Iris iGPU는 소폭의 속도 향상을 줄 수 있지만 (Qwen3 4B: iGPU가 사용되는 경우 추정 초당 12–20 토큰) 선택 사항이며 드라이버 지원에 따라 달라집니다. 중고 RTX 4060 8GB 같은 독립 GPU는 같은 모델 기준 CPU 전용보다 보통 5–10배 빠르지만, 이는 필수가 아닌 별도의 업그레이드 경로입니다.
Intel Iris iGPU는 로컬 LLM에 충분합니까?
도움이 될 수 있지만 보장되지는 않습니다. RAM 8 GB와 Intel Iris Xe iGPU에서 Ollama가 실제로 iGPU를 사용하면 Qwen3 4B는 추정 초당 12–20 토큰이고, RAM 16 GB에서 Llama 3.2 3B는 추정 초당 20–35 토큰입니다. iGPU는 CPU와 시스템 RAM을 공유하므로 향상 폭은 대체로 크지 않습니다. 같은 프롬프트를 iGPU를 사용할 때와 사용하지 않을 때 각각 실행해 보고 더 빠른 설정을 유지하십시오.
저사양 하드웨어에서는 Q2와 Q4 중 어느 양자화를 사용해야 합니까?
Q4_K_M부터 시작하십시오 — 이 가이드의 모든 모델 티어(1.7B~8B)에 맞으며 품질 손실은 작습니다. Q4_K_M이 메모리 부족 오류를 일으킬 때만 Q3나 Q2로 낮추십시오. Q2 파일은 더 작아서 더 빠르지만, 추론 및 코딩 작업에서 품질 손실이 눈에 띕니다.
Windows에서 사용 가능한 RAM을 확인하는 방법은 무엇입니까?
작업 관리자 → 성능 → 메모리를 여십시오. 표시되는 총량이 시스템 RAM입니다 — 위의 하드웨어 판단 표(4GB, 8GB, 16GB 티어)와 비교하여 올바른 모델을 선택하십시오.
Ollama가 내장 GPU를 자동으로 사용합니까?
지원되는 백엔드가 있는 경우에만 사용합니다. Ollama 문서에 따르면 Windows와 Linux에서 Vulkan GPU 지원은 백엔드가 설치되어 있으면 기본으로 활성화되며, AMD Ryzen AI iGPU는 ROCm 항목에 나열되어 있습니다. Intel 내장 GPU는 지원 표에 나열되어 있지 않습니다. 모델을 로드한 후 `ollama ps`로 확인하십시오 — PROCESSOR 열에 100% CPU, 100% GPU 또는 분할 상태가 표시됩니다. Vulkan GPU를 끄려면 `OLLAMA_VULKAN=0`을 설정하십시오.
저사양 PC에서 ChatGPT의 가장 좋은 무료 대안은 무엇입니까?
RAM 8 GB, CPU 전용 Ollama에서 Q4_K_M의 Phi-4-mini (3.8B)를 사용하면 초당 15–25 토큰을 얻을 수 있습니다 — 채팅, 요약, 코딩 도움에 충분합니다. 품질은 프론티어 클라우드 모델보다 낮지만 일상 작업에는 충분합니다. 완전 무료이며 오프라인으로 실행되고 API 키가 필요 없습니다.
로컬 LLM에서 독립 GPU는 CPU보다 얼마나 빠릅니까?
같은 모델 기준 보통 5–10배 빠릅니다. 중고 RTX 4060 8GB (가격 변동)는 이 가이드에서 다루는 CPU 전용 구성보다 대체로 빠릅니다. Intel Iris iGPU는 기껏해야 그 중간에 위치합니다 — 예를 들어 Qwen3 4B는 iGPU가 사용되는 경우 추정 초당 12–20 토큰이고, 가장 근접한 CPU 전용 비교 티어는 추정 초당 8–15 토큰입니다.
로컬 AI 모델과 로컬 LLM은 같은 것입니까?
이 가이드에서는 동일한 의미로 사용합니다. "로컬 AI 모델"은 업계에서 로컬 LLM(대규모 언어 모델)이라고 부르는 것 — 한 번 다운로드하여 자신의 기기에서 오프라인으로 실행하는 텍스트 생성 가중치 — 을 가리키는 일상적 표현입니다. 이 구분이 중요해지는 경우는 AI 모델이 텍스트 기반이 아닐 때뿐입니다. Stable Diffusion과 같은 이미지 생성 모델이나 Whisper와 같은 음성 모델도 로컬에서 실행되지만 하드웨어 요구사항이 다르며, 이 가이드의 tok/s 수치는 이들에 적용되지 않습니다.
실용적인 텍스트를 작성할 수 있는 가장 가벼운 로컬 LLM은 무엇입니까?
Q4_K_M 양자화된 Qwen3 1.7B가 이 가이드에서 사용할 가치가 있는 가장 가벼운 모델입니다 — 디스크 용량 1.4GB(Ollama 기준), 4GB RAM에서 실행되며 CPU 전용으로 추정 초당 25–40 토큰입니다. 더 작은 옵션(TinyLlama 1.1B, Qwen3 0.6B)도 존재하며 속도는 더 빠르지만, 출력 품질이 크게 떨어져 글쓰기 보조 도구보다는 자동완성으로 취급하는 것이 낫습니다. 약 10억 파라미터 미만에서는 가벼운 모델이 안정적으로 일관된 장문 텍스트를 생성하지 못합니다.
저사양 PC에서 Gemma 4 E2B가 Qwen3 1.7B보다 빠릅니까?
4 GB 머신에서는 아마 아닐 것입니다. Gemma 4 E2B(Google, 2026년 4월 출시)는 유효 파라미터가 약 2.3B이지만 임베딩 테이블 때문에 Ollama 다운로드가 4.6 GB부터 시작하며, 대역폭이 제한된 CPU에서는 파일이 클수록 초당 토큰 수가 줄어듭니다. RAM 8 GB 또는 16 GB 시스템에 더 적합합니다. CPU 전용 모델 가이드는 듀얼 채널 RAM에서 초당 8–14 토큰으로 추정합니다. 가장 저사양인 하드웨어에서는 Qwen3 1.7B(1.4GB)가 여전히 이 가이드의 속도 우선 선택입니다. RAM 8GB 이상에서는 비교를 위해 `ollama run gemma4:e2b`를 시도해 보십시오.
저사양 PC에서 로컬 LLM이 왜 이렇게 느립니까?
대개 CPU 속도가 아니라 메모리 대역폭이 원인입니다. 토큰 하나를 생성할 때마다 모델 파일 전체를 RAM에서 읽어야 하므로, 속도는 메모리 대역폭을 파일 크기로 나눈 값으로 제한됩니다. 네 가지를 확인하십시오: RAM 모듈이 하나뿐인지(채널이 하나면 상한이 절반이 됩니다), 모델 파일이 여유 RAM보다 큰지(스왑이 발생하면 생성이 몇 배나 느려집니다), 컨텍스트 창이 큰지(`OLLAMA_CONTEXT_LENGTH=2048`을 설정하십시오), 그리고 모델이 CPU와 GPU 중 어디에서 실행되는지(`ollama ps`). 그런 다음 Qwen3 1.7B나 Phi-4-mini 같은 더 작은 모델을 Q4_K_M으로 사용하십시오.
Intel N100 미니 PC에서 로컬 LLM은 얼마나 빠릅니까?
N100은 메모리 채널이 하나입니다(Intel 사양: DDR4-3200, DDR5-4800 또는 LPDDR5-4800). 1.4 GB인 Qwen3 1.7B Q4_K_M 파일의 대역폭 상한은 DDR4-3200에서 약 초당 18 토큰, DDR5-4800에서 약 초당 27 토큰이며 실제 속도는 더 낮습니다. Phi-4-mini(2.5 GB)의 상한은 DDR4에서 약 초당 10 토큰, DDR5에서 약 초당 15 토큰입니다. N100에서는 Qwen3 1.7B 이하를 사용하십시오.
RAM 2 GB 노트북에서 로컬 RAG를 실행할 수 있습니까?
작은 문서 집합이고 약 2 GB의 RAM이 비어 있다면 가능합니다. 채팅 모델로 Qwen3 0.6B(523 MB), 임베딩에는 nomic-embed-text(274 MB, 2K 컨텍스트)를 사용하고, 청크는 수백 토큰으로 유지하며, 상위 2–3개 청크만 모델에 전달하고 `OLLAMA_CONTEXT_LENGTH=2048`을 설정하십시오. 깊은 추론이 아니라 문서에서 가져온 간단한 답변을 기대하고, 중요한 답변은 원문 구절과 대조하십시오.
저사양 PC에서 Qwen3 대신 Qwen3.5를 사용해야 합니까?
가장 빠른 응답을 원한다면 당분간 Qwen3 1.7B를 유지하십시오. Ollama는 Qwen3.5 0.8B를 1.2 GB, 2B를 2.7 GB, 4B를 3.3 GB로 표기하며, Qwen3 1.7B는 1.4 GB, Qwen3 4B는 2.5 GB입니다. 대역폭이 제한된 CPU에서는 파일이 클수록 초당 토큰 수가 줄어들므로, Qwen3 1.7B보다 빠를 것으로 예상되는 모델은 품질이 더 낮은 Qwen3.5 0.8B뿐입니다. 속도보다 더 새로운 학습을 중시한다면 Qwen3.5 2B와 4B를 시험해 볼 만합니다. PromptQuorum은 이 가이드의 하드웨어에서 Qwen3.5의 속도를 측정하지 않았습니다.
CPU만으로 실행할 수 있는 가장 큰 모델은 무엇입니까?
한계는 파일과 컨텍스트를 위한 여유 RAM입니다. Ollama는 Qwen3 8B를 약 5.2 GB, Qwen3 14B를 9.3 GB, Qwen3 32B를 20 GB로 표기하므로, 대략적인 기준은 Q4에서 10억 파라미터당 0.65 GB입니다. RAM 32 GB PC는 Qwen3 32B를 담을 수 있지만, 듀얼 채널 DDR5-5600의 대역폭 상한은 약 초당 4.5 토큰(89.6 GB/s ÷ 20 GB)이어서 배치 작업용 도구에 가깝습니다. Qwen3 30B-A3B(19 GB) 같은 Mixture-of-Experts 모델은 토큰당 활성 파라미터 몇십억 개만 읽으므로 파일 크기로 짐작되는 것보다 빠르게 동작할 것입니다.
출처
- Phi-4 Mini 모델 카드 — Microsoft Research. 개발사가 보고한 벤치마크 결과; 2025년 출시.
- Ollama 라이브러리: Qwen3 — qwen3:0.6b, 1.7b, 4b, 8b의 파일 크기와 컨텍스트 길이 (2026-10-23 확인).
- Ollama 라이브러리: Qwen3.5 — qwen3.5:0.8b, 2b, 4b의 파일 크기 (2026-10-23 확인).
- Ollama 라이브러리: Gemma 4 — gemma4:e2b 다운로드 크기와 128K 컨텍스트 (2026-10-23 확인).
- Ollama 라이브러리: Phi-4-mini — 2.5 GB, 128K 컨텍스트 (2026-10-23 확인).
- Ollama 라이브러리: nomic-embed-text — 274 MB 임베딩 모델, 2K 컨텍스트 창 (2026-10-23 확인).
- Ollama 문서: GPU 지원 — Vulkan, ROCm 및 OLLAMA_VULKAN을 포함한 GPU 선택 변수.
- Ollama 문서: FAQ — OLLAMA_CONTEXT_LENGTH, OLLAMA_KV_CACHE_TYPE, OLLAMA_FLASH_ATTENTION, OLLAMA_KEEP_ALIVE 및 `ollama ps`.
- Intel Processor N100 사양 — 메모리 채널 하나; DDR4-3200, DDR5-4800, LPDDR5-4800.
- Gemma 4 발표 관련 보도 — 출시일 2026년 4월 2일, 유효 파라미터 약 2.3B, 전체 약 5.1B (제3자 요약).
- llama.cpp 빌드 문서 — CPU 백엔드와 빌드 옵션.