适合您硬件的最快模型是什么?
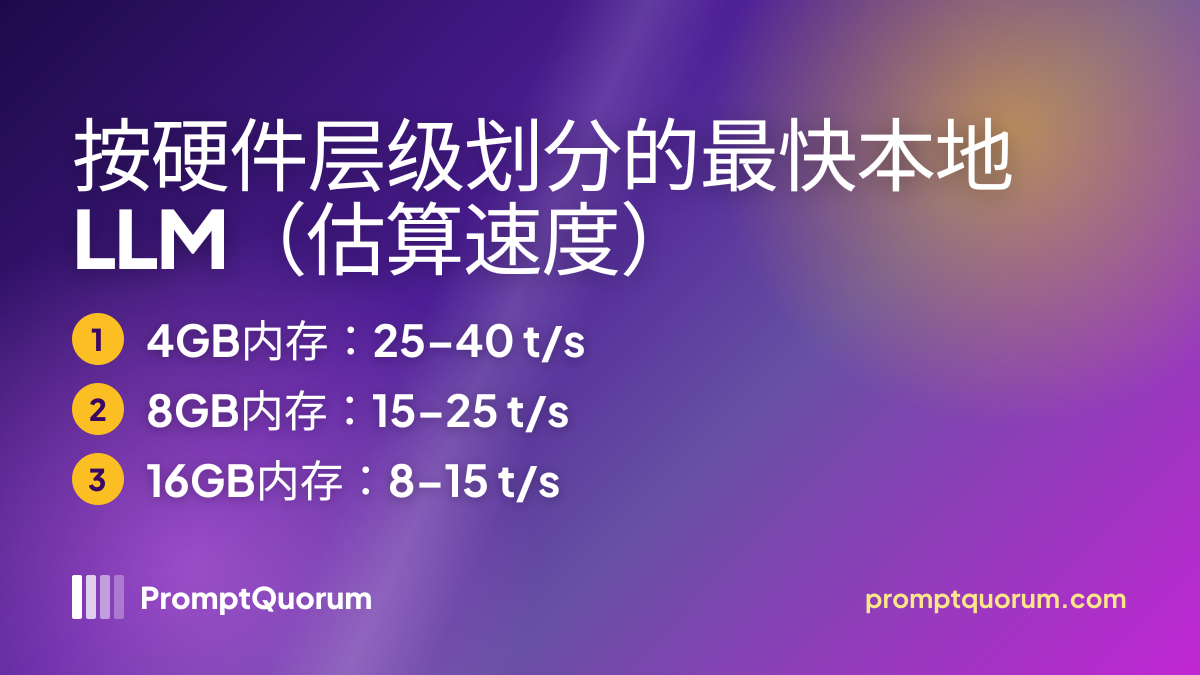
将您的硬件与正确的模型匹配——错误的选择会损失4–10倍的速度。除非另有说明,以下所有层级均为纯CPU。速度为PromptQuorum针对双通道内存的估算,并非实验室实测;单通道内存或较旧的DDR4笔记本会更低。
您的硬件 | 推荐模型 | Ollama命令 | 预期速度 |
|---|---|---|---|
| 4GB内存,纯CPU | Qwen3 1.7B Q4_K_M | ollama run qwen3:1.7b | 25–40 tok/s |
| 8GB内存,纯CPU | Phi-4-mini 3.8B Q4_K_M | ollama run phi4-mini | 15–25 tok/s |
| 8GB内存 + Intel Iris核显 | Qwen3 4B Q4_K_M | ollama run qwen3:4b | 12–20 tok/s |
| 16GB内存,纯CPU | Qwen3 8B Q4_K_M | ollama run qwen3:8b | 8–15 tok/s |
| 16GB内存 + 核显 | Llama 3.2 3B Q4_K_M | ollama run llama3.2:3b | 20–35 tok/s |
您应该使用哪种模型?
将您的情况与正确的模型匹配——这是最重要的决定:
- 8GB内存笔记本(无独立显卡): Phi-4-mini(3.8B)配Q4_K_M——15–25 tok/s,可处理编程和推理。`ollama run phi4-mini`
- 4GB内存,非常旧的电脑: Qwen3 1.7B Q4_K_M——25–40 tok/s,最低内存下最快响应。`ollama run qwen3:1.7b`
- 16GB内存,无GPU: Qwen3 8B Q4_K_M——8–15 tok/s,质量出色。`ollama run qwen3:8b`
- 8GB内存 + Intel Iris核显: Qwen3 4B——若Ollama启用核显(运行`ollama ps`并查看PROCESSOR列),估算12–20 tok/s。`ollama run qwen3:4b`
- 需要长上下文: Qwen3 4B(Ollama上为256K上下文)或Llama 3.2 3B(128K)。Qwen3 1.7B和8B标注为40K。
- 更新一代、文件最小: Qwen3.5 0.8B(Ollama上1.2 GB)比Qwen3 1.7B(1.4 GB)更小,因此在同一CPU上应当更快,但质量较低。Qwen3.5 2B(2.7 GB)和4B(3.3 GB)的文件比Phi-4-mini(2.5 GB)和Qwen3 4B(2.5 GB)更大,预计更慢。`ollama run qwen3.5:0.8b`。PromptQuorum尚未在本指南的硬件上对Qwen3.5计时。
- 在8GB内存上也值得尝试: Gemma 4 E2B(谷歌,2026年4月发布)。它的有效参数约为2.3B,但由于嵌入表较大,Ollama下载大小从4.6 GB起,因此并不是1.5–2 GB的模型。`ollama run gemma4:e2b`。不同内存类型下的估算速度见纯CPU模型指南。
- 关于按内存层级的推荐和散热管理,请参阅 如何在笔记本电脑上运行本地LLM。
您应在您的硬件上运行哪种本地LLM?
以下所有层级均为纯CPU或核显。选择在Q4_K_M下能适配您内存、并为操作系统和上下文留出余量的最大模型。速度为估算值。
硬件 | Model | Quant | Speed | Experience |
|---|---|---|---|---|
| 4GB内存,纯CPU | Qwen3 1.7B | Q4_K_M | 25–40 t/s | 快速,质量可用 |
| 8GB内存,纯CPU | Phi-4-mini 3.8B | Q4_K_M | 15–25 t/s | 编程+推理 |
| 8GB内存 + 核显Iris | Qwen3 4B | Q4_K_M | 12–20 t/s | 若核显被启用 |
| 16GB内存,纯CPU | Qwen3 8B | Q4_K_M | 8–15 t/s | 质量出色 |
| 16GB内存 + 核显 | Llama 3.2 3B | Q4_K_M | 20–35 t/s | 若核显被启用 |

GPU vs CPU:低配硬件上哪个更快?
独立显卡: 同一模型通常比纯CPU快5–10倍,因为显存的内存带宽远高于系统内存。二手RTX 4060 8 GB(价格不定)是常见的预算升级选择。参见经济型GPU指南。
集显(集成显卡): 与CPU共用系统内存,因此主要限制——内存带宽——并没有改变。提升通常有限,且取决于驱动支持。Ollama文档称,安装后端时Windows和Linux上的Vulkan GPU支持默认启用,并将AMD Ryzen AI核显列在ROCm之下;文档并未在支持列表中列出Intel集成显卡。请查看`ollama ps`:PROCESSOR列会显示模型运行在CPU、GPU还是两者之间拆分。
纯CPU: 无需配置驱动,任何电脑都能运行。速度大致等于内存带宽 ÷ 模型文件大小,这就是双通道内存和体积小的Q4_K_M文件比CPU主频更重要的原因。
规则: 有独立显卡就用独立显卡。否则,分别开启和关闭核显(`OLLAMA_VULKAN=0`可关闭Vulkan GPU)运行同一提示词,保留更快的那个设置。

为什么小模型在低配PC上更快
模型大小直接决定速度。 1B-3B模型完全适合系统RAM,CPU或GPU可以持续流式传输数据。较大的模型需要内存交换——在RAM和磁盘之间移动数据——这会使生成速度大幅下降(瓶颈是磁盘I/O,而非计算)。
上方的硬件决策表体现了这一原则:文件最小的模型速度最高,而13B+模型在低配硬件上不切实际,因为内存交换占主导。
- 1B-3B模型: 适合4-8GB RAM → 生成最快 → 质量可接受
- 7B模型: 在8GB系统上处于临界 → 因内存压力而较慢 → 质量高
- 13B+模型: 需要16GB+内存或大量内存交换 → 在低配电脑上交互式使用速度过慢
低配PC上本地LLM有多快?
纯CPU系统的估算范围:
- 3B模型 → 15-40词元/秒(旧CPU:10-15,较新的双通道DDR5系统:30-40)
- 7B–8B模型 → 8-15词元/秒(双通道内存下的Q4_K_M;单通道内存更低)
- 一次除法就能估算自己电脑的速度。 生成每个词元都需要把整个模型从内存读取一遍,因此每秒词元数不可能超过内存带宽 ÷ 模型文件大小。峰值带宽 = 传输速率(MT/s)× 8字节 × 通道数。
- 计算示例(上限,而非预测):双通道DDR4-3200为3200 × 8 × 2 = 51.2 GB/s;除以2.5 GB的Phi-4-mini文件,最多约20 tok/s。双通道DDR5-5600为89.6 GB/s,同一文件最多约36 tok/s。单通道DDR4-3200的笔记本为25.6 GB/s,最多约10 tok/s。实际速度低于上限。
- Intel N100迷你主机只有一个内存通道(Intel规格:DDR4-3200、DDR5-4800或LPDDR5-4800)。使用DDR4-3200时,1.4 GB的Qwen3 1.7B文件上限约为18 tok/s;使用DDR5-4800时约为27 tok/s。N100的实际表现会低于本指南中的双通道范围。
- 这比云端聊天机器人慢,但足以满足交互式使用。 3B模型以25词元/秒生成500词元响应需20秒——对于代码审查、摘要和创意写作等非时间敏感任务可接受。
量化如何影响低配PC的速度?
Q4(4位): 标准选择——文件大小约为16位的四分之一,多数任务上质量损失较小。所有量化级别的详细说明见完整指南。
Q3(3位): 文件比Q4更小,质量损失比Q4更大。Q4放不进内存时,聊天可接受。
Q2(2位): 文件最小,质量损失最大。有风险;仅在Q4和Q3都内存不足时使用。
速度影响: CPU解码受内存带宽限制,文件越小,生成越快,大致成比例。Q3和Q2文件比Q4更快,但对这类小模型而言,质量下降通常不值得。
策略:先选定模型大小,再使用Q4_K_M。小模型配Q4_K_M通常优于被压缩到Q2的更大模型——后者质量损失大,且仍需更多内存。
快速模型以牺牲质量来换取速度——但通过调整温度和top-p,您可以恢复大部分质量。在快速模型上使用较低的温度(0.1-0.3)会产生比默认设置更一致的输出。参阅温度和top-p解析了解确切设置。

如何加速纯CPU推理?
- 插满两个内存通道: 两条相同的内存条,峰值内存带宽是单条的两倍,这是纯CPU电脑上最大的单项提速。只有单条内存的笔记本和迷你主机只能达到一半上限。
- 缩小上下文窗口: KV缓存随上下文长度增长。设置`OLLAMA_CONTEXT_LENGTH=2048`(Ollama默认值为4096),或在`ollama run`中使用`/set parameter num_ctx 2048`。
- 量化KV缓存: `OLLAMA_FLASH_ATTENTION=1`配合`OLLAMA_KV_CACHE_TYPE=q8_0`,KV缓存内存比默认的f16大约减半,对4GB和8GB电脑帮助最大。
- 让模型保持加载: Ollama默认在5分钟后卸载模型。`OLLAMA_KEEP_ALIVE=30m`可避免每次会话都重新加载文件。
- 关闭占内存的应用: 开着很多标签页的浏览器会把模型挤进交换空间,使生成速度慢很多倍。
- 测试核显: 模型加载后运行`ollama ps`。若PROCESSOR显示100% CPU,请与GPU运行对比;若核显不稳定,设置`OLLAMA_VULKAN=0`。
能在2 GB内存上运行本地RAG吗?
可以,适用于小型文档集:用Qwen3 0.6B(Ollama上523 MB)生成回答,再用nomic-embed-text嵌入模型(274 MB)做检索,模型文件合计约0.8 GB。 前提是确实有2 GB内存空闲,例如轻量的Linux系统、旧上网本或关闭了其他应用的电脑。预期得到的是基于您文档的简单回答,而非深度推理。
- 对话模型: `ollama pull qwen3:0.6b`(523 MB,Ollama上为40K上下文)。若空闲内存稍多,`qwen3.5:0.8b`(1.2 GB)是更新的小型选择。
- 嵌入模型: `ollama pull nomic-embed-text`(274 MB,2K上下文窗口)。将文档切成几百个词元的分块,使每个分块都能放进2K窗口。
- 只检索少量分块: 只把最匹配的2–3个分块交给对话模型。每多一个分块,上下文就更长,KV缓存也更大。
- 保持上下文简短: 设置`OLLAMA_CONTEXT_LENGTH=2048`,让KV缓存保持较小。
- 核实回答: 0.6B模型擅长从检索到的段落中提取事实,但不擅长多步推理,因此重要答案请对照原文段落核实。
- 2 GB太紧张时: 4 GB内存可升级到Qwen3 1.7B(1.4 GB),8 GB内存可用Phi-4-mini,并继续使用同一嵌入模型。
这些模型有多快?估算速度
按硬件类别估算的速度,并非实验室实测。这些范围是PromptQuorum自己的估算,依据各类硬件的内存带宽上限推算,对应Ollama默认设置和Q4_K_M文件。请将其视为运行状态良好时的上限;您自己的`ollama run <model> --verbose`输出会给出真实的每秒词元数:
- Intel N100迷你主机(单通道内存,4GB层级)+ Qwen3 1.7B Q4_K_M:DDR4-3200下最多约18 tok/s,DDR5-4800下约27 tok/s(带宽上限)。`ollama run qwen3:1.7b`
- 现代双通道i5/Ryzen 5(4GB层级)+ Qwen3 1.7B Q4_K_M:估算25–40 tok/s。`ollama run qwen3:1.7b`
- Core i5-1235U级别笔记本(8GB内存)+ Phi-4-mini Q4_K_M:LPDDR5下估算15–22 tok/s;DDR4笔记本更低。`ollama run phi4-mini`
- Ryzen 5 5600G级别台式机(8GB内存)+ Qwen3 4B Q4_K_M:估算15–20 tok/s(双通道DDR4-3200的上限约为20);核显共用同一内存带宽,因此不要期待更高。
- Intel Iris Xe级别笔记本(8GB内存)+ Qwen3 4B Q4_K_M:估算12–18 tok/s。`ollama run qwen3:4b`
- Ryzen 7 7700X级别台式机(16GB内存,双通道DDR5)+ Qwen3 8B Q4_K_M:估算8–13 tok/s。`ollama run qwen3:8b`
- Iris Xe级别笔记本(16GB内存)+ Llama 3.2 3B Q4_K_M:估算20–30 tok/s。`ollama run llama3.2:3b`
对本地LLM来说什么才算真正的"快"?
速度的感受因任务而异——可参考以下标准:
如果您的模型速度低于15 tok/s,请在购买新硬件之前先缩小模型规模(7B → 3B)或降低一级量化(Q5 → Q4)。
- 低于10 tok/s → 感觉卡顿。 词语逐个出现,停顿明显。无法用于交互式聊天。
- 15–25 tok/s → 可接受。 对大多数用户来说速度可读。适合问答、摘要和编程辅助。
- 30+ tok/s → 流畅。 感觉像真实助手。对所有交互任务都很舒适。
- 60+ tok/s → 即时。 比阅读速度还快。适合实时自动补全和快速迭代。

低配PC上应避免什么
- 不要运行13B+模型——它们超出RAM限制。 Q4下13B模型仅文件就需要约8 GB,算上操作系统后,超出8GB电脑的容量。16GB电脑坚持使用8B及以下,8GB电脑坚持使用4B及以下。
- 避免Q8量化——速度更慢,质量提升微乎其微。 Q8的文件大小大约是Q4的两倍,而在带宽受限的CPU上,文件越大,每秒词元数越少。对于4GB系统,Q8不切实际;对于8GB系统,Q4仍是最优。Q3是Q4内存不足时唯一值得考虑的权衡。
- 不要期望实时自动补全性能。 在CPU上以3词元/秒的速度,生成50个词元需要约17秒。交互式自动补全需要高得多的速度。低配CPU上的本地LLM适用于批量聊天、起草和审查——而非实时自动补全或边输入边生成代码的场景。
- 不要将纯CPU推理用于生产聊天机器人。 适用于内部工具、原型和离线批处理。低配CPU一次只能以较低速度服务一位用户,而托管API可以扩展到许多用户。将本地推理用于隐私关键或离线场景,而非速度关键场景。
常见错误
- 错误:只插一条内存。 问题:单个内存通道使峰值带宽减半,同一模型的生成速度大约也只有一半。解决方案:在考虑换更快的CPU之前,先装两条相同的内存条(或购买双通道迷你主机)。
- 错误:只看CPU型号判断速度。 问题:配单通道慢速DDR4的较新CPU,可能比配双通道DDR5的较旧CPU更慢,因为词元生成受内存带宽限制。解决方案:比较内存速度和通道数,然后从`ollama run <model> --verbose`读取真实数值。
- 错误:量化到Q2以将7B强塞进4GB。 问题:Q2量化由于推理时KV缓存开销常导致内存溢出崩溃,且输出质量大幅下降。解决方案:改用Q4的3B模型。
- 错误:把上下文窗口留得很大。 问题:长上下文会使KV缓存增大,并把小内存电脑推入交换空间。解决方案:除非需要处理长文档,否则设置`OLLAMA_CONTEXT_LENGTH=2048`。
- 错误:使用错误的Ollama slug。 问题:`ollama run phi` 加载的是Phi-2,而非Phi-4-mini。解决方案:使用`ollama run phi4-mini`获取当前的Phi mini模型。始终在ollama.com/library查看精确的模型标签。
低配PC本地LLM:地区背景
中国(数据安全法): 2021年施行的《数据安全法》和《个人信息保护法》(PIPL)对数据处理和数据出境提出了要求。在消费级硬件上本地运行Qwen3和DeepSeek-R1蒸馏版是一种可选方案。金融、医疗和法律等行业的企业可以考虑这一部署思路:离线运行时,本地推理让推理数据留在设备上,有助于减少对境外云服务的依赖。具体合规要求取决于您的数据类型和业务场景,本指南不构成法律意见。Qwen3 0.6B、1.7B和4B可在纯CPU硬件上运行,为硬件受限用户提供可行的替代方案。
欧盟 / GDPR: 在低配硬件上本地运行:离线运行时,推理数据不离开设备——对许多中小企业和自由职业者而言,这是规避GDPR第44条数据转移风险的技术简便方法。欧盟AI法案或其他义务是否适用于您的使用场景,取决于部署系统的主体及其用途;本指南不构成法律意见。对于考虑在内部业务任务中使用本地LLM的德国中小企业,将文档保留在设备上可避免把文档发送给第三方处理者,但数据保护的整体合规性仍取决于您的整体运营方式,而非仅推理架构本身。
日本(METI AI治理): 日本经济产业省(METI)面向企业的AI指南强调负责任地处理数据。低配硬件上的CPU推理虽然较慢,但提示词保留在设备上——模型下载完成后,推理本身不需要API调用。对于使用CPU运行Qwen3处理日语任务的用户,按上文速度范围,每句话几秒钟对非实时文档摘要来说已经足够。
关于在低配PC上运行本地LLM的常见问题
运行本地LLM,什么算作低配PC?
低配PC是指没有独立显卡(纯CPU)、系统内存为4–16GB的机器。包括大多数配备Intel Iris或AMD Radeon集成显卡的笔记本电脑、没有独立显卡的旧款台式机,以及Intel N100等迷你主机。关键限制是用于存储模型权重的系统内存,而非CPU时钟频率。
我可以在完全没有GPU的情况下运行7B级模型吗?
可以——Qwen3 8B(Q4_K_M)在16GB内存、纯CPU下估算可达8–15 tok/s(为双通道Ryzen 7 7700X级别台式机的估算值)。它比更小的选项慢,但质量明显更好。若只有8GB内存,建议改用Phi-4-mini(3.8B)——8B模型在Q4_K_M下需要的余量,8GB系统未必能可靠保证。
CPU推理适合聊天机器人吗?
只要选对模型大小,适合交互式使用。Phi-4-mini(15–25 tok/s,8GB内存)和Qwen3 1.7B(25–40 tok/s,4GB内存)都足够快,可用于实时聊天。CPU上的7B级模型(8–15 tok/s)更适合起草、摘要、离线审阅等批处理任务,而非实时对话。
在纯CPU硬件上应该使用Phi-4-mini还是Qwen3 1.7B?
如果有8GB内存,使用Phi-4-mini(3.8B)——它以15–25 tok/s处理编程和推理。如果只有4GB内存,或想要最快的响应速度(25–40 tok/s),可以使用Qwen3 1.7B,但在复杂任务上质量会有所牺牲。
如何检查我是否有任何GPU?
对于独立NVIDIA显卡,在终端运行`nvidia-smi`。如果返回"command not found",请检查`lspci`(Linux)或设备管理器(Windows)是否有Intel Iris Xe或AMD Radeon核显——Ollama能否使用核显取决于驱动和后端支持,请用`ollama ps`确认。
量化如何影响推理速度?
量化主要减少内存带宽需求,而非计算量。Q2(2位)文件比Q4(4位)文件更小,CPU生成每个词元读取的字节更少,因此速度更快,大致与文件大小成比例。但Q2的输出质量损失要大得多。实用规则:本指南中每个层级都默认使用Q4_K_M,只有在Q4_K_M无法放入可用内存时才降至Q3。
我可以使用Q2以下的量化吗?
技术上可以(llama.cpp中存在1位的IQ1格式),但在这种体积下输出质量会崩溃。包括本指南的4GB内存层级在内,不建议用于任何实际场景——请改用更小的Q4_K_M模型。
支持CPU + 核显混合推理吗?
有时可以。当Ollama找到受支持的GPU后端时,可以在CPU和GPU之间拆分模型,`ollama ps`的PROCESSOR列会显示拆分情况。核显与CPU共用系统内存,因此主要的速度限制——内存带宽——并不会增加。在配备Intel Iris Xe核显的8GB内存系统上,若使用核显,Qwen3 4B估算为12–20 tok/s。可用`OLLAMA_VULKAN=0`与纯CPU对比测试。
低配电脑最快的本地LLM是什么?
Qwen3 1.7B(Q4_K_M)是本指南各档位推荐中最快的模型(Qwen3 0.6B等更小的模型更快,但质量低得多)——在现代i5/Ryzen 5、4GB内存、无GPU的情况下预计可达25–40 tok/s。若追求相近速度下更好的质量,Phi-4-mini(3.8B)在8GB内存下以15–25 tok/s运行,编程和推理表现明显更佳。
我可以在4GB内存上运行本地LLM吗?
可以——Qwen3 1.7B(Q4_K_M)是4GB内存、纯CPU场景下的推荐选择,在现代i5/Ryzen 5上可达25–40 tok/s。它是本指南各档位推荐中最快的模型,且为操作系统留有余量。
速度一定需要GPU吗?
不需要——本指南所有模型均可仅用CPU运行。Intel Iris核显可能带来小幅速度提升(Qwen3 4B:若使用核显,估算12–20 tok/s),但仅是可选项,且取决于驱动支持。像二手RTX 4060 8GB这样的独立显卡在同一模型下通常比纯CPU快5–10倍,但这是一条独立的升级路径,而非必需条件。
Intel Iris核显对本地LLM够用吗?
有帮助,但不能保证。配备8GB内存和Intel Iris Xe核显时,如果Ollama确实使用了核显,Qwen3 4B估算为12–20 tok/s;配备16GB内存时,Llama 3.2 3B估算为20–35 tok/s。由于核显与CPU共用系统内存,提升通常有限。请分别开启和关闭核显运行同一提示词,保留更快的设置。
低配硬件上应该使用Q2还是Q4量化?
从Q4_K_M开始——它适用于本指南中的每个模型层级(1.7B到8B),质量损失较小。只有在Q4_K_M导致内存不足错误时才降至Q3或Q2。Q2文件因为更小所以更快,但质量损失在推理和编程任务上较为明显。
如何在Windows上检查可用内存?
打开任务管理器 → 性能 → 内存。显示的总量即为系统内存——将其与上方的硬件判断表(4GB、8GB或16GB层级)对比,选择正确的模型。
Ollama会自动使用我的集成显卡吗?
只有存在受支持的后端时才会。Ollama文档称,安装后端时Windows和Linux上的Vulkan GPU支持默认启用,并将AMD Ryzen AI核显列在ROCm之下;文档并未在支持列表中列出Intel集成显卡。加载模型后用`ollama ps`验证——PROCESSOR列会显示100% CPU、100% GPU或两者拆分。设置`OLLAMA_VULKAN=0`可关闭Vulkan GPU。
低配电脑上ChatGPT的最佳免费替代方案是什么?
在Ollama上使用Phi-4-mini(3.8B,Q4_K_M),8GB内存、纯CPU,可达15–25 tok/s——足以应付聊天、摘要和编程辅助。质量低于前沿云端模型,但对日常任务已经足够。完全免费,可离线运行,无需API密钥。
独立显卡比CPU快多少?
同一模型下通常快5–10倍。一块二手RTX 4060 8GB(价格不定)通常优于本指南涉及的纯CPU配置。Intel Iris核显至多介于两者之间——例如Qwen3 4B若使用核显,估算为12–20 tok/s,而最接近的纯CPU层级估算为8–15 tok/s。
本地AI模型和本地LLM是同一回事吗?
在本指南中,是的。"本地AI模型"是业界所说的本地LLM(大语言模型)的通俗说法——即下载一次、在自己设备上离线运行的文本生成权重。这一区分只在AI模型不基于文本时才有意义:Stable Diffusion等图像生成模型和Whisper等语音模型也能本地运行,但硬件要求不同,本指南中的tok/s数据均不适用于它们。
仍能写出可用文本的最轻量本地LLM是什么?
Q4_K_M量化的Qwen3 1.7B是本指南中值得使用的最轻量模型——在Ollama中磁盘占用1.4 GB,4 GB内存即可运行,纯CPU下估算25–40 tok/s。更小的选择也存在(TinyLlama 1.1B、Qwen3 0.6B),速度更快,但输出质量下降明显,更适合作为自动补全而非写作助手。参数量低于约10亿时,轻量模型无法可靠生成连贯的长文本。
Gemma 4 E2B在低配电脑上比Qwen3 1.7B快吗?
在4 GB内存的电脑上多半不会。Gemma 4 E2B(谷歌,2026年4月发布)的有效参数约为2.3B,但由于嵌入表较大,Ollama下载大小从4.6 GB起,而在带宽受限的CPU上,文件越大,每秒词元数越少。它更适合8 GB或16 GB内存的电脑。纯CPU模型指南估算它在双通道内存下为8–14 tok/s。对于最低功耗的硬件,Qwen3 1.7B(1.4 GB)仍是本指南的速度首选;有8 GB或更多内存时,可尝试`ollama run gemma4:e2b`进行对比。
为什么我的本地LLM在低配电脑上这么慢?
通常的原因是内存带宽,而不是CPU速度:每生成一个词元都要从内存读取一遍整个模型文件,所以速度上限是内存带宽除以文件大小。请检查四点:是否只插了一条内存(单通道会使上限减半)、模型文件是否超过可用内存(内存交换会使生成慢很多倍)、上下文窗口是否过大(设置`OLLAMA_CONTEXT_LENGTH=2048`),以及模型运行在CPU还是GPU上(`ollama ps`)。然后改用更小的模型,例如Q4_K_M的Qwen3 1.7B或Phi-4-mini。
Intel N100迷你主机运行本地LLM有多快?
N100只有单个内存通道(据Intel:DDR4-3200、DDR5-4800或LPDDR5-4800)。对于1.4 GB的Qwen3 1.7B Q4_K_M文件,带宽上限在DDR4-3200上约为18 tok/s,在DDR5-4800上约为27 tok/s,实际速度更低。Phi-4-mini(2.5 GB)的上限在DDR4上接近10 tok/s,在DDR5上接近15 tok/s。在N100上请使用Qwen3 1.7B或更小的模型。
只有2 GB内存的笔记本能运行本地RAG吗?
可以,适用于小型文档集,前提是约有2 GB内存空闲。用Qwen3 0.6B(523 MB)作为对话模型,用nomic-embed-text(274 MB,2K上下文)做嵌入,将分块控制在几百个词元,只把最匹配的2–3个分块交给模型,并设置`OLLAMA_CONTEXT_LENGTH=2048`。预期得到的是基于文档的简单回答,而非深度推理;重要答案请对照原文段落核实。
在低配电脑上应该用Qwen3.5代替Qwen3吗?
想要最快响应,目前仍建议使用Qwen3 1.7B。Ollama列出的Qwen3.5 0.8B为1.2 GB、2B为2.7 GB、4B为3.3 GB,而Qwen3 1.7B为1.4 GB、Qwen3 4B为2.5 GB。在带宽受限的CPU上,文件越大每秒词元数越少,因此只有Qwen3.5 0.8B应当比Qwen3 1.7B更快,但质量较低。如果您更看重较新的训练而非速度,Qwen3.5 2B和4B值得测试。PromptQuorum尚未在本指南的硬件上对Qwen3.5计时。
纯CPU最大能运行多大的模型?
限制在于能容纳文件加上下文的空闲内存。Ollama列出Qwen3 8B约5.2 GB、Qwen3 14B约9.3 GB、Qwen3 32B约20 GB,因此粗略规则是Q4下每10亿参数约0.65 GB。32GB电脑可以装下Qwen3 32B,但双通道DDR5-5600下的带宽上限约为4.5 tok/s(89.6 GB/s ÷ 20 GB),只能当作批处理工具。Qwen3 30B-A3B(19 GB)等混合专家模型每个词元只读取几十亿个活跃参数,因此运行速度应当比其文件大小所暗示的更快。
参考资料
- Phi-4 Mini模型卡 — 微软研究院。开发者自报的基准测试结果;2025年发布。
- Ollama模型库:Qwen3 — qwen3:0.6b、1.7b、4b和8b的文件大小与上下文长度(2026-10-23核对)。
- Ollama模型库:Qwen3.5 — qwen3.5:0.8b、2b和4b的文件大小(2026-10-23核对)。
- Ollama模型库:Gemma 4 — gemma4:e2b的下载大小与128K上下文(2026-10-23核对)。
- Ollama模型库:Phi-4-mini — 2.5 GB,128K上下文(2026-10-23核对)。
- Ollama模型库:nomic-embed-text — 274 MB嵌入模型,2K上下文窗口(2026-10-23核对)。
- Ollama文档:GPU支持 — Vulkan、ROCm以及包括OLLAMA_VULKAN在内的GPU选择变量。
- Ollama文档:常见问题 — OLLAMA_CONTEXT_LENGTH、OLLAMA_KV_CACHE_TYPE、OLLAMA_FLASH_ATTENTION、OLLAMA_KEEP_ALIVE以及`ollama ps`。
- Intel Processor N100规格 — 一个内存通道;DDR4-3200、DDR5-4800、LPDDR5-4800。
- Gemma 4发布报道 — 发布日期2026年4月2日,有效参数约2.3B,总参数约5.1B(第三方汇总)。
- llama.cpp构建文档 — CPU后端与构建选项。